Évaluer et améliorer
Démarrage rapide de l’agent de codage
Utilisez-vous un agent de codage ? Collez ce prompt :
Read the documentation at https://docs.databricks.com/aws/en/mlflow3/genai/eval-monitor and set up evaluation for my agent using scorers and an evaluation dataset.
Vous pouvez également installer mlflow/skills pour une intégration plus approfondie avec MLflow.
L’évaluation permet de déterminer si votre agent est réellement performant : la réponse est-elle correcte, étayée, sûre et complète ? MLflow évalue vos traces à l’aide d’ évaluateurs : des juges LLM et des vérifications basées sur du code qui associent une évaluation de la qualité à chaque trace. Start par évaluer quelques traces à partir de l’interface utilisateur, puis intégrez ces mêmes évaluateurs dans une boucle mlflow.genai.evaluate() reproductible à mesure que votre application gagne en maturité.
Aperçu rapide : évaluer les traces à partir de l’interface utilisateur
Évaluez les traces que vous possédez déjà, sans code :
-
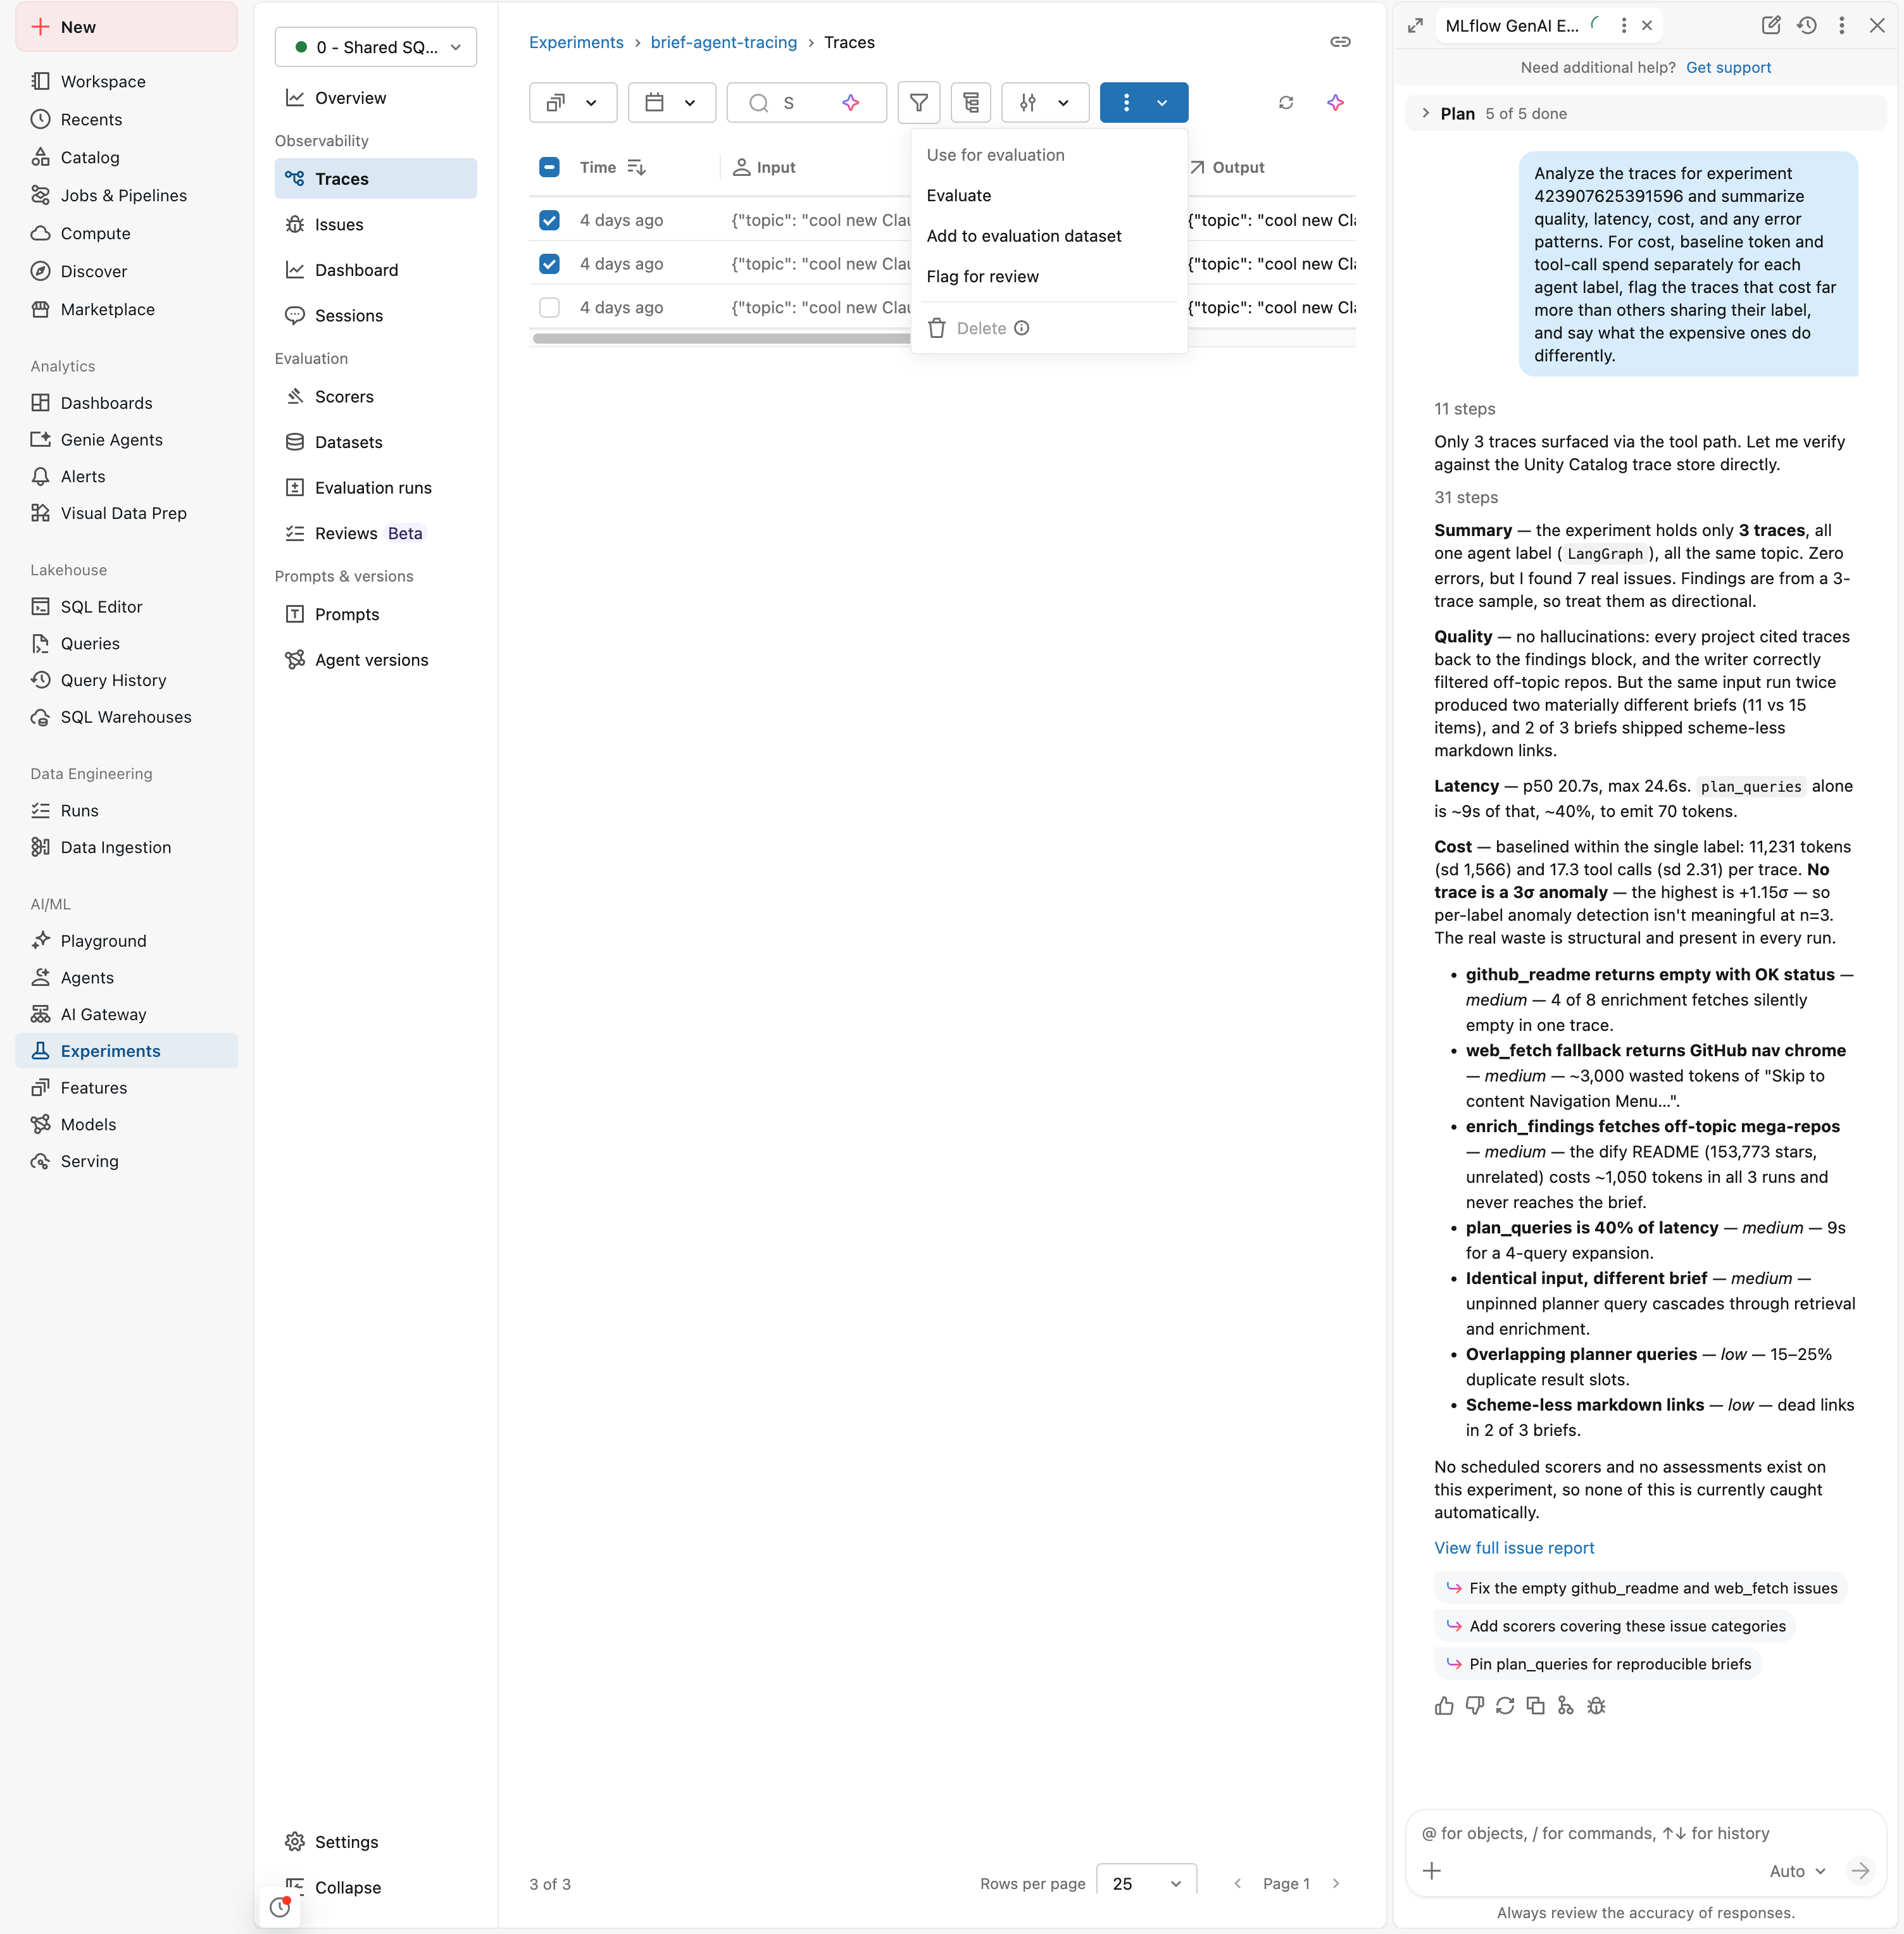
Dans l’onglet Traces , sélectionnez quelques traces à l’aide des cases à cocher des lignes.
-
Cliquez sur Actions et choisissez Évaluer .
-
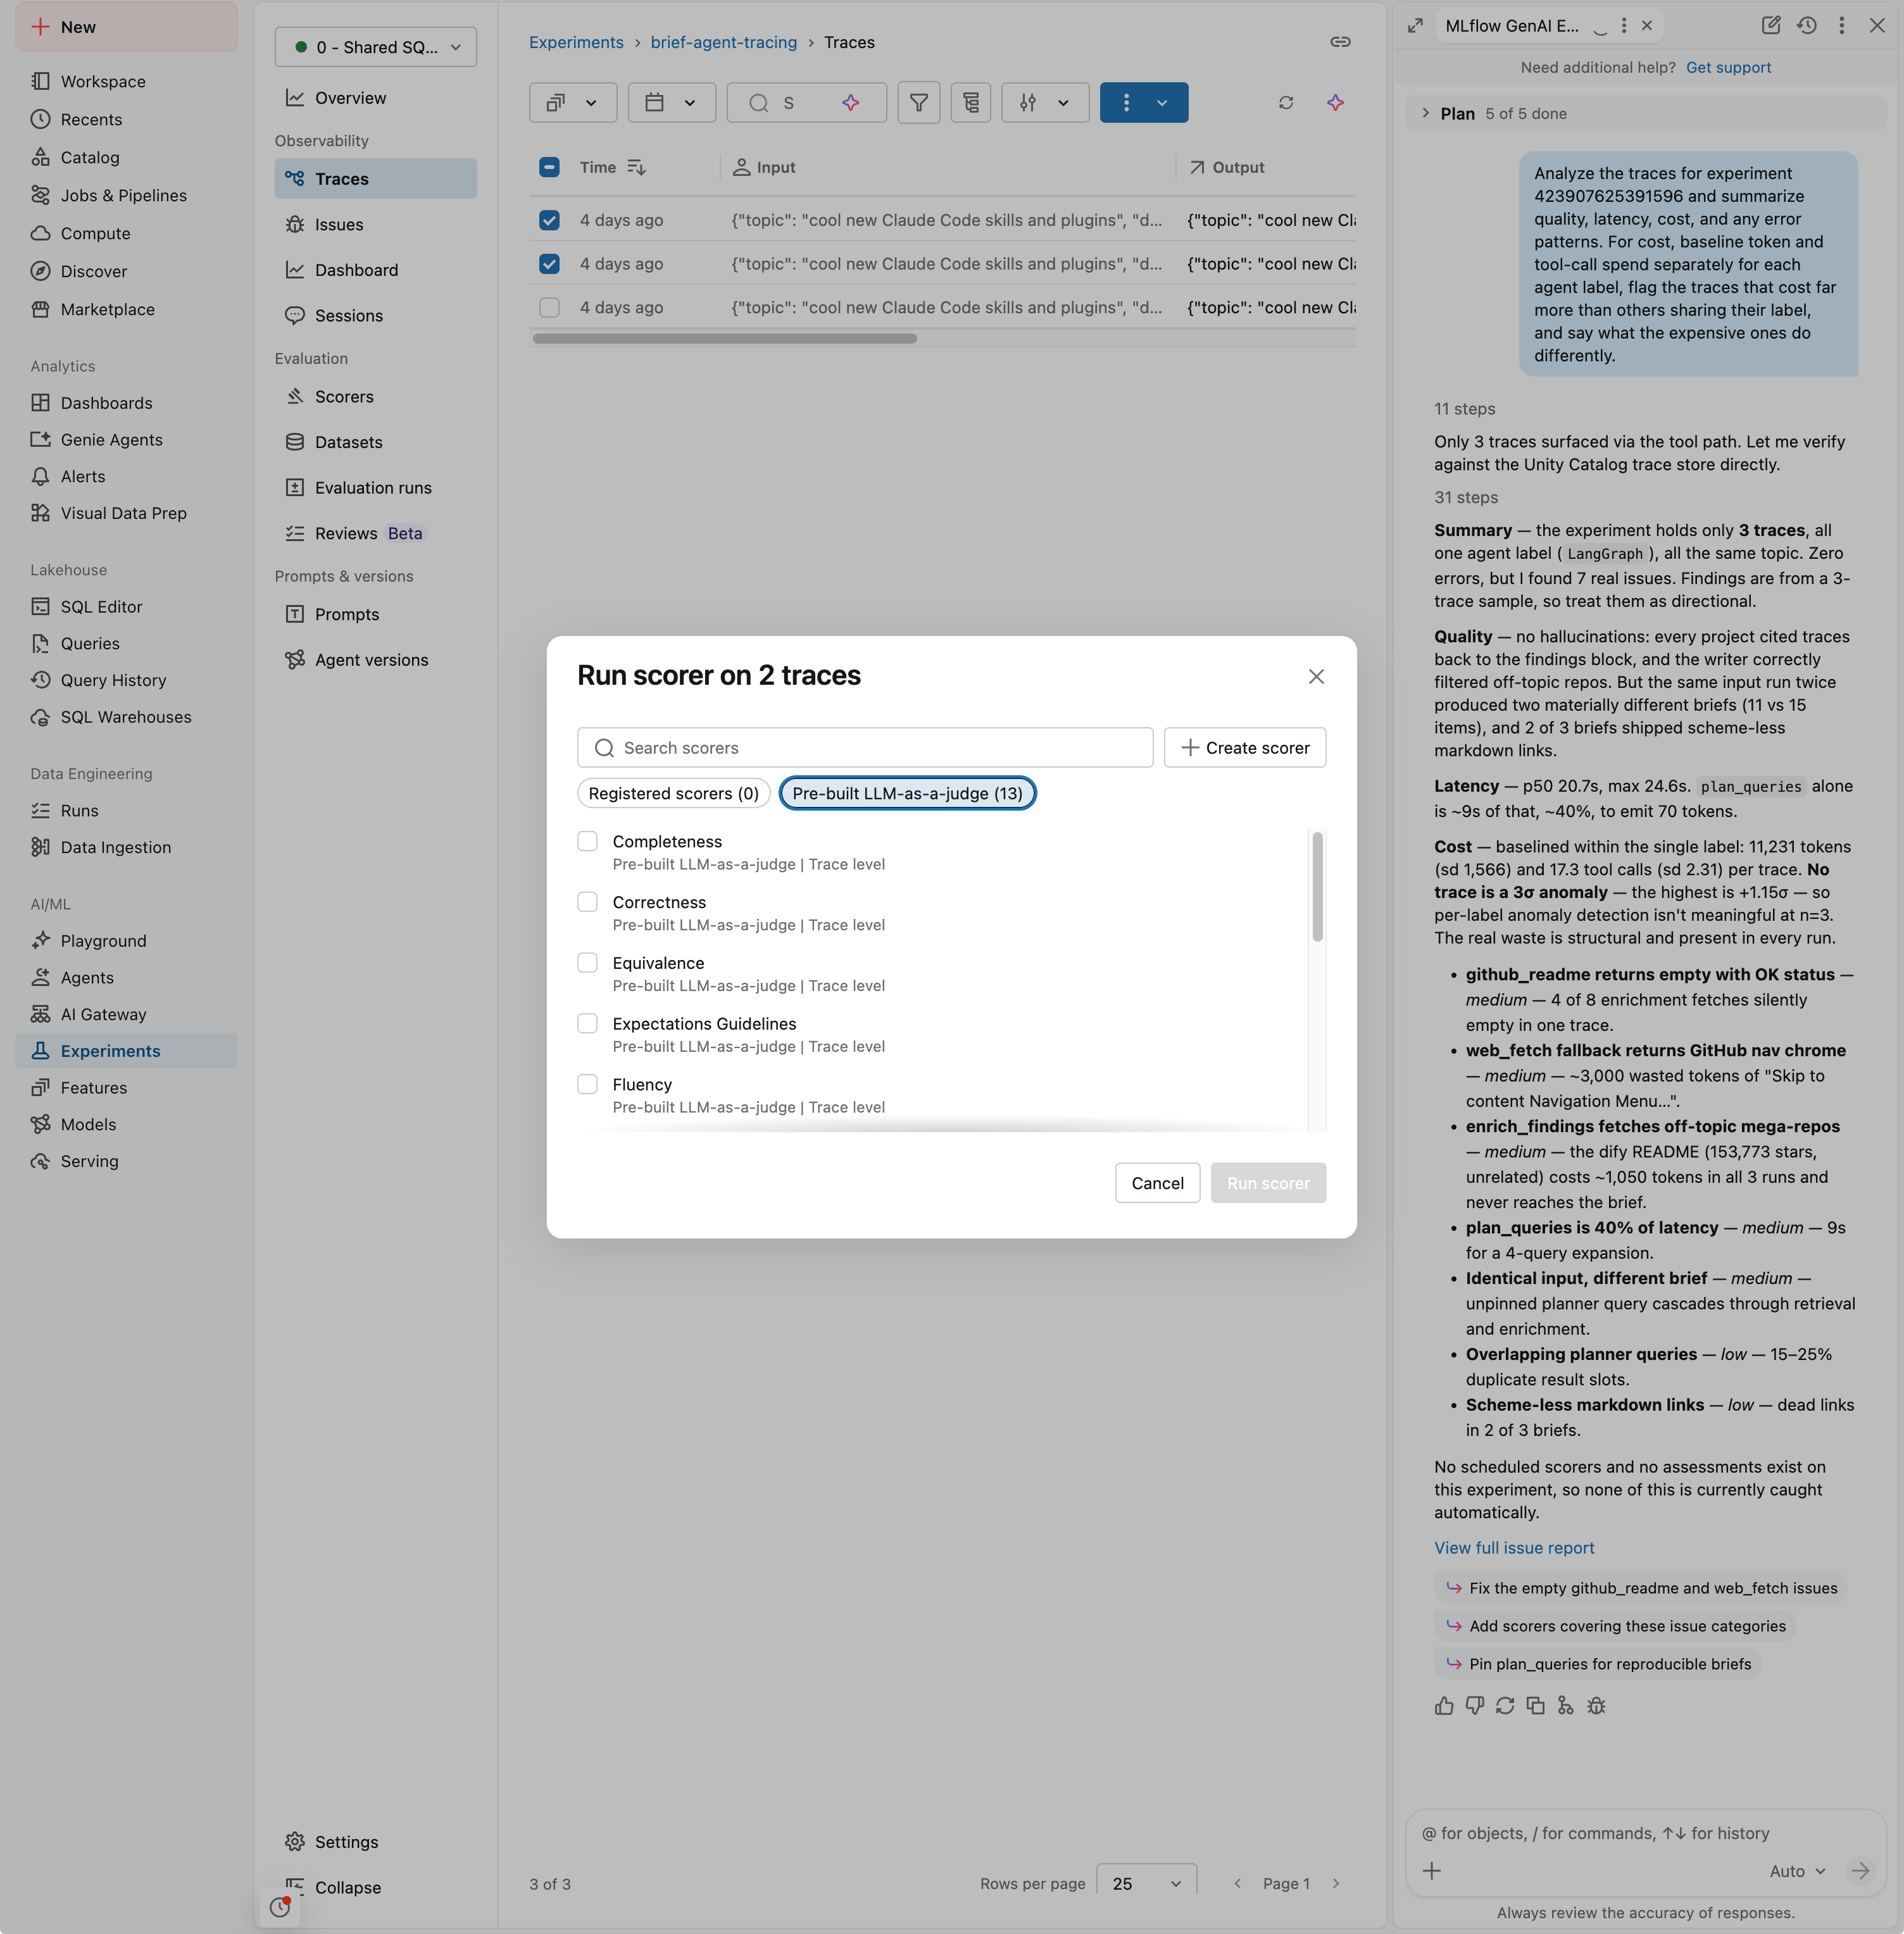
Dans la boîte de dialogue Run scorer , choisissez un ou plusieurs évaluateurs : faites votre choix parmi les évaluateurs Pre-built LLM-as-a-judge (tels que Correctness, Completeness et Fluency), réutilisez l'un de vos Registered scorers ou cliquez sur Create scorer .
-
Cliquez sur Run scorer . MLflow exécute les évaluateurs sur les traces sélectionnées, associe chaque résultat à sa trace sous forme de commentaire et enregistre l'exécution sous l'onglet Evaluation runs tab.
Il s'agit de la même évaluation qui alimente l'évaluation programmatique — les juges que vous choisissez ici sont les juges LLM intégrés, et les résultats sont enregistrés sous forme de traces avec les commentaires des évaluateurs dans votre Experiment.
Étapes suivantes
- Tutoriel : Évaluer et améliorer un agent — Exécutez
mlflow.genai.evaluate()sur un dataset d’évaluation pour noter l’ensemble d’une version d’application en une seule fois et comparer les versions. - Évaluateurs et juges LLM — Les juges intégrés, ce que chacun mesure et quand les utiliser.
- Configurer le monitoring de la production — Exécuter automatiquement ces mêmes évaluateurs sur un échantillon de trafic de production.