Recueillir des commentaires et créer des datasets
Démarrage rapide pour l’agent de codage
Vous utilisez un agent de codage ? Collez cette invite :
Read the documentation at https://docs.databricks.com/aws/en/mlflow3/genai/human-feedback and set up human feedback collection and evaluation datasets for my agent.
Facultativement, installez mlflow/skills pour une intégration plus poussée avec MLflow.
Le jugement humain (évaluations, commentaires et attentes de vérité terrain de la part des développeurs, des utilisateurs et des experts du domaine) est ce qui permet de maintenir l’évaluation en adéquation avec ce que « bien » signifie réellement pour votre application. Dans MLflow, vous enregistrez ce jugement directement sur une trace, et une trace qui porte une attente de vérité terrain devient un cas de test prêt à l’emploi pour l’ évaluation automatisée.
Aperçu rapide : transformer une trace en cas de test
- Dans l’onglet Traces , cliquez sur une trace pour l’ouvrir.
- Cliquez sur Assess , puis sur Add expectation pour enregistrer la bonne réponse (vérité terrain). L'attente est stockée sur la trace, ainsi que ses entrées, ses sorties et tout autre retour.
- Cliquez sur Ajouter au dataset pour ajouter la trace, avec son attente, à un dataset d’évaluation.
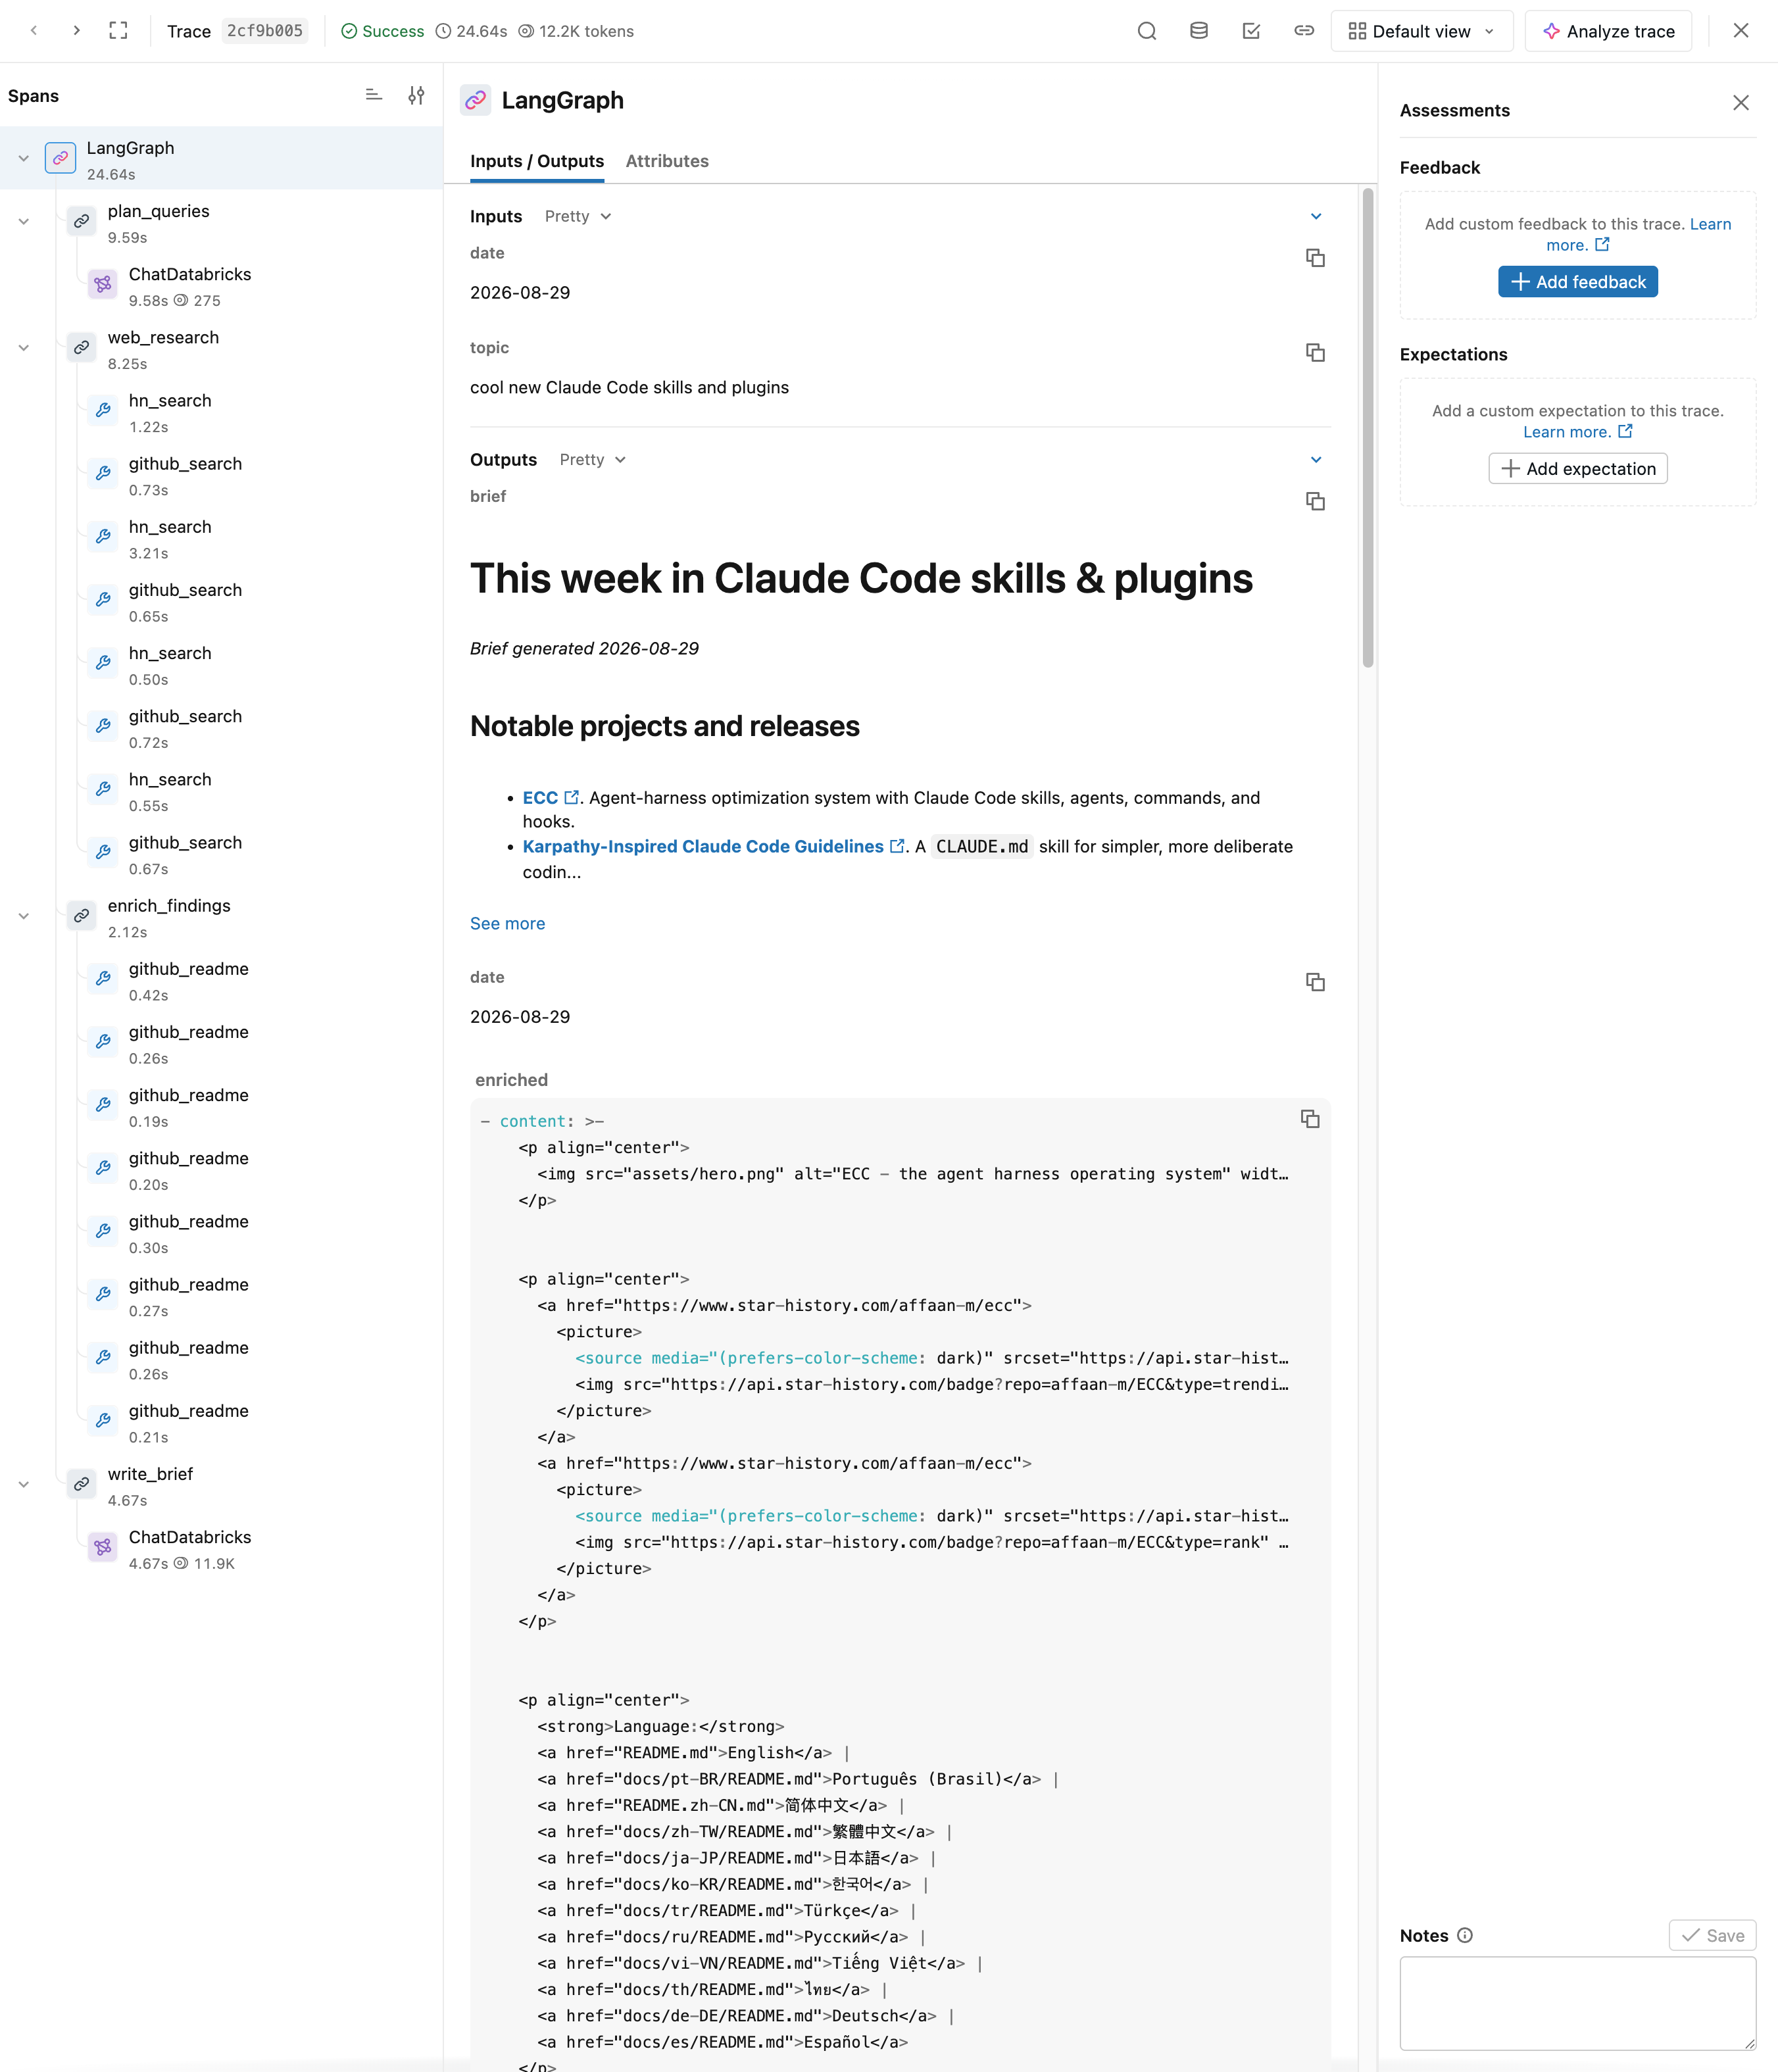
Cette trace est désormais un scénario de test : vous avez capturé la réponse attendue lors d’une interaction réelle et l’avez promue dans un dataset pour évaluer les versions futures. Puisque le retour d’expérience se trouve sur la trace, toute personne qui examine les traces, et pas seulement le développeur, peut effectuer cette opération sans quitter l’interface utilisateur de la trace.
Qui laisse des commentaires
Le feedback se présente sous deux formes : le feedback évalue la sortie réelle de l’application (la réponse était-elle bonne ?), et une expectation définit la sortie correcte de référence (vérité terrain). Chaque source de jugement possède son propre mécanisme.
Développeurs
Annotez les traces au fur et à mesure de votre conception pour suivre les notes de qualité et marquer des exemples en vue des tests de régression. Consultez la page Étiqueter les traces en tant que développeur.
Experts du domaine
Faites appel à des experts en la matière par l’intermédiaire de l’application d’évaluation pour définir ce à quoi ressemble une réponse de haute qualité et pour aligner les évaluateurs LLM sur vos exigences professionnelles. Il existe deux approches : Test an agent with the Chat UI ou Enable experts and collaborators to label traces.
Pour les nouveaux workflows d'examen humain, Databricks recommande les files d'attente d'examen (bêta), qui acheminent les traces et les enregistrements de dataset vers les réviseurs un par un.
Utilisateurs finaux
Recueillez les commentaires des utilisateurs de votre application déployée pour identifier les queries problématiques et préserver les interactions fructueuses. Voir Enrichir les traces : tags, contexte et commentaires.
Étapes suivantes
- Permettez à des experts et à des collaborateurs d'étiqueter les traces – Faites appel à des experts du domaine et à des collaborateurs pour étiqueter les traces.
- Créer des datasets d'évaluation MLflow - Packagez des traces étiquetées et des attentes dans un dataset.
- Évaluer et améliorer - Évaluez et améliorez votre application par rapport aux datasets que vous construisez.