Gérer le compute serverless
Cette page explique comment gérer l'accès au compute serverless et comment implémenter des limites de débit serverless. Les administrateurs du Workspace gèrent le compute Serverless à l'aide d'objets de compute Serverless intégrés. Un objet compute serverless est un type de ressource qui définit la limite d'autorisation pour les charges de travail serverless. Votre workspace obtient automatiquement deux objets de compute par default :
- Default Interactive Compute : régit l'accès aux notebooks et à Databricks Connect.
- Default Automated Compute : régit l’accès aux jobs et aux Spark Declarative Pipelines sur Lakeflow.
Par default, tous les utilisateurs du Workspace disposent de l'autorisation Can Use sur les deux objets ; les workloads existants continuent donc de s'exécuter sans aucune modification. Un administrateur de workspace peut supprimer des utilisateurs ou des groupes de l'un ou l'autre objet pour restreindre l'accès. Un utilisateur qui perd l'accès verra l'option de compute Serverless comme indisponible dans ses interfaces produit.
Gérer l’accès au compute serverless
Pour contrôler qui a accès au compute serverless, les administrateurs du workspace peuvent modifier les autorisations sur les objets Default Interactive Compute et Default Automated Compute . Les administrateurs du Workspace disposent de l'autorisation Can Manage par default, mais ils peuvent accorder cette autorisation à n'importe quel utilisateur. Ces objets de compute par default ne peuvent pas être renommés ni supprimés.

Chaque objet de compute serverless prend en charge deux niveaux d'autorisation :
Autorisation | Vous permet de |
|---|---|
Utilisation autorisée | Exécutez des charges de travail sur ce compute |
Gestion autorisée | Exécutez des charges de travail sur ce compute et modifiez les autorisations du compute |
Vous pouvez également gérer les autorisations pour les objets de compute Serverless par programmation à l’aide de l’ API Permissions. Les objets de compute Serverless utilisent le type d’objet serverless-compute, et chaque objet est identifié par son ID.
Restreindre l’accès aux requêtes interactives serverless
Pour limiter les personnes autorisées à utiliser le mode serverless pour les Notebooks et Databricks Connect :
- Cliquez sur Compute dans la barre latérale du workspace.
- Dans la Serverless tab , cliquez sur le menu kebab
 à côté de Default Interactive Compute , puis cliquez sur Edit permissions .
- Supprimez le groupe All Users ou le groupe qui inclut tous les utilisateurs du workspace.
- Ajoutez uniquement les utilisateurs, les groupes ou les Service Principals spécifiques que vous souhaitez autoriser.
Si vous révoquez les autorisations serverless interactives d’un utilisateur, les notebooks déjà connectés au serverless ne parviendront pas à se connecter lorsque l’utilisateur exécutera une cellule, et l’utilisateur ne verra plus l’option Serverless comme disponible dans le sélecteur de compute du notebook. S’ils tentent d’exécuter Databricks Connect, la demande de connexion échoue avec une erreur indiquant que l’utilisateur n’a pas accès au serverless.
Restreindre l’accès aux jobs et pipelines serverless
Pour limiter les personnes autorisées à utiliser le mode serverless dans les jobs et les pipelines :
- Cliquez sur Compute dans la barre latérale du workspace.
- Dans la Serverless tab , cliquez sur le menu kebab à côté de Default Automated Compute , puis cliquez sur Edit permissions .
- Supprimez le groupe All Users ou le groupe qui inclut tous les utilisateurs du workspace.
- Ajoutez uniquement les utilisateurs, les groupes ou les Service Principals spécifiques que vous souhaitez autoriser.
Si vous révoquez l'accès d'un utilisateur au default compute automatisé , les jobs et les pipelines qui s'exécutent en tant que cet utilisateur et utilisent cet objet de compute ne pourront pas s'exécuter. Les charges de travail qui sélectionnent un objet de compute automatisé personnalisé nécessitent une autorisation sur l'objet sélectionné.
Avant de révoquer l'accès d'un utilisateur à Default Automated Compute , auditez les jobs et les pipelines dont les utilisateurs concernés sont propriétaires. La requête suivante identifie les workloads serverless récents pour un utilisateur spécifique :
SELECT *
FROM system.billing.usage
WHERE usage_date >= date_add(now(), -30)
  AND billing_origin_product IN ('JOBS', 'DLT')
  AND identity_metadata.run_as = '<user_email>';
Vérifiez la colonne usage_metadata pour voir les ressources affectées, telles que les ID de Job et les ID de pipeline.
Auditer l’utilisation serverless
Les enregistrements de facturation serverless incluent un champ serverless_compute_id dans usage_metadata. Utilisez-le pour suivre l'objet de compute sur lequel une charge de travail a été exécutée :
SELECT
  usage_metadata.serverless_compute_id,
  identity_metadata.run_as,
  SUM(usage_quantity) AS total_dbus
FROM system.billing.usage
WHERE billing_origin_product IN ('JOBS', 'DLT', 'INTERACTIVE')
  AND usage_metadata.serverless_compute_id IS NOT NULL
  AND usage_date >= date_add(now(), -30)
GROUP BY 1, 2
ORDER BY 3 DESC;
Fonctionnalités de contrôle d’accès au compute serverless prises en charge
Les fonctionnalités suivantes sont intégrées aux contrôles d'accès au compute serverless.
Interactif (default Interactive compute)
- Notebooks et notebooks de l'AI Runtime
- Databricks Connect
Automatisé (Default Automated Compute)
- Jobs et jobs d'IA Runtime
- Spark Declarative Pipelines sur Lakeflow
Fonctionnalités de contrôle d'accès au compute serverless non prises en charge
Les fonctionnalités suivantes ne sont pas intégrées aux contrôles d’accès du compute serverless :
- Databricks SQL (DBSQL)
- Inférence par batch (
ai_query()) - Mise à disposition de modèles
- Endpoint de throughput provisionné de l'API Foundation Model
- Lakebase
- Databricks Apps
- Agent Evaluation et données synthétiques
- Indexation de recherche IA
- Optimisation prédictive
- profilage des données
- Contrôle d'accès granulaire sur compute dédié. L'accès au compute dédié détermine si un utilisateur peut utiliser le contrôle d'accès granulaire.
Pour toute fonctionnalité non répertoriée ici, contactez l’équipe de votre compte Databricks pour vous renseigner sur son statut.
Limitations du contrôle d’accès serverless
En cas de disruption de service, les contrôles d'accès pourraient échouer en mode ouvert, et les utilisateurs qui se verraient normalement refuser l'accès pourraient être en mesure de start des charges de travail serverless. Cette fonctionnalité est destinée à aider à régir l'accès au compute serverless. N'utilisez pas cette fonctionnalité pour garantir un plafond de dépenses absolu sur les montants finaux facturés. Databricks n'est pas responsable des coûts encourus par les charges de travail s'exécutant pendant un tel événement.
- Vous ne pouvez pas renommer ou supprimer les objets compute « default ».
- Les jobs et les pipelines qui utilisent le Default Automated Compute nécessitent des autorisations sur cet objet. Passez en revue les charges de travail actives avant de supprimer l'accès d'un utilisateur.
- Le compute en arrière-plan (jobs initiés par le système) est exempté des contrôles d'accès au compute Serverless.
Définir des limites de débit sur le compute serverless
Une limite de débit contrôle le niveau de mise à l'échelle automatique des exécuteurs Spark d'une charge de travail automatisée. Les administrateurs de Workspace peuvent créer des objets compute automatisés personnalisés et leur assigner une taille. Lorsqu'une charge de travail utilise l'objet compute, cette taille définit sa capacité maximale de mise à l'échelle automatique des exécuteurs Spark.
Les limites de vitesse s'appliquent uniquement aux charges de travail automatisées (Job et LakeFlow Pipelines). Les charges de travail interactives (notebooks et Databricks Connect) ne sont pas soumises à des limites de vitesse.
Une taille correspond à un taux de consommation approximatif en Databricks Unit (DBU) pour les exécuteurs Spark. Les limites de débit ne fixent pas une limite absolue sur le coût total de la charge de travail ou sur les montants finaux facturés. Ils ne plafonnent pas les coûts du Driver, de la machine virtuelle REPL, des GPU ou les coûts d’actualisation des materialized views et des streaming tables refresh.
La limite de débit s'applique indépendamment à chaque charge de travail qui utilise l'objet compute. Deux jobs qui utilisent le même objet compute reçoivent chacun le plafond complet. Dans un job, le plafond est partagé entre ses tâches serverless, même lorsque les tâches s’exécutent sur des clusters différents. Un objet compute n'impose pas de limite globale sur toutes les charges de travail qui l'utilisent.
Exigences relatives aux limites de débit
- Pour créer un objet compute Serverless, vous devez être administrateur du Workspace ou disposer des droits de création de clusters illimités.
- Pour modifier la taille ou les autorisations d’un objet compute personnalisé, vous devez disposer de l’autorisation Peut gérer sur cet objet.
- Pour exécuter une charge de travail sur un objet de compute, vous devez avoir l'autorisation Peut utiliser ou Peut gérer sur cet objet.
Créez un compute serverless avec une limite de débit
- Cliquez sur Compute dans la barre latérale du workspace.
- Dans l’onglet Serverless , cliquez sur Create serverless compute .
- Saisissez un nom.
- Pour Size , sélectionnez la limite de débit à appliquer, de Small à 2X-Large . Laissez le paramètre sur Default pour utiliser la limite par défaut de votre workspace.
- Cliquez sur « Créer ».
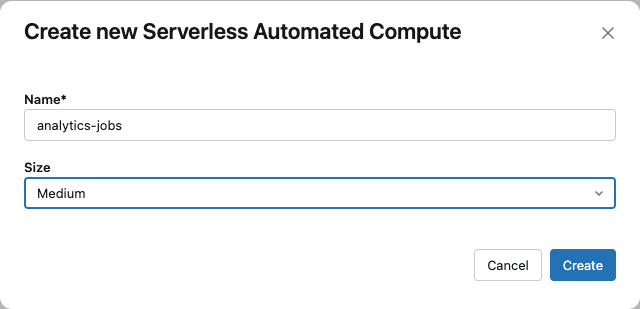
Le nouvel objet de compute apparaît sur le tab Serverless avec un type Automatisé . Accordez l’accès aux utilisateurs avant qu’ils exécutent des charges de travail dessus. Vous ne pouvez pas modifier la taille d’un objet de calcul default.
Accorder l'accès au compute limité en débit
- Sous le tab Serverless , ouvrez l’objet compute personnalisé.
- Cliquez sur Actions , puis sur Modifier les autorisations .
- Ajoutez les utilisateurs, les groupes ou les Service Principal qui doivent avoir accès.
- Accordez Peut utiliser pour exécuter des charges de travail, ou Peut gérer pour également modifier la taille et les autorisations.
- Cliquez sur Enregistrer .
Modifier une limite de vitesse
- Sous le tab Serverless , ouvrez l’objet compute personnalisé.
- Cliquez sur Modifier .
- Pour Taille , sélectionnez une taille.
- Cliquez sur Enregistrer .
Tailles des limites de débit
Les tailles suivantes correspondent à des taux de consommation approximatifs des exécuteurs Spark :
Taille | Taux de consommation approximatif de l’exécuteur |
|---|---|
Petit (Small) | ~60 DBU par heure |
Medium | ~120 DBU par heure |
Large | ~240 DBU par heure |
XL | ~480 DBU par heure |
XXL | ~960 DBU par heure |
Ces valeurs sont des estimations. L’utilisation réelle peut les dépasser en raison de la variabilité de l’infrastructure serverless et des coûts que la limite de débit ne couvre pas.
Choisir Default utilise la capacité d'autoscaling maximale existante de votre workspace pour les charges de travail serverless automatisées. La default dépend du niveau de votre Workspace et de toute limite spécifique au Workspace.
Exécuter une charge de travail sur un compute soumis à des limites de débit
Un utilisateur disposant de l’autorisation Can Use sur un objet compute peut le sélectionner lors de la configuration d’un job ou d’un pipeline. La charge de travail s’exécute ensuite selon la limite de débit du compute. Si une charge de travail ne spécifie pas d’objet compute, elle revient au Default Automated Compute de votre workspace. Si l’utilisateur n’a pas accès à ce default, la charge de travail ne peut pas s’exécuter.
- Jobs : dans les paramètres de compute du job, utilisez compute policy pour sélectionner l’objet de compute serverless automatisé. Le sélecteur peut également être intitulé Serverless compute . La liste affiche les objets de compute que l’identité d’exécution du job peut utiliser. Pour configurer un job avec l’API Jobs, voir Utiliser le compute limité par débit avec l’API Jobs.
- Pipelines : sélectionnez l’objet compute automatisé comme compute serverless pour un pipeline dans l’éditeur Lakeflow.
Lorsqu’une limitation de débit ralentit un pipeline, vous pouvez afficher l’impact dans l’historique des query du pipeline ou dans l’interface utilisateur de Lakeflow.
Utiliser le compute limité en débit avec l’API Jobs
Pour exécuter un job sur un objet compute à débit limité avec l’API Jobs, définissez un cluster de jobs qui définit serverless_compute.policy_id sur l’ID de l’objet compute. Il s’agit du même objet compute serverless automatisé que celui sélectionné comme politique de compute du job. Ensuite, définissez job_cluster_key sur chaque tâche serverless dans le job pour référencer ce cluster de jobs. Pour copier l’ID, dans l’onglet Serverless , cliquez sur le menu kebab de l’objet compute, puis cliquez sur Copier l’ID de compute .
{
  "job_clusters": [
    {
      "job_cluster_key": "rate_limited",
      "serverless_compute": { "policy_id": "<compute-id>" }
    }
  ],
  "tasks": [
    {
      "task_key": "ingest",
      "job_cluster_key": "rate_limited",
      "notebook_task": { "notebook_path": "/Workspace/Jobs/ingest" }
    },
    {
      "task_key": "transform",
      "job_cluster_key": "rate_limited",
      "notebook_task": { "notebook_path": "/Workspace/Jobs/transform" }
    }
  ]
}
Un job peut définir au plus un cluster de job qui définit serverless_compute. La même configuration s’applique lorsque vous créez, mettez à jour, Reset ou soumettez un Job, et lorsque vous déployez un Job avec Declarative Automation Bundles. Pour obtenir le schéma complet de la requête, consultez Créer un nouveau job dans la référence de l’API REST.
Le champ job_clusters[].serverless_compute_id est obsolète. Utilisez serverless_compute.policy_id à la place.
Limitations des limites de débit
- Les limites de débit plafonnent uniquement l'évolutivité automatique des exécuteurs Spark. Les autres composants de coût, tels que le driver, les VM REPL, les GPU et les refresh de vues matérialisées ou de tables de streaming, ne sont pas plafonnés.
- Le plafond de DBU par heure pour chaque taille est une estimation. L’utilisation réelle peut dépasser la cible en raison de légères fluctuations de la limite appliquée et de la variabilité inhérente à l’infrastructure serverless.
- Une charge de travail de taille 2X-Large peut présenter des performances inférieures aux attentes car la taille physique du cluster est plafonnée à 256 exécuteurs. Si deux charges de travail 2X-Large ou plus sont planifiées sur le même cluster d'exécution, chacune pourrait atteindre des performances inférieures aux attentes.
- En raison de détails liés à l’implémentation de la facturation, une même charge de travail peut entraîner une consommation de DBU différente selon les tailles de limite de débit.
- Vous ne pouvez pas définir de limite de débit sur un objet compute par default.