Migrer du compute classique au compute serverless
Migrez vos charges de travail du compute classique au compute serverless. Le compute serverless gère automatiquement le provisionnement, la mise à l'échelle, les mises à niveau d'exécution et l'optimisation.
La plupart des charges de travail classiques peuvent migrer avec des modifications de code minimes, voire aucune. Cette page se concentre sur ces charges de travail. Certaines fonctionnalités, telles que df.cache, ne sont pas encore prises en charge en mode Serverless, mais ne nécessiteront pas de modifications de code une fois disponibles. Certaines charges de travail qui dépendent des Notebooks R ou Scala nécessitent un compute classique et ne pourront pas migrer vers le serverless. Pour une liste complète des limitations actuelles, voir Limitations du compute Serverless.
Migrer avec l'agent de migration
Bêta
Cette fonctionnalité est en Beta. Les administrateurs du Workspace peuvent l’activer à partir de la page Previews en optant pour l’aperçu du Compute Agent . Consultez Manage Databricks previews.
Vous pouvez utiliser un agent de migration pour migrer un seul notebook ou job vers le compute Serverless. L’agent examine l’environnement, les bibliothèques, les configurations Spark, les tags et le code de la charge de travail, puis propose chaque modification sous forme de suggestion individuelle à accepter ou rejeter. Les modifications acceptées sont appliquées sur place et peuvent être annulées.
Ce que l'agent examine et modifie
Zone (Area) | Ce que fait l’agent |
|---|---|
Environnement et bibliothèques | Convertit les installations de bibliothèques en une spécification d'environnement serverless, y compris les installations |
Variables d'environnement | Traduit les variables d’environnement de cluster en leurs équivalents serverless, tout en préservant les références de secret du workspace et en omettant les valeurs gérées par la plateforme. |
Accès aux données et au stockage | Réécrit les chemins incompatibles avec serverless, tels que le disque local, |
Configurations Spark | Classifie chaque configuration Spark, met en commentaire les configurations qui peuvent être supprimées sans risque, et signale et supprime les configurations non prises en charge par le serverless. Couvre les configurations associées au cluster et intégrées au notebook. |
Code du Workload | Réécrit le code non pris en charge par serverless en équivalents compatibles, tels que les opérations RDD réécrites en opérations DataFrame, et ajuste le code pour le comportement SQL en mode ANSI sur serverless. |
Tags | Convertit les Cluster Tags personnalisés, tels qu'un tag de centre de coûts, en leurs équivalents Serverless. |
Mode performance | Suggère un mode de performance basé sur la configuration du cluster. Consultez Choisir un mode de performance. |
Conditions requises
-
Un accès administrateur Workspace est recommandé pour garantir une migration complète. Cela est dû au fait que l'agent examine également les scripts d'initialisation globaux au niveau du workspace au-delà du workload cible. Vous pourrez peut-être effectuer la migration si vous disposez de l'autorisation
CAN MANAGEsur le workload, mais sans les autorisations d'administrateur, cela peut entraîner l'absence de bibliothèques, de paramètres d'environnement ou de tags. -
Veuillez confirmer que vous avez accès à l'agent. Tapez
/computedans Genie Code./computedoit apparaître dans le menu de saisie semi-automatique. Si l'élément n'apparaît pas, un administrateur du workspace doit activer l'aperçu dans votre workspace.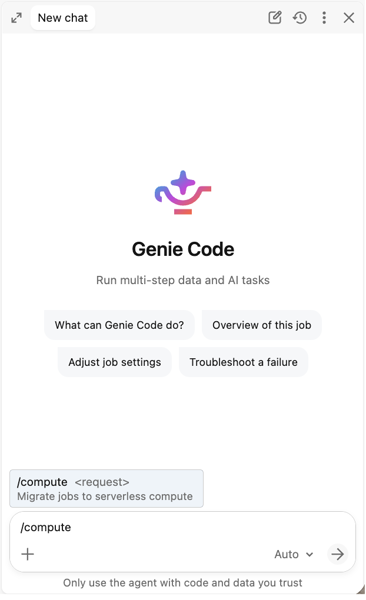
Migrer un notebook
- Ouvrez le notebook que vous souhaitez migrer.
- Ouvrez Genie Code et exécutez
/compute migrate to serverlessà partir de la palette de commandes/. - Examinez les conclusions de l’agent. L'agent analyse l'environnement, les bibliothèques, les configurations Spark, les tags et le code du notebook, puis propose une modification pour chaque élément qui le nécessite, telle que le déplacement d'une installation de bibliothèque dans une spécification d'environnement ou la réécriture d'une cellule de code pour s'exécuter sur Serverless.
- Acceptez ou rejetez chaque modification proposée.
- Appliquez les modifications que vous avez acceptées. Elles sont écrites directement dans le notebook.
- Connectez le notebook à serverless et exécutez-le pour confirmer qu'il se comporte comme vous l'attendez. Consultez Verifying a migrated workload.
Migrer un job
- Ouvrez le job que vous souhaitez migrer.
- Ouvrez Genie Code et exécutez
/compute migrate to serverlessà partir de la palette de commandes/. - L'agent clone votre job et tente de migrer le job cloné vers serverless.
- Examinez les conclusions de l’agent. Pour un job multitâche, l’agent énumère chaque tâche et sa configuration de cluster par tâche, et propose des modifications pour chacune tout en préservant la planification du job.
- Acceptez ou rejetez chaque modification proposée sur toute la surface de migration : environnement et bibliothèques, configurations Spark, ainsi que tout code de charge de travail devant être modifié.
- Appliquez les modifications que vous avez acceptées. Le compute du job est basculé vers le serverless.
- Exécutez le job sur serverless et confirmez les résultats. Consultez Verifying a migrated workload.
- Facultativement, comme dernière étape, l’agent promeut le clone migré. Il copie la configuration et les notebooks du clone directement sur votre job d’origine (en conservant les mêmes ID de job, planification et autorisations), puis supprime le clone. Si vous ignorez la promotion et conservez les deux jobs, suspendez la planification sur le job que vous n’exécutez pas, sinon le même trigger déclenchera les deux et pourra dupliquer les écritures ou d’autres effets secondaires.
Vérifier une charge de travail migrée
L'agent propose et applique des modifications, mais n'exécute pas votre charge de travail et n'en vérifie pas le résultat. Exécutez toujours une charge de travail migrée sur serverless et confirmez les résultats avant de vous y fier, en particulier pour les charges de travail qui écrivent dans des tables de production. Si l'agent propose une modification qui semble incorrecte, rejetez-la et envoyez-nous vos commentaires afin que nous puissions l'améliorer. Consultez Submit produit feedback.
Pendant que vous validez une charge de travail migrée, exécutez-la en mode optimisé pour les performances. Il démarre plus rapidement que le mode standard, ce qui vous permet d'obtenir un retour plus rapide lorsque vous confirmez les résultats. Passez au mode qui convient le mieux à la charge de travail avant de l'exécuter en production. Consultez Choisir un mode de performance.
Lorsque l’agent détecte un élément qu’il ne peut pas migrer en toute sécurité, il signale un blocage et s’arrête par default. Vous pouvez lui donner des instructions explicites pour contourner certains blocages de compatibilité ou de dépendance, mais vous acceptez ainsi le risque que ces dépendances, l’attribution des coûts ou le comportement d’exécution ne soient pas reportés, et la charge de travail risque d’échouer sur Serverless.
Annuler les modifications de la migration
Les modifications appliquées par l'agent sont réversibles.
Pour un notebook, ouvrez-le et restaurez la révision datant d'juste avant la migration. Consultez Historique des versions dans les notebooks Databricks.
Pour un job, si vous n'avez pas promu le clone migré, votre job d'origine n'a jamais été modifié : exécutez-le comme avant et supprimez le clone. Si vous avez promu le clone, restaurez-le à partir de la sauvegarde écrite par l'agent avant qu'il n'apporte de modifications :
- Ouvrez le dossier de sauvegarde dans le dossier d'accueil de votre workspace :
/Workspace/Users/<your-username>/serverless-migration/backups/job-<job-id>/<timestamp>/. L'agent a indiqué ce chemin pendant la migration. S'il y a plusieurs timestamps, choisissez celui qui précède immédiatement la migration. - Ouvrez
job.yaml, qui contient vos paramètres de job d’avant la migration, et appliquez ces paramètres au même job avec une requêtePOST /api/2.2/jobs/reset, ce qui remplace les paramètres du job par ceux que vous fournissez. Vous pouvez également les coller dans la définition JSON du job dans l’interface utilisateur. Cette opération rétablit le compute classique pour le job. - Ouvrez
mapping.yaml, qui répertorie chaque fichier sauvegardé et son chemin d'origine. Copiez chaque fichier de sauvegarde sur son chemin d'origine pour annuler les réécritures de code. - Exécutez le job pour confirmer qu'il se comporte comme avant la migration.
La migration ne supprime jamais cette sauvegarde. Les tâches que l'agent n'a pas modifiées, telles que les tâches basées sur Git, SQL ou dbt, sont enregistrées dans job.yaml, mais leurs fichiers ne sont pas copiés dans la sauvegarde ; restaurez-les donc à partir de votre source de vérité si nécessaire.
Limitations connues
-
Les éléments suivants sont signalés comme des blocages : les images personnalisées, les variantes de ML Runtime, les versions de Databricks Runtime antérieures à la version 13, les profils d'instance, les configurations Spark qui ne peuvent pas être ignorées en toute sécurité sur Serverless, ainsi que les dépendances telles que les fichiers egg, les fichiers JAR et les bibliothèques Maven. Un blocage signifie que l'agent s'arrête au lieu de migrer cet élément. Vous pouvez soit le résoudre vous-même et relancer la migration, soit demander à l'agent de migrer malgré tout, ce qui laisse cet élément non résolu et peut provoquer l'échec de la charge de travail sur Serverless.
-
L'agent lit les scripts d'initialisation stockés dans les fichiers du Workspace ou les volumes Unity Catalog. Les scripts d'initialisation stockés sur S3 ou DBFS ne peuvent pas être lus et sont signalés comme des blocages.
-
L’agent n’inspecte pas chaque attribut de classic compute. La livraison de log de cluster et les clés SSH ne sont pas modélisées et, bien que l’outil détecte de nombreuses dépendances de montage DBFS à partir du code de workload, il n’énumère ni ne résout chaque montage.
-
Les APIs de cache et de point de contrôle, les vues temporaires globales, les appels de gestion de montage DBFS et le code Scala ou R constituent des bloqueurs stricts by default. Vous pouvez demander à l’agent de continuer, mais la fonctionnalité non résolue reste inchangée et peut échouer sur Serverless.
-
Les jobs comportant plus de 10 tâches migrables ne peuvent pas être migrés pour l'instant.
-
L’agent migre les workloads un par un. Il n’y a pas de découverte à l’échelle de la flotte, de migration en masse ni de workflow d’approbation administrateur.
-
L’agent propose des modifications et applique celles que vous acceptez, mais il n’exécute pas votre charge de travail et ne vérifie pas l’exactitude des sorties. Vérifiez une charge de travail migrée avant de vous y fier pour les données de production.
-
Si la source de vérité de votre charge de travail est un Databricks Asset Bundle ou un dossier Git, l'agent applique les modifications directement sur l'objet du Workspace. Rapprochez ces modifications de votre bundle ou de votre repository afin qu'un déploiement ultérieur n'écrase pas la migration.
Migrer vers Serverless manuellement
Pour migrer vos charges de travail du compute classique vers le compute Serverless, suivez ces étapes :
- Vérifier les prérequis : Vérifiez que votre workspace, votre réseau et l'accès au stockage cloud répondent aux exigences. Voir Avant de commencer.
- Mettre à jour le code : apportez toutes les modifications nécessaires au code et à la configuration. Consultez Mettre à jour votre code.
- **Testez vos charges de travail** : Validez la compatibilité et l'exactitude avant le basculement. Voir Testez vos charges de travail.
- Choisissez un mode de performance : Sélectionnez le mode de performance qui correspond le mieux à vos exigences de charge de travail. Voir Choisir un mode de performance.
- Migration par phases : Déployez Serverless progressivement, en commençant par les workloads nouveaux et à faible risque. Voir Migrer par phases.
- Surveiller les coûts : suivre la consommation de DBU serverless et configurer des alertes. Voir Surveiller les coûts.
Avant de commencer
Avant de commencer la migration, vous pourriez avoir besoin de mettre à jour certaines configurations héritées dans votre Workspace.
Prérequis | Action | Détails |
|---|---|---|
Workspace est activé pour Unity Catalog | Migrer depuis Hive metastore si nécessaire | |
Réseau configuré | Remplacez le peering Virtual Private Cloud (VPC) par les NCC, Private Link ou les règles de pare-feu. | |
Accès au stockage cloud | Remplacez les modèles d'accès aux données hérités par les emplacements externes Unity Catalog. | Connectez-vous au stockage d'objets cloud à l'aide de Unity Catalog |
Remplacez les montages DBFS qui utilisent des profils d'instance par des emplacements externes Unity Catalog.
Mettez à jour votre code
Les sections suivantes énumèrent les modifications de code et de configuration requises pour rendre vos charges de travail compatibles avec le serverless.
Accès aux données
Les modèles d'accès aux données hérités ne sont pas pris en charge sur serverless. Mettez à jour votre code pour utiliser Unity Catalog à la place.
Modèle classique | Remplacement Serverless | Détails |
|---|---|---|
Chemins DBFS ( | Volumes du Unity Catalog | |
Tables du Hive Metastore | Tables Unity Catalog (ou fédération HMS) | |
Profils d'instance IAM | Emplacements externes Unity Catalog | Connectez-vous au stockage d'objets cloud à l'aide de Unity Catalog |
JAR JDBC personnalisés | Lakehouse Federation |
L'accès DBFS est limité sur serverless. Mettre à jour tous les dbfs:/ chemins vers des volumes Unity Catalog avant la migration. Pour plus d'informations, consultez Migrer les fichiers stockés dans DBFS.
Exemple : Remplacez les chemins DBFS et les références au Hive metastore
# Classic
df = spark.read.csv("dbfs:/mnt/datalake/data.csv", header=True)
df.write.parquet("dbfs:/mnt/output/results")
df = spark.table("my_database.my_table")

# Serverless
df = spark.read.csv("/Volumes/main/sales/raw_data/data.csv", header=True)
df.write.parquet("/Volumes/main/analytics/output/results")
df = spark.table("main.my_database.my_table")  # three-level namespace
APIs et code
Certaines APIs et certains modèles de code ne sont pas pris en charge sur Serverless. Référez-vous à cette table pour voir si votre code doit être mis à jour.
Modèle classique | Remplacement Serverless | Détails |
|---|---|---|
RDD APIs ( | DataFrame APIs | |
| Supprimer les appels de mise en cache | |
| Utilisez | |
Variables Hive ( | SQL | |
Configurations Spark non prises en charge | Supprimez les configurations non prises en charge. Serverless configure automatiquement la plupart des paramètres. | Configurez les propriétés Spark pour les Notebooks et les Jobs serverless. |
Exemple : remplacer les opérations RDD par des DataFrames
from pyspark.sql import functions as F

# sc.parallelize + rdd.map
# Classic:  rdd = sc.parallelize([1, 2, 3]); rdd.map(lambda x: x * 2).collect()
df = spark.createDataFrame([(1,), (2,), (3,)], ["value"])
result = df.select((F.col("value") * 2).alias("value")).collect()

# rdd.flatMap
# Classic:  sc.parallelize(["hello world"]).flatMap(lambda l: l.split(" ")).collect()
df = spark.createDataFrame([("hello world",)], ["line"])
words = df.select(F.explode(F.split("line", " ")).alias("word")).collect()

# rdd.groupByKey
# Classic:  rdd.groupByKey().mapValues(list).collect()
df = spark.createDataFrame([("a", 1), ("b", 2), ("a", 3)], ["key", "value"])
grouped = df.groupBy("key").agg(F.collect_list("value").alias("values")).collect()

# rdd.mapPartitions → applyInPandas
import pandas as pd
def process_group(pdf: pd.DataFrame) -> pd.DataFrame:
    return pd.DataFrame({"total": [pdf["id"].sum()]})
result = (spark.range(100).repartition(4)
    .groupBy(F.spark_partition_id())
    .applyInPandas(process_group, schema="total long").collect())

# sc.textFile → spark.read.text
df = spark.read.text("/Volumes/catalog/schema/volume/file.txt")
Exemple : remplacer SparkContext et la mise en cache
from pyspark.sql.functions import broadcast

# sc.broadcast → broadcast join
result = main_df.join(broadcast(lookup_df), "key")

# sc.accumulator → DataFrame aggregation
total = df.agg(F.sum("amount")).collect()[0][0]

# sqlContext.sql → spark.sql
result = spark.sql("SELECT * FROM main.db.table")

# df.cache() → remove caching calls
# Materialize expensive intermediate results to Delta as a workaround:
df = spark.read.parquet(path)
result = df.filter("status = 'active'")
expensive_df.write.format("delta").mode("overwrite").saveAsTable("main.scratch.temp")
result = spark.table("main.scratch.temp")
Bibliothèques et environnements
Vous pouvez gérer les bibliothèques et les environnements au niveau du Workspace à l'aide des environnements de base et au niveau du Notebook à l'aide de l'environnement Serverless du Notebook.
Modèle classique | Remplacement Serverless | Détails |
|---|---|---|
Scripts d'initialisation | Environnements Serverless | |
Bibliothèques limitées aux clusters | Bibliothèques à portée du Notebook ou d'environnement | |
Bibliothèques Maven/JAR | Prise en charge des tâches JAR pour les Job ; PyPI pour les Notebook | |
Conteneurs Docker | Environnements serverless pour les besoins des bibliothèques |
Pin Python packages in requirements.txt pour des environnements reproductibles. Voir Spécifier les versions de package Python.
streaming
Les workloads de streaming sont pris en charge sur Serverless, mais certains triggers ne le sont pas. Mettez à jour votre code pour utiliser les Trigger pris en charge.
Trigger Spark | Pris en charge | Notes |
|---|---|---|
| Oui | Recommandations |
| Oui | Ceci est obsolète. Utilisez |
| Non | Renvoie |
| Non | Utilisez plutôt le mode continu des Lakeflow pipelines. |
default (sans définir | Non | L’omission de |
Pour le streaming continu, migrez vers les Spark Declarative Pipelines en mode continu ou utilisez des jobs à planification continue avec AvailableNow. Pour les sources volumineuses, définissez maxFilesPerTrigger ou maxBytesPerTrigger pour éviter les erreurs de mémoire insuffisante.
Exemple : correction des triggers de streaming
# Classic (not supported on serverless — default trigger is ProcessingTime)
query = df.writeStream.format("delta").outputMode("append").start()

# Serverless (explicit AvailableNow trigger)
query = (df.writeStream.format("delta").outputMode("append")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
query.awaitTermination()

# With OOM prevention for large sources
query = (spark.readStream.format("delta")
    .option("maxFilesPerTrigger", 100)
    .option("maxBytesPerTrigger", "10g")
    .load(input_path)
    .writeStream.format("delta")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
Testez vos charges de travail
- Test de compatibilité rapide : Exécutez la charge de travail sur le compute classique avec le mode d'accès Standard et Databricks Runtime 14.3 ou versions ultérieures. Si l'exécution réussit, la charge de travail peut migrer vers Serverless sans aucune modification de code.
- Comparaison A/B (recommandé pour la production) : Exécutez la même charge de travail sur un cluster classique (contrôle) et serverless (expérimentation). Comparer les tables de sortie et vérifier l'exactitude. Itérer jusqu'à ce que les sorties correspondent.
- Configurations temporaires : Vous pouvez temporairement définir des configurations Spark prises en charge pendant les tests. Supprimez-les une fois stables.
Choisir un mode de performance
Les jobs et pipelines Serverless prennent en charge deux modes de performance : standard et optimisé pour les performances. Le mode de performance que vous choisissez dépend de vos exigences en matière de charge de travail.
Mode | Disponibilité | Startup | Idéal pour |
|---|---|---|---|
Standard | Tâches, LakeFlow Pipelines | de 4 à 6 minutes | Batch sensible aux coûts |
Optimisé pour la performance | Notebooks, Jobs, LakeFlow Pipelines | secondes | Interactif, sensible à la latence |
Migrez par phases
- Nouvelles charges de travail : Start tous les nouveaux notebooks et Jobs sur Serverless.
- Charges de travail à faible risque : Migrez les charges de travail PySpark/SQL déjà en mode d'accès standard et sous Databricks Runtime 14,3 ou version supérieure.
- Charges de travail complexes : migrez les charges de travail nécessitant des modifications de code (réécritures RDD, mises à jour DBFS, corrections de Trigger).
- Charges de travail restantes : examinez-les périodiquement à mesure que les capacités s'étendent.
Surveillance des coûts
La facturation Serverless est basée sur la consommation de DBU, et non sur le temps d'activité des clusters. Validez les prévisions de coûts avec des charges de travail représentatives avant de migrer à grande échelle. Pour les outils et stratégies de surveillance des coûts Serverless, voir Surveiller le coût du compute Serverless.
Ressources supplémentaires
- Bonnes pratiques pour le compute Serverless: conseils d'optimisation pour les workloads Serverless
- Limitations du compute Serverless: Liste complète des limitations actuelles et des fonctionnalités non prises en charge
- Configurer l'environnement Serverless: Gérer les bibliothèques et les dépendances
- Configurations Spark prises en charge: configurations Spark disponibles sur Serverless
- Spark Connect vs. Spark classique: différences de comportement dans l'architecture serverless
- Sécurité réseau Serverless: NCC, Private Link et configuration du pare-feu
- Notes de publication du calcul Serverless: suivez les nouvelles fonctionnalités au fur et à mesure de leur déploiement.
- Guide de mise à niveau vers Unity Catalog: Migrez de Hive Metastore vers Unity Catalog
Vous pouvez également vous référer aux billets de blog suivants pour plus d'informations :
- Qu'est-ce que le calcul Serverless ?: Aperçu des capacités Serverless et des résultats clients
- Évolution de l'ingénierie des données : comment le compute serverless transforme les notebooks et les Lakeflow Jobs: comment le serverless alimente les Lakeflow Jobs et les pipelines