Utiliser le Serverless partagé pour les dossiers et bundles Git
Bêta
Cette fonctionnalité est en version bêta. Pour l’utiliser, un administrateur de workspace doit activer Compute partagé à portée du projet depuis la page Aperçus . Consultez Gérer les aperçus Databricks.
Avec le serverless partagé, les notebooks et les fichiers dans le même dossier ou bundle Git partagent le compute serverless et un environnement Python dans l’éditeur. Pour personnaliser l’environnement, ajoutez un fichier pyproject.toml à la racine du dossier. Choisissez l’option de compute pour votre dossier ou bundle Git :
- Git folders, avec Shared Serverless for Git Folders.
- Declarative Automation Bundles, avec Shared Serverless for Asset Bundles.
Exigences
- Votre workspace doit remplir les conditions requises du compute serverless.
- Ouvrez votre dossier Git ou votre bundle dans l’éditeur de dossier Git ou l’éditeur de bundle. Voir Créer et gérer des dossiers Git et Créer des bundles dans le workspace.
- Le Serverless partagé nécessite une version 5 ou supérieure de l'environnement serverless.
Compute et environnement partagés
- Les notebooks et les fichiers situés dans le même dossier ou bundle Git partagent le compute et un environnement Python dans l'éditeur. Un fichier
pyproject.tomloptionnel à la racine du dossier définit l'environnement partagé. - Seuls les Notebook et les fichiers situés dans le dossier Git ou le bundle associé peuvent être associés à sa ressource compute partagée.
- Les ressources de compute partagées sont isolées par utilisateur. Seul l’utilisateur qui attache en premier un notebook ou un fichier à une ressource de compute partagée peut y exécuter des charges de travail.
- L’exécution du notebook reste isolée. Les variables Python définies dans un notebook ne sont pas disponibles dans un autre notebook.
- Un terminal web ouvert depuis un Notebook ou un fichier joint s’exécute sur la même ressource de compute.
Serverless partagé pour les dossiers Git
Utilisez le serverless partagé pour les dossiers Git afin de travailler avec des notebooks et des fichiers dans un dossier Git.
Attacher des Notebook et des fichiers dans l’éditeur de dossier Git
-
Dans la barre latérale du workspace, cliquez sur Workspace et accédez au dossier Git.
-
Cliquez sur Ouvrir dans l’éditeur .
-
Ouvrir un notebook ou un fichier dans le dossier Git.
-
Cliquez sur le menu déroulant du compute.
-
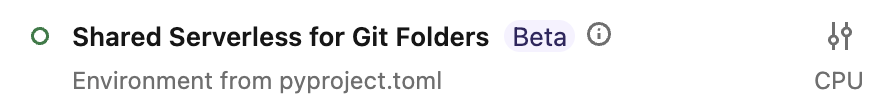
Sélectionnez Serverless partagé pour les dossiers Git .
-
Exécutez le notebook ou le fichier pour start la ressource de compute.
Pour utiliser le même compute à partir d’un autre notebook ou fichier, ouvrez-le dans le même dossier Git et sélectionnez Shared Serverless for Git Folders .
Collaborer via Git
Databricks recommande que chaque collaborateur clone le repository dans un dossier Git situé dans son dossier de workspace personnel. Chaque collaborateur obtient ensuite une ressource de compute et un environnement distincts pour son clone.
Utilisez des Branch, des commits, des pushs et des pulls pour échanger des modifications via le repository Git distant. Voir Collaborer dans les dossiers Git.
Serverless partagé pour les bundles d’asset
Utilisez Shared Serverless for Asset Bundles pour travailler avec des notebooks et des fichiers dans un bundle dans le workspace. La racine du bundle contient databricks.yml et peut contenir un fichier pyproject.toml qui définit l’environnement partagé.
Attacher des notebooks et des fichiers dans l'éditeur de bundle
- Dans la barre latérale du workspace, cliquez sur Workspace et accédez au bundle.
- À droite du nom du bundle, cliquez sur Ouvrir dans l’éditeur .
- Ouvrez un notebook ou un fichier dans le bundle.
- Cliquez sur le menu déroulant du compute.
- Sélectionnez Shared Serverless for Asset Bundles .
- Exécutez le notebook ou le fichier pour start la ressource de compute.
Pour utiliser le même compute depuis un autre notebook ou fichier, ouvrez-le dans le même bundle et sélectionnez Shared Serverless for Asset Bundles .
Pour collaborer via Git, demandez à chaque collaborateur de cloner le repository dans un dossier Git situé dans son dossier de workspace personnel. Voir Collaborer via Git.
Gérer l’environnement avec pyproject.toml
Le Serverless partagé utilise le fichier pyproject.toml à la racine du dossier Git ou du bundle pour gérer les dépendances Python du projet. Les notebooks serverless standard utilisent des dépendances configurées pour chaque notebook dans le volet latéral Environnement .
Créez le fichier racine pyproject.toml et définissez sa version d’environnement serverless avant de gérer ses dépendances. Voir Créer et modifier pyproject.toml. Vous pouvez ensuite ajouter des dépendances avec des commandes de notebook ou modifier le fichier directement.
Utiliser les commandes de notebook
-
Ouvrez un notebook attaché à Shared Serverless for Git Folders ou à Shared Serverless for Asset Bundles .
-
Exécutez
%uv add <package>pour ajouter une dépendance au fichierpyproject.tomlracine. Par exemple :Python%uv add cowsay
La commande met à jour pyproject.toml, uv.lock et l’environnement partagé. Vous n’avez pas besoin d’exécuter %uv sync après %uv add. Utilisez %uv sync pour appliquer les modifications apportées directement à pyproject.toml.
Créer et modifier pyproject.toml
-
Ouvrez un notebook attaché à Shared Serverless for Git Folders ou à Shared Serverless for Asset Bundles .
-
Ouvrez le volet latéral Environnement .
-
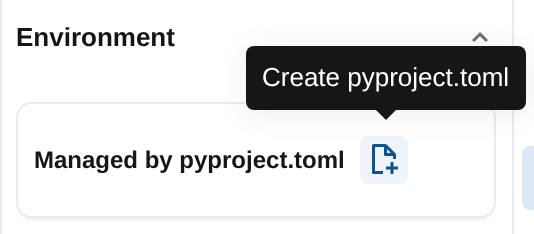
Dans la carte Géré par pyproject.toml , cliquez sur
 Créer pyproject.toml pour créer le fichier racine. Si le fichier existe déjà, cliquez sur
 Afficher pyproject.toml . Le fichier s’ouvre dans l’éditeur.
-
Modifiez la liste
dependencies. Gardez la section[tool.databricks.environment]générée, ou ajoutez-la si elle est manquante. Définissezenvironment_versionsur une version prise en charge (5 et plus). Par exemple :Toml[project]name = "my-project"version = "0.1.0"dependencies = ["simplejson==3.18.1",][tool.databricks.environment]environment_version = "5" -
Cliquez sur Apply en haut de l'éditeur de fichiers
pyproject.toml.
L'environnement mis à jour est disponible pour les notebooks et les fichiers attachés à la même ressource de compute partagée. Pour inspecter l’environnement, ouvrez le panneau latéral Environment . Voir Configurer l’environnement serverless pour plus d’informations sur les versions de l’environnement serverless et les dépendances installées.
Planifier un notebook
Lorsque vous planifiez un notebook attaché à Shared Serverless depuis le dossier Git ou l’éditeur de bundle, Databricks utilise le fichier racine pyproject.toml comme environnement de projet du job s'il existe. Déployez le bundle comme décrit dans les étapes suivantes.
- Dans l'éditeur de dossier ou de bundle Git, ouvrez un notebook attaché au serverless partagé.
- Si le dossier Git ou le bundle possède un fichier racine
pyproject.toml, vérifiez qu’il déclare les dépendances nécessaires à la tâche. - Cliquez sur Planning .
- Dans la liste déroulante Compute , sélectionnez un compute serverless.
- Configurez le planning et cliquez sur Créer .
Après avoir cliqué sur Créer , vérifiez la configuration du job :
-
Dossier Git : si le dossier Git possède un fichier
pyproject.tomlracine, vérifiez que l’ Environnement du projet dans la configuration de la tâche du job pointe vers celui-ci. Pour modifier la sélection, consultez Configurer l’environnement pour les tâches de job. -
Bundle : l’éditeur de bundles ouvre un fichier YAML de Job généré dans le dossier
resources/.- Si le bundle possède un fichier
pyproject.tomlracine, vérifiez queproject_environmentsous lespecde l’environnement pointe vers celui-ci, par rapport au fichier YAML généré. Voir Configurer un environnement de projet dans un bundle. - Déployez le bundle pour créer le job.
Les plannings sont suspendus default en mode développement. Voir Modes de déploiement des Declarative Automation Bundles.
- Si le bundle possède un fichier
Pour les options de planification des Notebook, voir Créer et gérer des Job de Notebook planifiés.
Limitations
- Le partage de compute est limité à une politique d’utilisation serverless. Les notebooks et les fichiers du même dossier Git ou bundle utilisant des politiques d'utilisation différentes se voient attribuer des ressources de compute distinctes au lieu d'en partager une.