Types de messages
Lorsque vous ingérez des données avec les SDK Zerobus Ingest via gRPC, vous choisissez le mode d'encodage des enregistrements sur un Stream donné. Zerobus Ingest prend en charge quatre formats de message pour que vous puissiez équilibrer la simplicité, la sécurité de type et le throughput de votre workload : JSON, Protocol Buffers (protobuf), Apache Arrow et Avro (Bêta). Chaque format est validé par rapport au schéma de votre table Delta avant que les données ne soient rendues durables. Voir Gestion des schémas.
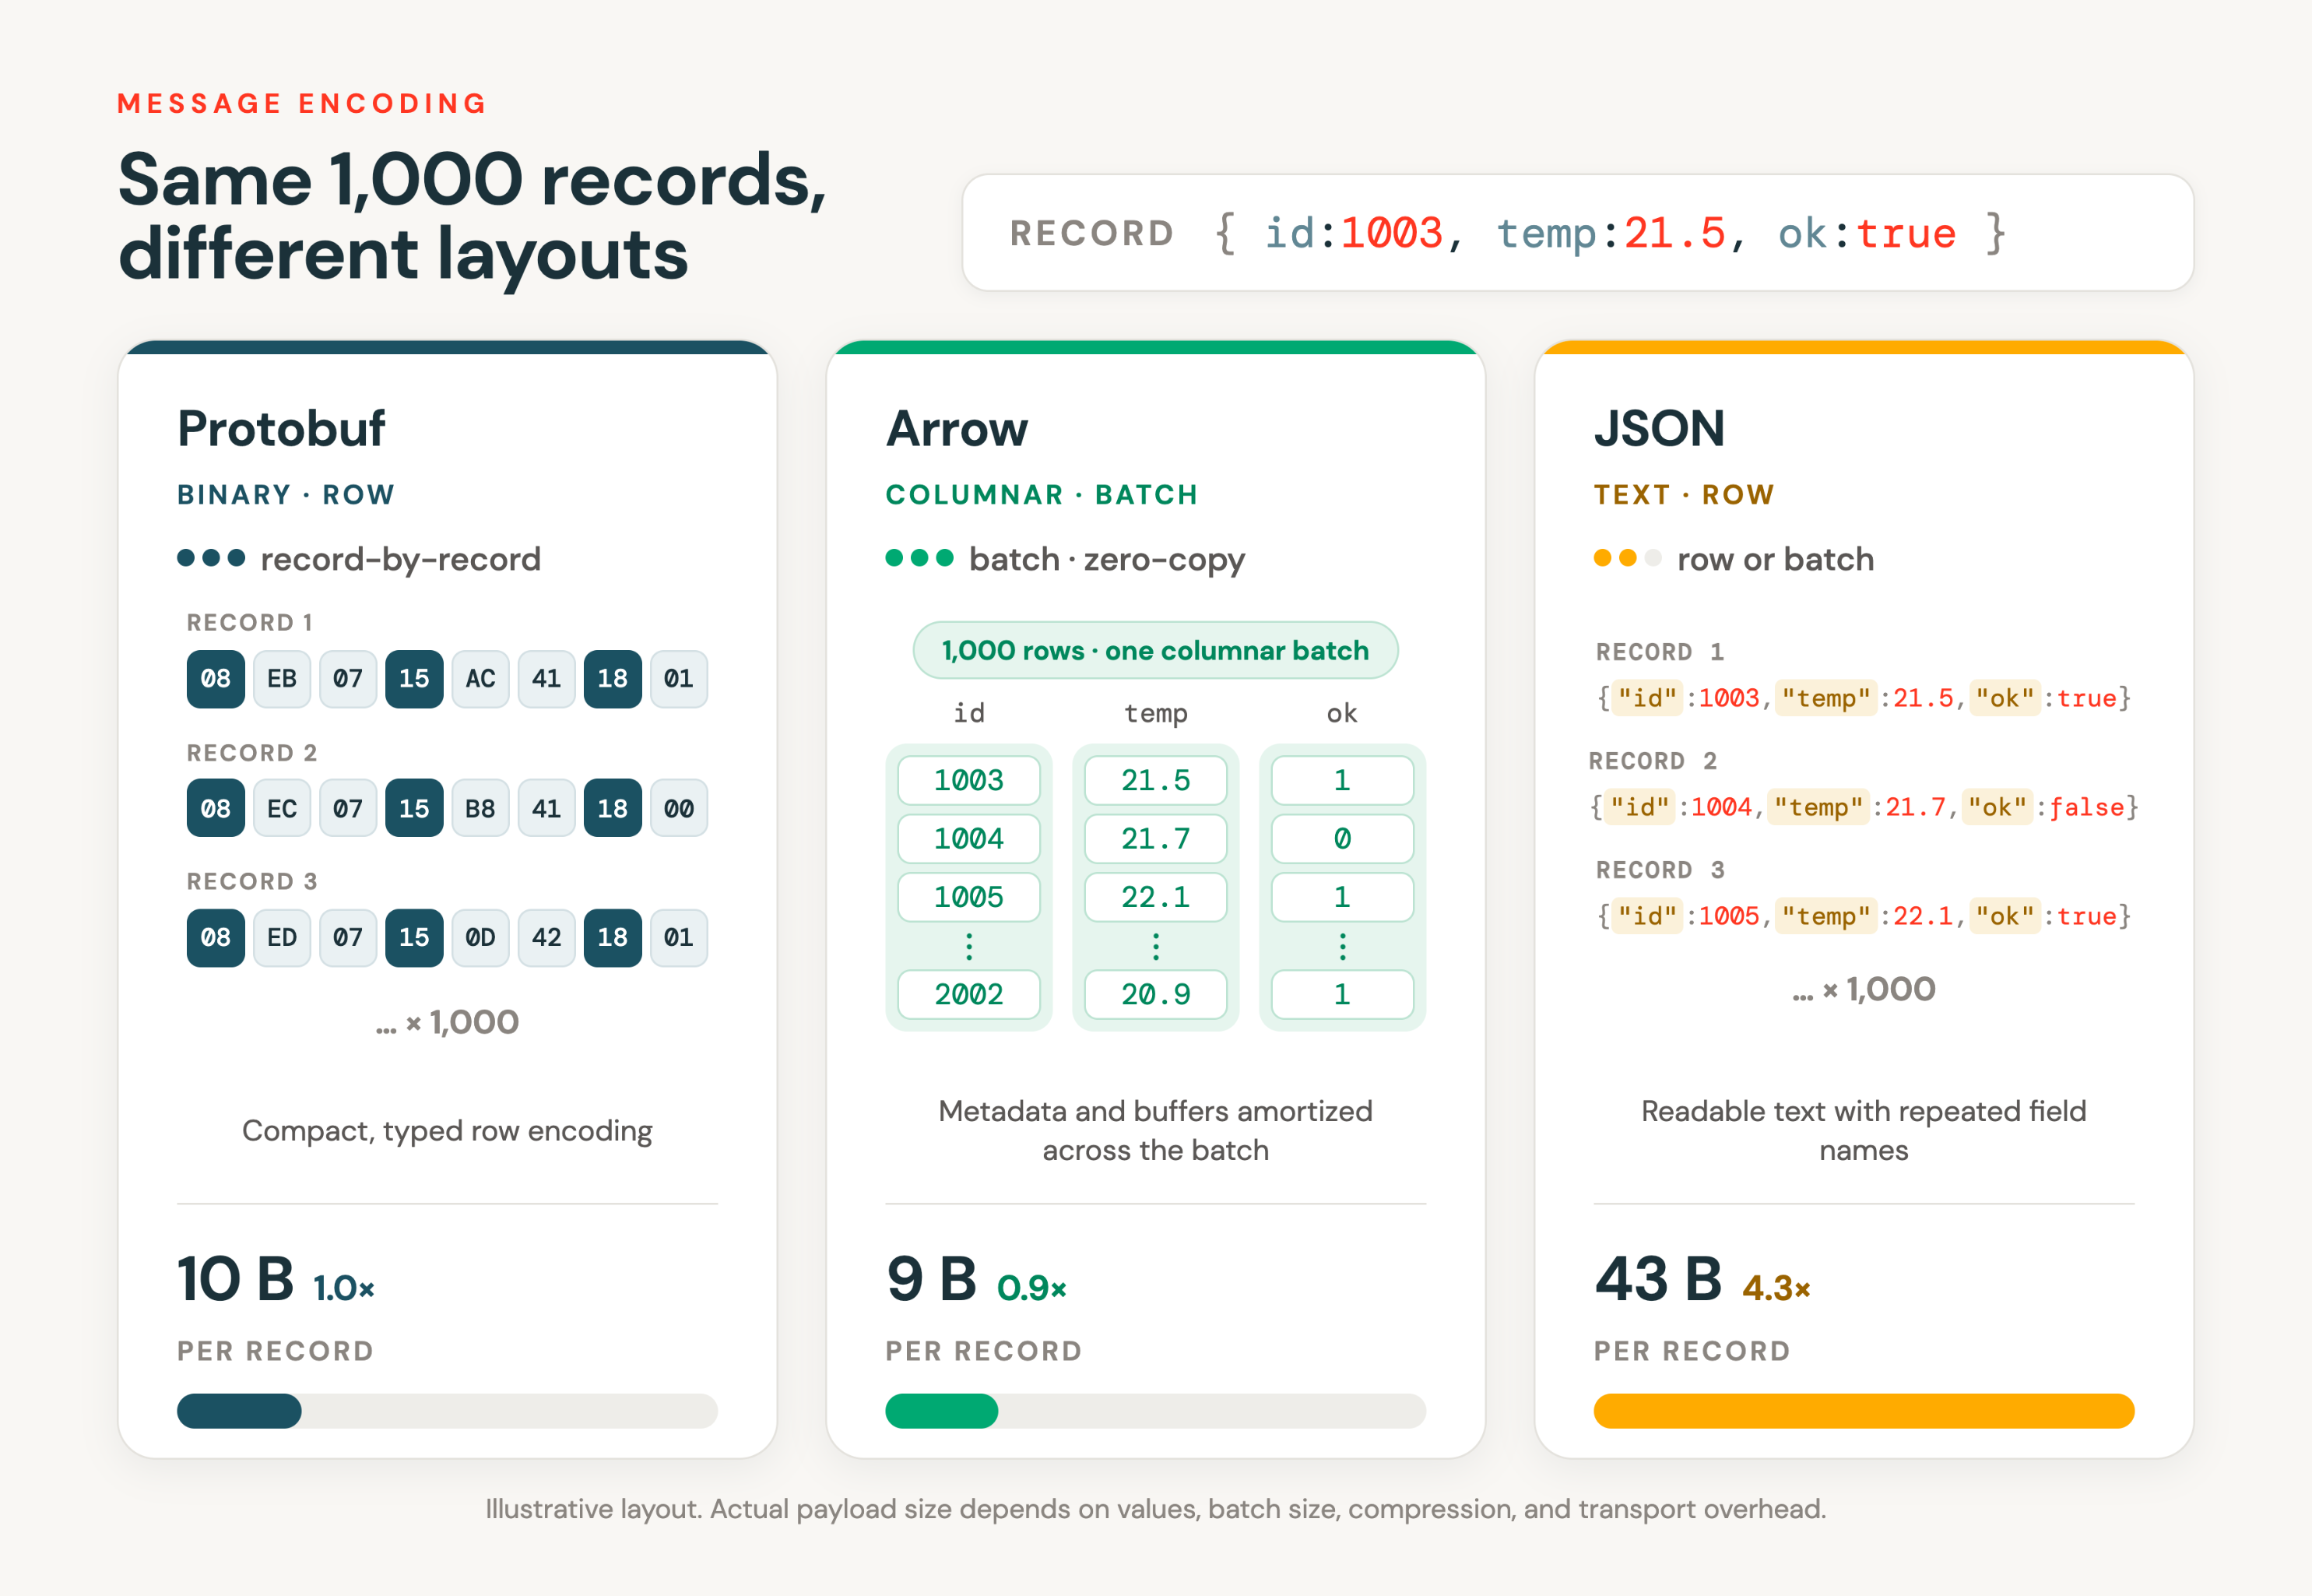
Le schéma montre JSON, protobuf et Apache Arrow. Il ne comprend pas Avro, qui utilise un encodage compact orienté lignes similaire à protobuf.
Quel format devez-vous utiliser ?
Format | Idéal pour | Notes |
|---|---|---|
JSON | Getting start et producteurs simples. | L'option la plus simple, sans définition de schéma à compiler. Pratique, mais plus lent que les formats binaires pour les charges de travail à haut volume. |
Protocol Buffers | Production, orientés ligne et à haut volume Stream. | Encodage binaire compact et sécurisé par le typage. Recommandé pour la plupart des charges de travail de production. Nécessite un schéma compilé. |
Apache Arrow | Charges de travail orientées colonnes ou par lots. | Envoie directement des batchs d'enregistrements Apache Arrow, évitant ainsi la sérialisation ligne par ligne. Idéal lorsque vos données sont déjà en colonnes ou que vous effectuez une ingestion par batch. Consultez Use Arrow Flight with Zerobus Ingest. |
Avro (Bêta) | Producteurs orientés lignes qui fonctionnent déjà avec Avro. | Encodage binaire orienté ligne compact décrit par un schéma JSON, une alternative à protobuf. |
Les extraits ci-dessous montrent la forme de chaque format dans le SDK Python. Ils supposent que vous avez déjà créé le client SDK et que vous connaissez votre table cible. Pour la configuration complète (Endpoint, table, Service Principal) et des exemples dans chaque langue, voir Use Zerobus Ingest.
JSON
Le JSON est le moyen le plus simple de start : vous envoyez des enregistrements sous forme d'objets JSON sans définition de schéma à compiler. C'est idéal pour démarrer, prototyper et pour les producteurs où la commodité compte plus que le throughput brut. Pour les charges de travail de production à haut volume, un format binaire (protobuf ou Arrow) est plus efficace.
Créez un stream pour les enregistrements JSON en transmettant un nom de table à TableProperties sans descripteur :
table_properties = TableProperties(TABLE_NAME)
stream = sdk.create_stream(CLIENT_ID, CLIENT_SECRET, table_properties)

stream.ingest_record_offset({"device_name": "sensor-1", "temp": 22, "humidity": 55})
Pour le guide complet sur le JSON, consultez Écrire un client.
Protocol Buffers
Protobuf fournit un encodage binaire compact et sécurisé en termes de types, et constitue le format recommandé pour la plupart des charges de travail de production orientées lignes. Vous définissez un schéma protobuf adapté à votre table Delta cible (voir schéma Protobuf), vous le compilez, et le SDK ingère les enregistrements un par un via gRPC.
L'utilisation de protobuf se fait en trois étapes : générer un schéma .proto correspondant à votre table, le compiler en un module de langage, puis ingérer les enregistrements en transmettant le descripteur à TableProperties. L'exemple suivant utilise le SDK Python.
1. Générez un schéma .proto à partir de votre table. Le SDK Python inclut un outil generate_proto qui lit votre table Delta et écrit un schéma correspondant :
python -m zerobus.tools.generate_proto \
    --uc-endpoint "https://<workspace-id>.cloud.databricks.com" \
    --client-id "<client-id>" \
    --client-secret "<client-secret>" \
    --table "main.default.air_quality" \
    --output "record.proto" \
    --proto-msg "AirQuality"
Le schéma généré utilise la syntaxe proto2, avec un champ facultatif pour chaque colonne Delta :
syntax = "proto2";
message AirQuality {
    optional string device_name = 1;
    optional int32 temp = 2;
    optional int64 humidity = 3;
}
2. Compilez le schéma en un module Python avec le compilateur protobuf :
pip install "grpcio-tools>=1.60.0,<2.0"
python -m grpc_tools.protoc --python_out=. --proto_path=. record.proto
Ceci génère record_pb2.py.
3. Ingestez les enregistrements en transmettant le descripteur compilé à TableProperties (the default pour protobuf). Le SDK utilise le descripteur pour sérialiser chaque enregistrement :
import record_pb2

descriptor_bytes = record_pb2.AirQuality.DESCRIPTOR.file.serialized_pb
table_properties = TableProperties(TABLE_NAME, descriptor_bytes)
stream = sdk.create_stream(CLIENT_ID, CLIENT_SECRET, table_properties)

record = record_pb2.AirQuality(device_name="sensor-1", temp=22, humidity=55)
stream.ingest_record_offset(record)
L'exemple ci-dessus utilise le SDK Python. Les outils varient selon le langage : certains SDK fournissent un utilitaire generate_proto qui génère un .proto à partir de votre table, tandis que d'autres (comme Go et TypeScript) compilent un .proto existant. Pour les étapes par langage, consultez les notes protobuf dans chaque onglet SDK de Write a client. Pour les sources des outils et des exemples complets, consultez le repository du SDK Zerobus.
Apache Arrow
L'ingestion Apache Arrow envoie les données Arrow RecordBatch directement via la même connexion gRPC, au lieu de convertir chaque ligne en JSON ou protobuf au préalable. C'est le meilleur choix lorsque votre application produit déjà des données Arrow ou lorsque vous ingérez des lignes par batch, en particulier pour les schémas larges, à forte composante numérique ou orientés analytique, où la sérialisation ligne par ligne ajoute une surcharge.
Arrow est également bien adapté aux très grands batchs. Contrairement aux méthodes par batch JSON et protobuf, qui fonctionnent sur le principe du tout ou rien et sont limitées par la taille maximale par message, le chemin Arrow Flight divise un batch volumineux en messages de transport plus petits qui sont envoyés et accusés de réception individuellement. Voir Les batchs Arrow Flight sont l'exception et Utiliser Arrow Flight avec Zerobus Ingest.
Ouvrez un Stream Arrow avec un pyarrow.Schema et ingérez des données RecordBatch :
stream = sdk.create_arrow_stream(TABLE_NAME, schema, CLIENT_ID, CLIENT_SECRET)

stream.ingest_batch(batch)
Pour le guide complet sur Arrow Flight, incluant la définition de schéma, le batching et la compression, consultez Utiliser Arrow Flight avec Zerobus Ingest.
Avro
Bêta
Cette fonctionnalité est en bêta. Pour l'utiliser, l'administrateur d'un workspace doit activer la prise en charge d'Avro par Zerobus Ingest à partir de la page Prévisualisations . Consultez Gérer les aperçus Databricks.
Apache Avro est un format open source, orienté ligne, compact, binaire et piloté par un schéma. Tout comme protobuf, chaque enregistrement est encodé par rapport à un schéma au lieu de transporter les noms de champs en ligne, ce qui permet de maintenir des enregistrements de petite taille. La différence réside dans le fait que protobuf utilise un descripteur .proto compilé, tandis qu'Avro décrit ses enregistrements avec un schéma écrit en JSON. L'ingestion Avro s'exécute sur gRPC via les SDK Zerobus. Pour savoir quels SDK prennent en charge Avro, consultez le repository SDK Zerobus.
Avro est adapté si votre producteur fonctionne déjà avec Avro, par exemple lorsqu'il lit des données Avro à partir d'un système en amont ou qu'il possède déjà un schéma d'écriture Avro.
Gestion du schéma
Zerobus Ingest n'utilise pas de registre de schémas, et les enregistrements sur le réseau ne portent aucun ID de schéma ou empreinte numérique. Au lieu de cela, vous fournissez le schéma d'écriture Avro au format JSON lorsque vous créez le Stream, et chaque enregistrement sur ce Stream est décodé par rapport à ce schéma. Le schéma est validé par rapport à la table Delta cible en amont, de sorte qu'un schéma incompatible est rejeté avant que les données ne circulent.
Le schéma d'écriture est fixe pendant toute la durée de vie du Stream. Pour ingérer avec un schéma différent, créez un nouveau Stream.
Les champs Avro sont associés aux colonnes Delta par nom à tous les niveaux, de sorte que l’ordre des champs dans le schéma de l’enregistreur n’a pas d’importance. Pour savoir comment les types Avro sont mappés vers les colonnes Delta et quelles colonnes ne peuvent pas être ciblées, consultez Types Avro. Pour savoir comment les enregistrements sont validés par rapport à la table, consultez Gestion du schéma.
Un schéma d’écriture Avro doit déclarer chaque type en ligne. Les références de type nommé, qui réutilisent un type record, enum ou fixed nommé ailleurs dans le schéma en faisant référence à son nom, ne sont pas prises en charge.
Comment fournir des données
Que vous utilisiez un SDK ou non, vous pouvez ingérer les valeurs une par une ou par batch. La différence réside dans l’entité qui encode les données en Avro :
-
Avec un SDK, vous pouvez :
- Laisser le SDK encoder vos données : vous donnez au SDK vos enregistrements Avro et il les encode par rapport au schéma d'écriture.
- Envoyer des octets Avro pré-encodés : si vous disposez déjà de données encodées en Avro, par exemple à partir d’un système en amont, le SDK les envoie telles quelles.
-
Sans SDK, en appelant directement l'API gRPC, vous n'envoyez que des octets Avro pré-encodés. Créez le Stream avec le schéma d’écriture, puis envoyez l’encodage binaire Avro brut de vos données, sans en-tête de fichier de conteneur, sans préfixe d’ID de registre de schéma et sans empreinte numérique.
Écrire un client
Les exemples ci-dessous utilisent les SDK Python et Rust. Ils créent un stream, envoient des enregistrements que le SDK encode avec le schéma du writer, et effectuent un flush. Ils supposent que vous avez déjà configuré Zerobus Ingest (endpoint, table cible et Service Principal). Voir Utiliser Zerobus Ingest. Pour savoir quels SDK prennent en charge Avro, consultez le repository du SDK Zerobus.
- Python SDK
- Rust SDK
Installez le SDK avec l'option avro, qui extrait l'encodeur fastavro :
pip install "databricks-zerobus-ingest-sdk[avro]"
Passez le schéma du rédacteur en tant que chaîne JSON à TableProperties avec le mot-clé avro_schema, puis ingérez les enregistrements en tant que dictionnaires :
import json

from zerobus.sdk.sync import ZerobusSdk
from zerobus.sdk.shared import TableProperties

SERVER_ENDPOINT = "https://1234567890123456.zerobus.us-west-2.cloud.databricks.com"
DATABRICKS_WORKSPACE_URL = "https://dbc-a1b2c3d4-e5f6.cloud.databricks.com"
TABLE_NAME = "main.default.air_quality"
CLIENT_ID = "your-client-id"
CLIENT_SECRET = "your-client-secret"

SCHEMA = {
    "type": "record",
    "name": "AirQuality",
    "fields": [
        {"name": "device_name", "type": "string"},
        {"name": "temp", "type": "int"},
        {"name": "humidity", "type": "long"},
    ],
}

sdk = ZerobusSdk(SERVER_ENDPOINT, DATABRICKS_WORKSPACE_URL)
table_properties = TableProperties(TABLE_NAME, avro_schema=json.dumps(SCHEMA))
stream = sdk.create_stream(CLIENT_ID, CLIENT_SECRET, table_properties)

try:
    for i in range(1000):
        stream.ingest_record_offset(
            {"device_name": f"sensor-{i}", "temp": 20 + (i % 5), "humidity": 55 + (i % 10)}
        )
    stream.flush()
finally:
    stream.close()
Pour envoyer des données que vous avez déjà encodées, transmettez directement la valeur brute bytes à ingest_record_offset, sans type d’encapsulation. Le SDK les transmet sans modification. Les octets doivent correspondre à une valeur Avro sans schéma, encodée selon le même schéma d’écriture. Ils sont affichés ici sous forme de littéral, mais en pratique, ils proviennent d’un système en amont :
# A schemaless Avro datum for {"device_name": "sensor-0", "temp": 21, "humidity": 55},
# encoded against the writer schema above: a length-prefixed "sensor-0", then temp
# and humidity as Avro varints.
payload = b"\x10sensor-0\x2a\x6e"
stream.ingest_record_offset(payload)
Ajoutez la crate avec la fonctionnalité avro, qui nécessite Rust 1.88 ou une version ultérieure :
cargo add databricks-zerobus-ingest-sdk --features avro
cargo add tokio --features macros,rt-multi-thread
Sélectionnez le format Avro avec .avro(schema_json) sur le générateur de Stream, puis ingérez les valeurs AvroRecord que le SDK encode par rapport au schéma de l’enregistreur :
use databricks_zerobus_ingest_sdk::{AvroRecord, AvroValue, ZerobusSdk};

const SERVER_ENDPOINT: &str = "https://1234567890123456.zerobus.us-west-2.cloud.databricks.com";
const DATABRICKS_WORKSPACE_URL: &str = "https://dbc-a1b2c3d4-e5f6.cloud.databricks.com";
const TABLE_NAME: &str = "main.default.air_quality";
const CLIENT_ID: &str = "your-client-id";
const CLIENT_SECRET: &str = "your-client-secret";

const AVRO_SCHEMA: &str = r#"{
  "type": "record",
  "name": "AirQuality",
  "fields": [
    {"name": "device_name", "type": "string"},
    {"name": "temp", "type": "int"},
    {"name": "humidity", "type": "long"}
  ]
}"#;

#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    let sdk = ZerobusSdk::builder()
        .endpoint(SERVER_ENDPOINT)
        .unity_catalog_url(DATABRICKS_WORKSPACE_URL)
        .build()?;

    let mut stream = sdk
        .stream_builder()
        .table(TABLE_NAME)
        .oauth(CLIENT_ID, CLIENT_SECRET)
        .avro(AVRO_SCHEMA)
        .build()
        .await?;

    for i in 0..1000 {
        let record = AvroValue::Record(vec![
            ("device_name".to_string(), AvroValue::String(format!("sensor-{i}"))),
            ("temp".to_string(), AvroValue::Int(20 + i % 5)),
            ("humidity".to_string(), AvroValue::Long((55 + i % 10) as i64)),
        ]);
        stream.ingest_record_offset(AvroRecord(record)).await?;
    }
    stream.flush().await?;
    stream.close().await?;

    Ok(())
}
Pour envoyer une donnée que vous avez déjà encodée, transmettez AvroBytes(bytes) à ingest_record_offset au lieu de AvroRecord.
Connexes
- Protocoles API: les protocoles API sur lesquels ces formats transitent.
- Gestion des schémas: comment les enregistrements sont validés par rapport à votre table.
- Types de données pris en charge: Types de données Delta, Protobuf et Avro pris en charge.