Configurer les variables d’environnement pour les jobs serverless
Les variables d’environnement fournissent une configuration spécifique au déploiement au code d’application dans les tâches Lakeflow Jobs serverless. Définissez des entrées de variables d’environnement nommées sur un job, puis sélectionnez une entrée pour chaque tâche qui en a besoin.
Bêta
Cette fonctionnalité est en version bêta. Pour l’utiliser, un administrateur du workspace doit activer Environment variables in Lakeflow Jobs depuis la page Previews . Consultez Gérer les aperçus Databricks.
Ces variables d’environnement s’appliquent uniquement aux jobs serverless. Le compute serverless ne prend pas en charge les scripts d’initialisation. Si votre charge de travail s’exécute sur un compute classique, consultez Définir et utiliser des variables d’environnement avec des scripts d’initialisation.
Fonctionnement des variables d'environnement
Les entrées de variables d'environnement sont définies au niveau du job. Chaque entrée possède une clé unique et contient des variables intégrées, des chemins vers des fichiers .env, ou les deux. Une entrée fonctionne avec tous les types de tâches serverless. Une clé d'entrée peut contenir uniquement des lettres, des chiffres, des traits d'union et des traits de soulignement. Chaque nom de variable intégrée doit start par une lettre ou un trait de soulignement et ne peut contenir que des lettres, des chiffres et des traits de soulignement.
Chaque tâche sélectionne une seule entrée de variable d'environnement avec environment_variables_key et ne reçoit que les variables de cette entrée. Les entrées ne sont jamais combinées et une entrée ne peut pas hériter d’une autre. Une tâche qui omet environment_variables_key ne reçoit aucune variable d’environnement.
Les variables d’environnement ne sont disponibles que pour le code d’application qui s’exécute dans le processus de tâche. Ils ne sont pas disponibles pour la logique d'exécution Spark.
Exigences
- Un administrateur de workspace a activé Environment variables in Lakeflow Jobs depuis la page Previews . Consultez Gérer les aperçus Databricks.
- Tâches qui s’exécutent avec la version 5 de l’environnement serverless et plus.
- Pour les fichiers
.env, l’identité Run as du job doit disposer d’un accès en lecture à chaque fichier. - Pour les références aux secrets, l'identité Exécuter en tant que du job doit avoir au moins la permission
READsur chaque Secret Scope référencé. Voir ACL de secret.
Limitations
Les fonctions définies par l'utilisateur (UDF) ne peuvent pas lire les variables d'environnement, car les UDF s'exécutent dans la logique d'exécution de Spark plutôt que dans le processus de tâche.
Seuls les secrets Databricks au niveau de Workspace sont pris en charge. La prise en charge des secrets Unity Catalog sera bientôt disponible.
Les limites suivantes s’appliquent :
Configuration | Limite |
|---|---|
Entrées de variables d’environnement par job | 10 |
Clé d’entrée | 1 à 100 caractères ; doit correspondre |
Variables en ligne par entrée | 20 |
Nom de variable en ligne | 1 à 256 caractères ; doit correspondre |
Valeur de variable en ligne | 512 caractères |
| 5 |
Chemin d'accès au fichier | 1 024 caractères |
Taille du fichier | 32 Kio (32 768 octets) |
Taille de ligne dans un fichier | 1 Kio (1 024 octets), mesurés en octets UTF-8 |
Utiliser les fichiers .env
Vous pouvez charger des variables d’environnement à partir de fichiers de workspace (/Workspace/...) ou de fichiers situés dans des volumes Unity Catalog (/Volumes/...). Ajoutez les chemins d’accès aux fichiers à la liste Files d’une entrée dans l’interface utilisateur ou à son tableau spec.files dans l’API Jobs. Les fichiers sont lus au start d’une tâche, et non lors de la création ou de la mise à jour du job.
Pour les jobs serverless, Databricks utilise son propre format de fichier .env. Les règles suivantes s’appliquent :
- Définissez une variable par ligne sous la forme
KEY=VALUE, sans espace au début ni espace avant=. - Les noms de variables doivent start par une lettre ASCII ou un trait de soulignement. Les caractères restants peuvent être des lettres ASCII, des chiffres ou des traits de soulignement.
- Tout ce qui suit le premier
=correspond à la valeur, y compris les espaces et les caractères=supplémentaires. Les valeurs vides sont autorisées. Les valeurs peuvent contenir du texte Unicode. Enregistrez le fichier en utilisant l’encodage UTF-8. - Les lignes vides et ne contenant que des espaces sont ignorées. Pour ajouter un commentaire, insérez
#comme premier caractère de la ligne.
Par exemple, un fichier execution.env peut contenir :
# Application configuration
APP_ENV=production
REGION=us-west-2
GREETING=こんにちは
OPTIONAL_VALUE=
Ce format n’interprète pas les guillemets, les séquences d’échappement, les commentaires en ligne ou les références de variables telles que ${OTHER_VARIABLE}. Ces caractères font toujours partie de la valeur. Par exemple, APP_ENV="production" inclut les guillemets dans la valeur. Un préfixe export n’est pas valide.
Les références de secret utilisent une syntaxe distincte et sont résolues une fois le fichier et les variables en ligne combinés. Voir Utiliser des secrets.
Si une variable comporte plusieurs définitions :
- Dans un fichier, la dernière définition a la priorité.
- Parmi l’ensemble des fichiers, un fichier listé ultérieurement remplace les valeurs des fichiers listés précédemment.
- Les variables en ligne remplacent les valeurs des fichiers.
Par exemple, si un fichier définit LOG_LEVEL=DEBUG et que l'entrée définit également la variable inline LOG_LEVEL=INFO, la tâche reçoit LOG_LEVEL=INFO.
Si un fichier contient une ligne non valide ou dépasse une limite de taille de fichier ou de ligne, la tâche échoue.
Utiliser des secrets
Les variables d'environnement pour les Job Serverless prennent en charge les secrets Databricks au niveau du Workspace, lesquels sont organisés en Secret Scope. Utilisez une référence secrète pour transmettre des identifiants ou des jetons au code de l'application sans stocker la valeur secrète dans la configuration du job ou dans un fichier .env. Pour créer un Secret Scope et ajouter un secret, consultez la rubrique Gestion des secrets.
Définissez la valeur d'une variable d'environnement sur une référence de secret au format suivant :
{{secrets/<scope-name>/<secret-name>}}
Remplacez <scope-name> par le nom du secret scope et <secret-name> par la clé du secret dans ce scope. La référence doit correspondre à la valeur entière. Les références incorporées dans une chaîne plus longue, telle que Bearer {{secrets/production/service-token}}, restent du texte littéral.
Dans l’interface utilisateur, saisissez la référence comme valeur sous Variables . Dans l’API Jobs, utilisez-la comme valeur dans spec.variables:
{
  "SERVICE_TOKEN": "{{secrets/production/service-token}}"
}
Pour référencer le même secret dans un fichier .env, ajoutez la ligne suivante sans guillemets ni espaces autour de la référence :
SERVICE_TOKEN={{secrets/production/service-token}}
Databricks résout les références de secret au start de la tâche, en utilisant l'identité Exécuter en tant que du Job. La tâche reçoit la valeur secrète résolue dans son environnement de processus. Le code d'application le lit avec os.environ["SERVICE_TOKEN"] en Python ou sys.env("SERVICE_TOKEN") en Scala.
Databricks tente de masquer les valeurs secrètes dans la sortie du notebook, mais le masquage est au mieux un effort. Les secrets que votre application imprime ou écrit dans les logs peuvent apparaître en texte brut dans les logs de compute, même lorsque la sortie du notebook affiche [REDACTED]. Évitez d'imprimer les valeurs secrètes ou de les écrire dans les logs. Voir Masquage des secrets.
Les mêmes règles de priorité s’appliquent aux références secrètes. Seules les valeurs résultantes sont résolues. Les paramètres du job conservent les références secrètes, pas les valeurs secrètes résolues.
Si un secret référencé n'existe pas ou si l'identité Exécuter en tant que ne dispose pas de l'autorisation de le lire, la tâche échoue avant l'exécution du code de l'application. Vérifiez le nom du scope, la clé secrète et les autorisations du Secret Scope.
Configurez les variables d’environnement dans l’UI
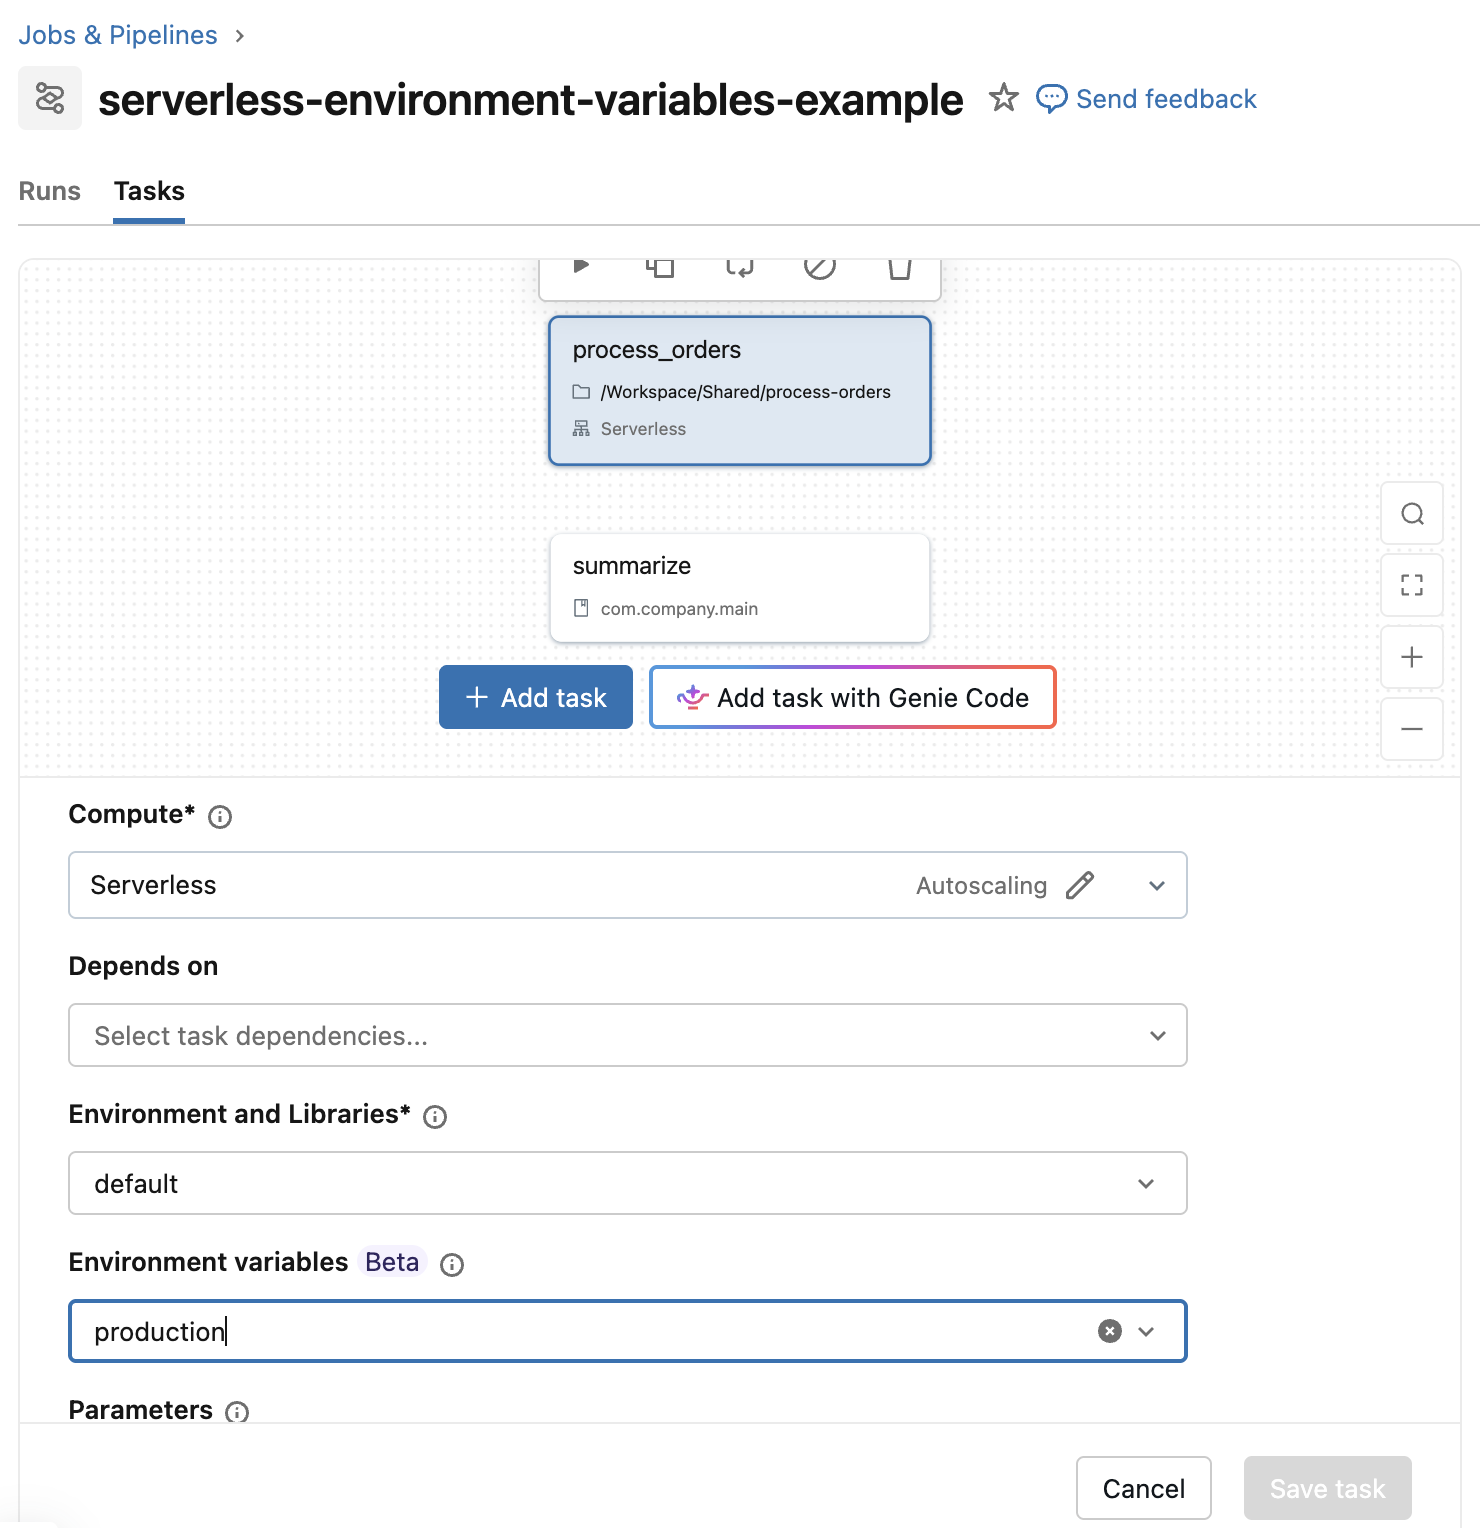
Sous l'onglet Tasks du job, sélectionnez une tâche. Utilisez Environment variables pour sélectionner ou créer une entrée de variable d'environnement, telle que production.
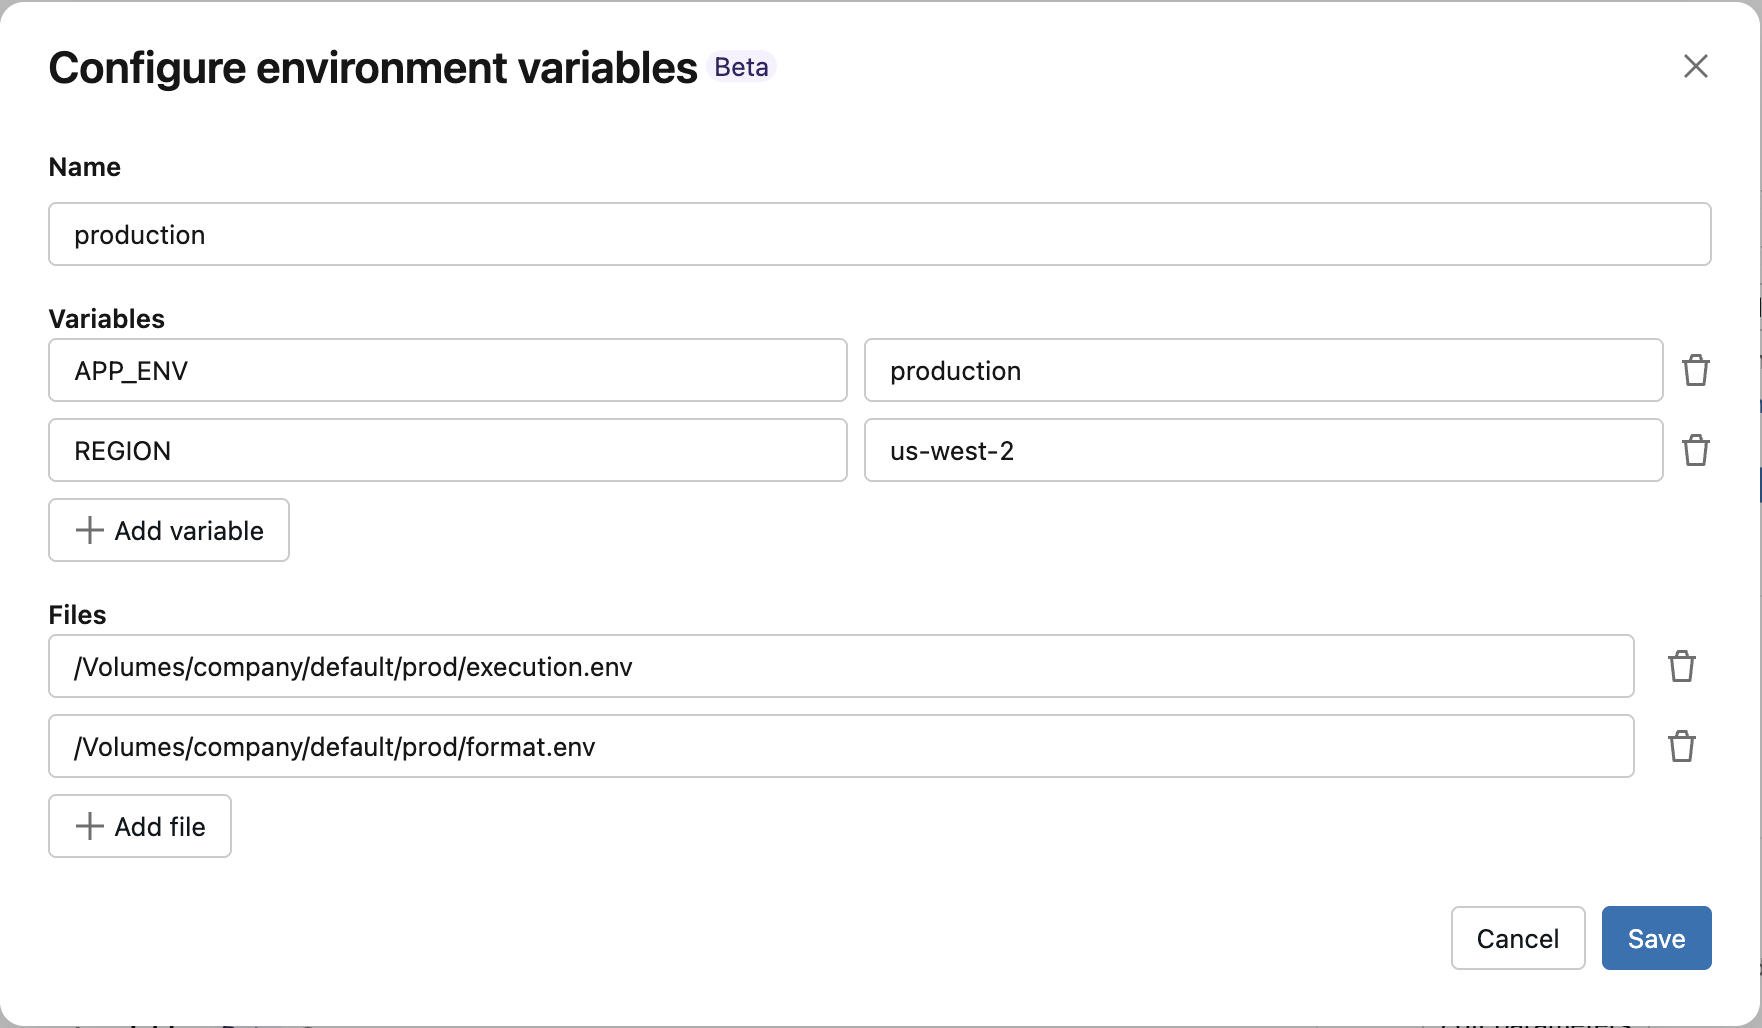
Dans Configure environment variables , saisissez un nom. Vous pouvez également ajouter des paires clé-valeur sous Variables , des chemins d’accès vers des fichiers .env sous Files , ou les deux. Vous pouvez également laisser les deux sections vides. Cliquez sur Enregistrer .
Configurez les variables d’environnement avec l’API Jobs
Utilisez le champ environment_variables dans une requête POST /api/2.2/jobs/create pour définir des entrées de variables d'environnement. Définissez environment_variables_key sur chaque tâche qui utilise une entrée.
Avant d’exécuter l’exemple suivant, créez le secret service-token dans le périmètre production et donnez à l’identité Exécuter en tant que du job l’accès à ce secret. Voir Utiliser des secrets. L’exemple définit des entrées de variables d’environnement distinctes pour une tâche de type notebook et une tâche de type JAR. Chaque entrée utilise spec.variables pour les valeurs inline et spec.files pour les chemins d’accès aux fichiers. Chaque tâche sélectionne son entrée avec environment_variables_key:
{
  "name": "serverless-environment-variables-example",
  "tasks": [
    {
      "task_key": "process_orders",
      "notebook_task": {
        "notebook_path": "/Workspace/Shared/process-orders"
      },
      "environment_key": "default",
      "environment_variables_key": "production"
    },
    {
      "task_key": "summarize",
      "spark_jar_task": {
        "main_class_name": "com.company.main"
      },
      "environment_key": "summary_env",
      "environment_variables_key": "summary_vars"
    }
  ],
  "environments": [
    {
      "environment_key": "default",
      "spec": {
        "environment_version": "5",
        "dependencies": []
      }
    },
    {
      "environment_key": "summary_env",
      "spec": {
        "environment_version": "5",
        "java_dependencies": ["/Volumes/company/default/prod/summarize.jar"]
      }
    }
  ],
  "environment_variables": [
    {
      "environment_variables_key": "production",
      "spec": {
        "variables": {
          "APP_ENV": "production",
          "REGION": "us-west-2",
          "SERVICE_TOKEN": "{{secrets/production/service-token}}"
        },
        "files": ["/Volumes/company/default/prod/execution.env", "/Volumes/company/default/prod/format.env"]
      }
    },
    {
      "environment_variables_key": "summary_vars",
      "spec": {
        "variables": {
          "APP_ENV": "production",
          "LOG_LEVEL": "INFO",
          "LOG_FILE": "service.log"
        },
        "files": ["/Volumes/company/default/prod/format.env"]
      }
    }
  ]
}
Vous pouvez également configurer des entrées de variables d’environnement avec les opérations Mettre à jour un job, Remplacer tous les paramètres d’un job et Soumettre une exécution unique.
Lire les variables d’environnement dans le code de l’application
Le code de l’application lit les variables configurées à partir de l’environnement de processus.
- Python
- Scala
import os

app_environment = os.environ["APP_ENV"]
region = os.environ["REGION"]
val appEnvironment = sys.env("APP_ENV")
val region = sys.env("REGION")