Surveiller et query les événements
Chaque LakeFlow pipeline émet des événements qui capturent les Logs d’audit, les contrôles qualité des données, la progression du pipeline et le data lineage. Vous pouvez interroger ces événements à partir de deux sources :
- La table système
pipeline_eventscontient les événements de tous les pipelines dans les Workspaces d’une région et constitue la méthode recommandée pour query des événements. Il s’agit d’une version bêta. - Le journal des événements par pipeline est une table Delta qui contient les événements d'un seul pipeline.
Vous interrogez des événements à l’aide de SQL standard. Pour vous aider à start, cette page fournit également un exemple de tableau de bord et des requêtes courantes pour la table système.
Conditions requises
Pour accéder à cette table système, les utilisateurs doivent soit :
- Soyez à la fois un administrateur du métastore et un administrateur de compte, ou
- Disposez des autorisations
USEetSELECTsur les schémas système. Voir Accorder l'accès aux tables système.
Exemple de tableau de bord
Ce tableau de bord d'exemple lit la table système pipeline_events pour suivre les mises à jour des pipelines, le throughput des flux, le backlog, la qualité des données et les erreurs pour chaque pipeline d'une région. Filtrer chaque page par pipeline, table, tag et période.

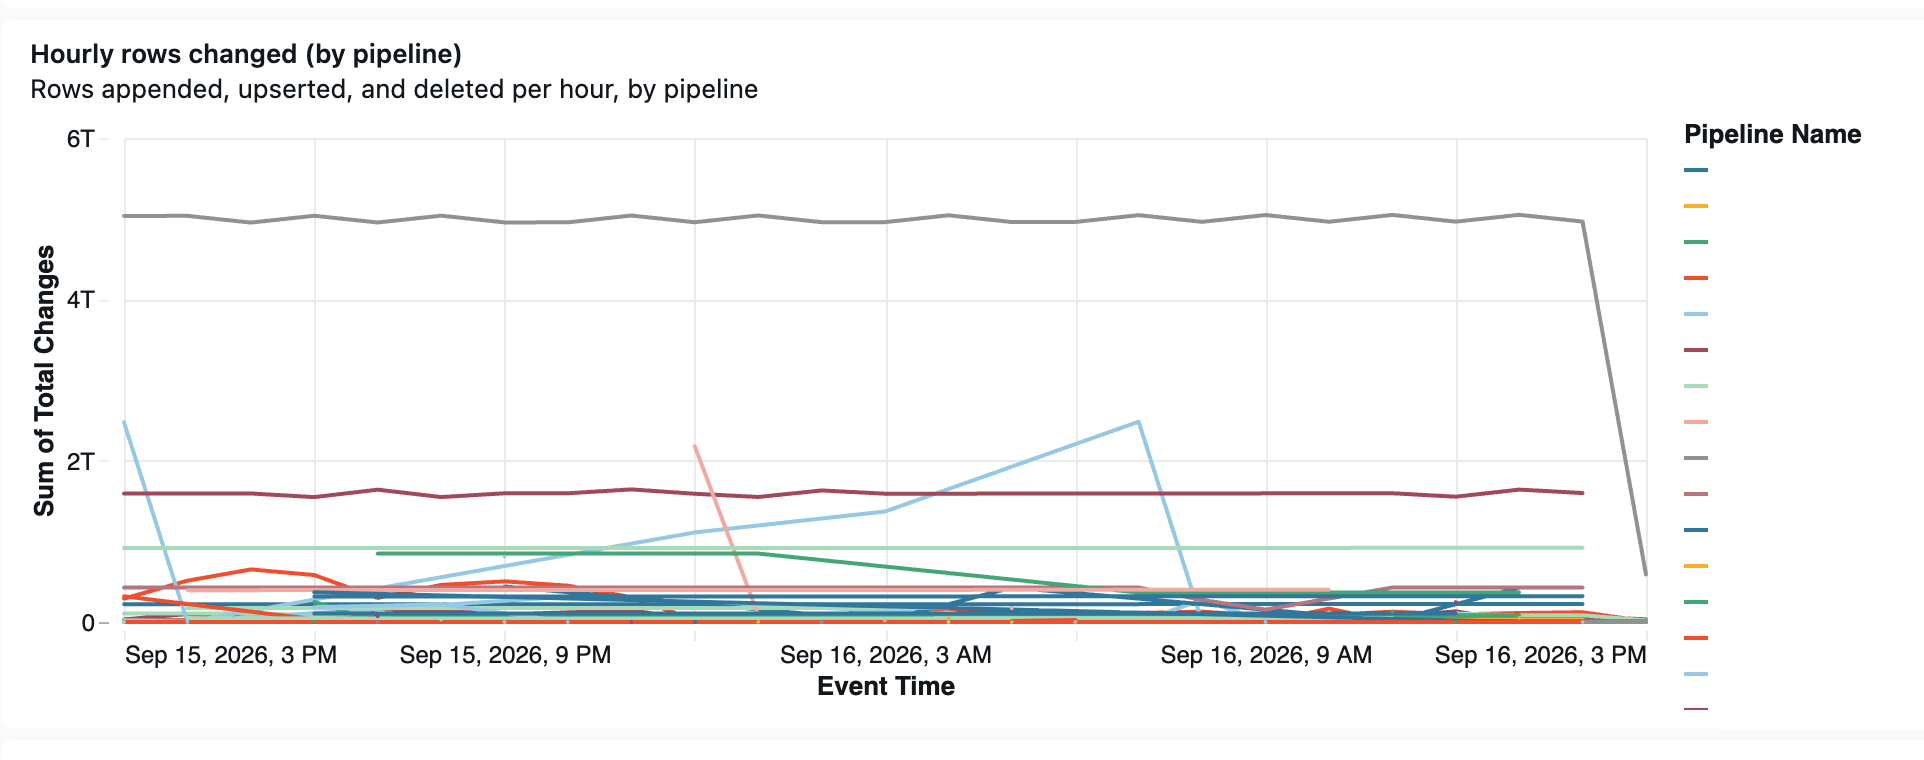

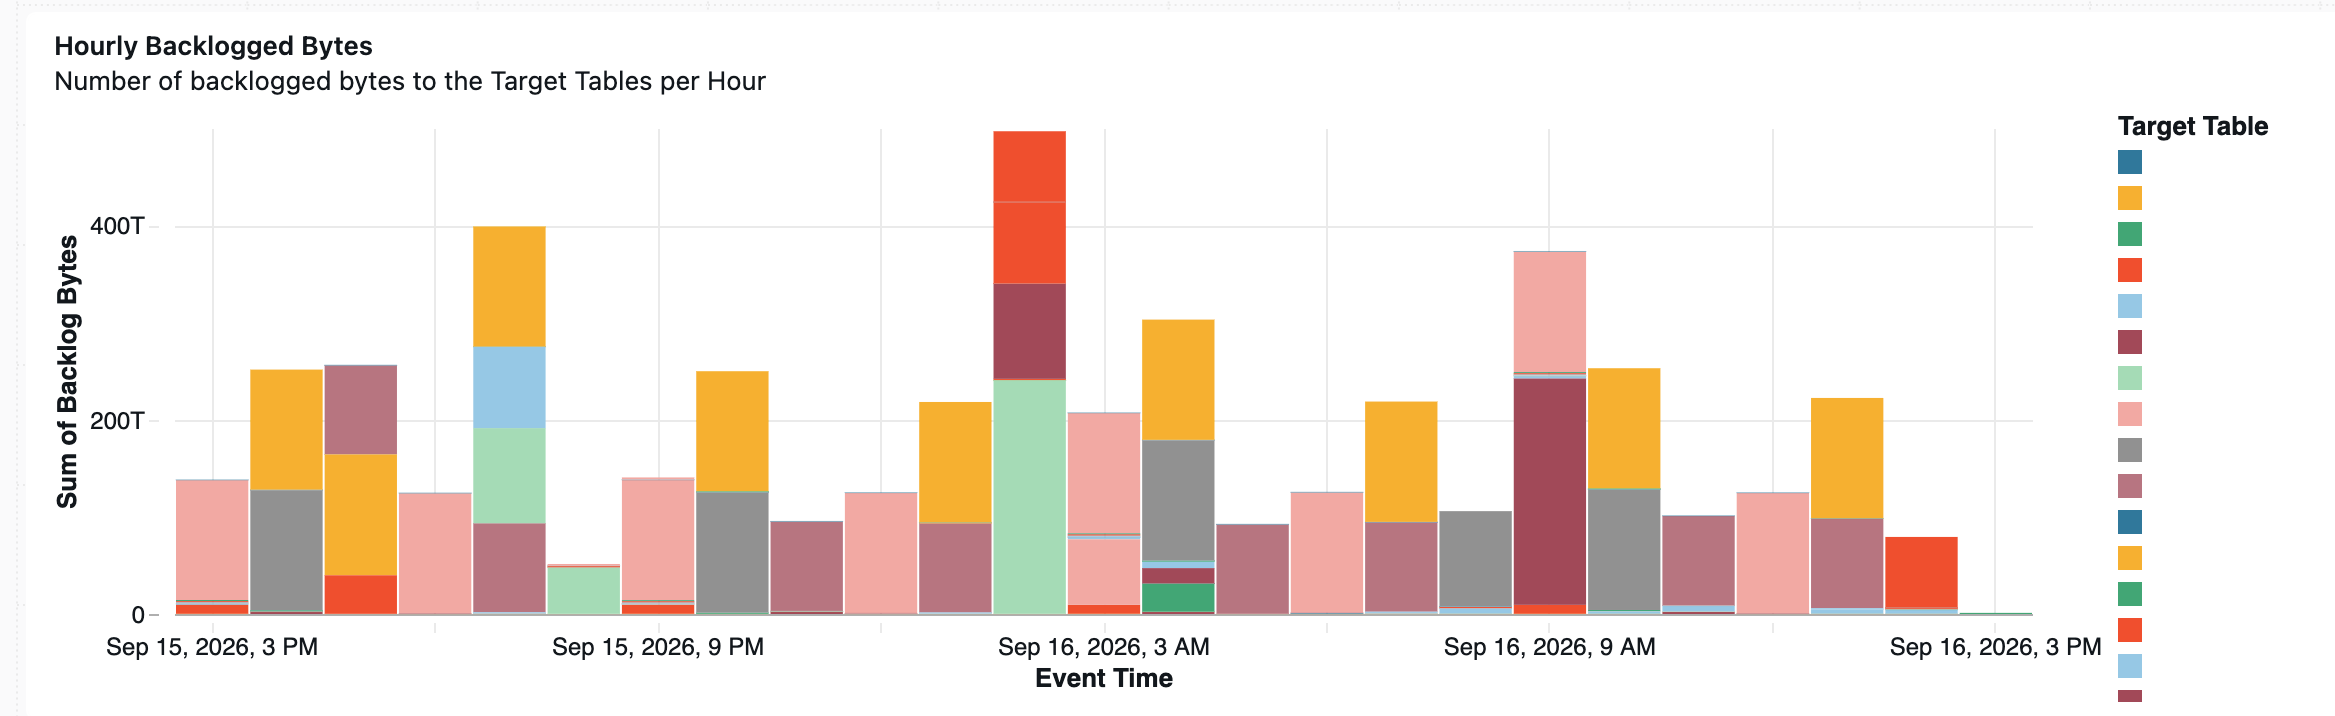
Importer le tableau de bord
- Download le fichier JSON du tableau de bord.
- Importez le tableau de bord dans votre workspace. Pour obtenir des instructions, consultez Importer un fichier de tableau de bord.
Requêtes de monitoring
Les requêtes suivantes du tableau de bord illustrent des cas d'utilisation courants de monitoring des pipelines.
Dernière erreur par pipeline
Cette query renvoie l’erreur la plus récente pour chaque pipeline ayant généré une erreur au cours des 7 derniers jours, avec l’exception externe.
SELECT
  workspace_id,
  pipeline_id,
  event_time,
  message,
  error.exceptions[0].error_class AS exception_error_class,
  error.exceptions[0].sql_state   AS exception_sql_state
FROM
  system.lakeflow_pipeline_events_preview.pipeline_events
WHERE
  level = 'ERROR'
  AND event_time >= current_timestamp() - INTERVAL 7 DAYS
QUALIFY
  ROW_NUMBER() OVER (PARTITION BY workspace_id, pipeline_id ORDER BY event_time DESC) = 1
ORDER BY
  event_time DESC
Taux d'erreur horaire
Cette query compte les erreurs par pipeline et par heure afin de vous permettre de repérer les pics.
SELECT
  pipeline_id,
  date_trunc('HOUR', event_time) AS hour,
  count(*) AS num_errors
FROM
  system.lakeflow_pipeline_events_preview.pipeline_events
WHERE
  level = 'ERROR'
  AND event_time >= current_timestamp() - INTERVAL 7 DAYS
GROUP BY
  pipeline_id,
  date_trunc('HOUR', event_time)
ORDER BY
  hour DESC
Lignes modifiées par flux
Cette query additionne les lignes qu’un flux a ajoutées, mises à jour (upsert) et supprimées par heure. Chaque mesure correspond à un décompte par micro-batch, de sorte que la somme sur la fenêtre donne le throughput.
SELECT
  origin.flow_name,
  date_trunc('HOUR', event_time) AS hour,
  SUM(
    ifnull(variant_get(details, '$.flow_progress.metrics.num_output_rows', 'BIGINT'), 0)
    + ifnull(variant_get(details, '$.flow_progress.metrics.num_upserted_rows', 'BIGINT'), 0)
    + ifnull(variant_get(details, '$.flow_progress.metrics.num_deleted_rows', 'BIGINT'), 0)
  ) AS rows_changed
FROM
  system.lakeflow_pipeline_events_preview.pipeline_events
WHERE
  event_type = 'flow_progress'
  AND event_time >= current_timestamp() - INTERVAL 7 DAYS
GROUP BY
  origin.flow_name,
  date_trunc('HOUR', event_time)
ORDER BY
  hour DESC,
  rows_changed DESC
Backlog par flux
Cette query renvoie la lecture de backlog la plus récente par flux. Un flux COMPLETED est à jour, son backlog est donc indiqué comme étant 0.
WITH latest_flow_progress AS (
  SELECT
    workspace_id,
    pipeline_id,
    origin.flow_name,
    event_time,
    CASE
      WHEN variant_get(details, '$.flow_progress.status', 'STRING') = 'COMPLETED' THEN 0
      ELSE variant_get(details, '$.flow_progress.metrics.backlog_bytes', 'BIGINT')
    END AS backlog_bytes
  FROM
    system.lakeflow_pipeline_events_preview.pipeline_events
  WHERE
    event_type = 'flow_progress'
    AND event_time >= current_timestamp() - INTERVAL 1 HOUR
    AND (
      variant_get(details, '$.flow_progress.metrics.backlog_bytes', 'BIGINT') IS NOT NULL
      OR variant_get(details, '$.flow_progress.status', 'STRING') = 'COMPLETED'
    )
  QUALIFY
    ROW_NUMBER() OVER (PARTITION BY workspace_id, pipeline_id, origin.flow_name ORDER BY event_time DESC) = 1
)
SELECT *
FROM latest_flow_progress
WHERE backlog_bytes > 0
ORDER BY backlog_bytes DESC
Attentes ayant échoué par dataset
Cette query renvoie les attentes dont les enregistrements ont échoué par dataset, par mise à jour, au cours du dernier jour. Il utilise comme clé sa propre dataset de l'attente, qui est renseignée même lorsque la origin.dataset_name de l'événement ne l'est pas.
SELECT
  pipeline_id,
  update_id,
  coalesce(expectation.dataset, origin.dataset_name) AS dataset_name,
  expectation.name AS expectation_name,
  SUM(expectation.failed_records) AS failed_records
FROM
  system.lakeflow_pipeline_events_preview.pipeline_events
  LATERAL VIEW explode(variant_get(details, '$.flow_progress.data_quality.expectations', 'ARRAY<STRUCT<name:STRING,dataset:STRING,passed_records:BIGINT,failed_records:BIGINT>>')) AS expectation
WHERE
  event_type = 'flow_progress'
  AND event_time >= current_timestamp() - INTERVAL 1 DAY
GROUP BY
  pipeline_id,
  update_id,
  coalesce(expectation.dataset, origin.dataset_name),
  expectation.name
HAVING
  SUM(expectation.failed_records) > 0
ORDER BY
  failed_records DESC