Suivre les exécutions avec la CLI Python héritée
Cette documentation est obsolète et pourrait ne plus être à jour.
La CLI air basée sur Python, installée avec le package databricks-air, est désormais obsolète et n'est plus activement maintenue.
Utilisez la CLI Databricks pour les nouvelles charges de travail. Consultez Utiliser la CLI Databricks avec l’Runtime de l’IA.
Chaque charge de travail que vous soumettez avec air run est à la fois une exécution de job Databricks et une exécution MLflow :
- L’exécution du job (visible sur la page Jobs & Pipelines du workspace) suit l’exécution : statut, compute, tentatives et résultat du driver.
- L'exécution MLflow suit l'Experimentation : les parameters, les indicateurs, les indicateurs système et les artefacts.
Une soumission crée une exécution de job et une exécution MLflow. Une nouvelle tentative crée une nouvelle exécution MLflow.
Expérimentations et exécutions
Les champs YAML de la charge de travail suivants contrôlent l’Experimentation, l’exécution et le stockage des artefacts MLflow :
experiment_name: my-training # Creates or appends to this MLflow experiment
mlflow_run_name: baseline-lr3e5 # Names the MLflow run for this submission
# Stores artifacts in a UC volume
mlflow_artifact_location: /Volumes/main/default/mlflow-artifacts/my-training
compute:
  num_accelerators: 8
  accelerator_type: GPU_8xH100
command: torchrun --nproc_per_node=8 train.py
max_retries: 2
experiment_name(Obligatoire) : crée une Experimentation MLflow portant ce nom si elle n’existe pas, ou ajoute une nouvelle exécution à l’Experimentation existante. Une experimentation contient de nombreuses exécutions.mlflow_run_name(Facultatif) : Définit le nom de l’exécution. Si elle est omise, le nom de l'exécution default le nom de l'expérimentation (experiment_name).mlflow_artifact_location(Facultatif) : définit l’emplacement racine des artefacts. Si elle est omise, une nouvelle Experimentation utilise l’emplacement DBFS par défaut, et une Experimentation existante utilise l’emplacement lié àexperiment_name. Pour un volume Unity Catalog, utilisez/Volumes/<catalog>/<schema>/<volume>/.... Pour une Experimentation existante, l'emplacement spécifié doit correspondre à l'emplacement de l'artefact de l'Experimentation ou être omis.max_retries(Facultatif) : chaque nouvelle tentative correspond à une nouvelle exécution MLflow dans la même expérience, ce qui vous permet de comparer les tentatives. La soumission initiale et ses nouvelles tentatives partagent une seule exécution de job.
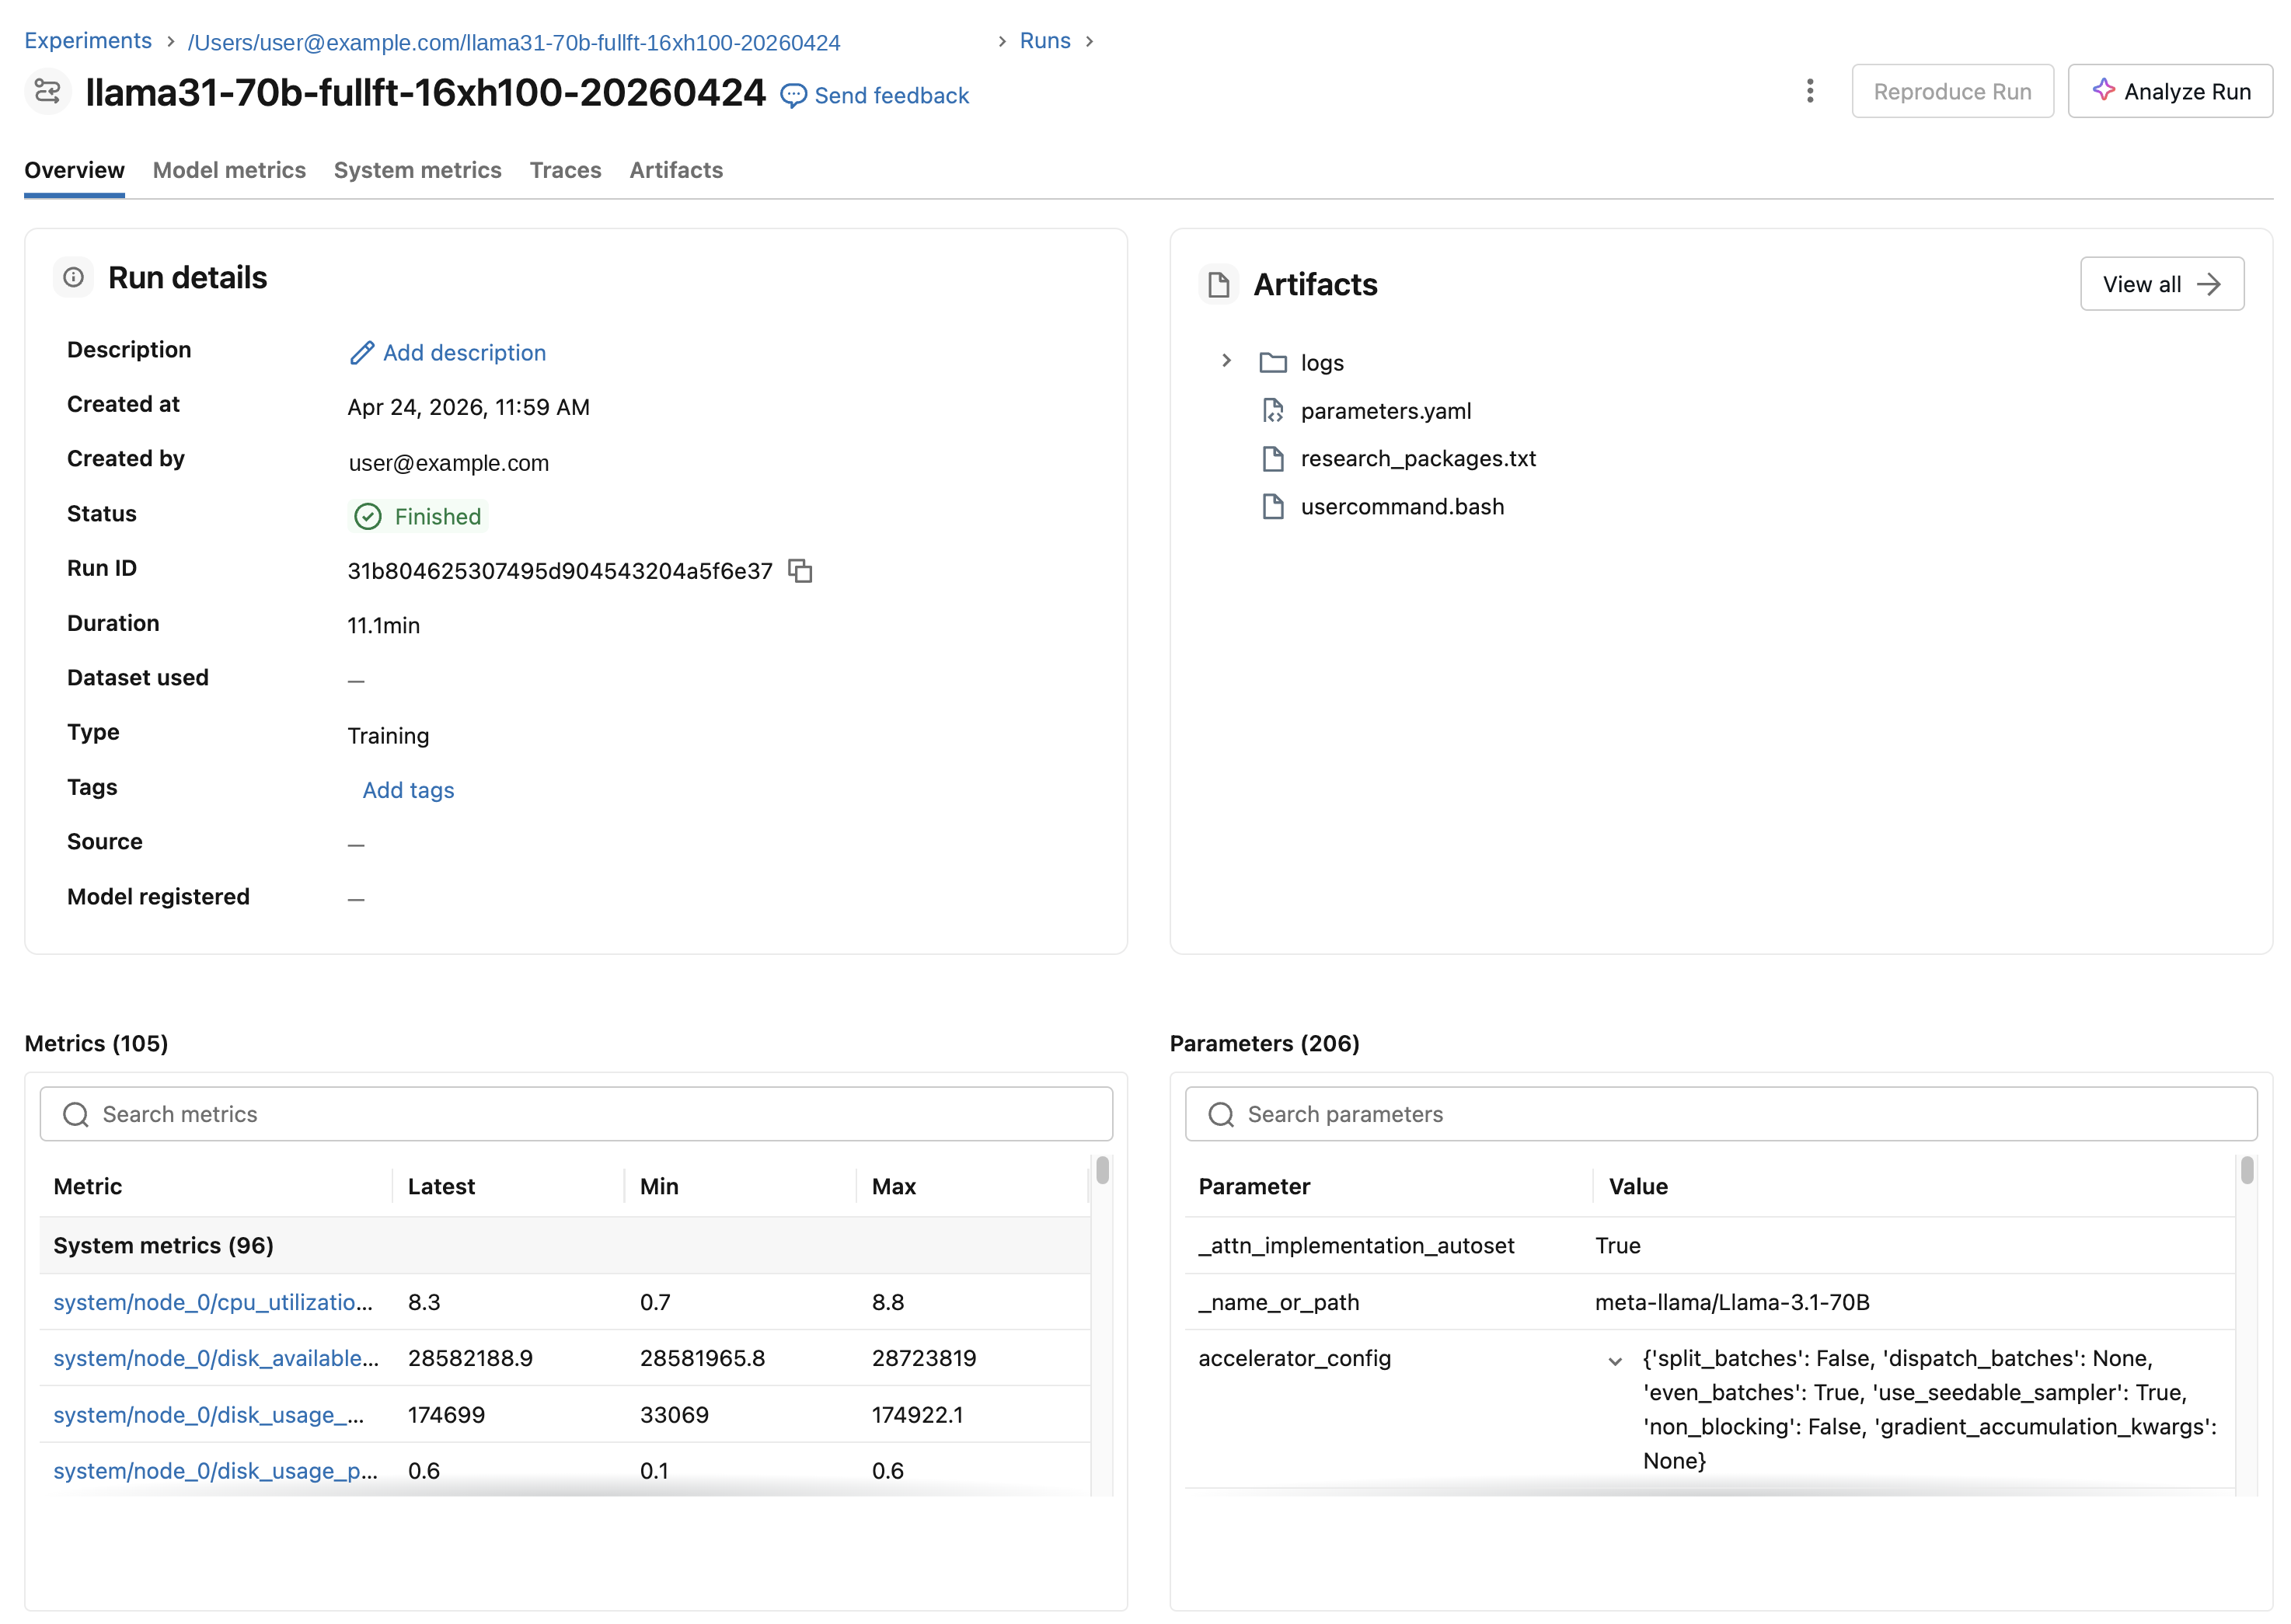
Naviguez entre Jobs, MLflow et les charges de travail précédentes
Vous pouvez accéder à une exécution depuis trois endroits :
- Jobs : la page d'exécution des jobs liste vos exécutions ; chaque exécution Link vers son exécution MLflow et son Experimentation.
- MLflow : la page Expérimentations répertorie vos expérimentations MLflow.
- Charges de travail précédentes :
air get run <job-run-id>affiche des Link cliquables vers le Job, l'Experimentation et le run MLflow du run.air list runsliste vos runs précédents et vous permet de filtrer pour trouver un run spécifique.
air get run <job-run-id> # Links to the job, experiment, and MLflow run
air list runs # List previous runs; filter to find a specific run
Indicateurs du système
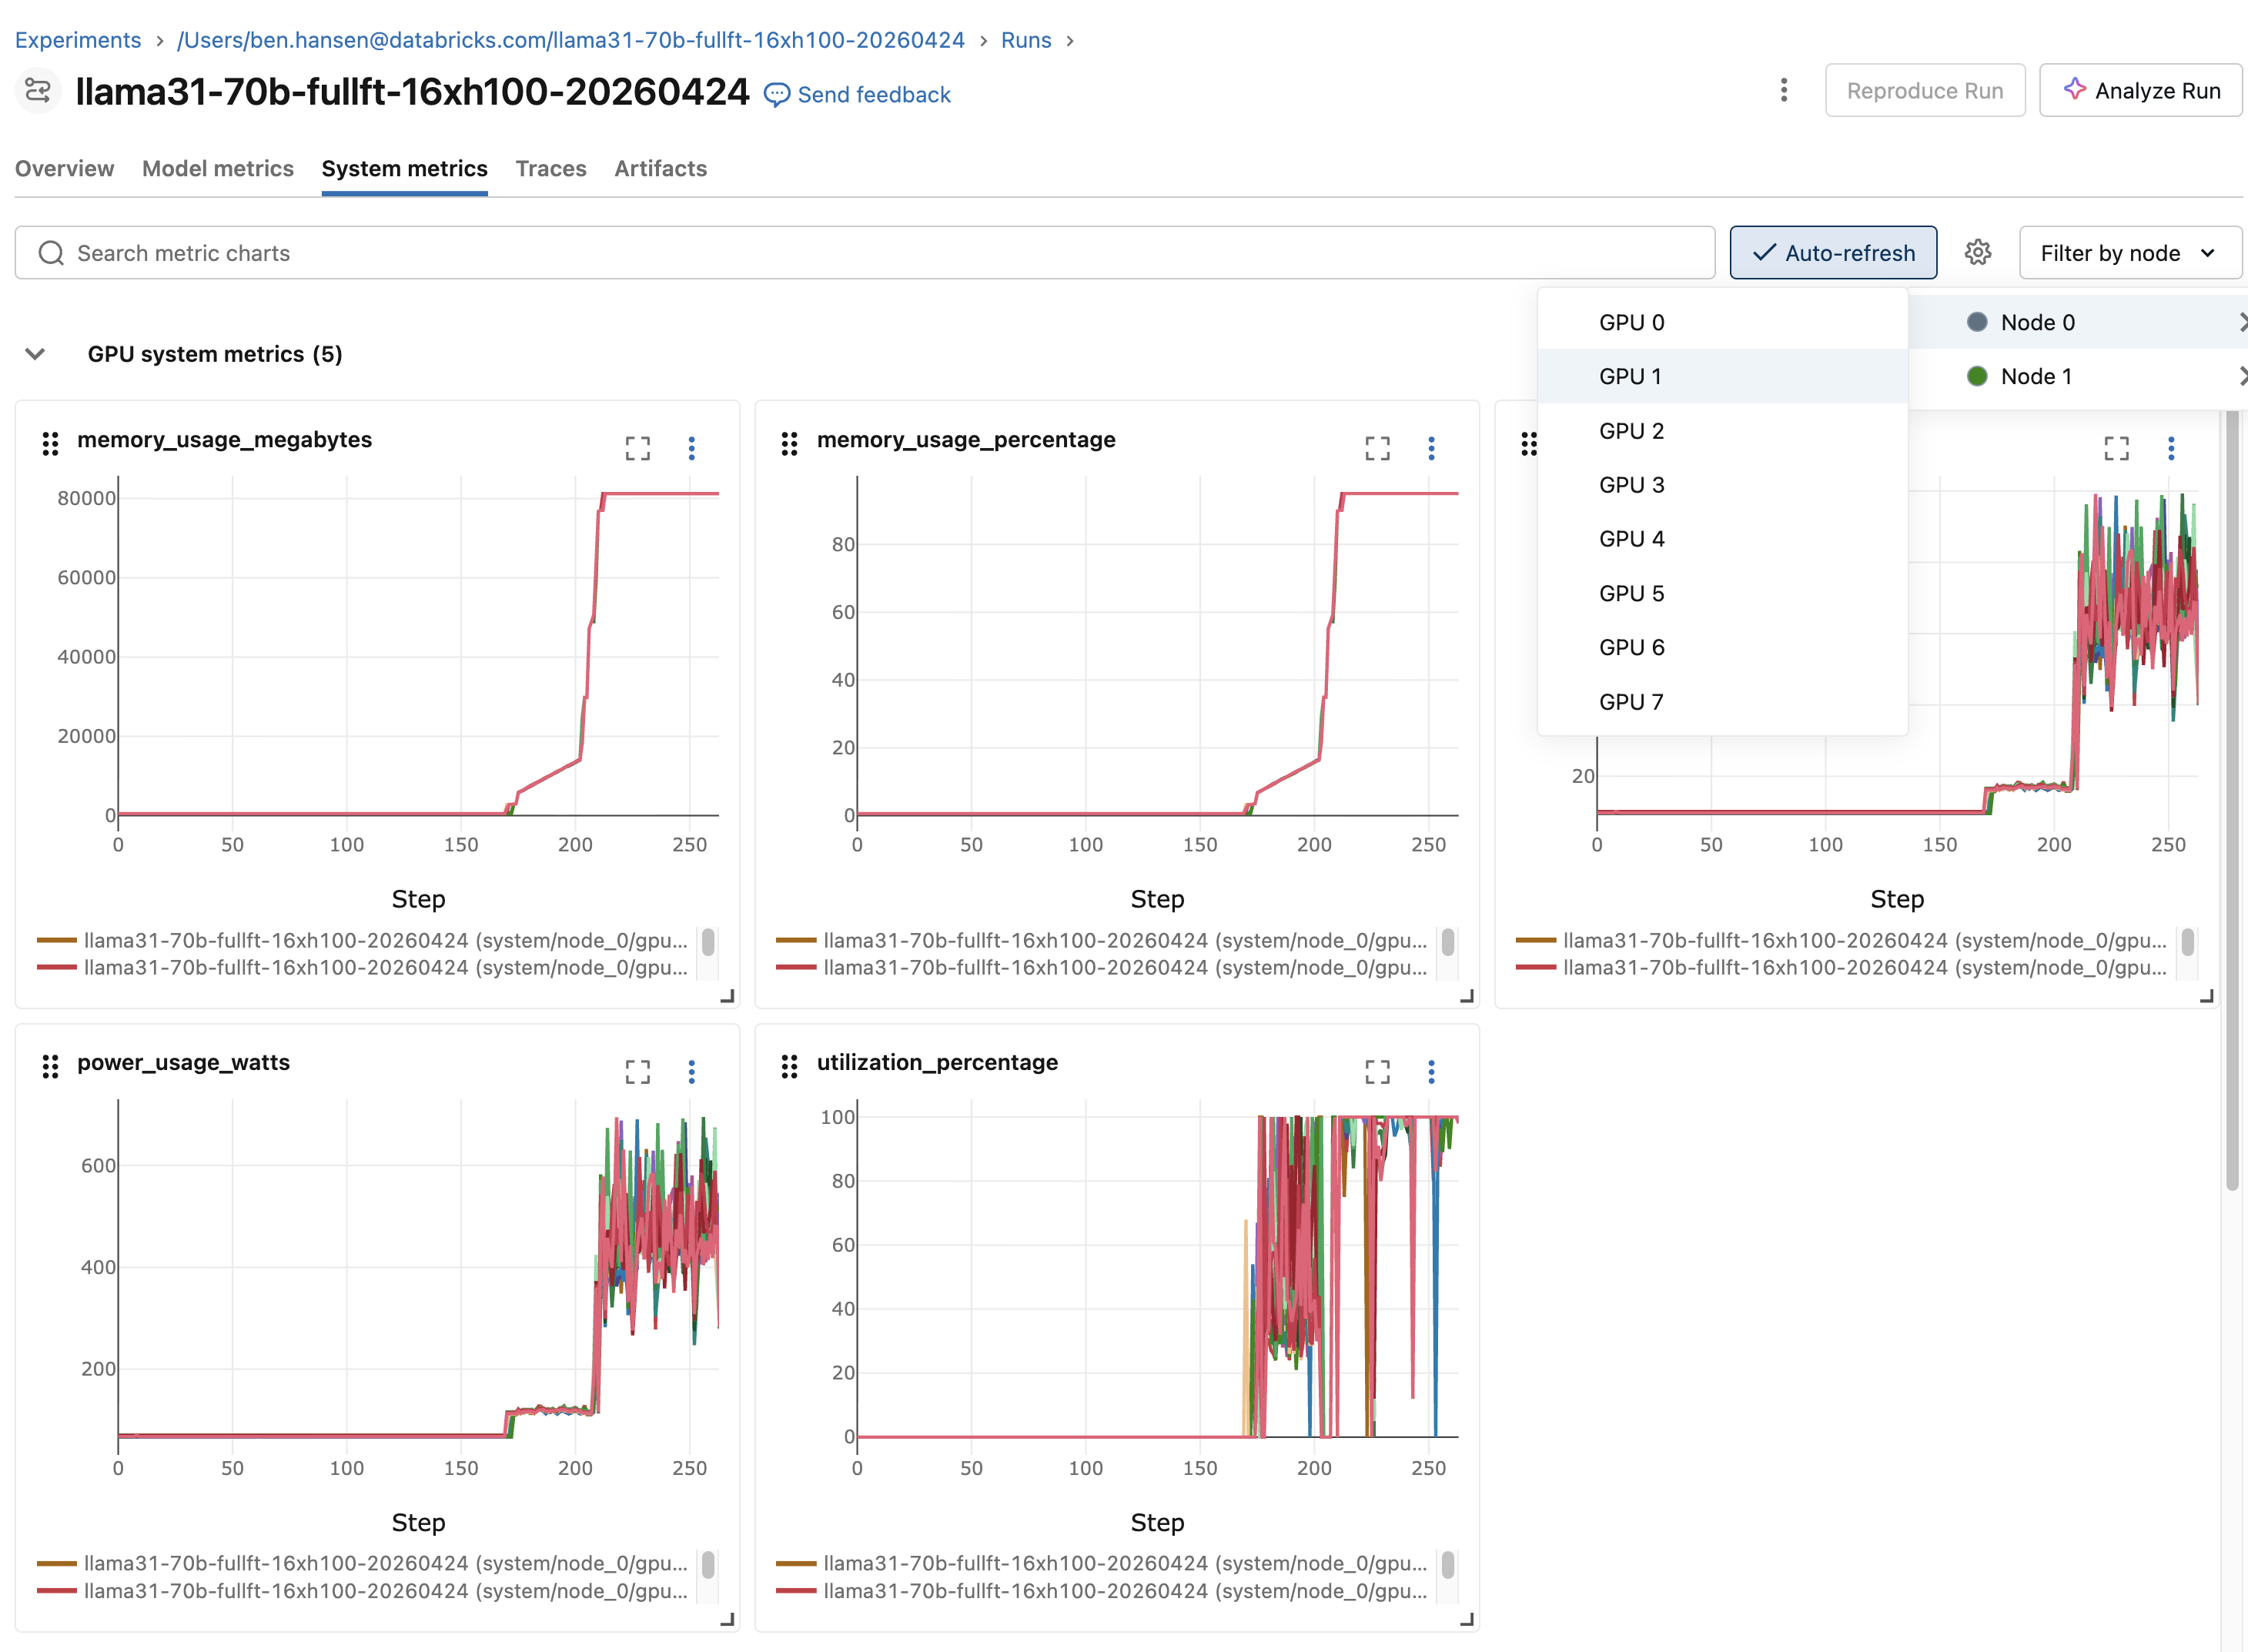
Les mesures système du GPU, du CPU et de la mémoire sont capturées automatiquement pour chaque exécution. Aucune configuration requise. Affichez-les dans la tab Indicateurs système de l'exécution MLflow.
Log des métriques personnalisées
La plateforme crée l'exécution MLflow et expose son ID à votre processus d'entraînement par le biais de la variable d'environnement MLFLOW_RUN_ID. Utilisez l'API de suivi MLflow pour Log vos propres parameters, mesures et artefacts dans cette exécution.
Sur les charges de travail distribuées (multi-nœuds), chaque nœud partage la même exécution MLflow. N’enregistrez qu’à partir du processus rank-0 afin que chaque métrique ne soit enregistrée qu’une seule fois :
import os

import mlflow

# Log from rank 0 only; all nodes share the same MLFLOW_RUN_ID.
if os.environ.get("RANK", "0") == "0":
    with mlflow.start_run(run_id=os.environ["MLFLOW_RUN_ID"]):
        mlflow.log_param("learning_rate", 3e-4)
        for step, loss in enumerate(training_losses):
            mlflow.log_metric("train_loss", loss, step=step)
Logs et artefacts
Stream ou download les logs d'une exécution avec air logs:
air logs <job-run-id> # Stream logs from node 0
air logs <job-run-id> --node 2 # Logs from a specific node
air logs <job-run-id> --download-to ./logs/ # Download instead of streaming
Les logs sont également disponibles en tant qu'artefacts sur l'exécution MLflow. Pour conserver les checkpoints de modèles, écrivez-les dans un volume Unity Catalog. Pour les modèles de checkpoint, voir Améliorer les performances et la résilience de l'entraînement sur l'IA Runtime.