Convertissez des scripts SQL et des pipelines ETL avec Genie Migrate
Genie Migrate utilise Genie Code pour convertir le SQL existant de dialectes tels que T-SQL, Snowflake, Redshift, Oracle, BigQuery et Teradata en code exécuté sur Databricks. Il convertit également les charges de travail ETL (extract, transform, and load) d'Informatica PowerCenter (bêta) en notebooks Databricks. Vous organisez votre travail dans un projet de migration et choisissez un framework cible pour la sortie : query Databricks SQL ou Notebooks Databricks (bêta) utilisant l’API DataFrame. Genie Migrate analyse chaque script source, valide la sortie convertie et corrige les erreurs de manière itérative avant d'écrire les résultats dans un dossier de workspace.
Genie Migrate fait partie des outils Databricks permettant de migrer des workloads à partir de data warehouse existants et d’outils ETL vers Databricks. Il convertit vos scripts SQL et pipelines ETL tandis que vous organisez et effectuez le suivi du travail dans un projet de migration.
Comment ça marche
Vous start une conversion en créant un projet de migration dans votre Workspace. Le projet suit l'état de chaque fichier et vous offre un endroit unique pour gérer la migration.

Lorsque vous exécutez une conversion, Genie Code déploie des sous-agents qui convertissent les fichiers simultanément. Chaque sous-agent analyse le dialecte source et génère le code équivalent pour le framework cible du projet (Databricks SQL ou un notebook Databricks). Il vérifie ensuite le code converti :
- Syntaxe : vérifie que le code converti s’exécute sur Databricks sans erreur.
- Intention sémantique : vérifie que le code converti conserve la logique métier de la source, par exemple les mêmes clauses joins et
WHERE.
Lorsqu’une vérification échoue, le sous-agent révise le code et vérifie à nouveau. Genie Code applique également vos compétences personnalisées lorsqu’il convertit des fichiers. Voir Créer une compétence personnalisée (optionnel). Les fichiers convertis sont écrits directement dans le dossier du workspace que vous spécifiez pour le projet.
Vous pouvez également convertir un fichier ou un dossier unique sans projet à l'aide de la commande /migrate dans une conversation Genie Code.
Exigences
- Vos fichiers SQL ou XML existants doivent être accessibles dans votre Workspace, soit upload en tant que fichiers de Workspace, soit ouverts dans l’éditeur.
- Votre Workspace doit répondre aux exigences de Genie Code. See Genie Code.
- Pour utiliser le framework cible Notebooks, l'analyse et la traçabilité de projet ou la conversion Informatica PowerCenter, qui sont en version bêta, un administrateur de workspace doit activer Fonctionnalités expérimentales des projets de migration depuis la page Aperçus . Consultez Gérer les aperçus Databricks.
Sources prises en charge
Le convertisseur prend en charge les dialectes SQL suivants :
- T-SQL
- Snowflake SQL
- Redshift SQL
- Oracle
- BigQuery
- Teradata
Lorsque vous créez un projet de migration pour un dialecte SQL, choisissez l’un des frameworks cibles suivants :
- DBSQL : Query Databricks SQL conformes aux normes ANSI.
- Notebooks (Bêta) : Notebooks Databricks utilisant l’API DataFrame, avec
spark.sqlpour la logique plus claire en SQL.
Bêta
La prise en charge des sources Informatica PowerCenter est en bêta. Pour l’utiliser, un administrateur du Workspace doit activer les Fonctionnalités expérimentales des projets de migration sur la page Aperçus . Consultez Gérer les aperçus Databricks.
Le convertisseur prend également en charge Informatica PowerCenter comme source ETL.
Informatica Intelligent gestion de données Cloud (IDMC) et Informatica Intelligent Cloud Services (IICS) ne sont pas pris en charge. Genie Migrate convertit les objets d’une exportation Informatica, tels que les workflows et les mappages, en notebooks Databricks, afin que les projets Informatica utilisent toujours le framework cible Notebooks.
Pour préparer les workflows Informatica pour la conversion, exportez-les depuis PowerCenter Repository Manager au format XML PowerMart. Exportez au niveau du workflow et incluez les objets dépendants, tels que les mappings, les sessions, les mapplets et les worklets. N'incluez pas les informations d'identification dans l'exportation.
Convertir votre code
Les étapes suivantes décrivent comment convertir les scripts SQL et les pipelines ETL dans un projet de migration.
Étape 1 : upload les fichiers source
upload vos fichiers SQL existants (.sql) ou vos exports ETL (.xml) en utilisant le navigateur de fichiers du Workspace, ou utilisez la Databricks CLI pour upload en masse un répertoire de scripts.
Étape 2 : créez un projet de migration
Créez un projet de migration depuis votre workspace :
- Cliquez sur
 > Projet de migration .
- Saisissez un **Nom** pour le projet.
- Utilisez les sélecteurs déroulants pour choisir un Dialecte source et un Framework cible . Pour Framework cible , choisissez DBSQL pour générer des queries Databricks SQL, ou Notebooks (Beta) pour générer des notebooks Databricks. Si vous choisissez Informatica comme dialecte source, le framework cible est réglé sur Notebook .
- Saisissez le chemin d’accès au fichier du **Dossier de destination** cible. Cliquez sur Parcourir pour choisir une destination dans la liste des dossiers Workspace disponibles.
- Cliquez sur Créer .

Étape 3 : Ajoutez des fichiers à votre projet
Dans le nouveau projet :
- Cliquez sur **Ajouter des fichiers** > **+ Ajouter des fichiers**.
- Sélectionnez le dossier source ou un fichier depuis votre Workspace.
Dans les projets Informatica, seuls .xml fichiers sont ajoutés. Les fichiers d’autres types sont ignorés.
L’ Fichiers tab répertorie chaque fichier avec son type de fichier, le nombre de lignes et l’état de conversion. Les projets Informatica s’ouvrent sur l’onglet tab , qui répertorie chaque exportation avec les objets qu’elle contient.

Étape 4 : examiner la complexité et la traçabilité du code (bêta)
Bêta
Cette fonctionnalité est en version bêta. Pour l’utiliser, un administrateur de workspace doit activer Fonctionnalités expérimentales des projets de migration sur la page Aperçus . Consultez Gérer les aperçus Databricks.
Analysez le projet pour examiner la complexité du code et les dépendances entre les fichiers avant de convertir. L'analyse est facultative pour les projets SQL et obligatoire pour les projets Informatica.
Pour analyser un projet SQL :
- Dans le projet, cliquez sur Analyser tout . Si le projet n’a pas de lignage, Analyser tout est l’action default. Sinon, sélectionnez Analyser tout dans le menu déroulant du bouton. L’analyse couvre tous les fichiers du projet, même si vous sélectionnez des fichiers.
- Attendez que l’analyse se termine. Pour annuler une analyse en cours, cliquez sur Arrêter . Une fois l’analyse terminée, le bouton devient Tout convertir .
- Cliquez sur un fichier source pour ouvrir son évaluation de complexité et cliquez sur Lineage pour ouvrir un graphe de dépendances qui montre les fichiers et les tables interdépendants que vous devez migrer ensemble.

Pour analyser un projet Informatica, cliquez sur Analyser tout sur l'onglet Inventaire tab. L'analyse divise chaque exportation en ses workflows, worklets, mappages et mapplets. Vous devez analyser une exportation avant de pouvoir la convertir.
Étape 5 : Exécutez la conversion
Dans les projets Informatica, vous sélectionnez et convertissez les workflows, les mappings et les autres objets créés par l'analyse, et non les exports .xml upload.
Pour convertir des fichiers spécifiques, sélectionnez-les et cliquez sur Convertir la sélection . Pour convertir tous les fichiers du projet, effacez la sélection et cliquez sur Convertir tout . Genie Code ouvre une conversation, invoque la compétence de migration et déploie des sous-agents pour convertir les fichiers simultanément. Chaque fichier converti apparaît comme un fichier lié dans le projet. Chaque fichier présente l’un des états suivants :
- Gris : le fichier n'a pas encore été converti ( Non start , En file d'attente ou Stopped ). Un indicateur de chargement s'affiche pendant la conversion du fichier.
- Vert non rempli : le fichier a été converti sans problème ( Converti ).
- Vert plein : vous avez révisé et accepté le fichier converti ( Révisé ).
- Jaune : le fichier a été converti, mais il contient des éléments d'action que vous devez examiner.
- Rouge : la conversion a échoué ( erreur ).
Chaque exécution convertit jusqu'à 500 fichiers. Si vous mettez en file d'attente plus de 500 fichiers, les 500 premiers fichiers non convertis seront traités par le batch actuel. Une fois le batch terminé, start à nouveau la conversion pour convertir les 500 fichiers suivants.

Étape 6 : Examiner les résultats de la conversion
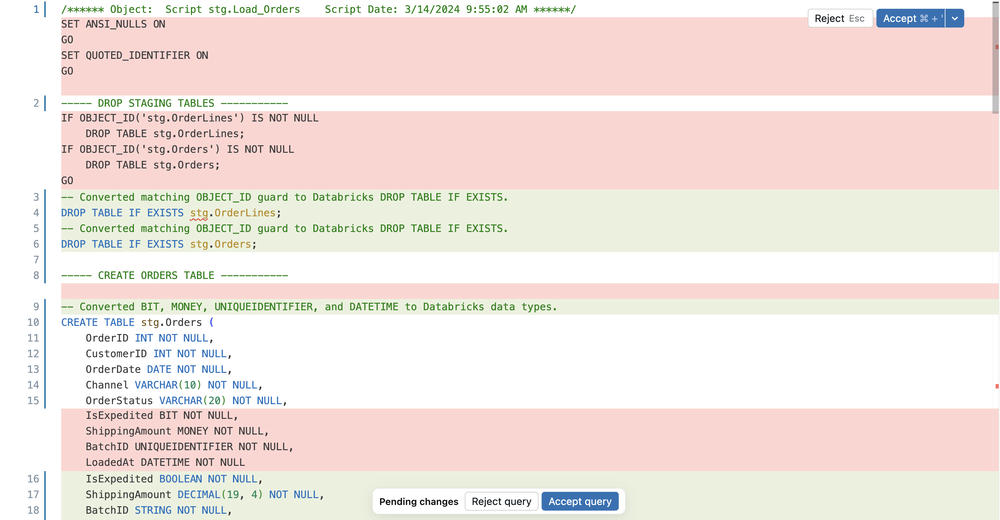
Pour les projets Databricks SQL, cliquez sur un fichier converti pour ouvrir un diff inline dans l’éditeur SQL, qui affiche chaque section du code source au-dessus du SQL Databricks proposé qui le remplace. Acceptez toutes les modifications suggérées, ou examinez et acceptez les modifications individuelles. Pour les projets Notebooks, cliquez sur un fichier converti pour ouvrir le notebook Databricks généré. Pour les scripts qui ne parviennent pas à se convertir, modifiez le code dans l’éditeur ou demandez à Genie Code de revalider ou de réessayer certaines sections. Une fois que vous êtes satisfait, exécutez le SQL ou le notebook converti pour confirmer qu’il s’exécute sur Databricks. Si la même erreur apparaît dans plusieurs fichiers, capturez la correction dans une compétence personnalisée et relancez ces fichiers. Voir Créer une compétence personnalisée (facultatif).
Pour les projets Informatica, comparez chaque notebook généré avec le mappage PowerCenter correspondant. Vérifiez les tables source et cible, les jointures, les filtres et les groupes de routeurs, les recherches, la logique de stratégie de mise à jour et les parameter. Avant d’utiliser un pipeline converti en production, exécutez-le sur des données hors production et comparez les résultats tels que le nombre de lignes et les agrégats clés avec la sortie du workflow PowerCenter.
Créer une compétence personnalisée (facultatif)
Les compétences personnalisées vous permettent d'encoder des règles métier que Genie Code applique automatiquement lors de chaque conversion. Utilisez-les pour gérer les types de données propriétaires, appliquer les modèles cibles préférés ou enregistrer les corrections que vous effectuez de manière répétée. Une compétence de migration est une compétence Genie Code, vous pouvez donc la créer et la gérer de la même manière que toute autre compétence. Pour plus de détails, consultez Étendre Genie Code avec les compétences d'agent.
Il n’est pas nécessaire de définir toutes vos compétences avant votre première conversion. La plupart des règles qu’une compétence devrait capturer ne deviennent claires qu’après avoir examiné les premiers résultats. Un flux de travail classique est :
- Convertissez un ensemble représentatif de fichiers.
- Passez en revue les fichiers avec des éléments d’action ou des erreurs, et recherchez les erreurs qui se répètent dans les fichiers, telles que le même type de données, la même fonction ou le même modèle de nommage non pris en charge.
- Créez une compétence qui capture la correction pour chaque erreur récurrente.
- Sélectionnez uniquement les fichiers concernés et cliquez sur Convertir la sélection . Genie Code applique la nouvelle compétence à ces fichiers.
Répétez ce cycle au fur et à mesure que vous convertissez davantage de code. Genie Code applique chaque compétence aux conversions ultérieures dans le workspace, de sorte qu’un correctif couvre d’autres fichiers avec le même modèle.
Vous pouvez créer une compétence à partir des paramètres de Genie Code ou d'une conversation Genie Code. Utilisez le chemin des paramètres pour les compétences complexes qui incluent des instructions détaillées, des exemples ou des fichiers de support. Utilisez le chemin de discussion pour des compétences rapides et à règle unique.
- Genie Code settings
- Genie Code chat
Créez la compétence en tant que fichier afin que vous puissiez rédiger des instructions détaillées et le versionner dans un dossier Git :
-
Dans le panneau Genie Code, cliquez sur
 Paramètres , puis cliquez sur
 Ouvrir le dossier des compétences .
-
Créez un dossier pour votre compétence sous le chemin des compétences du Workspace,
Workspace/.assistant/skills/. Par exemple,Workspace/.assistant/skills/sql-migration/. -
Dans le dossier de compétences, créez un fichier
SKILL.mdavec le frontmatter requis et vos règles de conversion. Par exemple :---name: sql-migrationdescription: Conversion rules to apply when migrating legacy SQL to ANSI SQL.---Always convert the custom type MYDATE to TIMESTAMP_NTZ.
Genie Code prend en compte la compétence la prochaine fois que vous exécutez une conversion.
Décrivez la règle de conversion que vous souhaitez encoder, puis demandez à Genie Code de l'enregistrer :
Always convert our custom type MYDATE to TIMESTAMP_NTZ. Save this as a custom migration skill.
Genie Code crée et enregistre la compétence et l'applique aux futures conversions dans le Workspace.
Pour afficher les compétences actives :
Show me my migration skills
Pour supprimer une compétence :
Delete the migration skill for [description]
Les compétences Workspace sont stockées au niveau du Workspace et partagées entre tous les utilisateurs du Workspace.
Conseils pour le test
Dans le cadre de sa boucle agentique, le convertisseur analyse chaque script source, valide que la sortie convertie est syntaxiquement valide et sémantiquement équivalente à la source, et corrige itérativement les sections qui échouent avant d'écrire les résultats. Les conseils suivants vous aident à examiner la sortie et à lui faire confiance :
- Conversion par batch : Convertissez un petit batch de deux à cinq fichiers en une session pour vérifier que la conversion de plusieurs fichiers fonctionne de bout en bout.
- Validation syntaxique : Après la conversion, exécutez la sortie dans un éditeur Databricks SQL ou un Notebook pour confirmer qu'elle s'exécute sans erreurs.
- Cas limites : Incluez un script avec des constructions spécifiques au dialecte, telles que des fonctions de fenêtre T-SQL, Snowflake
QUALIFYou Redshift,LISTAGGpour voir comment le convertisseur gère les modèles non triviaux. - Exactitude sémantique : Exécutez les queries originales et converties par rapport à des données de test équivalentes et comparez les résultats. Confirmez que la sortie est sémantiquement correcte, et pas seulement syntaxiquement valide.