Surveiller les applications GenAI en production
Bêta
Cette fonctionnalité est en Bêta. Les administrateurs du Workspace peuvent contrôler l'accès à cette fonctionnalité à partir de la page Previews . Consultez Gérer les aperçus Databricks.
Le monitoring de production vous permet d'exécuter automatiquement des évaluateurs MLflow 3 sur les traces de vos applications GenAI afin d'évaluer continuellement la qualité. Vous planifiez des évaluateurs pour une expérimentation MLflow, et le service de monitoring évalue un échantillon configurable de traces entrantes. Les résultats sont joints sous forme de feedback à chaque trace évaluée.
Le monitoring de production comprend les éléments suivants :
- Évaluation automatisée de la qualité à l’aide d’évaluateurs intégrés ou personnalisés, y compris les juges multivoies pour l’évaluation de conversations entières.
- Taux d'échantillonnage configurables afin que vous puissiez contrôler le compromis entre la couverture et le coût du calcul.
- Utilisez les mêmes évaluateurs en développement et en production pour garantir une évaluation cohérente.
- Évaluation continue de la qualité avec un monitoring en arrière-plan.
Le monitoring de la production MLflow 3 est compatible avec les traces enregistrées depuis MLflow 2.
Prérequis
Avant de configurer le monitoring de production, assurez-vous d'avoir :
-
Expérimentation MLflow : Une expérimentation MLflow où les traces sont journalisées. Si aucune expérience n'est spécifiée, l'expérience active est utilisée.
-
Application de production instrumentée : Votre application GenAI doit enregistrer les traces à l'aide de MLflow Tracing. Consultez le guide de traçage de la production.
-
Évaluateurs définis : Évaluateurs testés qui fonctionnent avec le format de trace de votre application. Si vous avez utilisé votre application de production comme
predict_fndansmlflow.genai.evaluate()pendant le développement, vos évaluateurs sont probablement déjà compatibles. -
Politique budgétaire Serverless : Si votre Workspace n'autorise pas la politique budgétaire Serverless par default, définissez une politique sur l'Experimentation MLflow avant d'enregistrer les évaluateurs. Consultez Configurer une politique budgétaire Serverless pour une Experimentation MLflow.
-
ID du SQL Warehouse (pour les traces Unity Catalog) : si vos traces sont stockées dans Unity Catalog, vous devez configurer un ID de SQL Warehouse pour que le monitoring fonctionne. Voir Activer le monitoring de la production.
Get start
Pour configurer le monitoring de production, vous enregistrez un scorer avec votre Experimentation MLflow, puis le start avec une configuration d’échantillonnage. Ce modèle en deux étapes (.register(), puis .start()) s'applique à tous les types de scorer.
À tout moment, au maximum 20 évaluateurs peuvent être associés à une expérimentation pour un monitoring continu de la qualité.
Pour plus d'informations sur les évaluateurs, consultez les éléments suivants :
Les sections suivantes décrivent comment utiliser les différents types de juges et comment les combiner. Développez une section pour en savoir plus.
Créez et programmez des juges LLM à l'aide de l'interface utilisateur.
Créez et planifiez des juges LLM à l'aide de l'interface utilisateur
Vous pouvez utiliser l’interface utilisateur de l’expérimentation MLflow pour créer et tester des évaluateurs basés sur des juges LLM.
Pour créer un nouveau juge LLM :
-
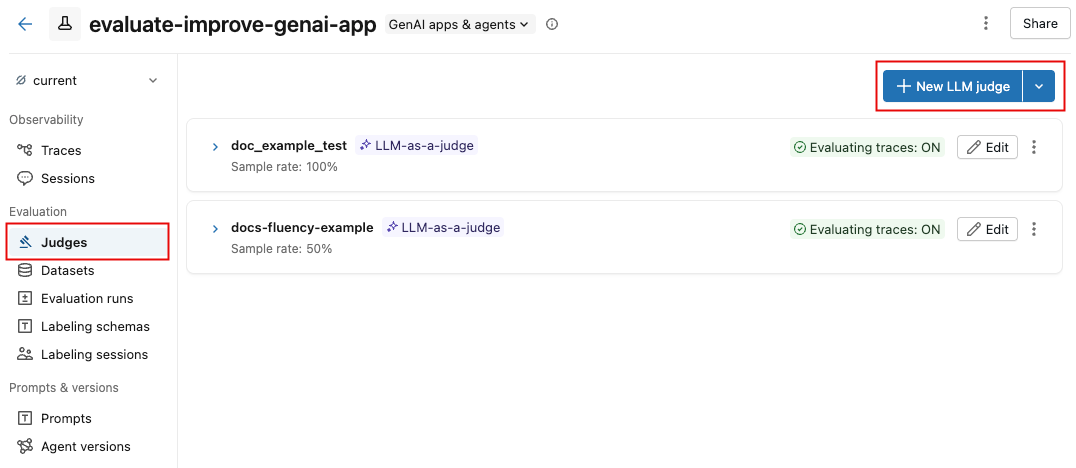
Accédez à l’onglet Scorers dans l’interface utilisateur d’Experimentation MLflow.
-
Cliquez sur **Nouveau juge LLM**.
-
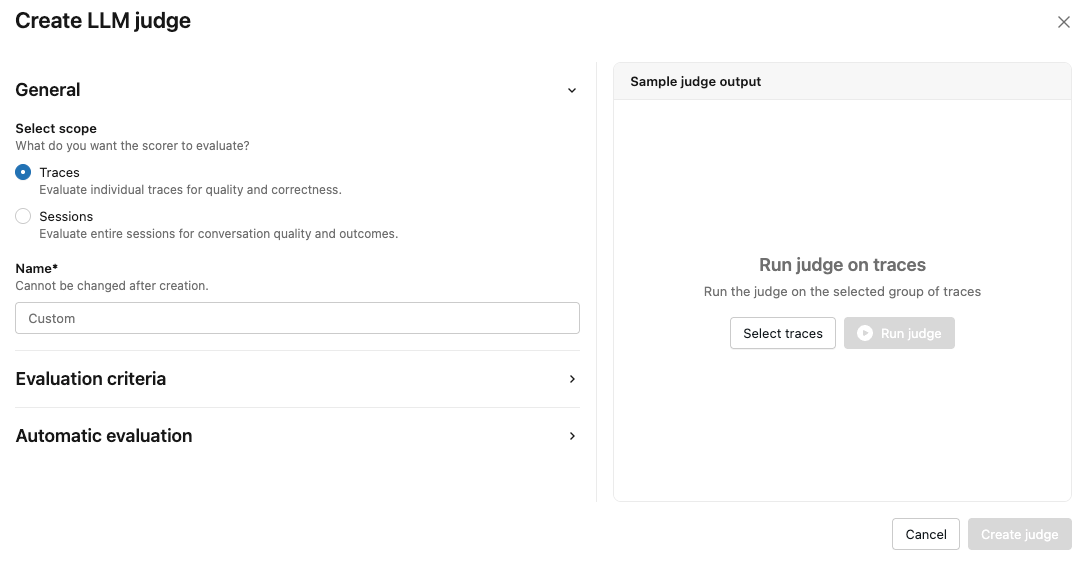
Spécifiez ce que l'évaluateur évaluera en sélectionnant Traces ou Sessions .
-
Saisissez un nom pour le juge.
-
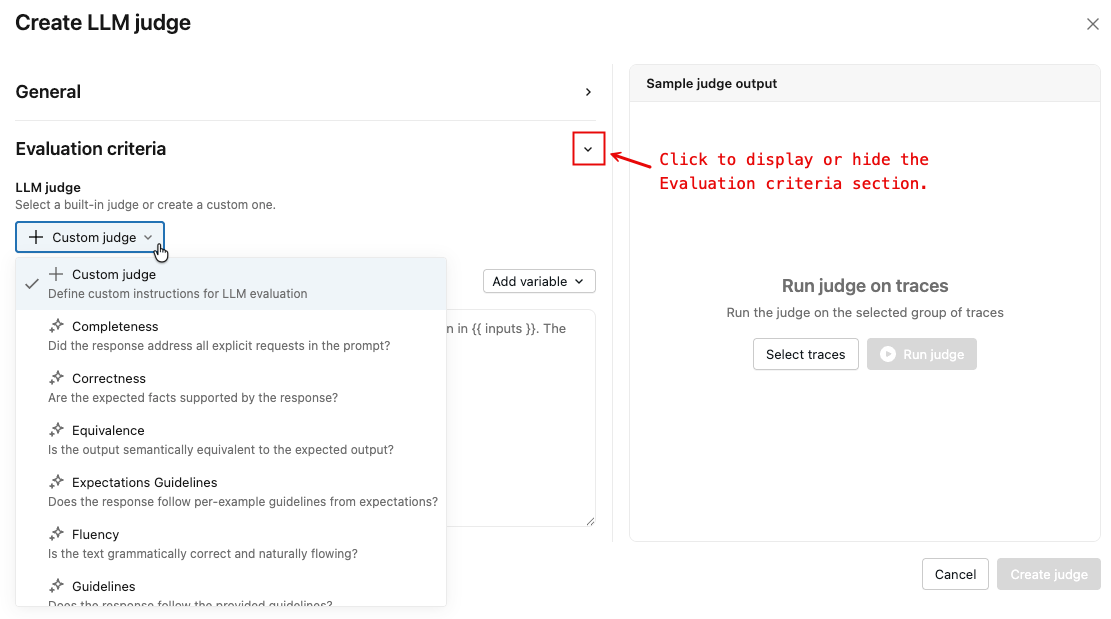
Cliquez sur la flèche comme indiqué pour afficher la section Critères d'évaluation .
-
Dans le menu déroulant, sélectionnez le type de juge. Certains types de juges vous permettent d'entrer des instructions personnalisées, y compris des variables.
-
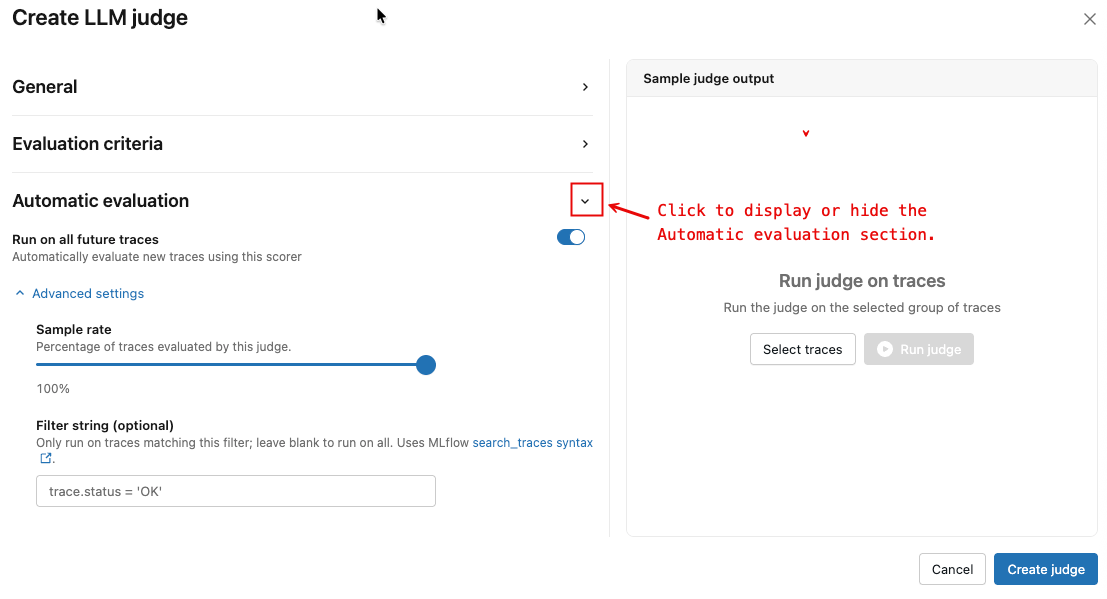
Cliquez sur la flèche comme indiqué pour afficher la section Évaluation automatique .
-
Réglez le bouton bascule **Exécuter sur toutes les traces futures** comme vous le souhaitez.
-
(Facultatif) Sous Paramètres avancés , ajustez le taux d'échantillonnage et la chaîne de filtre pour contrôler les traces évaluées.
-
(Facultatif) : Pour tester le nouveau juge sur un ensemble de traces existantes :
- Cliquez sur **Sélectionner les traces** dans le volet gauche. Une fenêtre contextuelle apparaît.
- Sélectionnez les traces à exécuter et cliquez sur Sélectionner (n) .
- Cliquez sur Exécuter le juge . Les traces sont évaluées et les résultats sont affichés.
- Examiner les résultats. Utilisez les boutons Suivant et Précédent pour parcourir les résultats de chaque trace sélectionnée.
- Si nécessaire, modifiez le juge et itérez jusqu'à ce que vous soyez satisfait des performances du juge.
-
Pour créer le juge, cliquez sur Créer un juge .
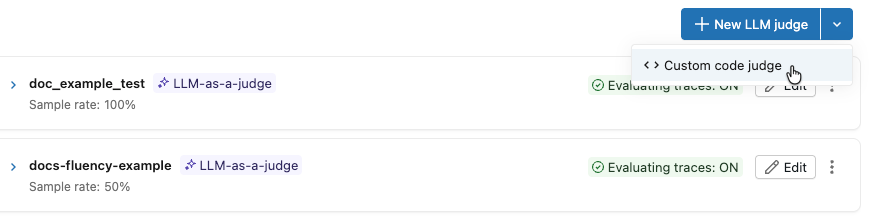
Vous ne pouvez pas créer de juge avec code personnalisé à l'aide de l'interface utilisateur. Pour voir le code de Template que vous pouvez copier dans votre Notebook et modifier au besoin, procédez comme suit :
-
Cliquez sur la flèche déroulante à côté du bouton Nouveau juge LLM, puis sélectionnez Juge de code personnalisé.
-
Une fenêtre contextuelle apparaît avec des instructions et du code template montrant comment définir et exécuter le juge de code personnalisé.
Utiliser des juges LLM intégrés
Utiliser les juges LLM intégrés
MLflow propose plusieurs juges LLM intégrés que vous pouvez utiliser prêts à l’emploi.
from mlflow.genai.scorers import Safety, ScorerSamplingConfig

# Register the scorer with a name and start monitoring
safety_judge = Safety().register(name="my_safety_judge")  # name must be unique to experiment
safety_judge = safety_judge.start(sampling_config=ScorerSamplingConfig(sample_rate=0.7))
Par défaut, chaque évaluateur utilise un LLM hébergé par Databricks conçu pour effectuer des évaluations de qualité GenAI. Vous pouvez modifier le modèle de juge pour qu'il utilise plutôt un Endpoint de service de modèle Databricks en utilisant l'argument model dans la définition du scoreur. Le modèle doit être spécifié au format databricks:/<databricks-serving-endpoint-name>.
safety_judge = Safety(model="databricks:/databricks-gpt-oss-20b").register(name="my_custom_safety_judge")
Utiliser les juges LLM de directives
Utiliser des juges LLM de directives
Juges LLM des lignes directrices évaluent les entrées et les sorties à l'aide de critères de réussite/d'échec en langage naturel.
from mlflow.genai.scorers import Guidelines

# Create and register the guidelines scorer
english_judge = Guidelines(
  name="english",
  guidelines=["The response must be in English"]
).register(name="is_english")  # name must be unique to experiment

# Start monitoring with the specified sample rate
english_judge = english_judge.start(sampling_config=ScorerSamplingConfig(sample_rate=0.7))
Comme les juges intégrés, vous pouvez modifier le modèle de juge pour utiliser plutôt un endpoint de service de modèle Databricks.
english_judge = Guidelines(
  name="english",
  guidelines=["The response must be in English"],
  model="databricks:/databricks-gpt-oss-20b",
).register(name="custom_is_english")
Utiliser les Juges LLM avec des invites personnalisées
Utilisez des Juges LLM avec des invites personnalisées
Pour plus de flexibilité que les juges de lignes directrices, utilisez les juges LLM avec des invites personnalisées qui permettent une évaluation de la qualité à plusieurs niveaux avec des catégories de choix personnalisables.
from typing import Literal
from mlflow.genai import make_judge
from mlflow.genai.scorers import ScorerSamplingConfig

# Create a custom judge using make_judge
formality_judge = make_judge(
    name="formality",
    instructions="""You will look at the response and determine the formality of the response.

Request: {{ inputs }}
Response: {{ outputs }}

Evaluate whether the response is formal, somewhat formal, or not formal.
A response is somewhat formal if it mentions friendship, etc.""",
    feedback_value_type=Literal["formal", "semi_formal", "not_formal"],
    model="databricks:/databricks-gpt-oss-20b",  # optional
)

# Register the custom judge and start monitoring
registered_judge = formality_judge.register(name="my_formality_judge")  # name must be unique to experiment
registered_judge = registered_judge.start(sampling_config=ScorerSamplingConfig(sample_rate=0.1))
Utilisez des fonctions d'évaluation personnalisées
Utiliser des fonctions d’évaluateur personnalisées
Pour une flexibilité maximale, définissez et utilisez une fonction d'évaluateur personnalisée.
:::important Exigences de scorer personnalisé pour le monitoring de production
- Seuls les évaluateurs basés sur le décorateur
@scorersont pris en charge. Les sous-classesScorerbasées sur des classes ne peuvent pas être enregistrées pour le monitoring en production. Si vous avez besoin d'un évaluateur basé sur une classe, refactorisez-le pour utiliser le décorateur@scorerà la place. - Les évaluateurs doivent être définis et enregistrés à partir d'un notebook Databricks. Le service de monitoring sérialise le code de la fonction de l'évaluateur pour l'exécution à distance, et cette sérialisation nécessite l'environnement Notebook. Les évaluateurs définis dans des fichiers Python autonomes ou des environnements IDE locaux ne peuvent pas être sérialisés pour la monitoring de production.
- Les évaluateurs doivent être autonomes. Étant donné que les fonctions d'évaluateur sont sérialisées en tant que code pour l'exécution à distance, toutes les importations doivent être effectuées en ligne dans le corps de la fonction. La fonction ne peut pas référencer des variables, des objets ou des modules définis en dehors d'elle.
:::
Lorsque vous définissez des évaluateurs personnalisés, n'utilisez pas d'indications de type qui doivent être importées dans la signature de la fonction. Si le corps de la fonction d'évaluateur utilise des packages qui doivent être importés, importez ces packages en ligne dans la fonction pour garantir une sérialisation correcte.
Certains packages sont disponibles par « default » sans avoir besoin d’un import en ligne. Cela inclut databricks-agents, mlflow-skinny, openai et tous les packages inclus dans Environment version 2.
from mlflow.genai.scorers import scorer, ScorerSamplingConfig


# Custom metric: Check if response mentions Databricks
@scorer
def mentions_databricks(outputs):
    """Check if the response mentions Databricks"""
    return "databricks" in str(outputs.get("response", "")).lower()

# Register and start monitoring
databricks_scorer = mentions_databricks.register(name="databricks_mentions")
databricks_scorer = databricks_scorer.start(sampling_config=ScorerSamplingConfig(sample_rate=0.5))
Pour plus d'exemples de scorings personnalisés, consultez scorings basés sur le code.
Utiliser les judges multi-tours
Utiliser des juges à plusieurs tours
Le monitoring de production prend en charge les juges multivoies qui évaluent des conversations entières plutôt que des traces individuelles. Ces juges évaluent les modèles de qualité à travers de multiples interactions, telles que la frustration de l'utilisateur et l'exhaustivité de la conversation. Les juges multi-tours sont enregistrés et start de la même manière que les juges à un tour.
Le Job de monitoring regroupe automatiquement les traces en conversations en fonction du tag mlflow.trace.session. Les juges multi-tours s'exécutent une fois qu'une conversation est considérée comme terminée. Par défaut, une conversation est considérée comme terminée lorsqu'aucune nouvelle trace avec cet ID de session n'est ingérée pendant **5 minutes**. Pour configurer ce tampon, définissez la variable d'environnement MLFLOW_ONLINE_SCORING_DEFAULT_SESSION_COMPLETION_BUFFER_SECONDS sur le Job de monitoring.
Pour la liste complète des juges multivoies disponibles, voir Juges multivoies. Pour plus de détails sur l'évaluation des conversations, consultez Évaluer les conversations.
To use multi-turn judges, your agent must set session IDs on traces. See Track users and sessions for details.
from mlflow.genai.scorers import (
    ConversationCompleteness,
    UserFrustration,
    ScorerSamplingConfig,
)

# Register and start multi-turn judges just like single-turn judges
completeness_scorer = ConversationCompleteness().register(name="conversation_completeness")
completeness_scorer = completeness_scorer.start(
    sampling_config=ScorerSamplingConfig(sample_rate=1.0),
)

frustration_scorer = UserFrustration().register(name="user_frustration")
frustration_scorer = frustration_scorer.start(
    sampling_config=ScorerSamplingConfig(sample_rate=1.0),
)
Combiner les juges
Combiner les juges
Vous pouvez combiner des juges à un tour et des juges à plusieurs tours dans la même expérimentation. Enregistrez et start chaque évaluateur individuellement.
from mlflow.genai.scorers import Safety, Guidelines, UserFrustration, ScorerSamplingConfig

# Single-turn judges
safety_judge = Safety().register(name="safety")
safety_judge = safety_judge.start(sampling_config=ScorerSamplingConfig(sample_rate=1.0))

english_judge = Guidelines(
    name="english",
    guidelines=["The response must be in English"]
).register(name="is_english")
english_judge = english_judge.start(sampling_config=ScorerSamplingConfig(sample_rate=0.5))

# Multi-turn judge
frustration_judge = UserFrustration().register(name="frustration")
frustration_judge = frustration_judge.start(sampling_config=ScorerSamplingConfig(sample_rate=0.3))
Afficher les résultats
Après la planification des scorers, prévoyez 15 à 20 minutes pour le traitement initial. Ensuite :
- Accédez à votre expérience MLflow.
- Ouvrez l'onglet Traces pour voir les évaluations jointes aux traces.
- Utilisez les tableaux de bord de monitoring pour suivre les tendances de qualité.
Pour les juges multi-tours, les évaluations sont attachées à la première trace de chaque session. Consultez Comment les évaluations sont stockées pour plus de détails.
Bonnes pratiques
Stratégie d’échantillonnage
-
Pour les évaluateurs critiques tels que les vérifications de sûreté et de sécurité, utilisez
sample_rate=1.0. -
Pour les évaluateurs coûteux, tels que les juges LLM complexes, utilisez des taux d'échantillonnage plus faibles (0,05-0,2).
-
Pour une amélioration itérative pendant le développement, utilisez des taux modérés (0,3-0,5).
-
Équilibrez la couverture et le coût, comme le montrent les exemples suivants :
Python# High-priority scorers: higher sampling
safety_judge = Safety().register(name="safety")
safety_judge = safety_judge.start(sampling_config=ScorerSamplingConfig(sample_rate=1.0)) # 100% coverage for critical safety
# Expensive scorers: lower sampling
complex_scorer = ComplexCustomScorer().register(name="complex_analysis")
complex_scorer = complex_scorer.start(sampling_config=ScorerSamplingConfig(sample_rate=0.05)) # 5% for expensive operations
Filtrer les traces
Utilisez le paramètre filter_string dans ScorerSamplingConfig pour contrôler les traces qu'un évaluateur évalue. Ceci utilise la même syntaxe de filtre que mlflow.search_traces().
from mlflow.genai.scorers import Safety, ScorerSamplingConfig

# Only evaluate traces that completed successfully
safety_judge = Safety().register(name="safety")
safety_judge = safety_judge.start(
    sampling_config=ScorerSamplingConfig(
        sample_rate=1.0,
        filter_string="attributes.status = 'OK'"
    ),
)
Vous pouvez combiner plusieurs conditions :
import time

# Evaluate successful traces from the last 24 hours
one_day_ago = int((time.time() - 86400) * 1000)
safety_judge = safety_judge.start(
    sampling_config=ScorerSamplingConfig(
        sample_rate=0.5,
        filter_string=f"attributes.status = 'OK' AND attributes.timestamp_ms > {one_day_ago}"
    ),
)
Conception d'évaluateur personnalisé
Maintenez les évaluateurs personnalisés autonomes, comme le montre l'exemple suivant :
@scorer
def well_designed_scorer(inputs, outputs):
    # All imports inside the function
    import re
    import json

    # Handle missing data gracefully
    response = outputs.get("response", "")
    if not response:
        return 0.0

    # Return consistent types
    return float(len(response) > 100)
Dépannage
Évaluateurs non exécutés
Si les évaluateurs ne s'exécutent pas, vérifiez les points suivants :
- Vérifier l'expérimentation : Assurez-vous que les traces sont enregistrées dans l'expérimentation, et non dans des exécutions individuelles.
- Taux d'échantillonnage : Avec des taux d'échantillonnage faibles, l'affichage des résultats peut prendre du temps.
- Vérifiez la chaîne de filtre : assurez-vous que votre
filter_stringcorrespond aux traces réelles.
Problèmes de sérialisation
Les évaluateurs personnalisés pour le monitoring de production sont sérialisés afin qu'ils puissent être exécutés à distance par le service de monitoring. Ceci impose plusieurs contraintes :
- Prérequis du Notebook : Les fonctions
@scorerpersonnalisées doivent être définies et enregistrées depuis un Notebook Databricks. Le mécanisme de sérialisation repose sur l'environnement du notebook. - Fonctions autonomes : toutes les importations doivent être intégrées dans le corps de la fonction. Les références à des variables, modules ou objets externes définis en dehors de la fonction ne sont pas capturées pendant la sérialisation.
- Pas de scorers basés sur des classes : seuls les scorers basés sur le décorateur
@scorerpeuvent être enregistrés. Les sous-classes basées sur des classesScorerne peuvent pas être sérialisées pour une exécution à distance. - Aucune indication de type nécessitant des importations : Les indications de type dans la signature de fonction qui nécessitent des instructions d'importation (par exemple,
Listdetyping) provoquent des échecs de sérialisation.
Lorsque vous créez un évaluateur personnalisé, incluez les importations dans la définition de la fonction.
# Avoid external dependencies
import external_library  # Outside function

@scorer
def bad_scorer(outputs):
    return external_library.process(outputs)

# Include imports in the function definition
@scorer
def good_scorer(outputs):
    import json  # Inside function
    return len(json.dumps(outputs))

# Avoid using type hints in scorer function signature that requires imports
from typing import List

@scorer
def scorer_with_bad_types(outputs: List[str]):
    return False

# Class-based scorers are not supported for production monitoring
class MyScorer(Scorer):
    name: str = "my_scorer"
    def __call__(self, outputs):
        return len(outputs) > 10
Ressources supplémentaires
- Gérer les scoreurs de production — Gérez le cycle de vie de vos scoreurs de production.
- Remplir rétrospectivement les traces historiques avec des évaluateurs — Appliquer rétrospectivement des évaluateurs aux traces historiques.
- Archiver les traces dans une table Delta – Enregistrer les traces et les évaluations dans une table Delta.
- Évaluateurs basés sur du code – Créez des évaluateurs adaptés à vos besoins.
- Évaluez les conversations – Découvrez l'évaluation des conversations à plusieurs tours et les juges à plusieurs tours.
- Création de datasets d'évaluation MLflow — Utilisez les résultats du monitoring pour améliorer la qualité.
Guides de référence
- Référence de l'API de gestion du cycle de vie des scoreurs - Référence de l'API pour la gestion du cycle de vie des scoreurs.
- Évaluateurs et juges LLM — Comprendre les métriques qui alimentent le monitoring.
- Évaluer les applications GenAI pendant le développement – Comment l'évaluation hors ligne se rapporte à la production.