Gérer les projets
Un projet est le conteneur de niveau supérieur pour vos Lakebase Ressources, y compris les Branch, les compute, les bases de données et les rôles. Cette page explique comment créer des projets, comprendre leur structure, configurer les paramètres et gérer leur cycle de vie.
Si vous débutez avec Lakebase, commencez par start pour créer votre premier projet.
Comprendre les projets
Structure du projet
Comprendre la structure du projet Lakebase vous aide à organiser et à gérer efficacement vos ressources. Un projet est le conteneur de niveau supérieur pour vos bases de données, Branch, computes et ressources associées. Chaque projet inclut des paramètres pour les valeurs par défaut du compute, les fenêtres de restauration et les mises à jour qui s'appliquent à toutes les branches au sein du projet.
Au niveau supérieur, un projet contient une ou plusieurs branches. Dans un projet, vous pouvez créer des branches pour différents environnements tels que le développement, les tests, la pré-production et la production. Chaque branch contient ses propres compute, rôles et bases de données.
Project
  └── Branches (main, development, staging, etc.)
        ├── Computes (R/W compute)
        ├── Roles (Postgres roles)
        └── Databases (Postgres databases)
Branch
Les données résident dans des Branch. Chaque projet Lakebase est créé avec une Branch racine appelée production, qui ne peut pas être supprimée. Bien que vous puissiez créer des branches supplémentaires et désigner une autre Branch comme votre Branch default, la Branch racine ne peut pas être supprimée.
Vous pouvez créer des Branches enfants à partir de n'importe quelle Branch de votre projet. Lorsque vous créez une Branch enfant, elle hérite de toutes les bases de données, rôles et données de sa Branch parente au moment de la création. Les modifications ultérieures apportées à la Branch parente ne se propagent pas automatiquement à la Branch enfant, ce qui permet un développement, des tests ou une Experimentation isolés.
Chaque Branch peut contenir plusieurs bases de données et rôles. En savoir plus : Gérer les branches
compute
Un compute est une ressource de calcul virtualisée qui inclut des vCPU et de la mémoire pour l'exécution de Postgres. Lorsque vous créez un projet, un compute principal R/W (lecture-écriture) est créé pour la Branch par default du projet. Chaque Branch dispose d'un seul compute R/W principal. Pour vous connecter à une base de données qui réside sur une Branch, vous devez vous connecter via le compute R/W associé à la Branch.
En plus du compute R/W principal, vous pouvez ajouter un ou plusieurs computes de répliques en lecture (lecture seule) à n’importe quelle Branch. Les réplicas en lecture vous permettent de décharger les charges de travail en lecture seule de votre compute principal pour des cas d'utilisation tels que la mise à l'échelle horizontale en lecture, les requêtes analytiques et de reporting, et l'accès en lecture seule pour les utilisateurs ou les applications. En savoir plus : Gérer les computes, Réplicas en lecture
Rôles
Les rôles sont des rôles Postgres. Un rôle est requis pour créer et accéder à une base de données. Un rôle appartient à une Branch. Lorsque vous créez un projet, un rôle Postgres est automatiquement créé pour votre identité Databricks (par exemple, user@databricks.com), qui est le propriétaire de la base de données databricks_postgres default. Tout rôle créé dans l'interface utilisateur Lakebase est créé avec databricks_superuser privilèges. Il y a une limite de 500 rôles par Branch. En savoir plus : Gérer les rôles
Bases de données
Une base de données est un conteneur pour les objets SQL tels que les schémas, les tables, les vues, les fonctions et les index. Dans Lakebase, une base de données appartient à une Branch. La branch default de votre projet est créée avec une base de données nommée databricks_postgres. Il y a une limite de 500 bases de données par branch. En savoir plus : Gérer les bases de données
Schémas
Toutes les bases de données dans Lakebase sont créées avec un schéma public, ce qui est le comportement default pour toute instance PostgreSQL standard. Les objets SQL sont créés dans le schéma public default.
Limites de projet
Lakebase Postgres applique les limites suivantes pour les projets :
Ressource | Limite |
|---|---|
Nombre maximal de compute simultanés actifs | 20 |
Nombre maximal de réplicas en lecture par Branch | 6 |
Nombre maximum de Branch par projet | 500 |
Nombre maximum de rôles Postgres par Branch | 500 |
Nombre maximum de bases de données Postgres par Branch | 500 |
Quota de stockage de la base de données (par Branch) | Ajustable sur demande |
Nombre maximum de projets par workspace | 1000 |
Nombre maximum de branches protégées | 1 |
Nombre maximal de Branch racine | 3 |
Nombre maximal d'instantanés manuels | 10 |
Période de rétention maximale de l’historique | 30 jours |
Durée minimale de monter en charge à zéro. | 60 secondes |
Durée maximale de dimensionnement à zéro | 7 jours |
Limite de compute actif simultané
La limite de compute actifs simultanément limite le nombre de compute pouvant s'exécuter simultanément afin d'éviter l'épuisement des Ressources. Cette limite protège contre les pics de Ressources accidentels, tels que le démarrage de plusieurs Endpoint de compute simultanément. La limite par default est de 20 compute actifs simultanément par projet.
Important : la branch default est exempte de cette limite, ce qui garantit sa disponibilité à tout moment.
Lorsque vous dépassez la limite, les compute supplémentaires au-delà de la limite restent suspendus et une erreur s'affiche lorsque vous tentez de vous y connecter. Pour résoudre ce problème :
- Suspendre d'autres computes actifs et réessayez.
- Si vous rencontrez souvent cette erreur, contactez le support Databricks pour demander une augmentation de la limite.
Les computes avec mise à l'échelle jusqu'à zéro activée se suspendent automatiquement après une période d'inactivité, vous aidant à rester dans la limite de compute actifs simultanés.
Quota de stockage de la base de données
Chaque Branch dispose d’un quota de stockage de base de données. Il s’agit d’un quota opérationnel plutôt que d’une limite architecturale, car les données résident dans le stockage d’objets cloud au lieu d’être sur un disque local provisionné. Si vous avez besoin d’un quota plus important, contactez l’assistance Databricks.
Lorsqu’une base de données atteint son quota, les performances d’écriture diminuent, mais vous pouvez toujours supprimer des données pour récupérer de l’espace.
Un compute prend en compte le quota actuel lors de son prochain start ou redémarrage. Un compute déjà en cours d'exécution continue d'utiliser le quota avec lequel il a démarré jusqu'à son prochain redémarrage.
Seules vos données réelles (tables et index, comme signalé par Postgres) sont prises en compte dans le quota. L’historique conservé pour la restauration à un instant T ne l’est pas.
Disponibilité régionale
Régions prises en charge :
us-east-1(Est des États-Unis - Virginie du Nord)us-east-2(US East - Ohio)us-west-2(États-Unis – Ouest – Oregon)ca-central-1(Canada – Centre)sa-east-1(Amérique du Sud - São Paulo)eu-central-1(Europe–Francfort)eu-west-1(Europe – Irlande)eu-west-2(Europe – Londres)eu-west-3(Europe - Paris)ap-south-1(Asie-Pacifique - Mumbai)ap-southeast-1(Asie-Pacifique - Singapour)ap-southeast-2(Asie-Pacifique - Sydney)ap-southeast-3(Asie-Pacifique - Jakarta)ap-northeast-1(Asie-Pacifique - Tokyo)ap-northeast-2(Asie-Pacifique - Séoul)
Votre projet Lakebase est créé dans la région de votre workspace Databricks.
Prise en charge de la version Postgres
Lakebase prend en charge Postgres 16, Postgres 17, Postgres 18 et Postgres 19. Postgres 18 est la version par default. Pour utiliser une version différente, sélectionnez-la lors de la création d'un nouveau projet. Certaines fonctionnalités ne sont pas disponibles sur Postgres 19. Voir Limites de Postgres 19. Pour déplacer un projet existant vers une version majeure plus récente, consultez Mises à niveau de version majeure.
Créer et gérer des projets
Créer un projet
Vous pouvez créer plusieurs projets dans Lakebase Postgres pour maintenir les applications ou les clients entièrement isolés, garantissant une séparation claire des données et des ressources.
Aperçu
Dans les Workspace inscrits dans la Private Preview de la politique de compute Serverless :
- La création d'un projet Lakebase nécessite
CAN_USEouCAN_MANAGEsur une stratégie autorisant Lakebase. - La modification de la capacité de compute ou des paramètres pour monter en charge vers zéro nécessite
CAN_MANAGEsur le projet Lakebase etCAN_USEouCAN_MANAGEsur sa politique. Cela s’applique même si la politique ne définit aucune limite pour le paramètre. - Modifier le nom d'affichage d'un projet Lakebase ne nécessite que
CAN_MANAGEsur le projet Lakebase. - Le remplacement de la stratégie nécessite
CAN_MANAGEsur le projet Lakebase etCAN_USEouCAN_MANAGEsur les deux stratégies. La suppression despec.compute_policy_idaffecte la stratégie Lakebase default en remplacement.
Les paramètres mis à jour doivent respecter les contraintes actuelles de la politique et conserver les paires clé-valeur de tag requises. Voir Autorisations pour les modifications de configuration.
Pour demander un accès en préversion, contactez l’équipe chargée de votre compte Databricks.
Pour sélectionner une politique de compute dans la préversion, définissez spec.compute_policy_id dans la requête API Postgres. La configuration de compute du projet Lakebase doit respecter les limites de cette politique. Pour voir un exemple, consultez Créer un projet Lakebase avec une politique.
Le budget_policy_id dans les exemples ci-dessous sélectionne une politique d’utilisation serverless pour l’attribution des coûts.
Pour créer un projet :
- UI
- Python SDK
- Java SDK
- CLI
- curl
- Cliquez sur le sélecteur d’applications dans le coin supérieur droit pour ouvrir l’application Lakebase.
- Cliquez sur **Nouveau projet**.
- Configurez les paramètres de votre projet :
- Nom d'affichage : Entrez un nom pour votre projet. Vous pouvez utiliser tous les caractères, y compris les espaces et les caractères spéciaux. Les modèles de dénomination courants incluent la dénomination d'après l'application (par exemple,
My Analytics App) ou le client ou le tenant que le projet sert (par exemple,Acme Corp DB). Un nom de ressource est automatiquement dérivé de votre nom d'affichage et est utilisé pour identifier le projet dans les appels d'API et de SDK. La boîte de dialogue affiche le nom de ressource résultant (par exemple,projects/my-analytics-app) afin que vous puissiez le vérifier avant de créer le projet. - Postgres version : sélectionnez la version de Postgres que vous voulez utiliser.
- Politique d'utilisation serverless (facultatif) : Sélectionnez une politique d'utilisation serverless pour attribuer les coûts de compute serverless à une politique spécifique. Voir les politiques d’utilisation Serverless.
- Nom d'affichage : Entrez un nom pour votre projet. Vous pouvez utiliser tous les caractères, y compris les espaces et les caractères spéciaux. Les modèles de dénomination courants incluent la dénomination d'après l'application (par exemple,
La boîte de dialogue Créer un projet affiche les options de configuration du projet.
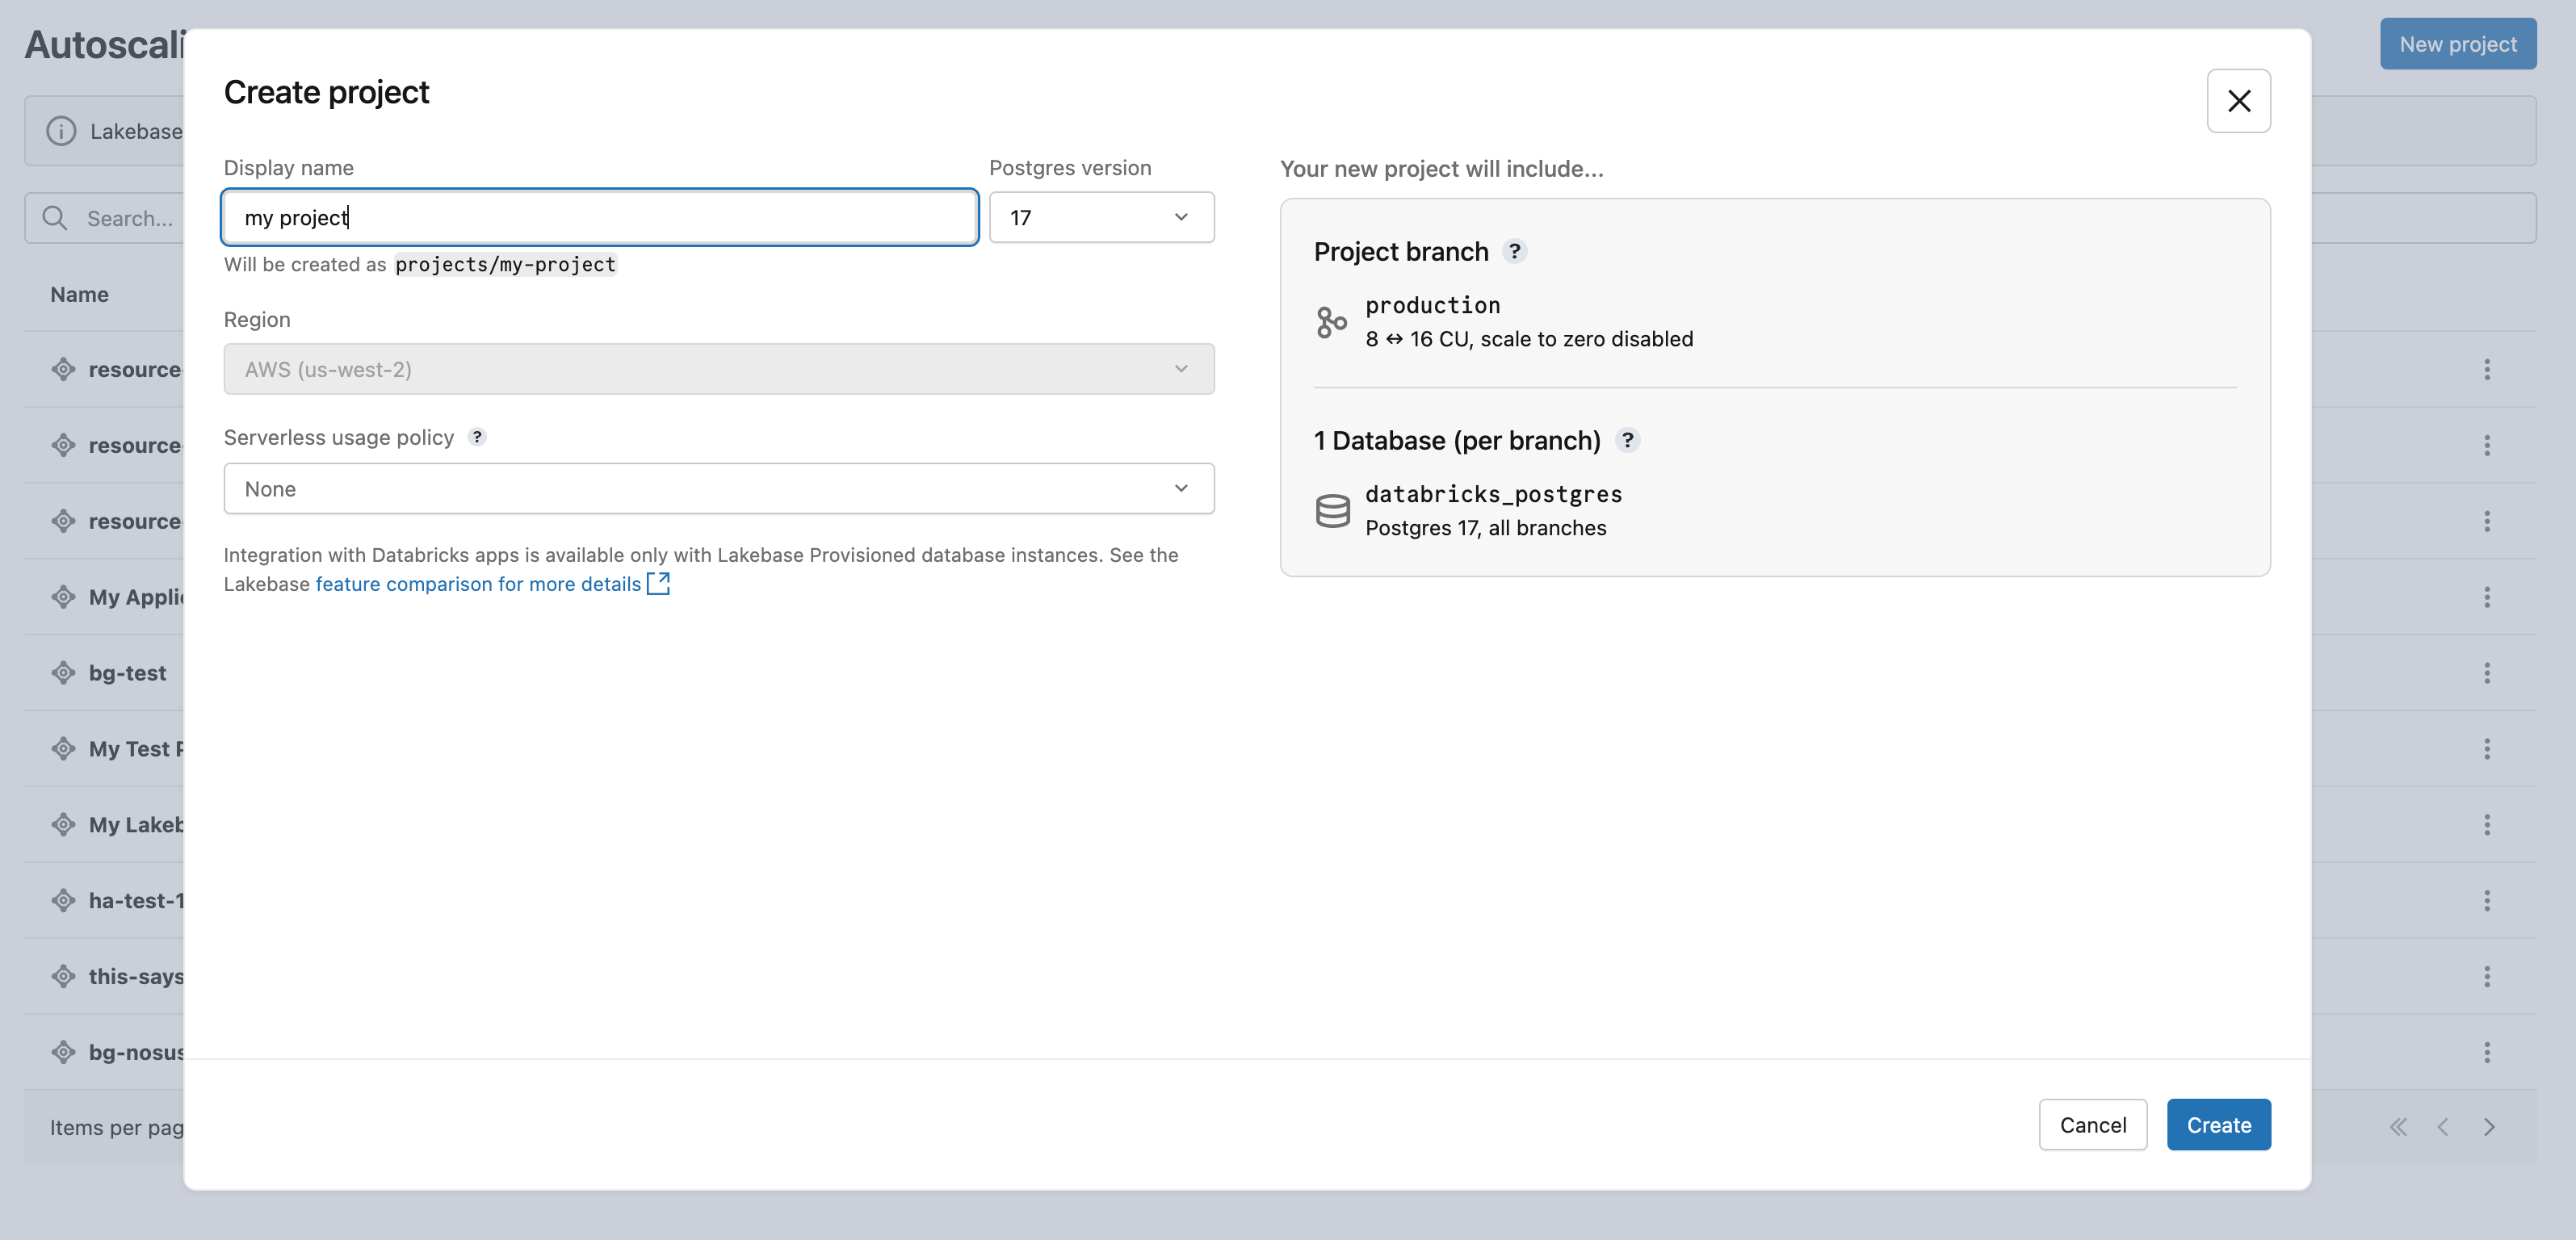
La **région** de votre projet Lakebase est définie sur la région de votre Workspace Databricks et ne peut pas être modifiée.
from databricks.sdk import WorkspaceClient
from databricks.sdk.service.postgres import Project, ProjectSpec

# Initialize the Workspace client
w = WorkspaceClient()

# Create a project with a custom project ID
operation = w.postgres.create_project(
    project=Project(
        spec=ProjectSpec(
            display_name="My Application",
            pg_version=17,
            budget_policy_id="<policy-id>"
        )
    ),
    project_id="my-app"
)

# Wait for operation to complete
result = operation.wait()
print(f"Created project: {result.name}")
print(f"Display name: {result.status.display_name}")
print(f"Postgres version: {result.status.pg_version}")
import com.databricks.sdk.WorkspaceClient;
import com.databricks.sdk.service.postgres.*;

// Initialize the Workspace client
WorkspaceClient w = new WorkspaceClient();

// Create a project with a custom project ID
CreateProjectOperation operation = w.postgres().createProject(
    new CreateProjectRequest()
        .setProjectId("my-app")
        .setProject(new Project()
            .setSpec(new ProjectSpec()
                .setDisplayName("My Application")
                .setPgVersion(17L)))
);

// Wait for operation to complete
Project result = operation.waitForCompletion();
System.out.println("Created project: " + result.getName());
System.out.println("Display name: " + result.getStatus().getDisplayName());
System.out.println("Postgres version: " + result.getStatus().getPgVersion());
# Create a project with a custom project ID
databricks postgres create-project my-app \
  --json '{
    "spec": {
      "display_name": "My Application",
      "pg_version": 17,
      "budget_policy_id": "<policy-id>"
    }
  }'
Créez un projet avec un ID de projet personnalisé. Le project_id est spécifié comme paramètre de query et fait partie du nom de la ressource du projet (par exemple, projects/my-app).
curl -X POST "$WORKSPACE/api/2.0/postgres/projects?project_id=my-app" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" \
  -H "Content-Type: application/json" \
  -d '{
    "spec": {
      "display_name": "My Application",
      "pg_version": 17,
      "budget_policy_id": "<policy-id>"
    }
  }' | jq
Il s'agit d'une opération de longue durée. La réponse inclut un nom d'opération que vous pouvez utiliser pour vérifier le statut. L'opération se termine généralement en quelques secondes.
Le paramètre project_id est obligatoire.
Si vous créez un projet avec le même ID qu’un projet récemment supprimé, notez que les ID de projet supprimés sont réservés pendant 7 jours. Pour réutiliser l'ID immédiatement, supprimez définitivement d'abord le projet original.
Un nouveau projet inclut les ressources suivantes par default :
-
Une seule Branch
production(la Branch default) -
Un seul compute primaire en lecture-écriture associé à la Branch avec les paramètres default suivants :
Branche
Unités de calcul (CU)
Haute disponibilité
Dimensionnement automatique
Dimensionner à zéro
production8 à 16 CU
Lorsque vous créez un projet Lakebase, la Branch
productionest créée avec un compute pour lequel la fonction monter en charge à zéro est activée par default avec un délai d'inactivité de 24 heures. Si une politique de compute Serverless nécessite un délai d'inactivité, maintenez la fonctionnalité Monter en charge à zéro activée et choisissez un délai d'inactivité dans sa limite. Sinon, vous pouvez ajuster le délai d'inactivité ou désactiver Monter en charge à zéro pour ce compute. -
Une base de données Postgres (nommée
databricks_postgres) -
Un rôle Postgres pour votre identité Databricks (par exemple,
user@example.com)
Pour modifier les paramètres de compute d'un projet existant, consultez Configurer les paramètres du projet. Pour modifier les paramètres de compute par default pour les nouveaux projets, consultez Compute defaults dans Configurer les paramètres du projet.
Obtenir les détails du projet
Récupérez les détails d'un projet spécifique.
- UI
- Python SDK
- Java SDK
- CLI
- curl
- Cliquez sur le sélecteur d’applications dans le coin supérieur droit pour ouvrir l’application Lakebase.
- Sélectionnez votre projet dans la liste des projets pour afficher ses détails.
from databricks.sdk import WorkspaceClient

w = WorkspaceClient()

# Get project details
project = w.postgres.get_project(name="projects/my-project")

print(f"Project: {project.name}")
print(f"Display name: {project.status.display_name}")
print(f"Postgres version: {project.status.pg_version}")
import com.databricks.sdk.WorkspaceClient;
import com.databricks.sdk.service.postgres.Project;

WorkspaceClient w = new WorkspaceClient();

// Get project details
Project project = w.postgres().getProject("projects/my-project");

System.out.println("Project: " + project.getName());
System.out.println("Display name: " + project.getStatus().getDisplayName());
System.out.println("Postgres version: " + project.getStatus().getPgVersion());
# Get project details
databricks postgres get-project projects/my-project
curl -X GET "$WORKSPACE/api/2.0/postgres/projects/my-project" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" | jq
La réponse comprend :
name: Nom de la ressource (projects/my-project)status: configuration du projet et état actuel (display_name, pg_version, etc.)
Remarque : Le champ spec n'est pas renseigné pour les opérations GET. Toutes les propriétés de ressource sont renvoyées dans le champ status.
Lister les projets
Listez tous les projets de votre workspace.
- UI
- Python SDK
- Java SDK
- CLI
- curl
- Cliquez sur le sélecteur d’applications dans le coin supérieur droit pour ouvrir l’application Lakebase.
- La liste des projets affiche tous les projets auxquels vous avez accès.
from databricks.sdk import WorkspaceClient

w = WorkspaceClient()

# List all projects
projects = w.postgres.list_projects()

for project in projects:
    print(f"Project: {project.name}")
    print(f"  Display name: {project.status.display_name}")
    print(f"  Postgres version: {project.status.pg_version}")
import com.databricks.sdk.WorkspaceClient;
import com.databricks.sdk.service.postgres.*;

WorkspaceClient w = new WorkspaceClient();

// List all projects
for (Project project : w.postgres().listProjects(new ListProjectsRequest())) {
    System.out.println("Project: " + project.getName());
    System.out.println("  Display name: " + project.getStatus().getDisplayName());
    System.out.println("  Postgres version: " + project.getStatus().getPgVersion());
}
# List all projects
databricks postgres list-projects
curl -X GET "$WORKSPACE/api/2.0/postgres/projects" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" | jq
Format de réponse :
{
  "projects": [
    {
      "name": "projects/my-project",
      "status": {
        "display_name": "My Project",
        "pg_version": 17
      }
    }
  ]
}
Configurer les paramètres du projet
Pour les autorisations de stratégie et les exigences de remplacement lors de l'aperçu, consultez Autorisations pour les modifications de configuration et Remplacer la stratégie d'un projet Lakebase.
Pour modifier les paramètres d'un projet Lakebase, ouvrez Paramètres dans son tableau de bord.
Paramètres généraux
La page des paramètres généraux affiche les champs suivants :
- Nom d’affichage : Le nom d’affichage modifiable de votre projet.
- Nom de la ressource : Lecture seule. Le chemin d'accès complet de la ressource pour votre projet (format :
projects/{project_id}). Utilisez cette valeur dans les appels API et SDK pour identifier le projet. - UID : Lecture seule. L'identifiant unique généré par le système pour votre projet.
- Politique d'utilisation Serverless : Associez une politique d'utilisation serverless à votre projet pour attribuer les coûts de compute serverless à une politique spécifique. Voir les politiques d’utilisation Serverless.
- Tags personnalisés : Ajoutez des tags clé-valeur à votre projet. Les tags sont enregistrées dans les relevés d'utilisation facturables de votre compte (
system.billing.usage) et peuvent être utilisées pour suivre les coûts par équipe, projet ou centre de coûts. Voir Tags personnalisés. Lorsque vous mettez à jour des tags personnalisés à l'aide de l'API ou de la CLI, la nouvelle liste remplace tous les tags existants.
- UI
- Python SDK
- CLI
- curl

from databricks.sdk import WorkspaceClient
from databricks.sdk.service.postgres import Project, ProjectSpec, ProjectCustomTag, FieldMask

w = WorkspaceClient()

# Update project display name
w.postgres.update_project(
    name="projects/my-project",
    update_mask=FieldMask(field_mask=["spec.display_name"]),
    project=Project(spec=ProjectSpec(display_name="My Updated Project Name"))
).wait()

# Update serverless usage policy
w.postgres.update_project(
    name="projects/my-project",
    update_mask=FieldMask(field_mask=["spec.budget_policy_id"]),
    project=Project(spec=ProjectSpec(budget_policy_id="<policy-id>"))
).wait()

# Update custom tags (replaces all existing tags)
w.postgres.update_project(
    name="projects/my-project",
    update_mask=FieldMask(field_mask=["spec.custom_tags"]),
    project=Project(spec=ProjectSpec(custom_tags=[
        ProjectCustomTag(key="team", value="data-eng"),
        ProjectCustomTag(key="cost-center", value="1234")
    ]))
).wait()
# Update project display name
databricks postgres update-project projects/my-project spec.display_name \
  --json '{
    "spec": {
      "display_name": "My Updated Project Name"
    }
  }'

# Update serverless usage policy
databricks postgres update-project projects/my-project spec.budget_policy_id \
  --json '{
    "spec": {
      "budget_policy_id": "<policy-id>"
    }
  }'

# Update custom tags
databricks postgres update-project projects/my-project spec.custom_tags \
  --json '{
    "spec": {
      "custom_tags": [
        {"key": "team", "value": "data-eng"},
        {"key": "cost-center", "value": "1234"}
      ]
    }
  }'
# Update project display name
curl -X PATCH "$WORKSPACE/api/2.0/postgres/projects/my-project?update_mask=spec.display_name" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" \
  -H "Content-Type: application/json" \
  -d '{
    "spec": {
      "display_name": "My Updated Project Name"
    }
  }' | jq

# Update serverless usage policy
curl -X PATCH "$WORKSPACE/api/2.0/postgres/projects/my-project?update_mask=spec.budget_policy_id" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" \
  -H "Content-Type: application/json" \
  -d '{
    "spec": {
      "budget_policy_id": "<policy-id>"
    }
  }' | jq

# Update custom tags
curl -X PATCH "$WORKSPACE/api/2.0/postgres/projects/my-project?update_mask=spec.custom_tags" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" \
  -H "Content-Type: application/json" \
  -d '{
    "spec": {
      "custom_tags": [
        {"key": "team", "value": "data-eng"},
        {"key": "cost-center", "value": "1234"}
      ]
    }
  }' | jq
Il s'agit d'Opérations de longue durée. La réponse inclut un nom d'opération que vous pouvez utiliser pour vérifier le statut.
Compute default
Ces paramètres par défaut sont utilisés comme paramètres initiaux pour tout compute principal ou de réplique en lecture que vous créez. La modification de ces default ne modifie pas les paramètres des computes existants.
Si votre Workspace est inscrit à la version préliminaire privée de la politique de compute Serverless, choisissez des valeurs par default qui respectent les limites de la politique de compute Serverless applicable en matière de capacité et de temps d'inactivité avant de monter en charge à zéro. Pour les autorisations requises afin de modifier ces paramètres par default, consultez Autorisations pour les modifications de configuration.
Valeurs default :
- **Taille du Compute** : 2 ↔ 4 CU (plage de dimensionnement automatique ; ~4 à 8 Go de RAM)
- Mise à l'échelle à zéro : activée par default — Suspendre le compute après une période d'inactivité est cochée, avec Suspendre après 24 heures sélectionnée
Cliquez sur Modifier les default pour ouvrir la boîte de dialogue et modifier ces valeurs.
Pour modifier les paramètres d'un compute existant, consultez Gérer les computes.
Lakebase Postgres prend en charge les tailles de compute de 0,5 CU à 112 CU. L'autoscaling est disponible pour les computes jusqu'à 64 CU (0,5, puis par incréments entiers : 1, 2, 3... 64). Des computes de taille fixe plus grands sont disponibles jusqu'à 112 CU. Chaque unité de compute (CU) fournit 2 Go de RAM.
Tailles représentatives :
Unités de compute | RAM |
|---|---|
0,5 CU | 1 Go |
1 unité de contrôle | 2 Go |
4 CU | 8 Go |
8 CU | 16 Go |
16 CU | 32 Go |
32 CU | 64 Go |
64 CU | 128 Go |
112 unités de contrôle | 224 Go |
- Pour activer le dimensionnement automatique, définissez une plage de taille de compute à l'aide du curseur. La montée en charge automatique ajuste dynamiquement les ressources de compute en fonction de la demande de charge de travail. Voir Dimensionnement automatique.
- Ajustez le paramètre Monter en charge à zéro pour augmenter ou diminuer la durée d'inactivité du compute avant sa suspension (de 60 secondes à 7 jours lorsque cette option est activée). Vous pouvez également désactiver le fait de monter en charge à zéro pour un compute toujours actif si la politique de compute applicable le permet. Voir Monter en charge à zéro.

Fenêtre d'historique
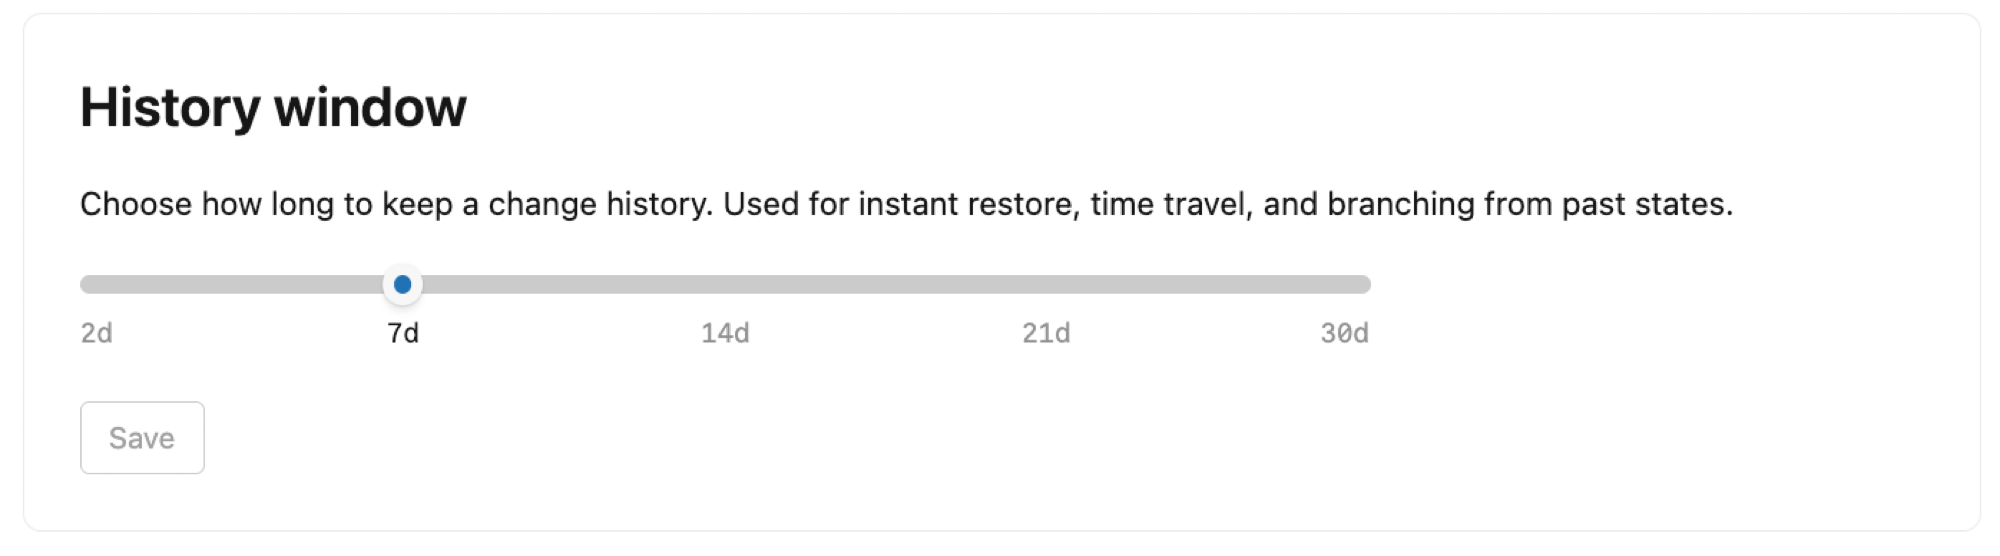
Configurer la longueur de la fenêtre d'historique pour votre projet. Par default, Lakebase conserve un historique des modifications pour les branches racines de votre projet, ce qui permet la restauration à un point dans le temps pour récupérer des données perdues, l' interrogation des données à un point dans le temps pour investiguer des problèmes de données, et le branchement à partir d'états passés pour les flux de travail de développement.
Vous pouvez définir la fenêtre d'historique de 2 jours à 30 jours, avec un default de 7 jours. Notez que :
- L'extension de la fenêtre d'historique augmente votre stockage.
- Le paramètre de la fenêtre d'historique affecte toutes les branches de votre projet.
Autorisations du projet
Contrôlez qui peut accéder et gérer votre projet Lakebase en accordant des autorisations aux identités, groupes et Service Principal Databricks. Les autorisations de projet déterminent les actions que les utilisateurs peuvent effectuer au sein du projet, telles que la création de branches, la gestion des computes et la consultation des détails de connexion.
Types d’autorisations :
- **CAN CREATE** : Afficher et créer des ressources de projet
- PEUT UTILISER : Afficher et utiliser les ressources de projet (répertorier, afficher, connecter et effectuer certaines opérations de Branch) sans créer ni supprimer de projets ou de Branches
- CAN MANAGE : contrôle total sur la configuration du projet et les ressources
default permissions :
Lorsque vous créez un projet, les autorisations suivantes sont automatiquement attribuées :
- Propriétaire du projet (l'utilisateur qui a créé le projet) : CAN MANAGE (contrôle total)
- Utilisateurs du Workspace : PEUVENT CRÉER (peuvent consulter et créer des projets)
- Administrateurs du Workspace : CAN MANAGE (contrôle total)
Pour obtenir les autorisations de politique supplémentaires requises dans la version préliminaire, consultez la section Autorisations pour les modifications de configuration.
Pour accorder l'accès à d'autres utilisateurs, consultez Gérer les autorisations du projet.
Les autorisations de projet et l'accès à la base de données sont séparés
Les autorisations de projet contrôlent les actions de la plateforme Lakebase, tandis que l'accès à la base de données est contrôlé par les rôles Postgres et leurs autorisations associées. Consultez Créer des rôles Postgres et Gérer les autorisations de base de données.

Mises à jour
Pour maintenir vos services de calcul Lakebase et vos instances Postgres à jour, Lakebase applique automatiquement les mises à jour planifiées qui incluent des mises à niveau des versions mineures de Postgres, des correctifs de sécurité et des fonctionnalités de plateforme. Les mises à jour sont appliquées aux computes au sein de votre projet et nécessitent un bref redémarrage du compute qui prend quelques secondes.
Les mises à jour sont appliquées automatiquement, mais vous pouvez définir un jour et une heure préférés pour les mises à jour. Les redémarrages se produisent dans la fenêtre horaire sélectionnée.
Pour des informations détaillées sur les mises à jour, consultez Gérer les mises à jour.

Supprimer un projet
Lorsque vous supprimez un projet, il passe par default à un état de suppression provisoire et est conservé pendant 7 jours avant d'être définitivement supprimé. Pendant cette fenêtre, vous pouvez récupérer le projet et restaurer toutes ses données. Consultez Récupérer un projet supprimé. Pour ignorer la période de rétention et supprimer immédiatement le projet, consultez Supprimer un projet définitivement.
Lorsqu'un projet est supprimé de manière logique, les tentatives de connexion ou de récupération des informations d'identification de la base de données renvoient des erreurs génériques (telles que le Endpoint introuvable ou la connexion refusée) plutôt qu'une erreur indiquant que le projet a été supprimé. Si vous rencontrez ces erreurs de manière inattendue, vérifiez si le projet a été supprimé logiquement en listant les projets avec show_deleted=true. Voir Trouver les projets supprimés de manière logique.
Avant la suppression
Databricks recommande de supprimer tous les catalogues Unity Catalog associés et les tables synchronisées avant de supprimer le projet. Sinon, toute tentative de consulter les catalogues ou d'exécuter des queries SQL qui y font référence entraînera des erreurs.
Si vous n'êtes pas le propriétaire des tables ou des catalogues, vous devez vous réaffecter la propriété avant la suppression.
Seuls les utilisateurs disposant de l'autorisation CAN MANAGE sur le projet Lakebase peuvent le supprimer. Consultez les ACLs de projet et Gérer les autorisations de projet pour plus de détails.
Supprimer un projet
Pour supprimer un projet :
- UI
- Python SDK
- Java SDK
- CLI
- curl
- Accédez aux Paramètres de votre projet dans l'application Lakebase.
- Dans la section Supprimer le projet , cliquez sur Supprimer et saisissez le nom du projet pour confirmer la suppression.
from databricks.sdk import WorkspaceClient

w = WorkspaceClient()

# Delete a project
operation = w.postgres.delete_project(name="projects/my-project")

print(f"Delete operation started: {operation.name()}")
Il s'agit d'une opération de longue durée. Le projet et toutes ses ressources (Branch, Endpoint, bases de données, rôles, données) seront supprimés.
import com.databricks.sdk.WorkspaceClient;

WorkspaceClient w = new WorkspaceClient();

// Delete a project
w.postgres().deleteProject("projects/my-project");

System.out.println("Delete operation started");
Il s'agit d'une opération de longue durée. Le projet et toutes ses ressources (Branch, Endpoint, bases de données, rôles, données) seront supprimés.
# Delete a project
databricks postgres delete-project projects/my-project
Cette commande s'exécute immédiatement. Le projet et toutes ses ressources seront supprimés.
curl -X DELETE "$WORKSPACE/api/2.0/postgres/projects/my-project" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" | jq
Il s'agit d'une opération de longue durée. La réponse inclut un nom d’opération que vous pouvez utiliser pour vérifier l’état de suppression.
Supprimer définitivement un projet
Pour supprimer définitivement un projet Lakebase immédiatement sans attendre l'expiration de la période de rétention de suppression logicielle de 7 jours :
- Python SDK
- Java SDK
- CLI
- curl
from databricks.sdk import WorkspaceClient

w = WorkspaceClient()

operation = w.postgres.delete_project(name="projects/my-project", purge=True)
operation.wait()
import com.databricks.sdk.WorkspaceClient;
import com.databricks.sdk.service.postgres.DeleteProjectRequest;

WorkspaceClient w = new WorkspaceClient();

w.postgres().deleteProject(
    new DeleteProjectRequest()
        .setName("projects/my-project")
        .setPurge(true)
).waitForCompletion();
databricks postgres delete-project projects/my-project --purge
curl -X DELETE "$WORKSPACE/api/2.0/postgres/projects/my-project?purge=true" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" | jq
Récupérer un projet supprimé
Lorsque vous supprimez un projet Lakebase, il passe à l'état de suppression logicielle et est conservé pendant 7 jours avant d'être définitivement supprimé. Pendant cette fenêtre, vous pouvez récupérer le projet et restaurer toutes ses données.
Qu'est-ce qui est restauré
La récupération d’un projet supprimé logiquement restaure les éléments suivants :
- Toutes les Branch et leurs données
- Toutes les bases de données et rôles Postgres
- Tous les Endpoints compute et leurs configurations
- Paramètres du projet, y compris les paramètres de compute par default, les paramètres de restauration des fenêtres et les préférences de mise à jour
- Autorisations de projet
Certaines ressources peuvent nécessiter une reconfiguration après la récupération. Contactez l’ assistance Databricks si vous rencontrez des problèmes après avoir récupéré un projet.
Trouver les projets supprimés de manière logique
Pour lister tous les projets, y compris ceux qui ont été supprimés logiquement, utilisez le show_deleted paramètre. Ceci est utile pour trouver le nom de la Ressource d'un projet que vous souhaitez récupérer.
- Python SDK
- CLI
- curl
from databricks.sdk import WorkspaceClient

w = WorkspaceClient()

for project in w.postgres.list_projects(show_deleted=True):
    print(f"Project: {project.name}")
    print(f"  Display name: {project.status.display_name}")
    if project.delete_time:
        print(f"  Deleted: {project.delete_time}")
        print(f"  Purge time: {project.purge_time}")
databricks postgres list-projects --show-deleted
curl -X GET "$WORKSPACE/api/2.0/postgres/projects?show_deleted=true" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" | jq
Récupérer un projet
Pour récupérer un projet Lakebase supprimé de manière non définitive :
- Python SDK
- Java SDK
- CLI
- curl
from databricks.sdk import WorkspaceClient

w = WorkspaceClient()

operation = w.postgres.undelete_project(name="projects/my-project")
operation.wait()
import com.databricks.sdk.WorkspaceClient;
import com.databricks.sdk.service.postgres.UndeleteProjectRequest;

WorkspaceClient w = new WorkspaceClient();

w.postgres().undeleteProject(
    new UndeleteProjectRequest().setName("projects/my-project")
).waitForCompletion();
databricks postgres undelete-project projects/my-project
curl -X POST "$WORKSPACE/api/2.0/postgres/projects/my-project/undelete" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" | jq