Jobs ou exécuteurs défaillants supprimés
Les jobs qui échouent et les exécuteurs supprimés coûtent du temps. Lorsqu'un exécuteur est supprimé, Spark réexécute ses tâches non terminées. Lorsqu'un job Spark échoue, la query ou la tâche qui exécute le job échoue également. Utilisez cette page pour découvrir pourquoi les jobs échouent ou les exécuteurs sont supprimés, et pour déterminer si le comportement est attendu ou s'il s'agit d'un problème à résoudre.
Utilisez cette page lorsque la chronologie des jobs indique des jobs ayant échoué ou des exécuteurs supprimés, par exemple :
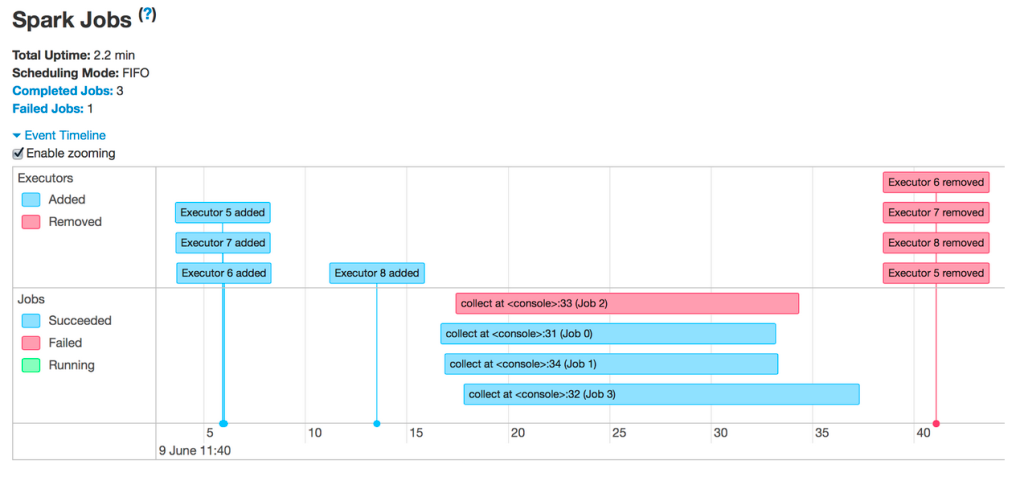
Si la chronologie n'affiche pas de jobs en échec ou d'exécuteurs supprimés, consultez la chronologie des jobs pour rechercher d'autres modèles et utilisez les autres pages de ce guide pour diagnostiquer le problème. Consultez Diagnostiquer les problèmes de coût et de performance à l'aide de la Spark UI.
Les raisons les plus courantes de la suppression des exécuteurs sont :
- Dimensionnement automatique : Dans ce cas, c'est attendu et non une erreur. Consultez Activer le dimensionnement automatique.
- Perte d'instance ponctuelle : le fournisseur cloud récupère vos machines virtuelles. Voir Perte d'instances ponctuelles.
- Exécuteurs en panne de mémoire : consultez Problèmes de mémoire Spark.
Jobs en échec
Si vous voyez des jobs qui échouent, cliquez dessus pour ouvrir leurs pages. Faites ensuite défiler vers le bas pour voir l'étape échouée et la raison de l'échec :
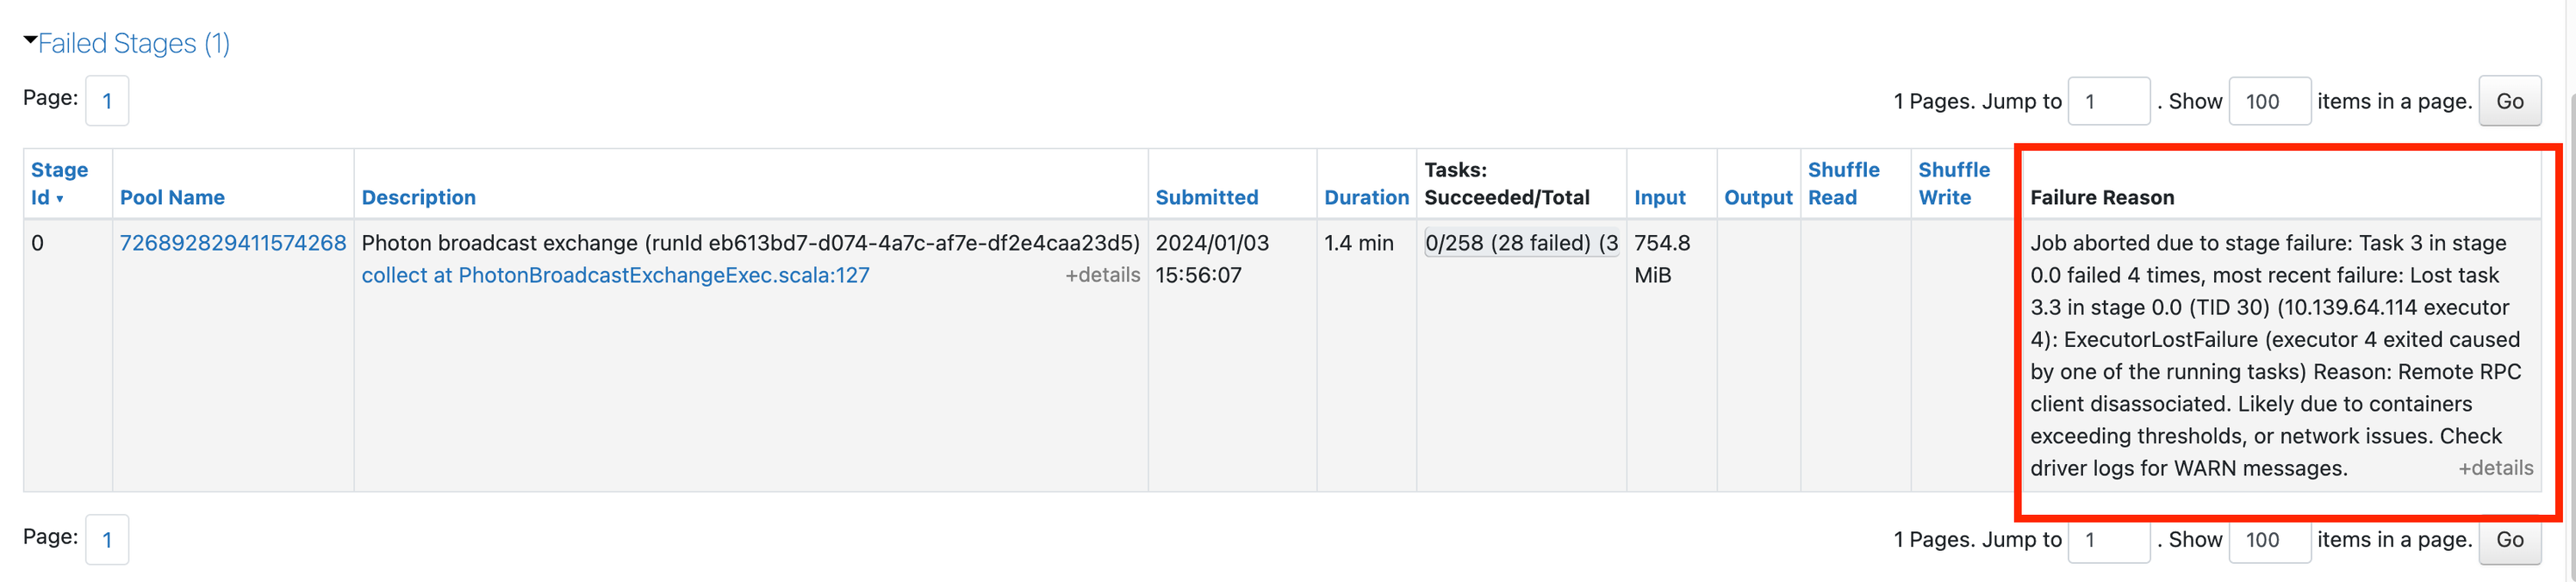
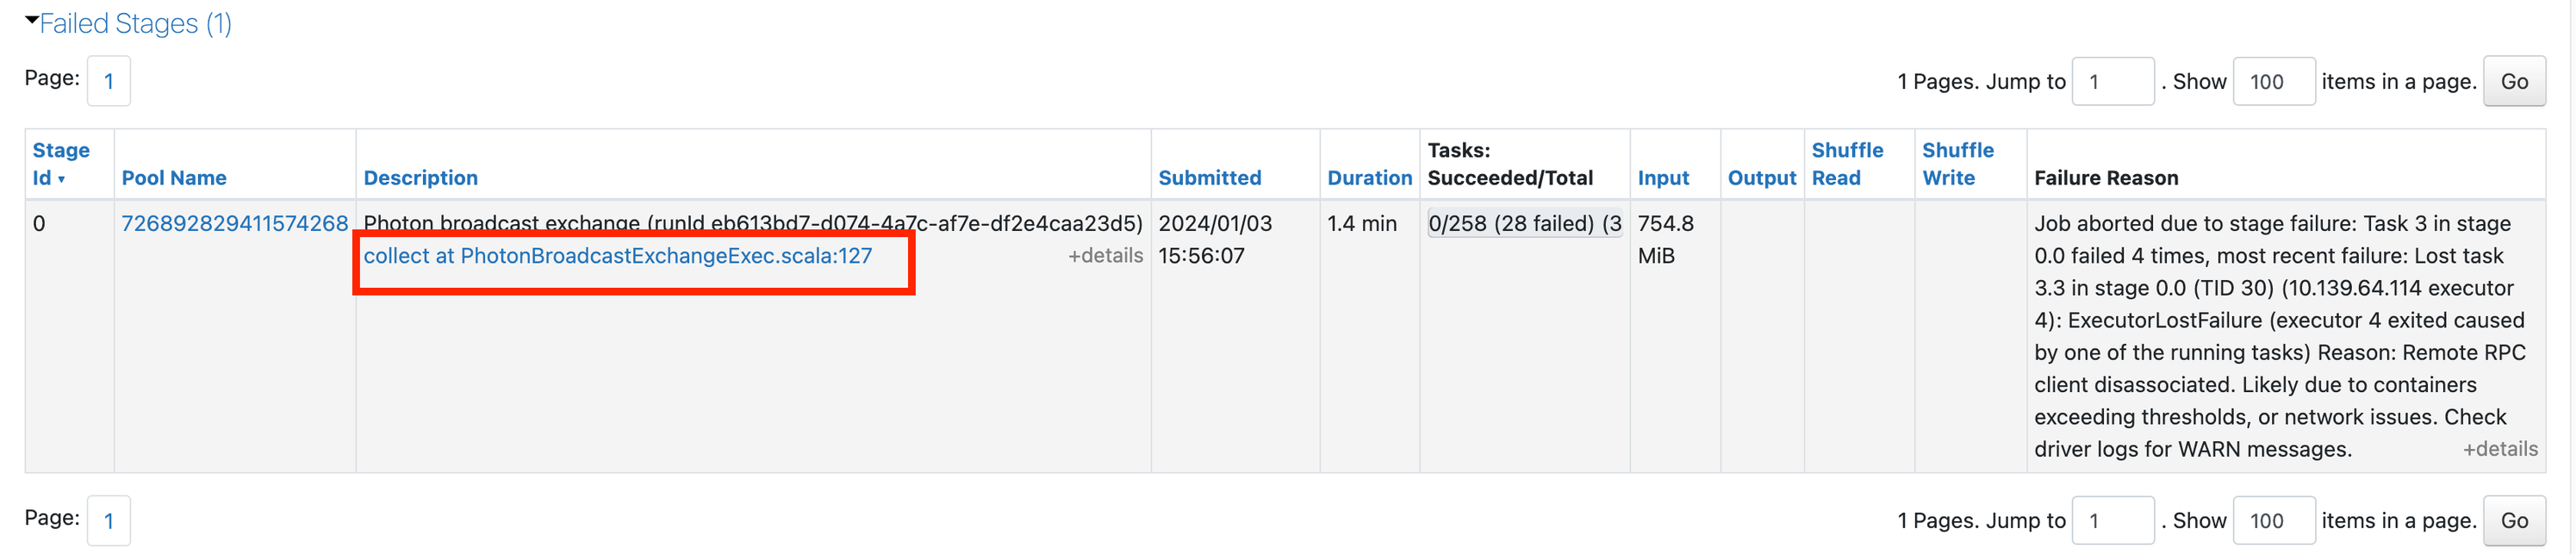
Vous pouvez obtenir une erreur générique. Cliquez sur le Link dans la description pour voir plus de détails :
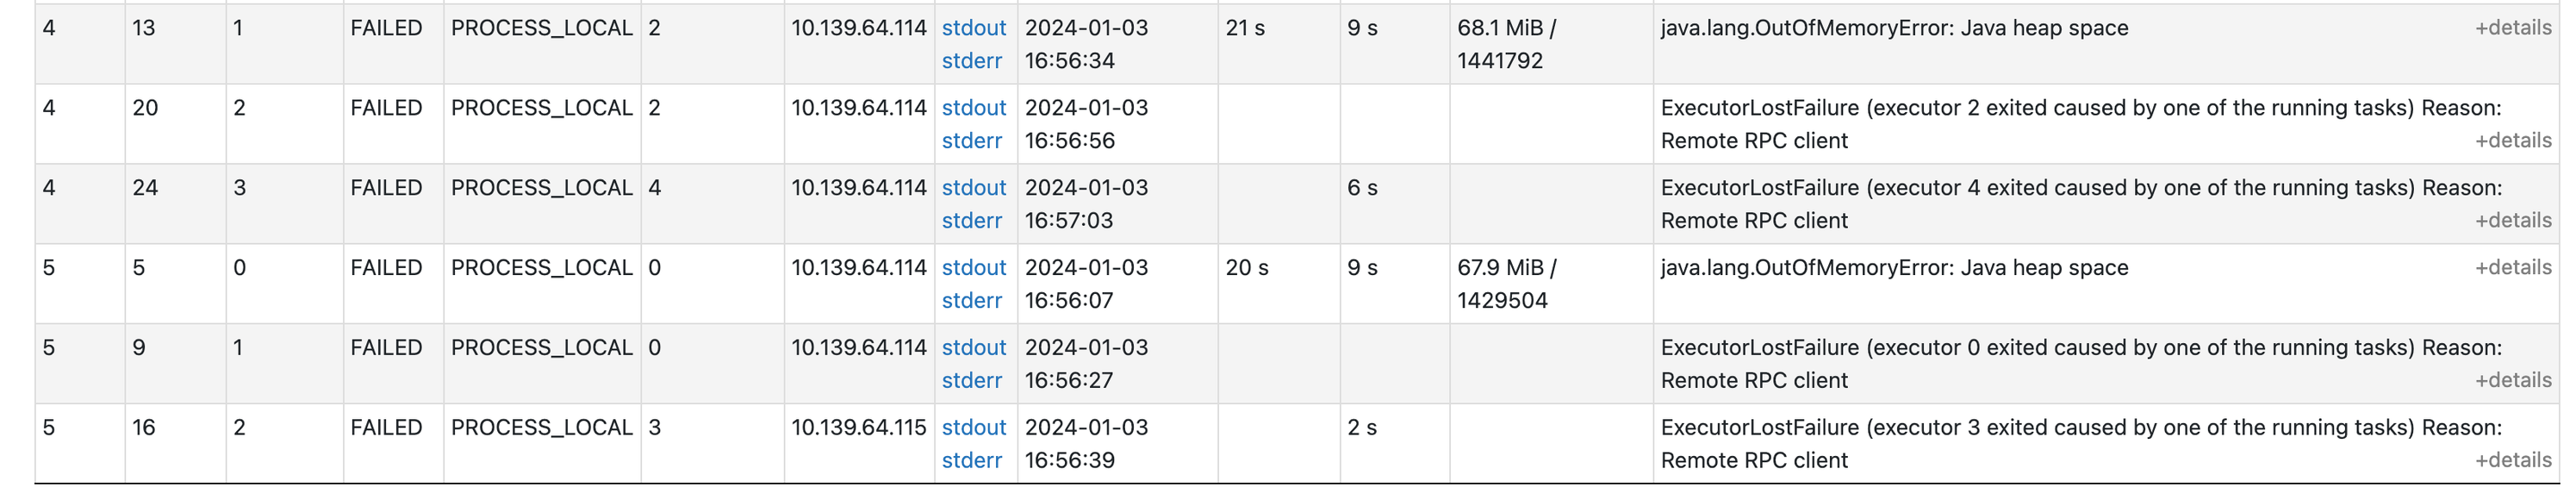
Si vous faites défiler cette page vers le bas, vous verrez pourquoi chaque tâche a échoué. Dans ce cas, un problème de mémoire semble en être la cause :
Exécuteurs défaillants
Pour savoir pourquoi vos exécuteurs échouent, vérifiez d'abord le journal des événements du compute pour voir s'il existe une explication pour les échecs des exécuteurs. Par exemple, si vous utilisez des instances ponctuelles, le fournisseur cloud peut les récupérer.
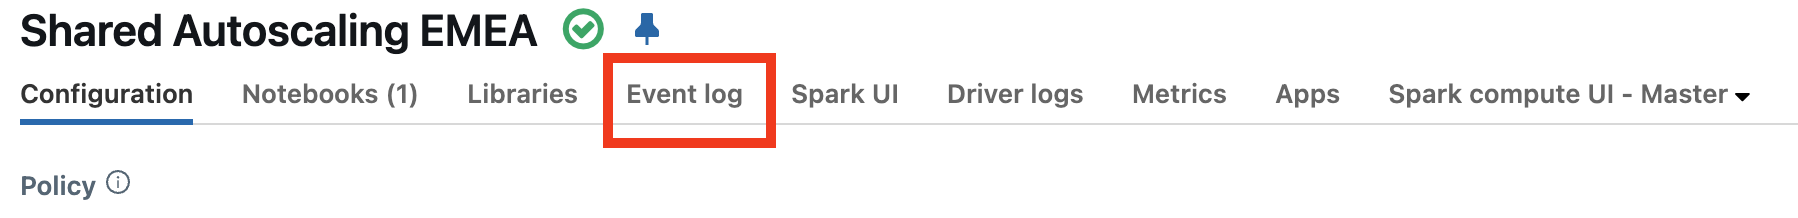
Recherchez les événements qui expliquent la perte des exécuteurs. Par exemple, vous pouvez voir des messages indiquant que le cluster est en cours de redimensionnement ou que des instances ponctuelles sont perdues.
- Si vous utilisez des instances ponctuelles, consultez Perte d’instances ponctuelles.
- Si votre compute a été redimensionné avec le dimensionnement automatique, c'est normal et il ne s'agit pas d'une erreur. Voir Activer le dimensionnement automatique.
Si vous ne voyez aucune information dans le Log des événements, revenez au Spark UI et cliquez sur le tab :
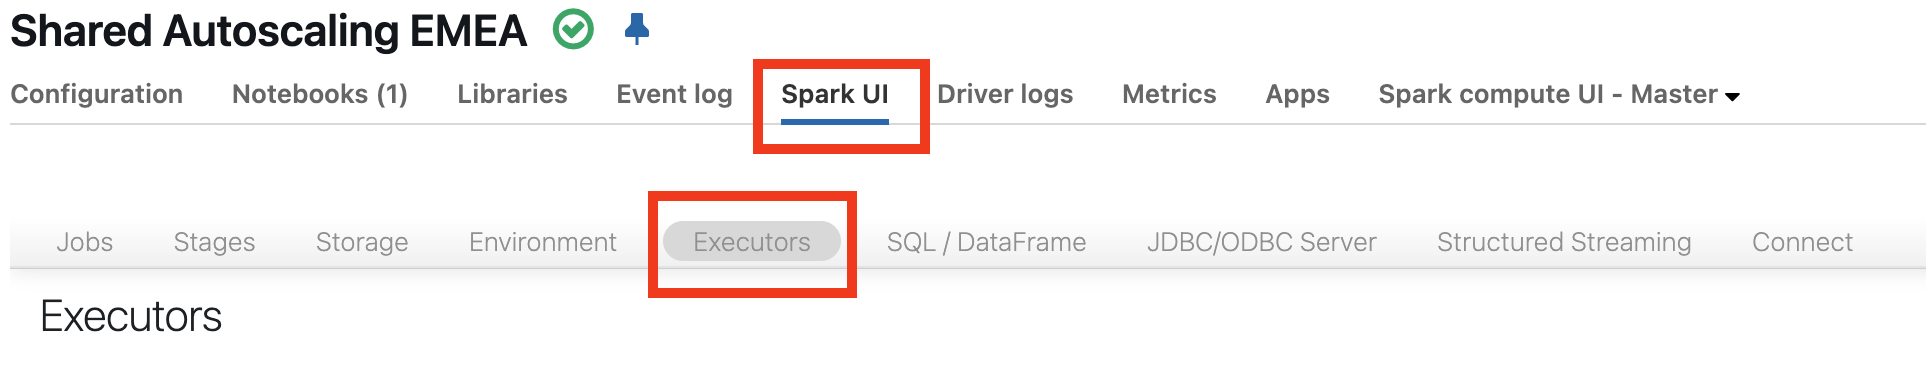
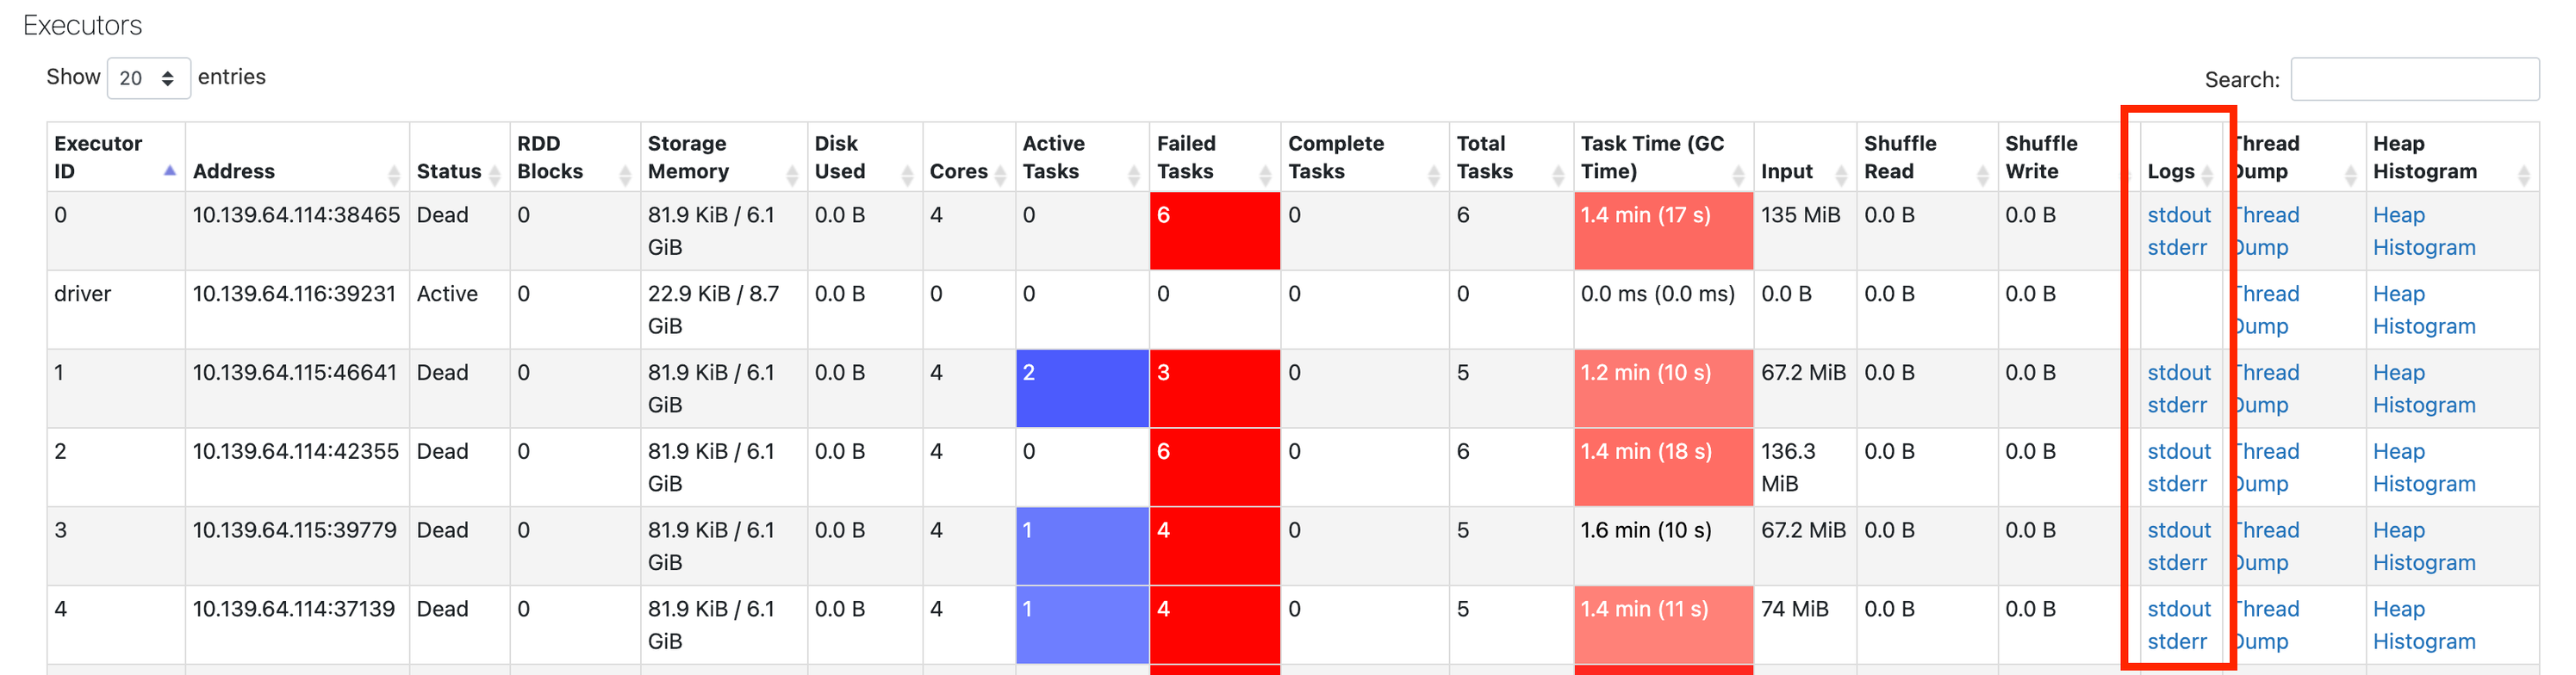
Vous pouvez obtenir les logs des exécuteurs ayant échoué :
Étape suivante
Si vous êtes arrivé jusque-là, l’explication la plus probable est un problème de mémoire. L'étape suivante consiste à examiner les problèmes de mémoire. Voir problèmes de mémoire Spark.