Identifier une lecture coûteuse dans le SQL DAG
Lorsqu'une étape passe la majeure partie de son temps à lire des données, identifiez la table ou les fichiers qu'elle lit avant d'optimiser la lecture. La page d'étape montre combien de données une étape lit, mais pas d'où proviennent ces données. Le DAG SQL relie l'étape au scan qui lit les données.
Utilisez cette page lorsque l’étape la plus longue est à entrée élevée. Si l’entrée de l’étape n’est pas élevée, vérifiez sa sortie et son mélange dans E/S élevées de l’étape Spark et utilisez les autres pages de ce guide pour diagnostiquer le problème. Voir Diagnostiquer les problèmes de coûts et de performance à l’aide de Spark UI.
Accéder au DAG
Pour trouver l’analyse qui lit les données :
-
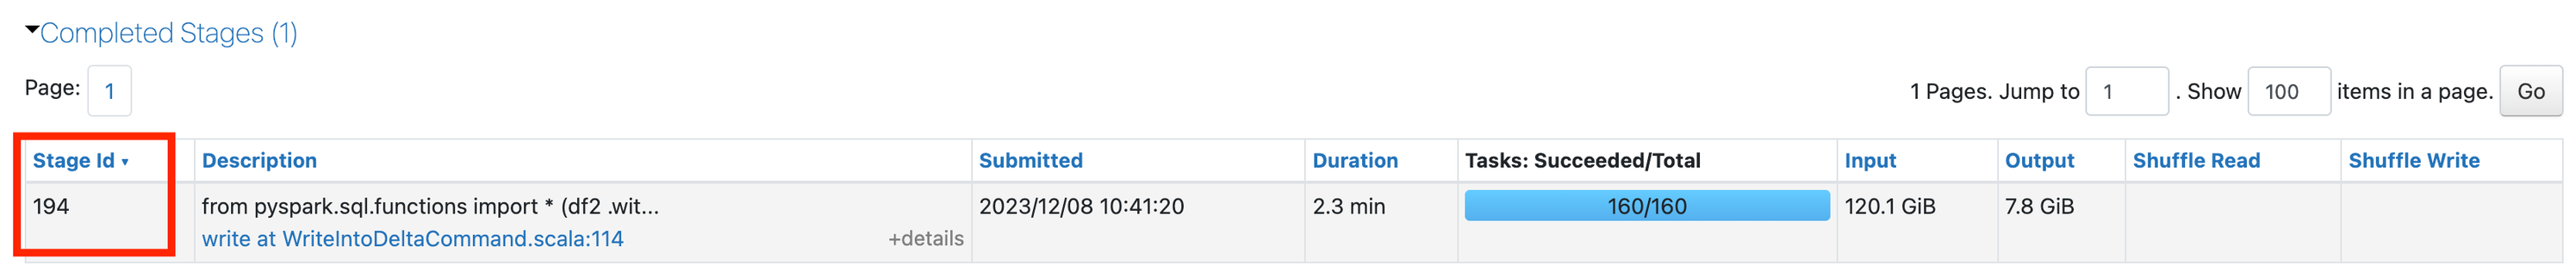
Sur la page de job, notez l’ID de l’étape qui effectue la lecture. Dans cet exemple, l’ID d’étape est 194 :
-
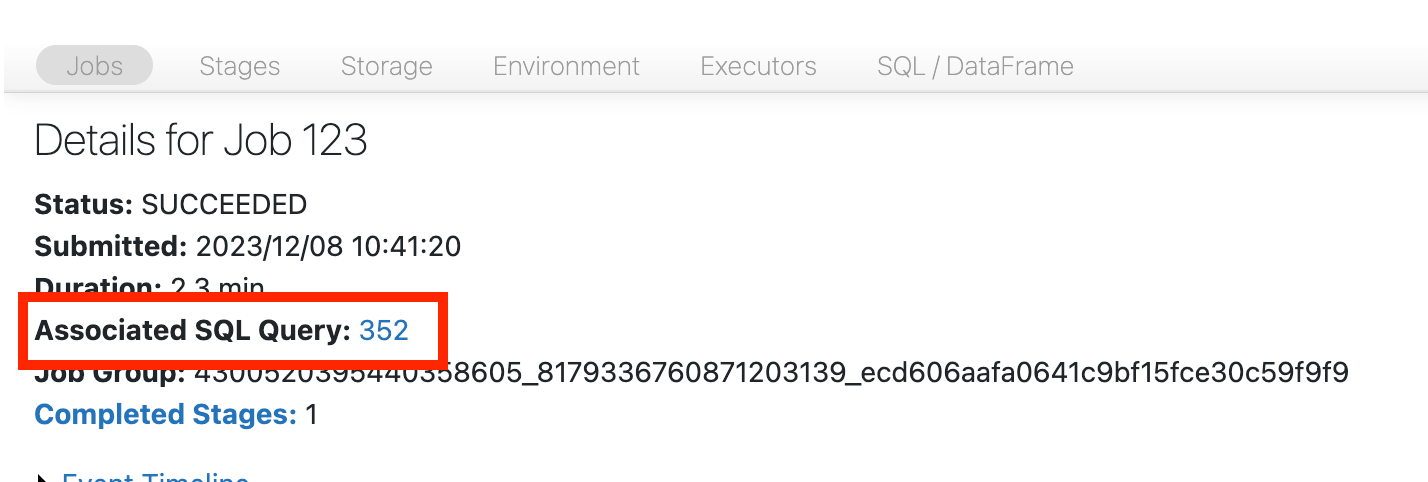
Faites défiler jusqu’en haut de la page du job et cliquez sur Associated SQL Query :
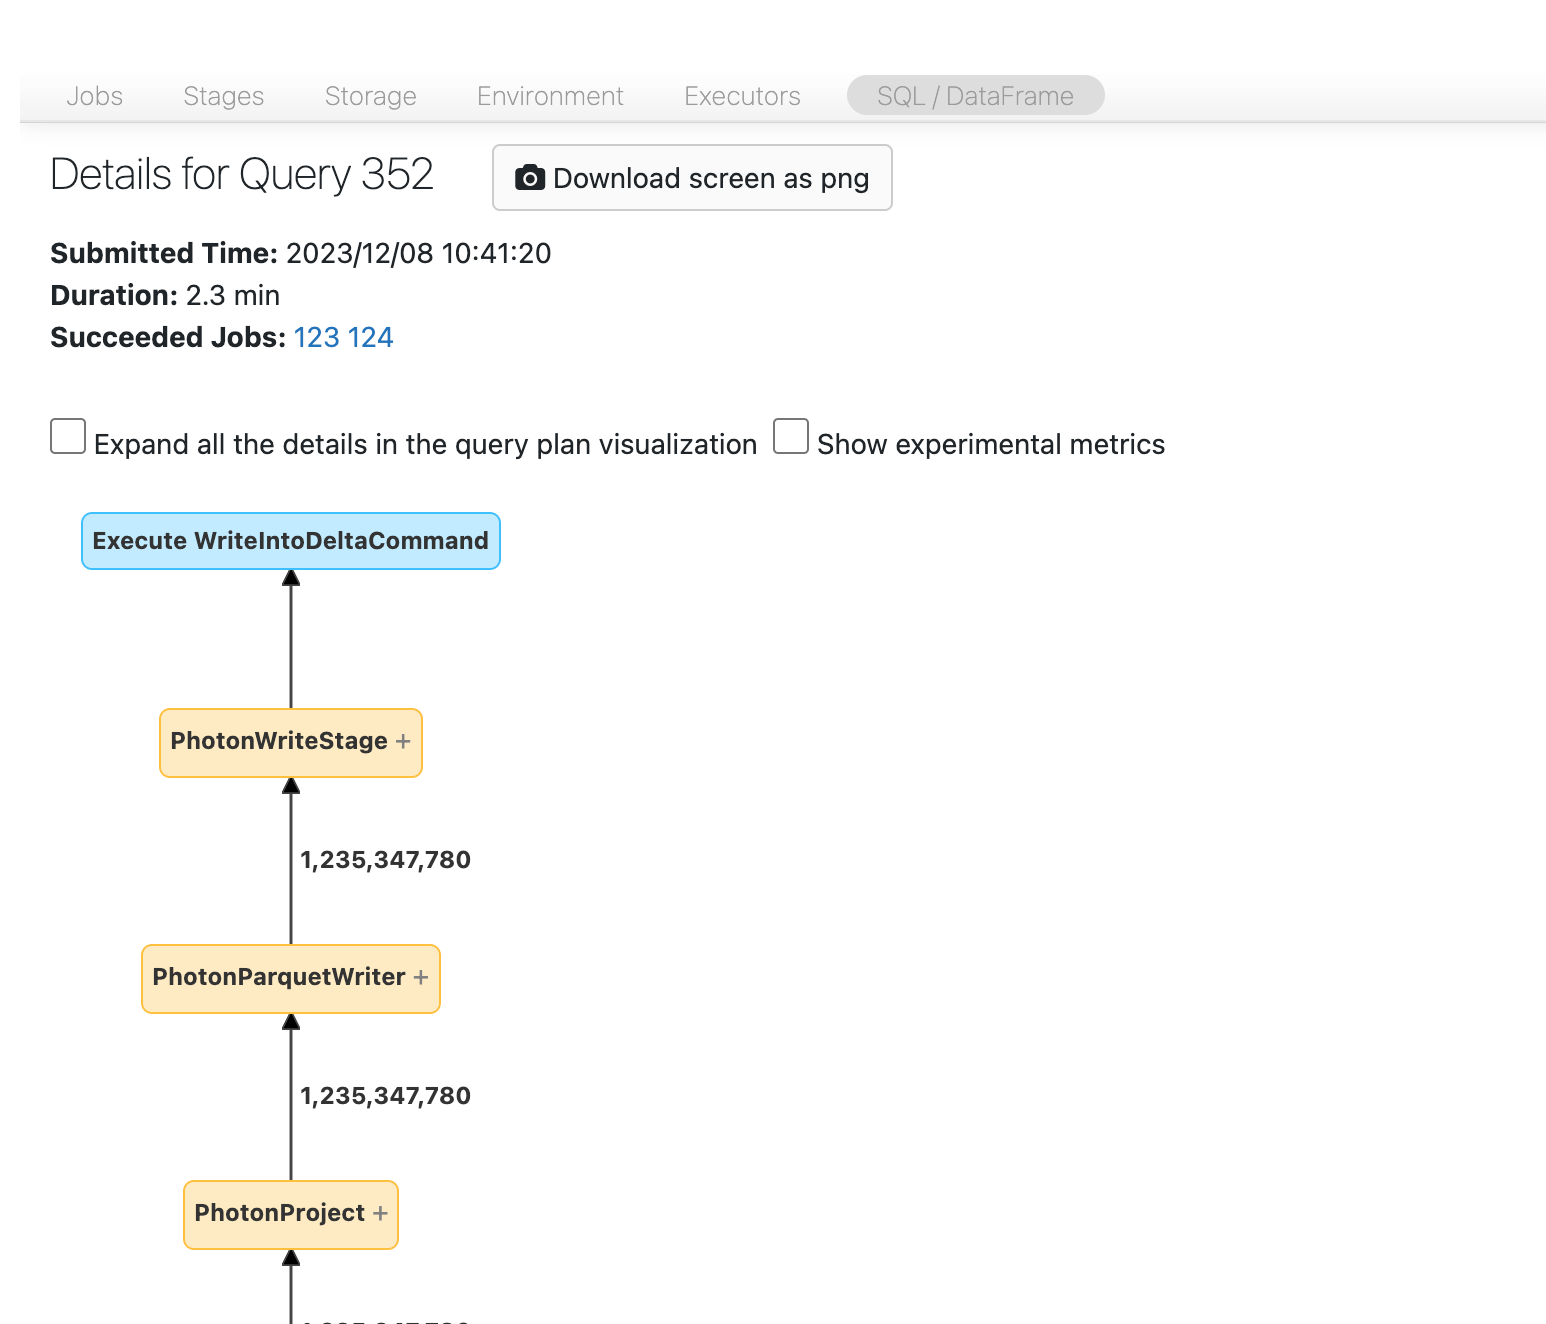
Le DAG SQL s'affiche. Si ce n'est pas le cas, faites défiler vers le bas pour la trouver :
-
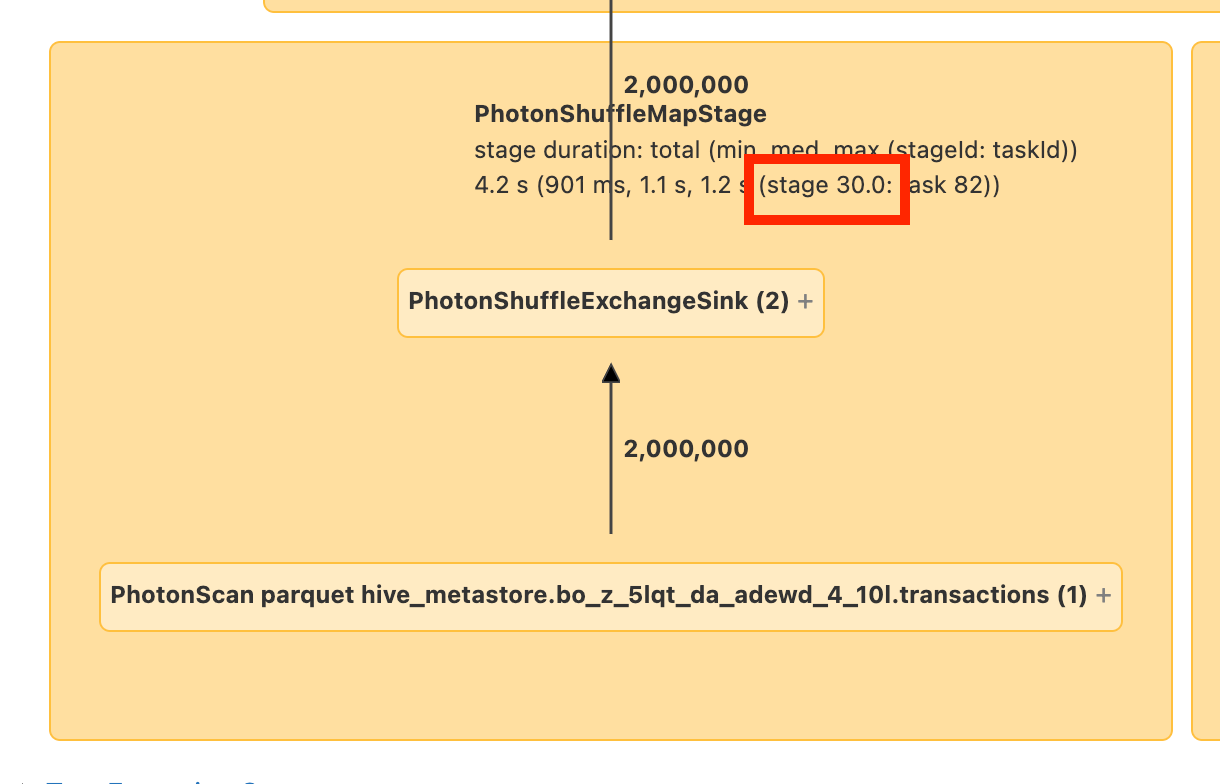
Recherchez l’étape dans le DAG. Si la source des données n’est pas claire dans le DAG, recherchez le nœud étiqueté avec l’ID d’étape que vous avez noté :
-
Recherchez le nœud Scan pour cette étape. Dans cet exemple, l’étape lit une table nommée
transactions: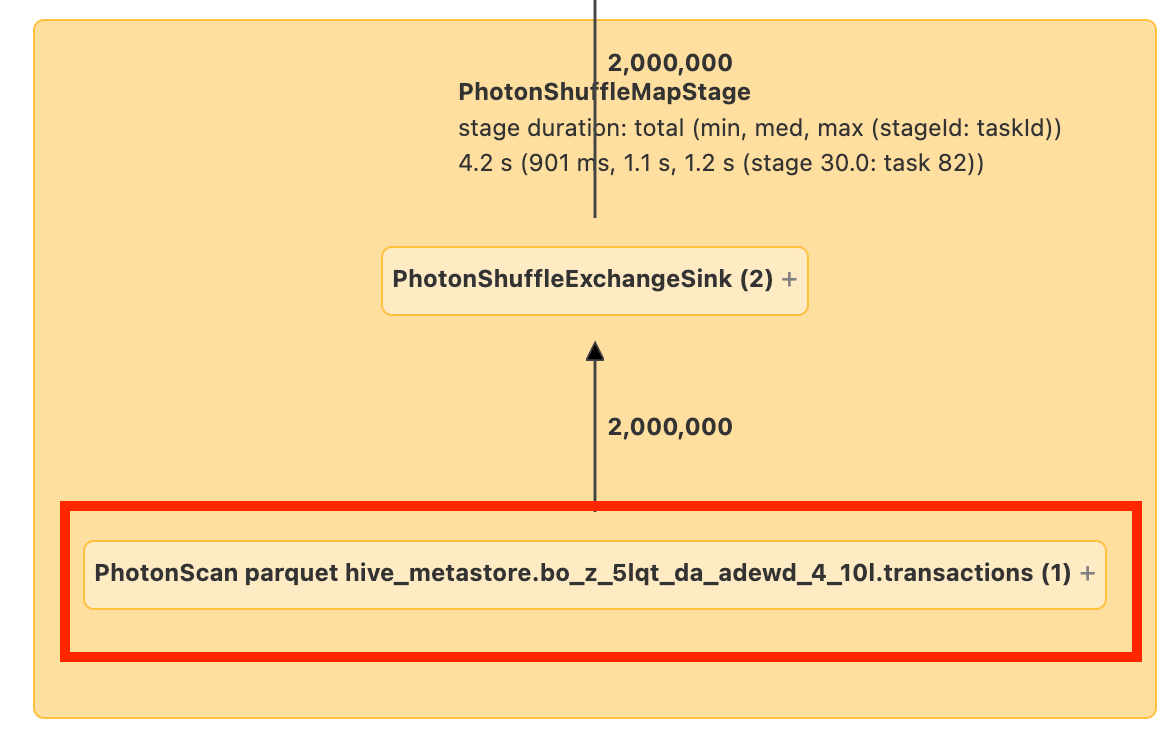
Pour voir l'emplacement des données lues par le nœud, cliquez ou survolez le nœud.
Étape suivante
Une fois que vous avez identifié les données lues par l’étape, choisissez une approche pour réduire ou accélérer la lecture. Voir Entrée élevée.