Serverlessコンピュートの管理
このページでは、Serverlessコンピュートへのアクセスを管理する方法と、Serverlessのレート制限を実装する方法について説明します。Workspace 管理者は、組み込みの Serverless コンピュートオブジェクトを使用して Serverless コンピュートを管理します。Serverlessコンピュートオブジェクトは、Serverlessワークロードの権限境界を定義するリソースタイプです。ワークスペースには、defaultのコンピュートオブジェクトが自動的に2つ付与されます:
- デフォルトのインタラクティブ コンピュート : ノートブックおよびDatabricks Connectへのアクセスを管理します。
- Default Automated コンピュート : ジョブおよびLakeFlow上のSpark宣言型パイプラインへのアクセスを管理します。
By default、すべてのワークスペースユーザーが両方のオブジェクトに対して 使用可能 権限を持っているため、既存のワークロードは変更なしで実行され続けます。ワークスペース管理者は、いずれかのオブジェクトからユーザーまたはグループを削除してアクセスを制限できます。アクセス権を失ったユーザーには、製品インターフェース上で Serverless コンピュートオプションが利用不可として表示されます。
Serverless コンピュートへのアクセスを管理する
Serverlessコンピュートへのアクセス権を制御するために、ワークスペース管理者は「 Default Interactive Compute 」および「 Default Automated Compute 」オブジェクトの権限を編集できます。ワークスペース管理者にはdefaultで「 管理可能 」権限が付与されていますが、任意のユーザーにその権限を付与することができます。これらのデフォルトのコンピュートオブジェクトは、名前の変更や削除ができません。

各 Serverless コンピュートオブジェクトは、2 つの権限レベルをサポートしています:
権限 | 次のことができます: |
|---|---|
Can Use | このコンピュートでワークロードを実行する |
Can Manage | このコンピュート上でワークロードを実行し、コンピュートの権限を編集します |
権限APIを使用して、Serverlessコンピュートオブジェクトの権限をプログラムで管理することもできます。Serverless コンピュートオブジェクトは serverless-compute オブジェクトタイプを使用し、各オブジェクトはIDによって識別されます。
Serverlessインタラクティブへのアクセスを制限する
ノートブックおよびDatabricks Connectでserverlessを使用できるユーザーを制限するには、次の手順を実行します。
- ワークスペースのサイドバーで「 コンピュート 」をクリックします。
- Serverless tab で、
 Default Interactive コンピュート の横にあるケバブメニュー をクリックし、[Edit permissions] をクリックします。
- All Users グループ、またはすべてのワークスペースユーザーを含むグループを削除します。
- 承認する特定のユーザー、グループ、またはService Principalのみを追加してください。
ユーザーのインタラクティブなServerless権限を取り消すと、Serverlessに既にアタッチされているノートブックは、ユーザーがセルを実行したときに接続に失敗し、ユーザーはノートブックのコンピュートピッカーで Serverless オプションを利用できなくなります。Databricks Connect の実行を試みると、ユーザーがserverlessにアクセスできないことを示すエラーが発生し、接続要求は失敗します。
Serverless ジョブおよびパイプラインへのアクセスを制限する
ジョブおよびパイプラインでServerlessを使用できるユーザーを制限するには:
- ワークスペースのサイドバーで「 コンピュート 」をクリックします。
- In the Serverless tab, click the kebab menu next to Default Automated コンピュート , then click Edit permissions .
- All Users グループ、またはすべてのワークスペースユーザーを含むグループを削除します。
- 承認する特定のユーザー、グループ、またはService Principalのみを追加してください。
ユーザーの default コンピュート へのアクセスを取り消すと、そのユーザーとして実行され、そのコンピュートオブジェクトを使用するジョブおよびパイプラインは失敗します。カスタム自動コンピュートオブジェクトを選択するワークロードでは、選択したオブジェクトに対する権限が必要です。
ユーザーの Default Automated コンピュート へのアクセス権を取り消す前に、影響を受けるユーザーが所有するジョブとパイプラインを監査してください。次のクエリーは、特定のユーザーの最近のServerlessワークロードを特定します:
SELECT *
FROM system.billing.usage
WHERE usage_date >= date_add(now(), -30)
  AND billing_origin_product IN ('JOBS', 'DLT')
  AND identity_metadata.run_as = '<user_email>';
usage_metadata 列を確認して、ジョブIDやパイプラインIDなどの影響を受けるリソースを確認してください。
Serverless usageの監査
サーバレスの請求レコードには、usage_metadata 内に serverless_compute_id フィールドが含まれています。これを使用して、ワークロードがどのコンピュートオブジェクト上で実行されたかを追跡します:
SELECT
  usage_metadata.serverless_compute_id,
  identity_metadata.run_as,
  SUM(usage_quantity) AS total_dbus
FROM system.billing.usage
WHERE billing_origin_product IN ('JOBS', 'DLT', 'INTERACTIVE')
  AND usage_metadata.serverless_compute_id IS NOT NULL
  AND usage_date >= date_add(now(), -30)
GROUP BY 1, 2
ORDER BY 3 DESC;
サポートされている Serverless コンピュートのアクセス制御機能
以下の機能は、Serverlessコンピュートのアクセス制御と統合されています。
インタラクティブ(default インタラクティブコンピュート)
- ノートブックとAIランタイムノートブック
- Databricks Connect
自動 (default の自動コンピュート)
- ジョブと AI ランタイム ジョブ
- Lakeflow上のSpark宣言型パイプライン
Unsupported Serverless コンピュートのアクセス制御機能
以下の機能は、Serverless コンピュートのアクセス制御と統合されていません:
- Databricks SQL(DBSQL)
- バッチ推論 (
ai_query()) - モデルサービング
- 基盤モデル API プロビジョニング throughput Endpoint
- Lakebase
- Databricks Apps
- エージェント評価と合成データ
- AI Search インデックス作成
- 予測最適化
- データプロファイリング
- 専用コンピュートでのきめ細かなアクセス制御を参照してください。専用コンピュートへのアクセス権によって、ユーザーがきめ細かなアクセス制御を使用できるかどうかが決まります。
ここに記載されていない機能については、Databricks アカウント チームにそのステータスをお問い合わせください。
Serverless アクセス制御の制限
サービスの中断が発生した場合、アクセスチェックが「フェイルオープン」状態になり、本来アクセスを拒否されるはずのユーザーがServerlessワークロードを開始できてしまう可能性があります。この機能は、Serverlessコンピュートへのアクセスを管理しやすくすることを目的としています。最終的な請求額に対する絶対的な支出上限を保証するために、この機能を使用しないでください。Databricks は、そのようなイベント中に実行されたワークロードによって発生したコストについては責任を負いません。
- default コンピュートオブジェクトの名前変更や削除はできません。
- defaultの自動コンピュートを使用するジョブとパイプラインには、そのオブジェクトに対する権限が必要です。ユーザーのアクセス権を削除する前に、アクティブなワークロードを確認してください。
- バックグラウンドコンピュート(システムが開始したジョブ)は、Serverlessコンピュートのアクセス制御の対象外です。
Serverlessコンピュートのレート制限を設定する
ベータ版
Serverlessレート制限は ベータ版 です。ワークスペース管理者は、 Serverlessコンピュートレート制限 設定を使用して、プレビュー ページからレート制限を有効にできます。
レート制限は、自動化されたワークロードのSparkエグゼキューターがどの程度オートスケールできるかを制御します。ワークスペース管理者は、カスタム自動化コンピュートオブジェクトを作成し、それぞれにサイズを割り当てることができます。ワークロードがコンピュートオブジェクトを使用する場合、そのサイズによってSparkエグゼキューターのオートスケール容量の上限が設定されます。
レート制限は、自動化されたワークロード(ジョブとLakeFlow Pipelines)にのみ適用されます。対話型ワークロード(ノートブックとDatabricks Connect)はレート制限されません。
サイズは、SparkエグゼキューターのDatabricksユニット(DBU)の概算消費率に対応します。レート制限では、ワークロード全体のコストや最終的な請求額に上限は設定されません。レート制限では、ドライバー、REPL仮想マシン、GPU、マテリアライズドビューおよびストリーミングテーブルの更新にかかるコストに上限を設けません。
コンピュートオブジェクトを使用する各ワークロードに対して、レート制限は個別に適用されます。同じコンピュートオブジェクトを使用する2つのジョブには、それぞれ上限全体が適用されます。1つのジョブ内では、タスクが別々のクラスターで実行される場合でも、そのジョブのServerlessタスク間で上限が共有されます。コンピュートオブジェクトは、それを使用するすべてのワークロード全体にわたる合計上限を設けません。
レート制限の要件
- Serverlessコンピュートオブジェクトを作成するには、ワークスペース管理者であるか、無制限のクラスター作成権限を持っている必要があります。
- カスタムコンピュートオブジェクトのサイズまたは権限を編集するには、そのオブジェクトに対する「管理可能」権限を持っている必要があります。
- コンピュート オブジェクトでワークロードをランするには、そのオブジェクトに対する「使用可能」または「管理可能」権限が必要です。
レート制限付きのServerlessコンピュートを作成する
- ワークスペースのサイドバーで「 コンピュート 」をクリックします。
- Serverless tabで、 [Create serverless コンピュート] をクリックします。
- 名前を入力してください。
- Size には、適用するレート制限を Small から 2X-Large の間で選択します。ワークスペースの Default の上限を使用するには、Default に設定したままにします。
- 作成 をクリックします。
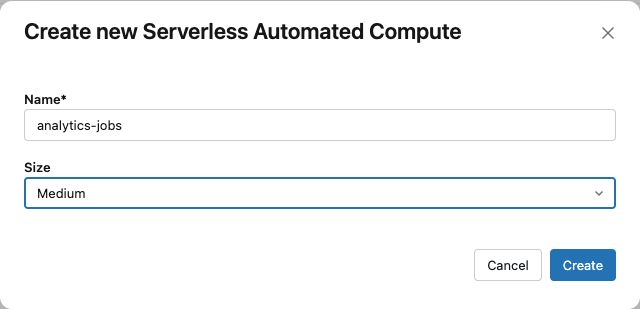
新しいコンピュートオブジェクトが Serverless tabに表示され、タイプは Automated になります。それらのワークロードをランする前にユーザーにアクセス権を付与してください。defaultコンピュートオブジェクトのサイズは編集できません。
レート制限付きコンピュートへのアクセスを許可する
- Serverless tabで、カスタムコンピュートオブジェクトを開きます。
- [ アクション ] をクリックし、次に [ 権限の編集 ] をクリックします。
- アクセスが必要なユーザー、グループ、またはService Principalを追加します。
- ワークロードをランするには 「使用可能」 を、サイズと権限を編集するには 「管理可能」 を付与します。
- 保存 をクリックします。
レート制限の変更
- Serverless tabで、カスタムコンピュートオブジェクトを開きます。
- [ 編集 ] をクリックします。
- サイズ でサイズを選択します。
- 保存 をクリックします。
レート制限サイズ
以下のサイズは、概算のSparkエグゼキューター消費量にマップされます:
サイズ | 概算のエグゼキューター消費率 |
|---|---|
S | ~60 DBU/時間 |
M | 1時間あたり約120 DBU |
Large | ~240 DBU/時間 |
X-Large | ~480 DBU/時間 |
2X-Large | ~960 DBU/時間 |
これらの値は推定値です。Serverlessインフラストラクチャの変動や、レート制限の対象外となるコストがあるため、実際の使用量はこれらの値を超える場合があります。
default を選択すると、Serverless自動ワークロードに対するワークスペースの既存の最大オートスケール容量が使用されます。defaultは、ワークスペースのティアおよびワークスペース固有の制限によって異なります。
レート制限のあるコンピュートでワークロードを実行する
コンピュートオブジェクトに対する Can Use 権限を持つユーザーは、ジョブまたはパイプラインを構成する際にそのオブジェクトを選択できます。その後、ワークロードはコンピュートのレート制限下で実行されます。ワークロードでコンピュートオブジェクトが指定されていない場合、ワークスペースの デフォルトの自動コンピュート にフォールバックします。ユーザーがそのdefaultへのアクセス権を持っていない場合、ワークロードの実行は失敗します。
- ジョブ :ジョブの コンピュート 設定で、 コンピュートポリシー を使用して自動Serverlessコンピュートオブジェクトを選択します。セレクターのラベルを Serverless コンピュート にすることもできます。リストには、ジョブのラン・アズ・アイデンティティが使用できるコンピュートオブジェクトが表示されます。Jobs APIを使用してジョブを設定するには、Jobs APIでレート制限付きコンピュートを使用するを参照してください。
- パイプライン :Lakeflow エディターでパイプラインのServerlessコンピュートとして自動コンピュートオブジェクトを選択します。
レート制限によってパイプラインが制限されると、パイプラインのクエリー履歴または Lakeflow UI で影響を確認できます。
Jobs APIでレート制限付きコンピュートを使用する
Jobs APIを使用してレート制限付きコンピュート・オブジェクトでジョブをランするには、コンピュート・オブジェクトのIDにserverless_compute.policy_idを設定するジョブ・クラスターを定義します。これは、ジョブのコンピュート・ポリシーとして選択されたものと同じ自動Serverless・コンピュート・オブジェクトです。次に、ジョブのすべてのServerless・タスクでjob_cluster_keyを設定して、そのジョブ・クラスターを参照します。IDをコピーするには、 [Serverless] tabで、コンピュート・オブジェクトのケバブメニューをクリックし、 [コンピュートIDのコピー] をクリックします。
{
  "job_clusters": [
    {
      "job_cluster_key": "rate_limited",
      "serverless_compute": { "policy_id": "<compute-id>" }
    }
  ],
  "tasks": [
    {
      "task_key": "ingest",
      "job_cluster_key": "rate_limited",
      "notebook_task": { "notebook_path": "/Workspace/Jobs/ingest" }
    },
    {
      "task_key": "transform",
      "job_cluster_key": "rate_limited",
      "notebook_task": { "notebook_path": "/Workspace/Jobs/transform" }
    }
  ]
}
ジョブは、 serverless_compute を設定するジョブクラスターを最大1つ定義できます。同じ構成は、ジョブを作成、更新、Reset、または送信するとき、および宣言型自動化バンドル(Declarative Automation Bundles)でジョブをデプロイするときにも適用されます。完全なリクエストスキーマについては、 REST API リファレンスの ジョブの新規作成 を参照してください。
job_clusters[].serverless_compute_idフィールドは非推奨です。代わりに serverless_compute.policy_id を使用してください。
レート制限の制限事項
- レート制限は、Sparkエグゼキューターのオートスケールのみを制限します。ドライバー、REPL VM、GPU、マテリアライズドビューやストリーミングテーブルの更新など、その他のコストコンポーネントには上限がありません。
- 各サイズの1時間あたりのDBU上限は推定値です。適用される制限のわずかな変動や、Serverlessインフラストラクチャに内在する変動性により、実際の使用量がターゲットを超える場合があります。
- 物理クラスターサイズが 256 エグゼキューターに制限されているため、2X-Large サイズのワークロードは期待を下回るパフォーマンスになる可能性があります。2つ以上の 2X-Large ワークロードが同じランタイムクラスター上でスケジュールされている場合、それぞれが期待されるパフォーマンスを下回る可能性があります。
- 課金の実装詳細により、同じワークロードであっても、レート制限のサイズが異なると DBU の使用量が異なる場合があります。
- defaultのコンピュートオブジェクトにはレート制限を設定できません。