クラシック コンピュートからサーバレス コンピュートへの移行
ワークロードをクラシック コンピュートからサーバレス コンピュートに移行します。 サーバレス コンピュートは、プロビジョニング、スケーリング、ランタイム アップグレード、最適化を自動的に処理します。
ほとんどの従来型ワークロードは、最小限のコード変更、あるいはコード変更なしで移行できます。このページでは、そうしたワークロードに焦点を当てています。df.cacheなどの一部の機能は、 レスではまだサポートされていませんが、利用可能になった際にはコードの変更は必要ありません。 R またはScalaノートブックに依存する特定のワークロードはクラシック コンピュートを必要とするため、サーバーレスに移行できません。 現在の制限の完全なリストについては、 「サーバレス コンピュートの制限」を参照してください。
移行エージェントを使用して移行する
ベータ版
この機能はベータ版です。ワークスペース管理者は、 [Compute Agent] プレビューにオプトインすることで、 [Previews] ページから有効にできます。詳しくは、Databricksのプレビューの管理を参照してください。
移行エージェントを使用して、単一のノートブックまたはジョブをServerless コンピュートに移行できます。エージェントはワークロードの環境、ライブラリ、Spark構成、タグ、およびコードを確認し、それぞれの変更を個別の提案として提示し、承認または拒否できるようにします。承認された変更はその場で適用され、ロールバックすることができます。
エージェントがレビューおよび変更する内容
領域 | エージェントの動作 |
|---|---|
環境とライブラリ |
|
環境変数 | クラスターの環境変数をServerlessの同等の変数に変換し、ワークスペースシークレットの参照を保持しながら、プラットフォーム管理の値を省略します。 |
データとストレージへのアクセス | ローカルディスク、 |
Spark 構成 | 各 Spark 設定を分類し、安全に削除できる設定をコメントアウトし、Serverless でサポートされていない設定を検出して削除します。クラスターアタッチ型とノートブック内の両方の設定を対象とします。 |
Workloadコード | Serverlessでサポートされていないコードを互換性のある形式に書き換えます(RDD 操作を DataFrame 操作に書き換えるなど)。また、Serverlessでの ANSI モードの SQL 動作に合わせてコードを調整します。 |
タグ | Translates custom Cluster Tag, such as a cost-center タグ, to their Serverless equivalents. |
パフォーマンスモード | クラスターの構成に基づいてパフォーマンスモードを提案します。パフォーマンスモードの選択をご覧ください。 |
要件
-
完全な移行を行うには、ワークスペース管理者アクセス権を持つことをお勧めします。これは、エージェントがターゲットワークロードだけでなく、ワークスペースレベルのグローバルinitスクリプトも検査するためです。ワークロードに対する
CAN MANAGE権限がある場合は移行できる可能性がありますが、管理者権限がない場合、ライブラリ、環境設定、またはタグが欠落する可能性があります。 -
エージェントへのアクセス権があることを確認します。Genie Codeに「
/compute」と入力します。オートコンプリート メニューに/computeが表示されます。表示されない場合は、ワークスペース管理者がワークスペースでプレビューを有効にする必要があります。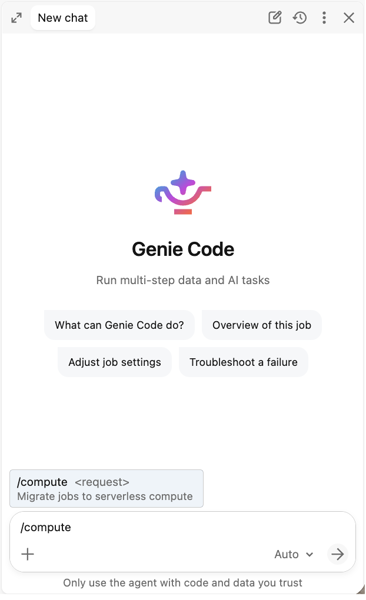
ノートブックの移行
- 移行するノートブックを開きます。
- Genie Code を開き、
/コマンドパレットから/compute migrate to serverlessをランします。 - エージェントの検出結果を確認します。エージェントは、ノートブックの環境、ライブラリ、コードをスキャンし、ライブラリのインストール環境仕様への移行や、Serverlessで実行するためのコードセルの書き換えなど、対応が必要な項目ごとに変更を提案します。
- 提案された各変更を承認または拒否します。
- 受け入れた変更を適用します。それらはインプレースでノートブックに書き込まれます。
- ノートブックを Serverless にアタッチし、実行して期待どおりに動作することを確認します。移行されたワークロードの検証を参照してください。
ジョブの移行
- 移行するジョブを開きます。
- Genie Code を開き、
/コマンドパレットから/compute migrate to serverlessをランします。 - エージェントはジョブのクローンを作成し、そのクローンを作成したジョブを Serverless に移行しようと試みます。
- エージェントの検出結果を確認します。マルチタスクジョブの場合、エージェントはすべてのタスクとそのタスクごとのクラスター構成を列挙し、ジョブのスケジュールを維持しながらそれぞれに対する変更を提案します。
- 移行対象(環境とライブラリ、Spark設定、変更が必要なワークロードコードなど)全体の提案された変更ごとに、承認または拒否を行います。
- 承認した変更を適用します。ジョブのコンピュートがServerlessに切り替わります。
- serverlessでジョブを実行し、結果を確認します。移行されたワークロードの検証を参照してください。
- オプションとして、最後のステップとして、エージェントは移行されたクローンを昇格させます。クローンの構成とノートブックを元のジョブに上書きしてコピーし(同じジョブ ID、スケジュール、アクセス許可を保持)、その後クローンを削除します。昇格をスキップして両方のジョブを保持する場合は、実行していない方のジョブのスケジュールを停止してください。そうしないと、同じTriggerが両方で実行され、書き込みが重複したりその他の副作用が発生したりする可能性があります。
移行されたワークロードを検証する
エージェントは変更を提案して適用しますが、ワークロードの実行やその出力の検証は行いません。移行したワークロードは必ずServerlessで実行し、依存する前に結果を確認してください。特に、本番運用テーブルに書き込むワークロードの場合は注意してください。エージェントが不適切な変更を提案した場合は、それを拒否し、エージェントを改善できるようにフィードバックを送信してください。製品フィードバックの送信を参照してください。
移行したワークロードの検証中は、パフォーマンス最適化モードで実行してください。標準モードよりもすばやく起動するため、結果を確認しながらより迅速にフィードバックを得ることができます。本番運用で実行する前に、ワークロードに最も適したモードに切り替えてください。パフォーマンスモードの選択をご覧ください。
エージェントが安全に移行できない項目を発見すると、ブロッカーとして報告し、defaultで停止します。互換性や依存関係のブロッカーを回避して続行するように明示的に指示することは可能ですが、そうすると、それらの依存関係、コスト配分、またはランタイムの動作が引き継がれず、ワークロードがServerlessで失敗するリスクを受け入れることになります。
移行の変更をロールバックする
エージェントが適用する変更は元に戻すことができます。
ノートブックの場合は、開いて移行直前のリビジョンを復元します。Databricks ノートブックのバージョン履歴を参照してください。
ジョブについて、移行されたクローンを昇格しなかった場合、元のジョブは変更されていません。従来どおり実行し、クローンを削除してください。クローンを昇格した場合は、エージェントが変更を加える前に作成したバックアップから復元します。
- ワークスペースのホームにあるバックアップフォルダを開きます:
/Workspace/Users/<your-username>/serverless-migration/backups/job-<job-id>/<timestamp>/。エージェントは移行中にこのパスを示しました。If there are several Timestamp, pick the one from just before the migration. - 移行前のジョブ設定が保存されている
job.yamlを開き、ジョブの設定を指定した内容で上書きするPOST /api/2.2/jobs/resetリクエストを使用して、同じジョブにその設定を再度適用します。UI のジョブの JSON 定義にそれらを貼り付けることもできます。これにより、ジョブがクラシック コンピュートに戻ります。 - バックアップされた各ファイルと、その元のパスが一覧表示されている
mapping.yamlを開きます。各バックアップファイルを元のパスにコピーし直して、コードの書き換えを元に戻します。 - ジョブを実行して、移行前と同様に動作することを確認します。
移行によってこのバックアップが削除されることはありません。Gitソース、SQL、dbtタスクなど、エージェントが変更しなかったタスクは job.yaml に記録されますが、そのファイルはバックアップにコピーされません。必要に応じて、信頼できる情報源からそれらを復元してください。
既知の制限事項
-
ブロックとして報告されるのは、カスタムイメージ、機械学習 ランタイム バリアント、Databricks Runtime 13 未満のバージョン、インスタンスプロファイル、serverlessで安全に無視できない Spark 構成、および eggs、JAR、Maven ライブラリなどの依存関係です。ブロッカーとは、そのアイテムを移行せずにエージェントが停止することを意味します。自分で解決して移行を再度実行するか、とにかく移行するようにエージェントに指示することができます。後者の場合、そのアイテムは未解決のままとなり、Serverlessでワークロードが失敗する原因になる可能性があります。
-
エージェントは、ワークスペースファイルまたは Unity Catalog ボリュームに保存されている init スクリプトを読み取ります。S3 または DBFS に保存されている init スクリプトは読み取ることができないため、ブロッカーとして報告されます。
-
エージェントは、すべてのクラシックコンピュート属性を検査するわけではありません。クラスターの Logs 配信と SSH キーはモデル化されず、ワークロードコードから多くの DBFS マウントの依存関係が検出されますが、すべてのマウントが列挙または解決されるわけではありません。
-
キャッシュおよびチェックポイントAPIs、グローバル一時ビュー、DBFSマウント管理呼び出し、およびScalaまたはRコードは、defaultでハードブロッカーになります。エージェントに続行するよう指示することはできますが、未解決の機能は変更されないままであり、Serverlessで失敗する可能性があります。
-
移行可能なタスクが10個を超えるジョブは、現在移行できません。
-
エージェントは、一度に1つのワークロードを移行します。フリート全体のディスカバリー、一括移行、または管理者承認ワークフローはありません。
-
エージェントは変更を提案し、承認された変更を適用しますが、ワークロードの実行や出力の正確性の検証は行いません。本番運用データの信頼性を確認する前に、移行されたワークロードを検証します。
-
ワークロードの信頼できる情報源(ソースオブツリー)が Databricks アセットバンドルまたは Git フォルダーである場合、エージェントはインプレースでワークスペースオブジェクトに変更を適用します。後からのデプロイで移行が上書きされないように、それらの変更をバンドルまたはリポジトリと調整します。
Serverless に手動で移行する
ワークロードをクラシック コンピュートからサーバレス コンピュートに移行するには、次のステップに従います。
- 前提条件を確認してください :ワークスペース、ネットワーク、クラウドストレージへのアクセスが要件を満たしていることを確認してください。始める前にご覧ください。
- コードの更新 :必要なコードおよび設定の変更を行います。コードの更新を参照してください。
- ワークロードをテストする :切り替え前に互換性と正確性を検証する。ワークロードのテストを参照してください。
- パフォーマンスモードを選択してください :ワークロードの要件に最適なパフォーマンスモードを選択してください。「パフォーマンスモードの選択」を参照してください。
- 段階的に移行する :展開 新規かつリスクの低いワークロードから始めて、段階的に展開します。 段階的な移行を参照してください。
- コストの監視 : サーバレスDBU消費を追跡し、アラートを設定します。 監視コストを参照してください。
始める前に
移行を開始する前に、ワークスペース内の既存の設定をいくつか更新する必要がある場合があります。
前提条件 | 操作 | 詳細 |
|---|---|---|
ワークスペースがUnity Catalogに対して有効になっています | 必要に応じてHive metastoreから移行する | |
ネットワーク設定済み | VPCピアリングをNCC、プライベートリンク、またはファイアウォールルールに置き換える | |
クラウドストレージへのアクセス | 従来のデータ アクセス パターンをUnity Catalog外部ロケーションに置き換える |
インスタンスを使用するDBFSマウントをUnity Catalog外部ロケーションに置き換えます。
コードを更新してください
以下のセクションでは、ワークロードを レスと互換性を持たせるために必要なコードと構成の変更を一覧表示します。
データアクセス
従来のデータアクセスパターンは、 ではサポートされていません。 コードを更新して、代わりにUnity Catalog使用するようにしてください。
クラシックなパターン | サーバレス交換 | 詳細 |
|---|---|---|
DBFSパス( | Unity Catalogボリューム | |
Hive metastoreテーブル | Unity Catalogテーブル(またはHMS Federation) | |
IAM最適 | Unity Catalog外部位置 | |
カスタムJDBC JAR | レイクハウスフェデレーション |
DBFSアクセスはサーバーレスで制限されています。 移行前に、 Unity Catalogボリュームへのすべてのdbfs:/パスを更新してください。 詳細については、 DBFSに保存されているファイルの移行」を参照してください。
例: DBFSパスとHive metastore参照を置き換える
# Classic
df = spark.read.csv("dbfs:/mnt/datalake/data.csv", header=True)
df.write.parquet("dbfs:/mnt/output/results")
df = spark.table("my_database.my_table")

# Serverless
df = spark.read.csv("/Volumes/main/sales/raw_data/data.csv", header=True)
df.write.parquet("/Volumes/main/analytics/output/results")
df = spark.table("main.my_database.my_table")  # three-level namespace
APIsとコード
特定のAPIsとコードパターンは、 レスではサポートされていません。 コードの更新が必要かどうかを確認するには、この表を参照してください。
クラシックなパターン | サーバレス交換 | 詳細 |
|---|---|---|
RDD APIs ( | DataFrame APIs | |
| キャッシュ呼び出しを削除する | |
|
| |
Hive変数( | SQL | |
サポートされていない Spark 設定 | サポートされていない設定を削除します。サーバーレスはほとんどの設定を自動調整します。 |
例: RDD操作をDataFramesに置き換える
from pyspark.sql import functions as F

# sc.parallelize + rdd.map
# Classic:  rdd = sc.parallelize([1, 2, 3]); rdd.map(lambda x: x * 2).collect()
df = spark.createDataFrame([(1,), (2,), (3,)], ["value"])
result = df.select((F.col("value") * 2).alias("value")).collect()

# rdd.flatMap
# Classic:  sc.parallelize(["hello world"]).flatMap(lambda l: l.split(" ")).collect()
df = spark.createDataFrame([("hello world",)], ["line"])
words = df.select(F.explode(F.split("line", " ")).alias("word")).collect()

# rdd.groupByKey
# Classic:  rdd.groupByKey().mapValues(list).collect()
df = spark.createDataFrame([("a", 1), ("b", 2), ("a", 3)], ["key", "value"])
grouped = df.groupBy("key").agg(F.collect_list("value").alias("values")).collect()

# rdd.mapPartitions → applyInPandas
import pandas as pd
def process_group(pdf: pd.DataFrame) -> pd.DataFrame:
    return pd.DataFrame({"total": [pdf["id"].sum()]})
result = (spark.range(100).repartition(4)
    .groupBy(F.spark_partition_id())
    .applyInPandas(process_group, schema="total long").collect())

# sc.textFile → spark.read.text
df = spark.read.text("/Volumes/catalog/schema/volume/file.txt")
例:SparkContextとキャッシングの置き換え
from pyspark.sql.functions import broadcast

# sc.broadcast → broadcast join
result = main_df.join(broadcast(lookup_df), "key")

# sc.accumulator → DataFrame aggregation
total = df.agg(F.sum("amount")).collect()[0][0]

# sqlContext.sql → spark.sql
result = spark.sql("SELECT * FROM main.db.table")

# df.cache() → remove caching calls
# Materialize expensive intermediate results to Delta as a workaround:
df = spark.read.parquet(path)
result = df.filter("status = 'active'")
expensive_df.write.format("delta").mode("overwrite").saveAsTable("main.scratch.temp")
result = spark.table("main.scratch.temp")
ライブラリと環境
基本環境を使用してワークスペース レベルでライブラリと環境を管理し、ノートブックのサーバレス環境を使用してノートブック レベルでライブラリと環境を管理できます。
クラシックなパターン | サーバレス交換 | 詳細 |
|---|---|---|
initスクリプト | サーバーレス環境 | |
クラスタースコープのライブラリ | ノートブックスコープまたは環境ライブラリ | |
Maven / JARライブラリ | JARタスクのサポート。ノートブック用のPyPI | |
Dockerコンテナ | ライブラリのニーズに対応したサーバーレス環境 |
再現可能な環境用のrequirements.txtのピン留めPythonパッケージ。 Pythonパッケージのバージョン指定を参照してください。
ストリーミング
ストリーミング ワークロードはサーバレスでサポートされていますが、特定のトリガーはサポートされていません。 サポートされているトリガーを使用するようにコードを更新してください。
Sparkトリガー | サポート対象 | 注 |
|---|---|---|
| はい | 推奨 |
| はい | これは非推奨です。代わりに |
| No | 戻り値 |
| No | 代わりに、LakeFlow Pipelines 連続モードを使用してください。 |
デフォルト( | No |
|
連続ストリーミングの場合は、連続モードでSpark宣言型パイプラインに移行するか、 AvailableNowで連続スケジュール ジョブを使用します。 大きなソースの場合は、メモリ不足エラーを防ぐためにmaxFilesPerTriggerまたはmaxBytesPerTriggerを設定してください。
例:ストリーミングトリガーを修正する
# Classic (not supported on serverless — default trigger is ProcessingTime)
query = df.writeStream.format("delta").outputMode("append").start()

# Serverless (explicit AvailableNow trigger)
query = (df.writeStream.format("delta").outputMode("append")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
query.awaitTermination()

# With OOM prevention for large sources
query = (spark.readStream.format("delta")
    .option("maxFilesPerTrigger", 100)
    .option("maxBytesPerTrigger", "10g")
    .load(input_path)
    .writeStream.format("delta")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
ワークロードをテストする
- クイック互換性テスト : 標準 アクセス モードおよびDatabricks Runtime 14.3 以降を使用して、クラシック コンピュートでワークロードを実行します。 実行が成功すると、コードを変更せずにワークロードをサーバレスに移行できます。
- A/B 比較 (本番運用に推奨): クラシック (コントロール) とサーバレス (エクスペリメント) で同じワークロードを実行します。 出力テーブルを比較し、正当性を検証する。出力が一致するまで繰り返す。
- 一時的な設定 :テスト中に、サポートされているSparkの設定を一時的に設定できます。安定したら取り外してください。
パフォーマンスモードを選択してください
サーバレス ジョブとパイプラインは、標準とパフォーマンス最適化の 2 つのパフォーマンス モードをサポートします。 選択するパフォーマンスモードは、ワークロードの要件によって異なります。
モード | 可用性 | 起動する | どのようなタスクにベストなのか |
|---|---|---|---|
Standard | ジョブ、LakeFlow Pipelines | 4~6分 | コスト重視のバッチ |
パフォーマンス最適化済み | ノートブック、ジョブ、LakeFlow Pipelines | 秒 | インタラクティブで、レイテンシに敏感 |
段階的に移行する
- 新しいワークロード : すべての新しいノートブックとジョブをサーバレスで開始します。
- 低リスクワークロード :標準アクセスモードおよびDatabricks Runtime 14.3以降で既に稼働しているPySpark/SQLワークロードを移行します。
- 複雑なワークロード :コード変更が必要なワークロード(RDDの書き換え、DBFSの更新、トリガーの修正など)を移行します。
- 残りのワークロード :機能拡張に伴い、定期的に見直してください。
コストを監視する
サーバーレスの請求は、クラスターの稼働時間ではなく、 DBU消費量に基づいて行われます。 大規模移行を行う前に、代表的なワークロードを用いてコスト予測を検証してください。サーバレス コストを監視するツールと戦略については、 「サーバレス コンピュートのコストを監視する」を参照してください。
その他のリソース
- サーバレス コンピュートのベスト プラクティス: サーバレス ワークロードの最適化のヒント
- サーバーレス コンピュートの制限事項: 現在の制限事項とサポートされていない機能の完全なリスト
- サーバーレス環境の構成: ライブラリと依存関係の管理
- サポートされているSpark構成: Spark構成は、 レス
- Spark Connectと従来のSpark :動作の違い レスアーキテクチャ
- サーバレス ネットワーク セキュリティ: NCC、プライベート リンク、ファイアウォール設定
- サーバーレス コンピュート リリース ノート: 新機能の出荷時に追跡する
- Unity Catalogアップグレードガイド: Hive metastoreからUnity Catalogへの移行
さらに詳しい情報については、以下のブログ記事もご参照ください。
- サーバレスコンピューティングとは何ですか? : サーバレス機能の概要と顧客実績
- データエンジニアリングの進化: サーバレス コンピュートがノートブックとLakeFlow Jobどのように変革するか: サーバレスがLakeFlow Jobs とパイプラインをどのように強化するか