Lakeflow Designer の組み込みオペレーター
Lakeflow Designerには、一般的なデータの準備と変換タスクのための組み込みオペレーターが含まれています。左側のサイドペインでオペレーターメニューを開いてカテゴリ別にオペレーターを閲覧するか、ペイン上部の 「オペレーターを検索...」 を使用してください。オペレーター検索は、ユーザーの意図に基づいてオペレーターを提案します。たとえば、average by monthと入力すると、 集計 オペレーターが返されます。キャンバスにオペレーターを追加した後、そのオペレーターを設定するには、ダブルクリックするか、オペレーターの上にカーソルを合わせて ( オペレーターの編集 )をクリックし、設定ペインを開きます。
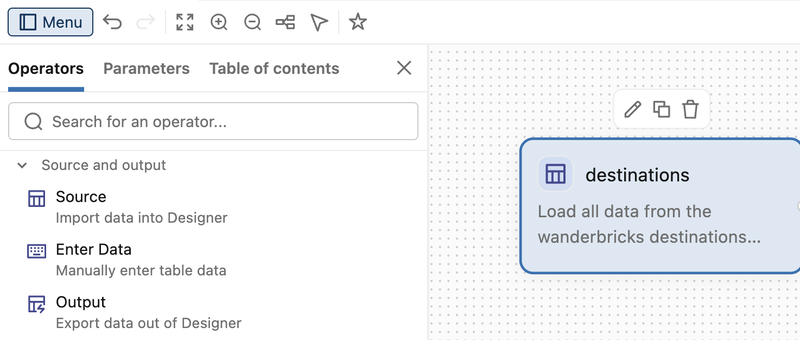
各オペレーターは、その機能のAI生成された説明を表示します。この説明はオペレーターのエディターとしても機能します。説明を編集すると、オペレーターが説明に合わせて再構成されます。
独自のユーザー定義演算子を作成する方法については、 「Lakeflow Designer のユーザー定義演算子」を参照してください。
ソースと出力
ソース
DesignerにUnity Catalogテーブルまたはその他のサポートされているソースからデータをインポートします。ソースを選択するには、名前でテーブルまたはファイルを検索するか、カタログとスキーマで参照します。このペインから新しいテーブルを作成することもできます。
テーブルを選択すると、ペインにテーブルの名前、所有者、最終更新時刻が表示されます。ソースを変更するには、「**新しいデータソースを選択**」をクリックします。ソースを変更すると、すべてのダウンストリームオペレーターの出力キャッシュが無効になります。
Unity Catalogメトリクスビューをソースとして使用することもできます。メトリクスビューを選択すると、含めるディメンションと測定値を選択し、Designerがアグリゲートクエリーを生成します。
Unity Catalog のボリュームまたはフォルダー全体をターゲットにすることを含め、データ取り込みオプションの全範囲については、Lakeflow Designer へのデータの取り込み」を参照してください。
データを入力
スプレッドシート形式のエディターに値を入力してテーブルを作成します。個別のソーステーブルを作成せずに、ルックアップ値やテストデータなどの少量の参照データを追加するには、このオペレーターを使用します。
フィールド | 説明 |
|---|---|
テーブルデータ | データをテーブルとして入力してください。最初の行は列ヘッダーを定義し、残りの行はデータです。Designerは、各列のデータ型をその値から推測します。 |
出力
Designerからデータをエクスポートします。Output オペレーターは、結果を Unity Catalog テーブルに書き込んだり、マテリアライズドビューとして公開したり、Unity Catalog ボリューム内のファイルに書き込んだりできます。 出力タイプ を使用して宛先を選択します。
出力タイプ | 説明 |
|---|---|
テーブル | 結果をマネージドUnity Catalogテーブルに書き込みます。 **テーブル名**と**出力場所** (カタログおよびスキーマ)を設定し、**書き込みモード**を選択してください。 |
マテリアライズドビュー | ビジュアルデータ準備の実行時に更新されるUnity Catalogのマテリアライズドビューとして、結果を発行します。 |
ファイル | 結果を Unity Catalog ボリューム内のファイルに書き込みます。**ファイルの種類**をCSV、Excel、またはJSONから選択し、ターゲットボリュームとファイル名を設定します。 |
**テーブル**または**ファイル**出力の場合、**書き込みモード**で各ランが宛先に書き込む方法を選択します。
書き込みモード | 説明 |
|---|---|
上書き | 既存のコンテンツを現在のランの結果に置き換えます。これがdefaultです。 |
追加 | 現在のラン結果を既存の行に追加します。 |
マージ | 指定した Merge キーに一致することで、ターゲット テーブルに行をアップサートします。テーブル出力で使用できます。 |
ラン をクリックして、ビジュアルデータ準備を実行し、結果を書き込みます。テーブル出力の場合、テーブルが存在しないと、オペレーターが作成します。スケジュールされたランは、同じ書き込みモードを使用して宛先に書き込みます。
Output 演算子がテーブル、マテリアライズドビュー、またはファイルを書き込んだ後、その出力ポートを接続してワークフローを続行します。テーブル、マテリアライズドビュー、およびプレーンな単一ファイル出力の場合、出力ポートは Output 演算子が書き込んだばかりの永続アセットから直接読み取ります。分割出力、Excel の範囲書き込み、およびヘッダーのないファイルの場合、出力ポートは入力行をそのまま通過させます。
ファイル出力の場合、 [詳細設定] を展開して次のオプションを設定します。
- 一意の値で分割 :個別の一意の値ごとに1つのファイルを書き込む列を選択します。Excel出力の場合は、代わりに各値を1つのブック内の個別のワークシートに書き込むことができます。1つのランで最大50個のファイルまたはワークシートを作成できます。
- シート名 :Excel出力の場合は、対象のワークシートを設定します。
- ヘッダー行を含める :CSVまたはExcel出力に列名を含めます。
- セル範囲 : [上書き] モードでの Excel 出力の場合は、開始セルとオプションの終了セルを設定します。Designer は範囲外の書式設定を保持し、データが固定範囲に収まらない場合はランを失敗させます。セル範囲を 個別の値による分割 と組み合わせることはできません。
Overwrite モードで出力が複数のファイルに分割される場合、Designer は生成された名前パターンに一致する既存のファイルを削除します。これには、ボリューム フォルダー内で同じパターンを持つ手動で作成されたファイルが含まれる場合があります。
AI機能
組み込みのAI操作をデータ上で実行します。設定ペインで、「関数の選択」を開き、以下の表のいずれかの関数を選択します。各関数は、入力用(例:列、プロンプト、ラベル、または言語)および出力用として、ペインにオプションを提供します。
関数 | 説明 |
|---|---|
| 入力テキストに対して感情分析を実行します。 |
| ユーザーが指定したラベルを使用して、テキストまたは解析済みドキュメントを分類します。 |
| 定義したフィールドを使用して、テキストまたは解析済みドキュメントから構造化データを抽出します。 |
| テキスト内の文法的な誤りを修正します。 |
| 指定した予測期間と頻度まで時系列データを予測します。 |
| 入力内容に対して、ユーザーが指定したプロンプトに回答します。 |
| テキスト内の特定のエンティティをマスクします(たとえば、匿名化のため)。 |
| 非構造化ドキュメントからテキスト、表、Layoutを抽出します。 |
| 解析されたドキュメントの出力を、ベクトル検索と検索拡張生成(RAG)パイプライン用の検索に対応したチャンクに変換します。 |
| 汎用的なタスクとモデルの柔軟性のために、サポートされている任意の基盤モデルを使用してプロンプトに応答します。 |
| 2つの文字列を比較し、意味的な類似度スコアを返します。 |
| テキストの要約を生成します。 |
| 指定した言語にテキストを翻訳します。 |
各関数の詳細については、AI関数を使用した非構造化データの変換を参照してください。
変換
以下の演算子は、データに対して変換処理を実行します。
集計
データをグループ化し、集計値を計算することで、行を要約します。
フィールド | 説明 |
|---|---|
集計条件 | 列を選択し、集計関数を選択して、出力列の名前を指定します。 + 集計を追加 をクリックして、さらに追加します。サポートされている関数: |
グループ | グループ化する列を選択してください。[ + グループ化を追加 ] をクリックします。 Group by で使用される列は、自動的に出力に含まれます。 |
組み合わせる
セット操作を使用して、複数のテーブルからのデータを単一の出力に結合します。
フィールド | 説明 |
|---|---|
設定操作 | Union 、 Intersect 、または Except を選択してください。 |
マージ戦略 | 出力から重複する行を除外するには**Distinct**を選択し、重複する行を含むすべての行を保持するには**All**を選択します。 |
Union by name | Union では、位置ではなく名前別に列を一致させるために、 [Advanced] の下にある [Union by name] を選択します。 |
Allow missing columns | Union では、まず [Union by name] を選択し、次に [Allow missing columns] を選択して、入力から欠落している列を null 値で埋めます。このオプションがオフの場合、各入力には同じ一連の列が含まれている必要があります。 |
ユニーク
入力データから重複行を削除します。defaultでは、この演算子はすべての列を対象に重複排除を行います。代わりに、列のサブセットをキーとして選択し、行を並び替えることで、どの重複行を保持するかを制御できます。
フィールド | 説明 |
|---|---|
一意の基準: | すべての列で同一の行を削除するには [すべての列] を選択し、キーとして選択した列のみで重複している行を削除するには [選択した列] を選択します。 |
並べ替え | オプション:1 つ以上の列と並べ替え順序を選択して、重複セットごとにどの行を保持するかを制御します。順序を設定しない場合、演算子は最初に見つかった行を保持します。 |
フィルター
グラフィカルな条件ビルダーを使用して、1 つ以上の条件を満たすかどうかに基づいて行を分割します。
フィールド | 説明 |
|---|---|
条件 | 各条件について、条件付きで一致させる*列*、*条件タイプ*、および*値*を選択します。サポートされている条件タイプ:
日付列の条件の場合、日付ピッカーは年と月の間を移動するのに対応しています。 条件が列の値と一致する場合(例: Is one of )、値リストには、入力に基づいてその列の一意の値のサンプルが表示されます。 Load more を選択して、必要に応じて追加の値をフェッチします。 |
フィルター演算子には 2 つの出力があり、条件を満たすかどうかに基づいてデータをBranchできます。
出力 | 説明 |
|---|---|
含まれるもの | フィルター条件を満たす行。 |
除外 | フィルター条件を満たさない行。これには、条件がnullと評価される行も含まれます。 |
ガードレール
受信データを順序付けられたチェックリストに照らして検証し、合格した行と不合格の行を分離します。
フィールド | 説明 |
|---|---|
チェック | 必須列 、 行数 、 NULL 以外 、 一意 、 許容値 、 許可されない値 、 値の範囲 、 正規表現一致 、または 式 のチェックを追加します。 |
チェックが失敗した場合 | 出力および下流の動作を制御するには、3つのオプションから1つを選択します。 |
-
警告を表示し、合格した行で続行 :
- 下流の実行が継続されます。
- 有効なすべてのチェックに合格した行は、 Passed に送信されます。
- 有効になっているチェックのいずれか1つで失敗した行は、 [Failed] に送信されます。
- Errors には、失敗したチェックごとに1つの行が含まれ、その種類、重大度、メッセージが示されます。
-
合格した出力に対し警告およびブロックする :
- チェックが失敗した場合、下流の実行は継続されますが、 Passed には行が含まれません。
- 失敗 には失敗した行が引き続き含まれ、 エラー には失敗の詳細が引き続き含まれます。
- 合格した行の下流処理を防止しながら、 Failed および Errors の下流処理を許可するには、このオプションを使用します。
-
ワークフローを失敗させる :
- チェックが失敗した場合、下流の演算子が実行される前に実行が停止します。
- これらは Passed 、 Failed 、または Errors の出力を受け取りません。
- スケジュールされたジョブでは、ランが失敗としてマークされ、ジョブ通知など、設定済みの失敗処理がTriggerされる可能性があります。
Guardrailsオペレーター自体をプレビューする場合でも、 Fail the workflow モードで3つの出力すべてを検査できます。
いずれかの警告モードで出力から行を永続化するには、それを Output 演算子に接続します。
結合
一致する列値に基づいて入力データセットを結合することにより、テーブルの Link を作成します。
フィールド | 説明 |
|---|---|
入力テーブル | 結合する 2 つの入力テーブルを選択します。3 つ以上のテーブルを結合するには、 [Advanced options] を展開し、 [Join more than three tables] を選択して、追加のテーブルごとに [Add input] をクリックします。 |
結合条件 | 2 つのテーブルから一致する列を選択して、少なくとも 1 つの結合条件を指定します。 + Add join expression をクリックして、さらに条件を追加します。オプション: 2 つのテーブル間の矢印をクリックしてカスタム結合条件を追加し、AI 生成の説明を編集するか SQL を記述します。3 つ以上の入力がある場合、追加された各テーブルは、別の入力に対する 1 つの関係を定義する必要があります。 |
大文字と小文字の区別 | オフの場合(default)、文字列結合キーは大文字と小文字を区別せずに照合されます(先頭と末尾の空白は無視されます)。文字列キーを完全に照合するには、「大文字と小文字を区別」をオンにします。このオプションは、カスタム結合条件ではなく、結合キーに適用されます。 |
結合タイプ | 2つの入力テーブルについて、結合タイプを選択します。defaultでは、Join演算子は結果を3つの出力に分割します(次のセクションを参照してください)。代わりに Full join 、 Inner join 、 Left join 、または Right join を選択して、単一の結合された出力を作成します。3つ以上の入力がある場合、演算子は構成されたテーブル関係に従い、内部結合を使用し、単一の結合された出力を生成します。 |
出力列 | オプション: 含める列を選択します。defaultでは、各入力テーブルの列が含まれます。2つの入力がある場合、右側のテーブルからの重複する名前には |
カスタム式列 | オプション: 結合された結果に基づいて、カスタム式列を追加します。 |
2つの入力がある場合、Joinオペレーターにはdefaultで3つの出力があるため、結合結果に基づいてワークフローをbranchさせることができます。
出力 | 説明 |
|---|---|
一致しないまま | 右側の入力に一致するものがない左側の入力の行。 |
一致しました | 両方の入力にわたって一致する行。 |
右側の不一致 | 左側の入力に一致しない右側の入力の行。 |
2 つの入力がある場合、特定の [Join type] (full、inner、left、または right) を選択すると、3 つの分割された出力の代わりに単一の結合された出力が生成されます。
制限
指定した最大行数までしか処理を通過させないことで、行数を制限します。
フィールド | 説明 |
|---|---|
最大行数 | 渡す行の最大数を指定してください。 |
ピボット
表形式データを双方向に整形します。構成ペインの上部にあるtabを使用して、モードを選択してください。
行 → 列 (ピボット)
1つの列にある異なる値を新しい列ヘッダーに変換し、別の列からの集計値で埋めます。
フィールド | 説明 |
|---|---|
ピボット列 | 一意の値が新しいヘッダーになる列を選択します。 |
値&集計 | ピボットされたセルに値が埋め込まれる列を選択し、集約関数を選択します。利用可能な関数は、選択した列のデータ型によって異なります。
ペインで利用できる場合は、欠損値の処理方法(null またはゼロなど)を構成します。 |
列 → 行 (アンピボット)
1つまたは複数の列を行に折りたたみます。
フィールド | 説明 |
|---|---|
列をアンピボット | アンピボットする列を選択してください。 |
キーと値の列 | 出力キーと値の列の名前を設定します。 |
列を含める
どちらのモードでも、ピボットまたはアンピボットされた値とともに、出力に残す列を選択し、変換前に不要な列は削除します。デザイナーは、ピボット、値、またはアンピボットのロールに割り当てていない列から、固定 (グループ化) 列を推測します。
ソート
1つまたは複数の列で行を順序付けします。
フィールド | 説明 |
|---|---|
並べ替え順 | 各列に対して、 ASC (昇順)または DESC (降順)を選択します。追加の列で並べ替えるには、 + ソート式を追加 をクリックします。並べ替えは標準の辞書式順序に従います。 |
SQL
他の演算子でカバーされていない変換処理に対して、カスタムSQLコードを作成します。
フィールド | 説明 |
|---|---|
SQLエディタ | SQL SQL
|
パラメータ | ビジュアルデータ準備のパラメーターを参照するには、たとえば、 |
 ボタンをクリックして、完全な SQL コード ペインを開き、ステートメントが完全なワークフローにどのように適合するかを確認します。
選択
入力データから列を選択、名前変更、並べ替えを行います。
フィールド | 説明 |
|---|---|
列を含める/除外する | **すべての列を含めて開始**または**列なしで開始**を選択し、チェックボックスを使用して個々の列を含めるか除外します。列をドラッグして並べ替えます。 |
列の名前を変更する | 任意の列の横にある [名前の変更] フィールドに、新しい名前を入力します。 |
列を動的に選択 | 列を個別に選択するのではなく、ルールに基づいて列を選択することで、入力スキーマの変更に合わせて出力が適応するようにします。 一致する列を保持 するか、 一致する列を削除 するかを選択し、次の基準で列を一致させます:
|
準備
入力データに1つ以上のアクションを連結することで、列をクリーンアップして導出します。 「+ Add action」をクリックし、アクションを選択します。 必要なだけアクションを追加します。それらは順番に適用されます。
操作 | 説明 |
|---|---|
公式 | 自然言語またはSQL式を使用して、新しい列を作成するか、既存の列を上書きします。 |
タイプを変更 | 列を別のデータ型に変換します。 |
値を置き換えます | 列の値を検索および置換 |
null値を埋める | Null値を定数で置き換えます。 |
テキストの大文字・小文字 | 大文字、小文字、またはタイトルケースに変更します。 |
空白を削除 | 両端または片方から空白を削除します。 |
正規表現置換 | 正規表現パターンに一致するテキストを置換します。 |
抽出(Extract) | 正規表現グループに一致する部分文字列を抽出。 |
日付を解析 | 文字列を日付やTimestampに変換します。 |
アクションを削除するには、その行にカーソルを合わせ、 をクリックします。
カスタム列
「**Formula**」アクションにより、式エディターが開き、自然言語またはSQLコードを使用して新しい列を作成したり、既存の列を上書きしたりできます。エディターには2つの入力ボックスがあり、双方向です:
- 説明 : 列に何を実行させたいかを自然言語で説明します。Designer は Genie を使用して、以下の対応するコード式を生成します。
- 式 : コードを直接記述または編集する場合は、式の編集ボタンをクリックします。式を編集すると、自然言語による説明が自動的に生成されます。
式エディターで @ と入力すると、演算子の入力列と組み込み SQL 関数のメニューが開きます。@ の後に入力してリストをフィルタリングし、エントリを選択して挿入します。列を選択するとその名前が挿入され、関数を選択すると括弧内にカーソルが置かれた状態で関数呼び出しが挿入されます。同じ @ メニューは、カスタムフィルタや結合条件など、他の演算子の式エディタでも使用できます。
Python
入力データに対してカスタム Python (PySpark) を実行します。
フィールド | 説明 |
|---|---|
| 単一のDataFrameを |
| 入力 DataFrames のリストを、アップストリームの順に示します。オペレーターの詳細ペインには、各入力の名前が順番に表示されます。たとえば、 |
パラメータ |
|
最小限のパターンとしては、入力値が存在する場合は最初の入力値を使用し、存在しない場合は空のDataFrame使用する方法があります。
# inputs["data"] is a list of input DataFrames

result = inputs["data"][0] if inputs["data"] else spark.createDataFrame([], "col: string")
そこから、代入が終了する前にresultに対して DataFrame の操作 (例えば、 select 、 filter 、 withColumn 、または結合) を連鎖させたり、 result inputs["data"]から構築された新しい DataFrame に置き換えたりすることができます。
プレビュー中、演算子の出力は生成されると同時に出力ペインにストリームされます。これには display() でレンダリングしたものや出力したテキストが含まれるため、ランが終了する前に結果を確認できます。
Python プレビューモード
ビジュアルデータの準備を作成する際、Designerはデータのサンプルを使用して、各演算子の出力を継続的にプレビューします。これらのプレビューは、フルランと同じ方法でPythonコードを実行します。これは、外部APIの呼び出し、通知の送信、Unity Catalog外のシステムへの書き込みなど、コードに副作用がある場合に問題となります。通常、プレビューのたびにそのような副作用が発生することは望ましくありません。
コードで両者を区別できるようにするため、Designer が設定する Boolean 値である config["is_preview"] を読み取ります。
Trueプレビューラン中であるため、副作用をスキップできます。False「実行」 をクリックしたときやスケジュールされたランなど、フルランの実行中。
例えば、副作用がプレビュー外でのみ実行されるようにガードします:
result = inputs["data"][0] if inputs["data"] else spark.createDataFrame([], "col: string")

# Side effects run only on a full run or scheduled job, not during previews.
if not config["is_preview"]:
    write_results_to_external_system(result)
組織
注記
キャンバスにメモを追加して、ワークフロー自体(目的、前提条件、注意事項、視覚的なデータ準備を後で開く人への引き渡しコンテキスト)を文書化できるようにします。
フィールド | 説明 |
|---|---|
コンテンツ | リッチテキストエディターを使用して、キャンバスでメモの内容をインライン編集します。プレーンテキストでは不十分な場合、見出し、テキストのスタイル設定、Link、画像、テーブルを追加できます。ノートは、オペレーターを介したデータの流れに影響しません。 |
グループ
キャンバス上の演算子を視覚的にグループ化し、データの流れを変更することなく、視覚的なデータ準備が大規模になる場合や論理的な段階を反映したい場合に役立ちます。
フィールド | 説明 |
|---|---|
グループに追加します | 1つまたは複数のオペレーターをグループにドラッグして追加してください。 |
選択から作成 | 1つまたは複数の演算子を選択し、ショートカットメニューを開いて(右クリック)、 [新しいグループを作成] を選択して、選択範囲を新しいグループにまとめます。 |
名前 | グループに説明的な名前を付けます。 |
最小化 / 拡大 | キャンバスでグループのコンテンツを表示または非表示にするには、**最小化**または**拡大**をクリックします。 |
有効/無効 | グループのヘッダーを右クリックして 「無効化」 を選択するとグループ内のすべての演算子がランから除外され、 「有効化」 を選択すると再度含まれます。無効化された演算子は出力行を生成しないため、有効化されるまでダウンストリームの演算子は空の結果を受け取ります。個々の演算子を有効化または無効化することもできます。演算子の有効化または無効化を参照してください。 |
可視化
入力データから可視化を作成し、それをキャンバスに直接レンダリングします。表形式データを生成する任意の演算子に可視化演算子を接続し、Designerを離れることなく結果をグラフ化します。
ビジュアライゼーションを構成するには、演算子を開き、 ビジュアライゼーション の種類を選択してから、列をチャートにマップします。
フィールド | 説明 |
|---|---|
可視化 | レンダリングするチャートの種類は、**棒グラフ**、**面グラフ**、または**カウンター**などです。 |