メッセージタイプ
gRPC経由でZerobus Ingest SDKを使用して取り込む場合、特定のストリームでレコードをエンコードする方法を選択します。Zerobus Ingestは4つのメッセージフォーマットをサポートしているため、ワークロードのシンプルさ、型安全性、throughputをトレードオフできます: JSON、 Protocol Buffers (protobuf)、 Apache Arrow、および Avro (Beta)。各フォーマットは、データが永続化される前にDeltaテーブルスキーマに対して検証されます。スキーマ管理を参照してください。
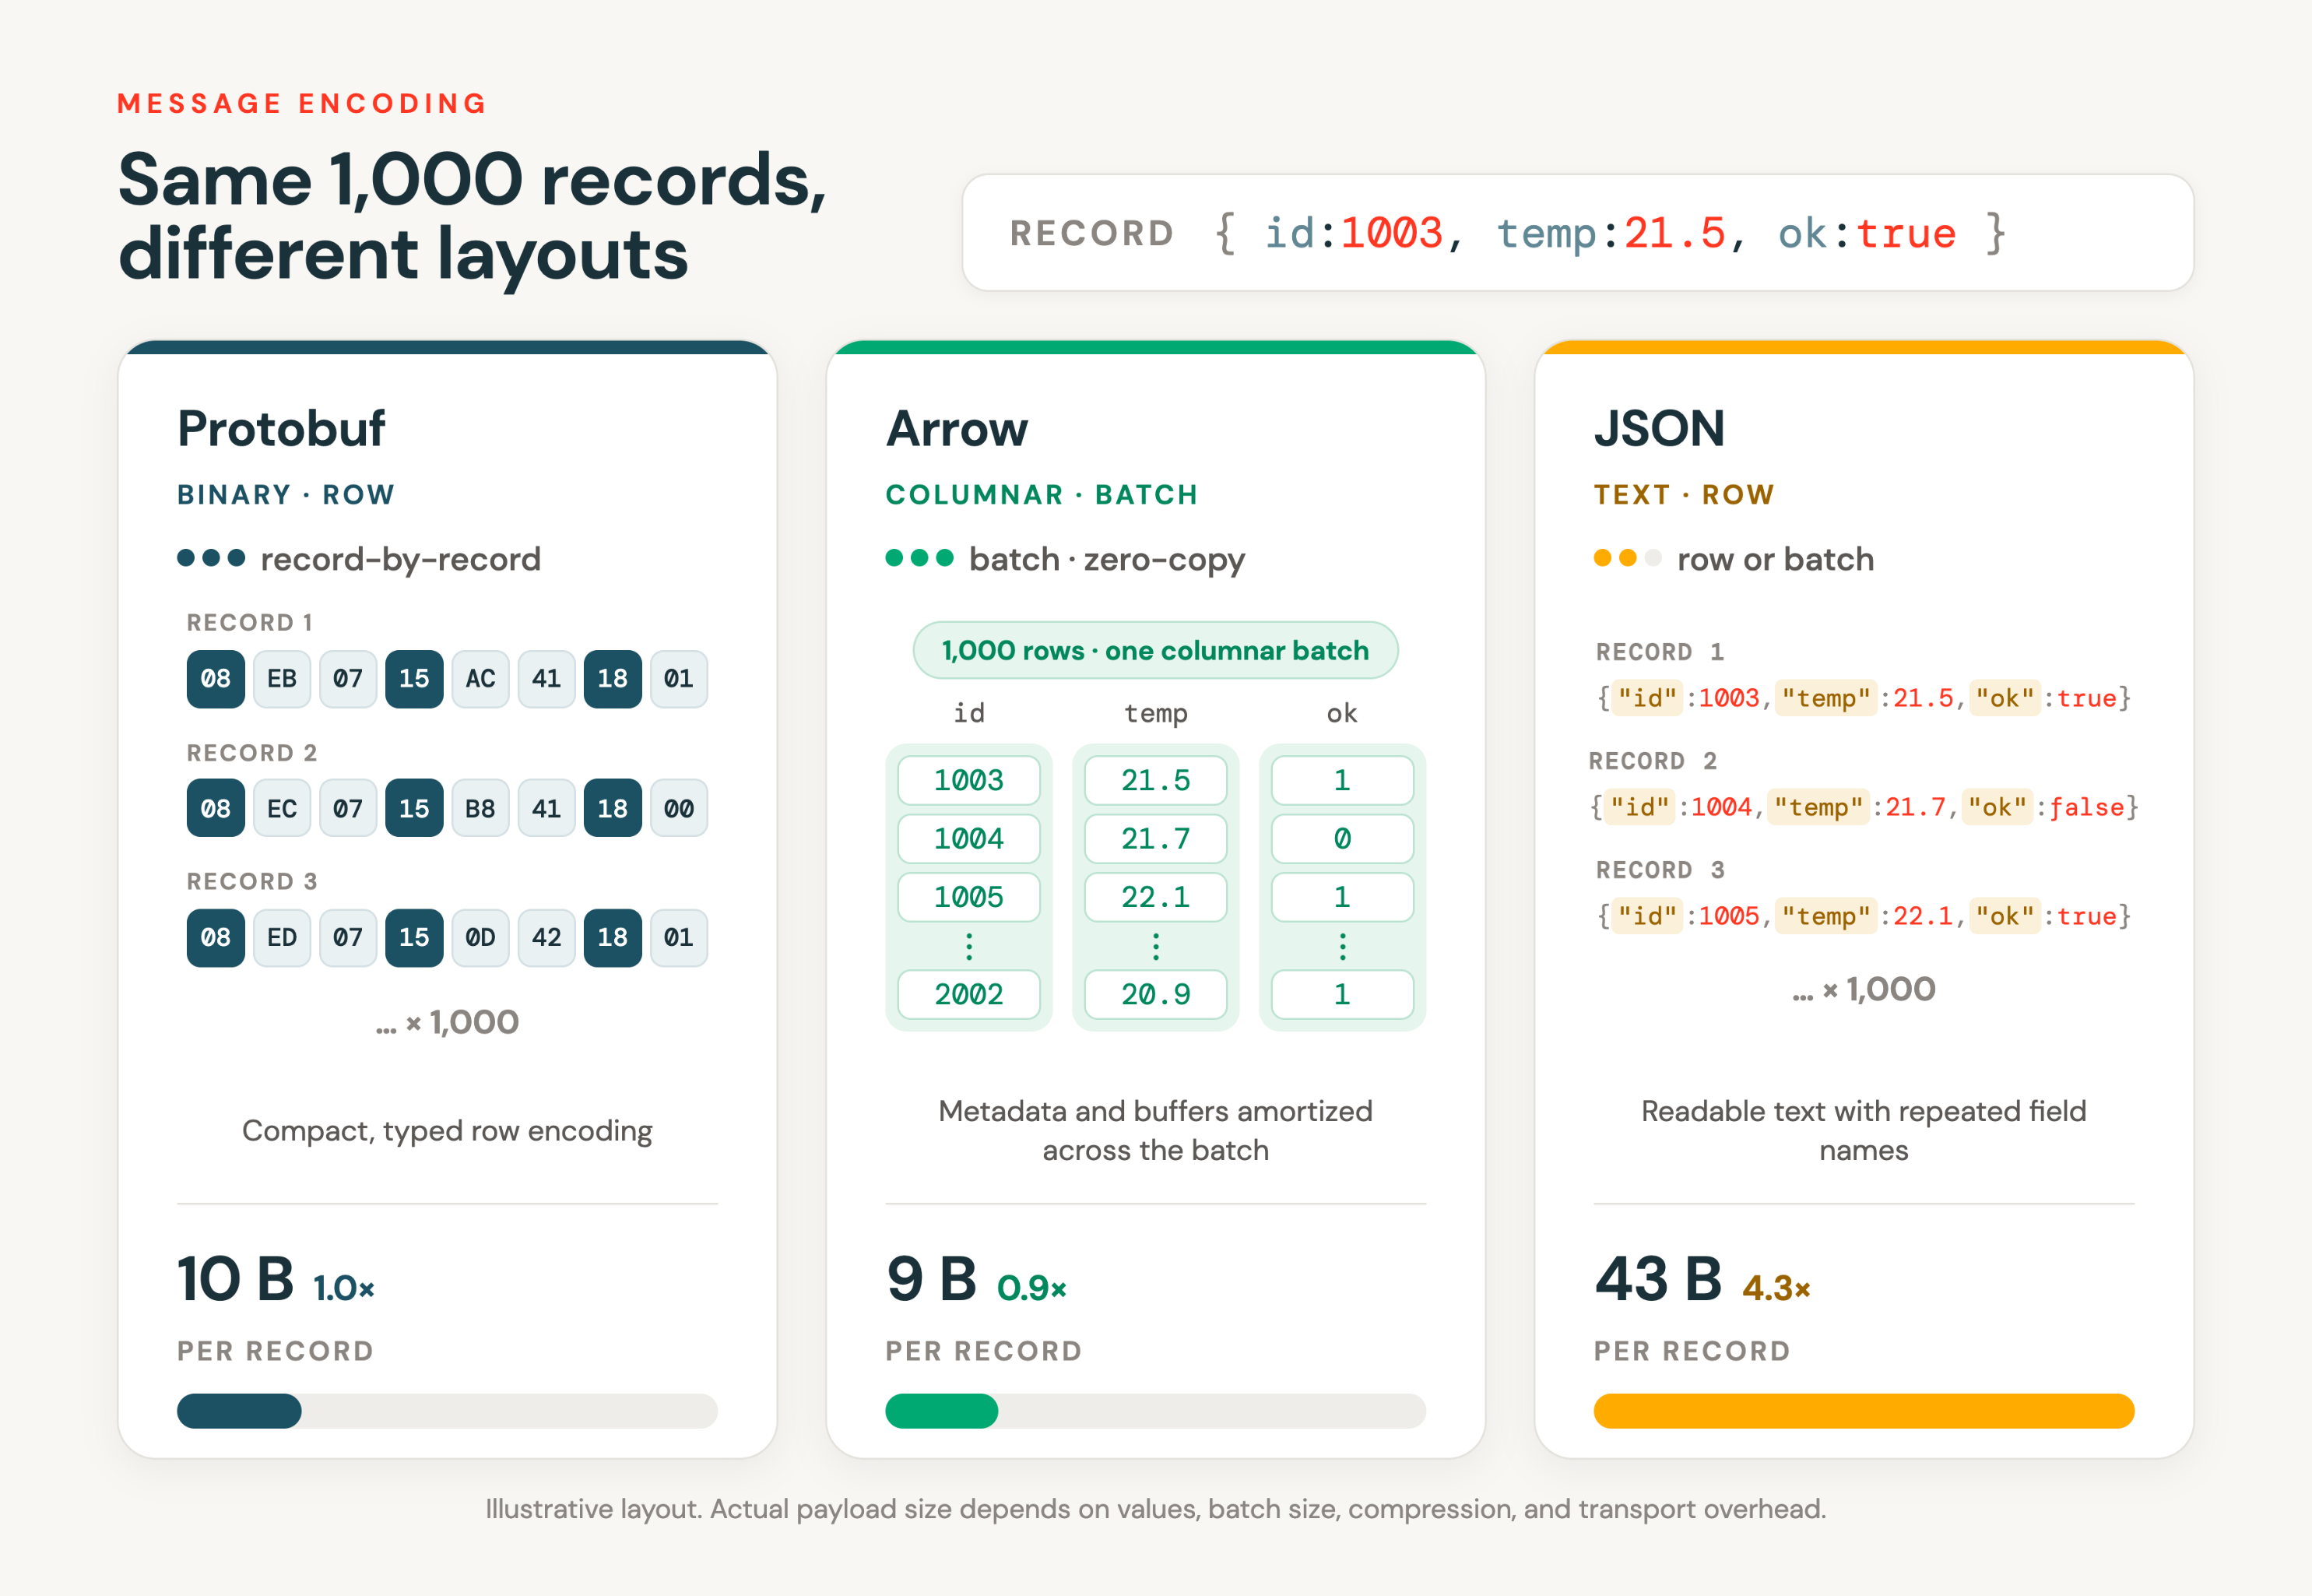
図は、JSON、protobuf、およびApache Arrowを示しています。これには、protobufに類似したコンパクトな行指向エンコーディングを使用するAvroは含まれていません。
どの形式を使用すべきですか?
フォーマット | どのようなタスクにベストなのか | 注 |
|---|---|---|
JSON | 導入とシンプルなプロデューサー。 | コンパイルするスキーマ定義を必要としない、最もシンプルなオプションです。便利ですが、大量のワークロードではバイナリ形式よりも低速です。 |
プロトコルのバッファ | 本番運用、行指向、大量のストリーム。 | 型安全でコンパクトなバイナリエンコーディング。ほとんどの本番運用ワークロードに推奨されます。コンパイル済みスキーマが必要です。 |
Apache Arrow | カラムナ型またはバッチ指向のワークロード。 | Apache Arrow レコードバッチを直接送信し、行ごとのシリアル化を回避します。データがすでに列指向である場合、またはバッチで取り込む場合に最適です。Zerobus Ingest で Arrow Flight を使用するを参照してください。 |
Avro (ベータ) | Avro ですでに動作している行指向プロデューサー。 | JSONスキーマによって記述されるコンパクトな行指向バイナリエンコーディングで、protobufに代わるもの。 |
以下のスニペットは、Python SDKにおける各フォーマットの形状を示しています。これらは、SDKクライアントが既に作成されており、ターゲットテーブルが判明していることを前提としています。完全なセットアップ(Endpoint、テーブル、Service Principal)および各言語の例については、Use Zerobus Ingestを参照してください。
JSON
JSON は最も簡単に起動する方法です。コンパイルするスキーマ定義なしで、レコードを JSON オブジェクトとして送信します。これは、起動、プロトタイピング、および throughput よりも利便性が重視されるプロデューサーに最適です。大量の本番運用ワークロードには、バイナリ形式(protobuf または Arrow)の方が効率的です。
記述子なしで TableProperties にテーブル名を渡すことにより、JSON レコードのストリームを作成します:
table_properties = TableProperties(TABLE_NAME)
stream = sdk.create_stream(CLIENT_ID, CLIENT_SECRET, table_properties)

stream.ingest_record_offset({"device_name": "sensor-1", "temp": 22, "humidity": 55})
JSON の詳細なウォークスルーについては、「クライアントを記述する」を参照してください。
Protocol Buffers
Protobuf は、型安全でコンパクトなバイナリエンコーディングを提供し、ほとんどの本番運用における行指向ワークロードで推奨される形式です。ターゲットの Delta テーブルに適合する protobuf スキーマを定義し(Protobuf スキーマを参照)、それをコンパイルすると、SDK が gRPC を介してレコードごとにデータを取り込みます。
protobuf の使用には 3 つのステップが必要です。テーブルと一致する .proto スキーマを生成し、それを言語モジュールにコンパイルしてから、記述子を TableProperties に渡してレコードを取り込みます。次の例では Python SDK を使用します。
1. テーブルから .proto スキーマを生成します。 Python SDKには、Deltaテーブルを読み取り、一致するスキーマを書き込むgenerate_protoツールが含まれています。
python -m zerobus.tools.generate_proto \
    --uc-endpoint "https://<workspace-id>.cloud.databricks.com" \
    --client-id "<client-id>" \
    --client-secret "<client-secret>" \
    --table "main.default.air_quality" \
    --output "record.proto" \
    --proto-msg "AirQuality"
生成されたスキーマはproto2構文を使用し、各Delta列にオプションのフィールドが含まれます:
syntax = "proto2";
message AirQuality {
    optional string device_name = 1;
    optional int32 temp = 2;
    optional int64 humidity = 3;
}
2. protobuf コンパイラを使用してスキーマを Python モジュールにコンパイルする :
pip install "grpcio-tools>=1.60.0,<2.0"
python -m grpc_tools.protoc --python_out=. --proto_path=. record.proto
これは record_pb2.py を生成します。
3. レコードをインジェスト するには、コンパイルされた記述子を TableProperties (protobuf の default) に渡します。SDK は記述子を使用して各レコードをシリアル化します:
import record_pb2

descriptor_bytes = record_pb2.AirQuality.DESCRIPTOR.file.serialized_pb
table_properties = TableProperties(TABLE_NAME, descriptor_bytes)
stream = sdk.create_stream(CLIENT_ID, CLIENT_SECRET, table_properties)

record = record_pb2.AirQuality(device_name="sensor-1", temp=22, humidity=55)
stream.ingest_record_offset(record)
上記の例では Python SDK を使用しています。ツールは言語によって異なります。一部の SDK にはテーブルから .proto を生成する generate_proto ユーティリティが付属していますが、その他 (Go や TypeScript など) は既存の .proto をコンパイルします。言語ごとのステップについては、「クライアントの作成」の各 SDK tab にある protobuf の注記を参照してください。ツールのソースと完全な例については、Zerobus SDK リポジトリを参照してください。
Apache Arrow
Apache Arrowの取り込みでは、各行を最初にJSONやprotobufに変換するのではなく、同じgRPC接続を介して Arrow RecordBatch データを直接送信します。アプリケーションがすでにArrowデータを生成している場合や、行をバッチで取り込む場合に最適な選択肢です。特に、行ごとのシリアル化がオーバーヘッドとなるような、幅が広く数値が多いスキーマや、アナリティクス指向のスキーマに適しています。
Arrowは、非常に大きなバッチにも適しています。すべてか無かであり、メッセージごとのサイズ制限によって制限されるJSONおよびprotobufのバッチメソッドとは異なり、Arrow Flightパスは大きなバッチを小さな転送メッセージに分割し、個別に送信および確認応答を行います。Arrow Flight バッチ are the exceptionおよびUse Arrow Flight with Zerobus Ingestを参照してください。
pyarrow.Schema を使用して Arrow ストリームを開き、RecordBatch データを取り込みます:
stream = sdk.create_arrow_stream(TABLE_NAME, schema, CLIENT_ID, CLIENT_SECRET)

stream.ingest_batch(batch)
スキーマ定義、バッチ処理、圧縮を含む Arrow Flight の詳細なウォークスルーについては、「Zerobus Ingest での Arrow Flight の使用」を参照してください。
Avro
ベータ版
この機能はベータ版です。使用するには、ワークスペース管理者は [プレビュー] ページから Zerobus Ingest Avro サポート を有効にする必要があります。Databricksのプレビューを管理するを参照してください。
Apache Avro は、行指向のコンパクトなバイナリ スキーマ駆動型形式です。protobuf と同様に、各レコードはフィールド名をインラインで保持する代わりにスキーマに対してエンコードされるため、レコードが小さくなります。違いは、protobuf はコンパイルされた .proto 記述子を使用するのに対し、Avro は JSON で記述されたスキーマでレコードを記述することです。Avro の取り込みは、Zerobus SDK を介して gRPC 上で実行されます。Avro をサポートする SDK については、 Zerobus SDK リポジトリ を参照してください。
Avroは、プロデューサーが既にAvroで作業している場合に適しています。例えば、上流システムからAvroデータを読み取る場合や、既にAvroライタースキーマを保持している場合などです。
スキーマの取り扱い
Zerobus Ingestはスキーマレジストリを使用せず、回線上のレコードはスキーマIDやフィンガープリントを保持しません。その代わりに、ストリームを作成するときにAvroライタースキーマをJSONとして提供し、そのストリーム上のすべてのレコードはそのスキーマに対してデコードされます。スキーマはターゲットのDeltaテーブルに対して事前に検証されるため、互換性のないスキーマはデータが流れる前に拒否されます。
ライターのスキーマは、ストリームの存続期間中固定されます。異なるスキーマで取り込むには、新しいストリームを作成します。
Avroフィールドはすべてのレベルで名前によってDelta列とペアになるため、ライタースキーマでのフィールドの順序は関係ありません。Avro型をDelta列にマップする方法と、ターゲットにできない列については、Avro型を参照してください。レコードがテーブルに対してどのように検証されるかについては、スキーマ管理を参照してください。
Avroライタースキーマは、各型をインラインで宣言する必要があります。名前付き型参照はサポートされていません。これは、スキーマの他の場所で名前付きrecord、enum、またはfixed型をその名前を参照して再利用するものです。
データの提供方法
SDKを使用するかどうかにかかわらず、一度に1つの値を読み込むか、バッチで読み込むことができます。異なるのは、データを Avro にエンコードする人です。
-
SDKを使用すると、次のことができます。
- SDKにデータをエンコードさせる : AvroレコードをSDKに渡すと、SDKはライタースキーマに従ってそれらをエンコードします。
- 事前にエンコードされたAvroバイト列を送信 :すでに上流システムなどからAvroでエンコードされたデータをお持ちの場合、SDKはそのまま送信します。
-
SDK を使用せずに gRPC API を直接呼び出す場合、送信するのは事前にエンコードされた Avro バイトのみです。writer schema を使用してストリームを作成し、コンテナーファイルヘッダー、schema registry ID のプレフィックス、またはフィンガープリントを付けずに、データの未加工の Avro バイナリーエンコーディングを送信します。
クライアントを記述する
以下の例では、Python SDKとRust SDKを使用しています。ストリームを作成し、SDKがライタースキーマに対してエンコードするレコードを送信し、フラッシュします。これらは、Zerobus Ingest (Endpoint、ターゲットテーブル、および Service Principal) が既に設定されていることを前提としています。Zerobus Ingest の使用を参照してください。どのSDKがAvroをサポートしているかについては、 Zerobus SDKリポジトリを参照してください。
- Python SDK
- Rust SDK
avro extraを使用してSDKをインストールします。これにより、fastavroエンコーダがプルインされます:
pip install "databricks-zerobus-ingest-sdk[avro]"
ライターのスキーマを JSON 文字列として avro_schema キーワードで TableProperties に渡し、レコードを辞書として取り込みます。
import json

from zerobus.sdk.sync import ZerobusSdk
from zerobus.sdk.shared import TableProperties

SERVER_ENDPOINT = "https://1234567890123456.zerobus.us-west-2.cloud.databricks.com"
DATABRICKS_WORKSPACE_URL = "https://dbc-a1b2c3d4-e5f6.cloud.databricks.com"
TABLE_NAME = "main.default.air_quality"
CLIENT_ID = "your-client-id"
CLIENT_SECRET = "your-client-secret"

SCHEMA = {
    "type": "record",
    "name": "AirQuality",
    "fields": [
        {"name": "device_name", "type": "string"},
        {"name": "temp", "type": "int"},
        {"name": "humidity", "type": "long"},
    ],
}

sdk = ZerobusSdk(SERVER_ENDPOINT, DATABRICKS_WORKSPACE_URL)
table_properties = TableProperties(TABLE_NAME, avro_schema=json.dumps(SCHEMA))
stream = sdk.create_stream(CLIENT_ID, CLIENT_SECRET, table_properties)

try:
    for i in range(1000):
        stream.ingest_record_offset(
            {"device_name": f"sensor-{i}", "temp": 20 + (i % 5), "humidity": 55 + (i % 10)}
        )
    stream.flush()
finally:
    stream.close()
既にエンコードしたデータを送信するには、ラッパー型なしで、生の bytes を ingest_record_offset に直接渡します。SDKはそれらを変更せずに送信します。バイトは、同じライタースキーマに対してエンコードされた、スキーマレスのAvroデータである必要があります。ここではリテラルとして表示されていますが、実際にはアップストリームシステムから取得されます。
# A schemaless Avro datum for {"device_name": "sensor-0", "temp": 21, "humidity": 55},
# encoded against the writer schema above: a length-prefixed "sensor-0", then temp
# and humidity as Avro varints.
payload = b"\x10sensor-0\x2a\x6e"
stream.ingest_record_offset(payload)
avro機能を持つクレートを追加します。これにはRust 1.88以降が必要です。
cargo add databricks-zerobus-ingest-sdk --features avro
cargo add tokio --features macros,rt-multi-thread
ストリームビルダで.avro(schema_json)でAvroフォーマットを選択し、SDKがライタースキーマに対してエンコードするAvroRecordの値をインジェストします:
use databricks_zerobus_ingest_sdk::{AvroRecord, AvroValue, ZerobusSdk};

const SERVER_ENDPOINT: &str = "https://1234567890123456.zerobus.us-west-2.cloud.databricks.com";
const DATABRICKS_WORKSPACE_URL: &str = "https://dbc-a1b2c3d4-e5f6.cloud.databricks.com";
const TABLE_NAME: &str = "main.default.air_quality";
const CLIENT_ID: &str = "your-client-id";
const CLIENT_SECRET: &str = "your-client-secret";

const AVRO_SCHEMA: &str = r#"{
  "type": "record",
  "name": "AirQuality",
  "fields": [
    {"name": "device_name", "type": "string"},
    {"name": "temp", "type": "int"},
    {"name": "humidity", "type": "long"}
  ]
}"#;

#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    let sdk = ZerobusSdk::builder()
        .endpoint(SERVER_ENDPOINT)
        .unity_catalog_url(DATABRICKS_WORKSPACE_URL)
        .build()?;

    let mut stream = sdk
        .stream_builder()
        .table(TABLE_NAME)
        .oauth(CLIENT_ID, CLIENT_SECRET)
        .avro(AVRO_SCHEMA)
        .build()
        .await?;

    for i in 0..1000 {
        let record = AvroValue::Record(vec![
            ("device_name".to_string(), AvroValue::String(format!("sensor-{i}"))),
            ("temp".to_string(), AvroValue::Int(20 + i % 5)),
            ("humidity".to_string(), AvroValue::Long((55 + i % 10) as i64)),
        ]);
        stream.ingest_record_offset(AvroRecord(record)).await?;
    }
    stream.flush().await?;
    stream.close().await?;

    Ok(())
}
既にエンコード済みのデータを送信するには、AvroRecordの代わりにAvroBytes(bytes)をingest_record_offsetに渡します。
関連
- API プロトコル: これらの形式が経由する API プロトコル。
- スキーマ管理:レコードがテーブルに対してどのように検証されるか。
- サポートされているデータ型:サポートされている Delta、Protobuf、Avro のデータ型。