レガシー Python CLI でランを追跡する
このドキュメントは廃止されており、更新されない可能性があります。
databricks-air パッケージとともにインストールされる Python ベースの air CLI は非推奨となり、今後は積極的にメンテナンスされません。
新しいワークロードには Databricks CLI を使用します。AI Runtime での Databricks CLI の使用を参照してください。
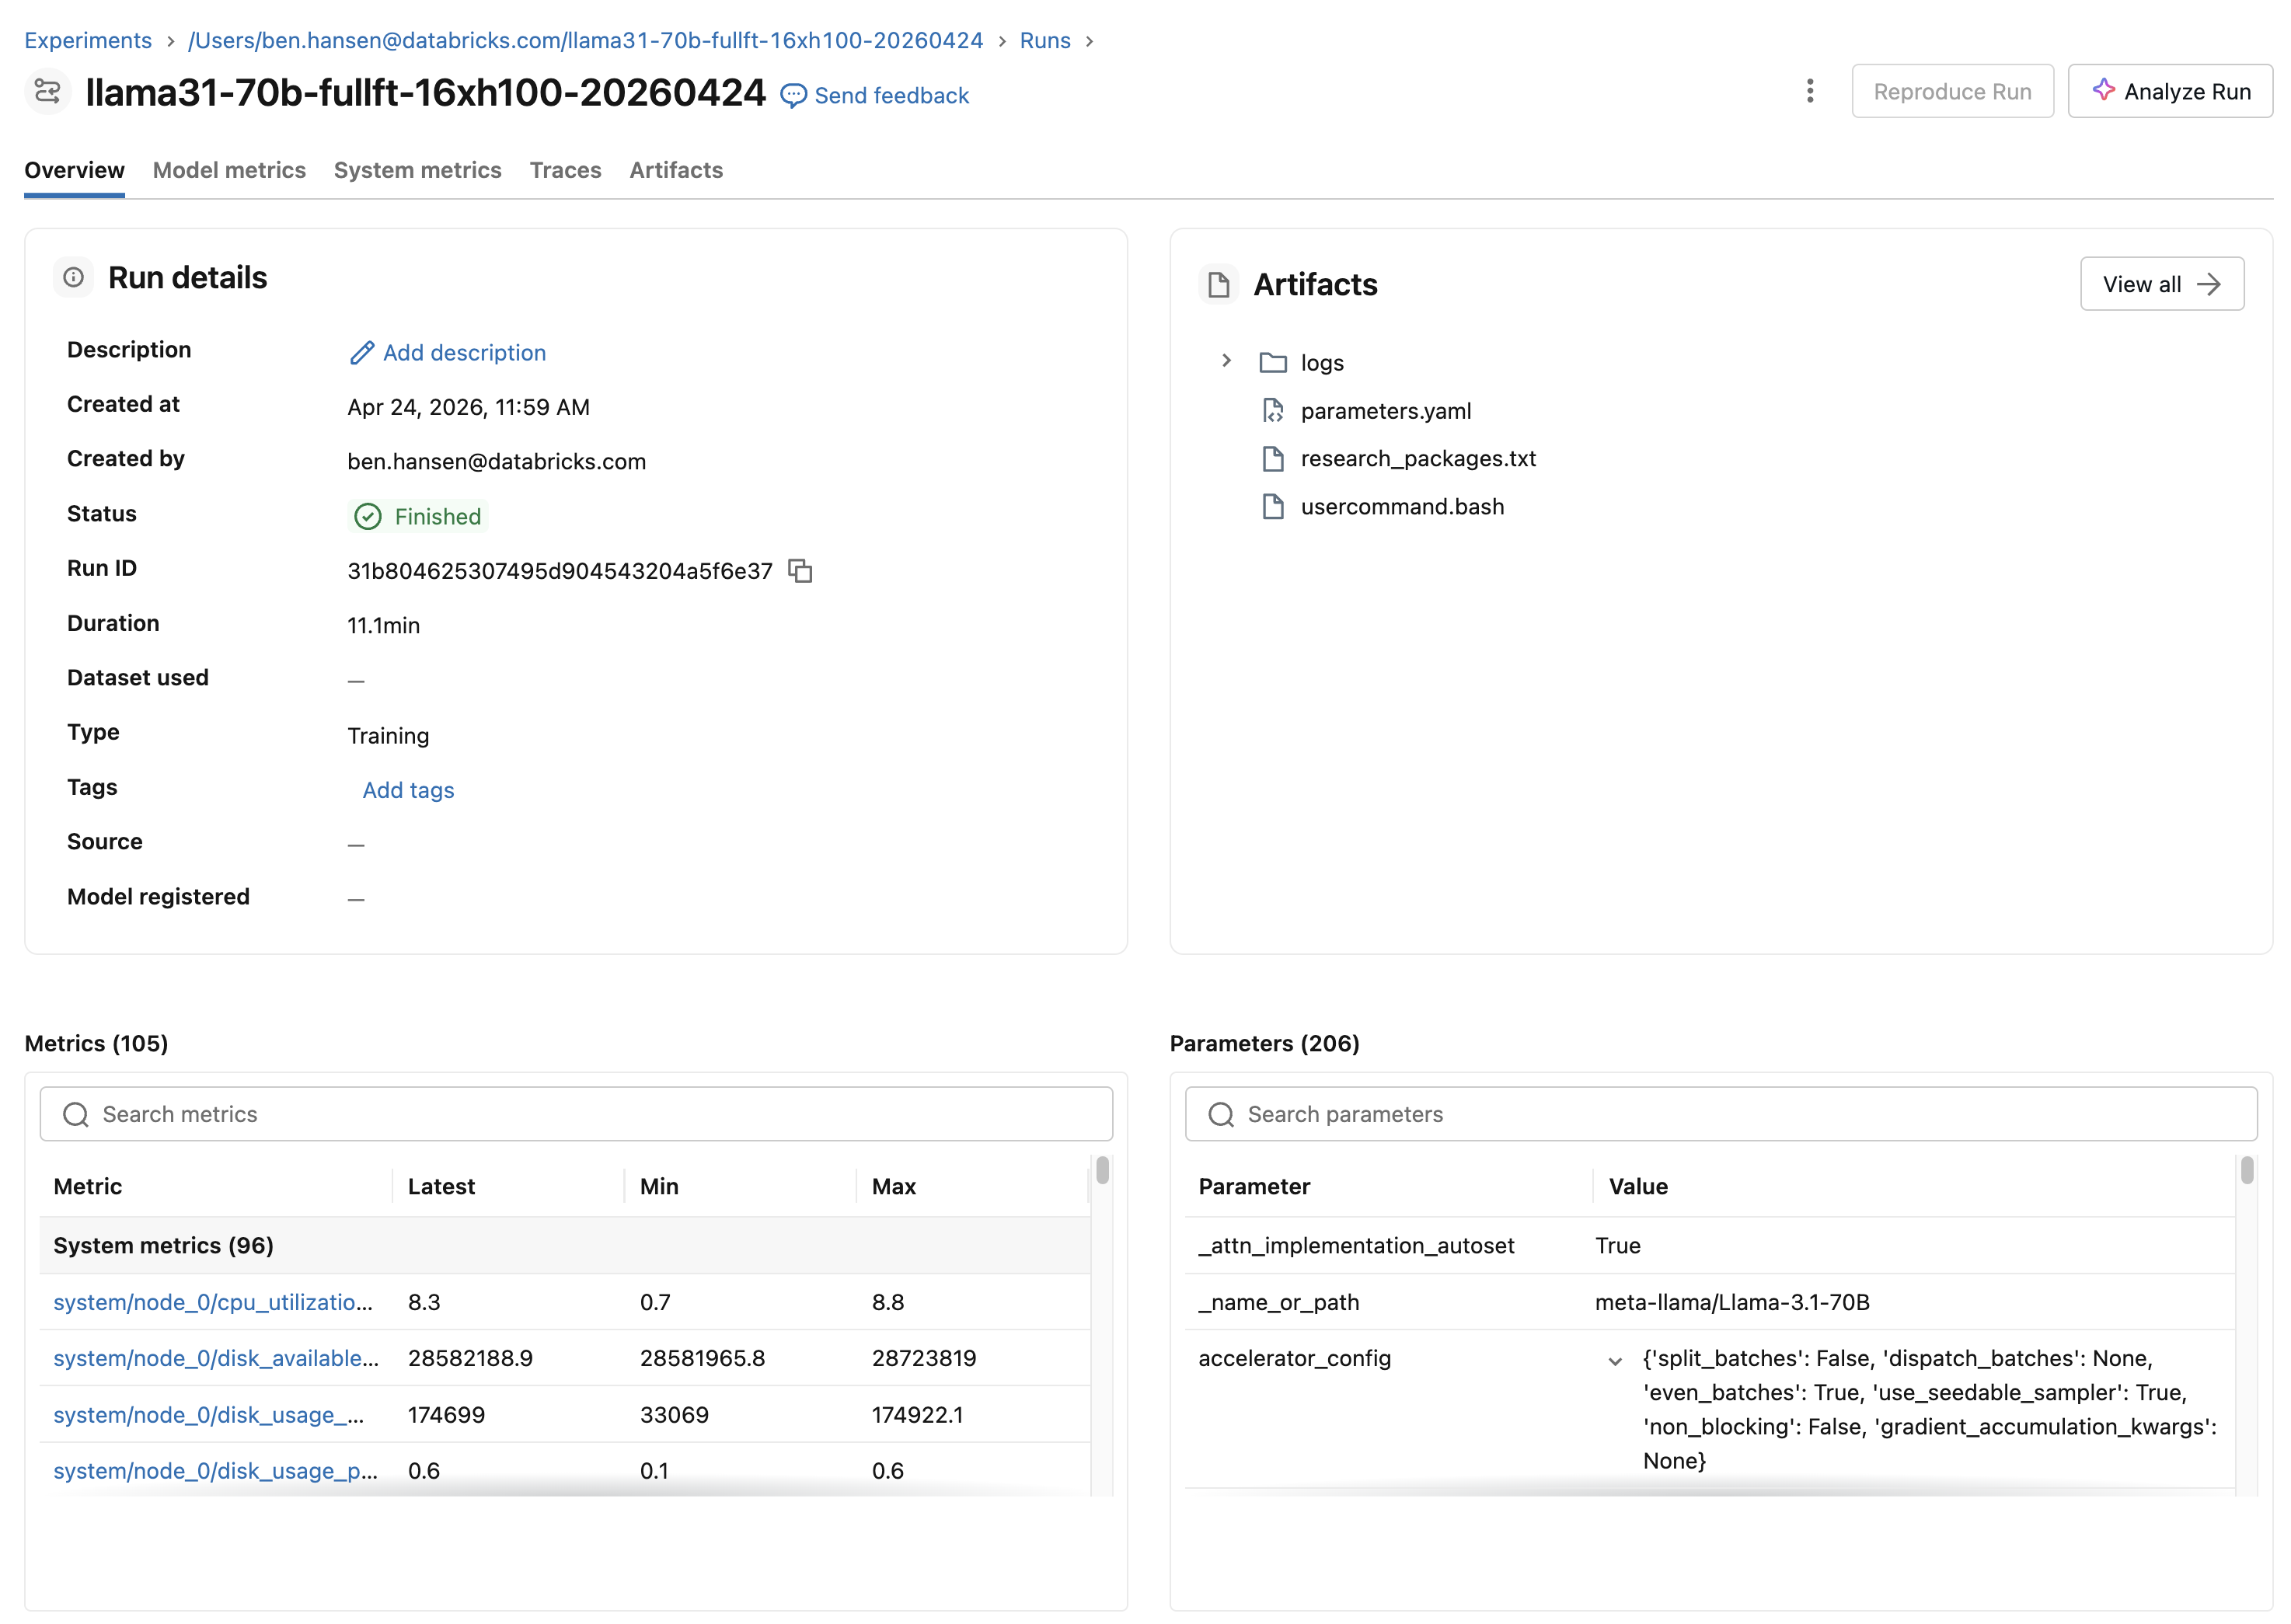
air runを使用して送信する各ワークロードは、Databricks のジョブランおよび MLflow ランの両方になります。
- ジョブラン(ワークスペースの ジョブ & パイプライン ページで確認可能)は、ステータス、コンピュート、再試行、ドライバー出力などの実行を追跡します。
- MLflowランは、エクスペリメント(パラメーター、メトリクス、システム メトリクス、アーティファクト)を追跡します。
1 回のサブミッションで 1 つのジョブランと 1 つの MLflow ランが作成されます。再試行によって新しい MLflow ランが作成されます。
エクスペリメントとラン
次のワークロード YAML フィールドによって、MLflow のエクスペリメント、ラン、およびアーティファクト ストレージが制御されます。
experiment_name: my-training # Creates or appends to this MLflow experiment
mlflow_run_name: baseline-lr3e5 # Names the MLflow run for this submission
# Stores artifacts in a UC volume
mlflow_artifact_location: /Volumes/main/default/mlflow-artifacts/my-training
compute:
  num_accelerators: 8
  accelerator_type: GPU_8xH100
command: torchrun --nproc_per_node=8 train.py
max_retries: 2
experiment_name(必須):指定した名前のエクスペリメントが存在しない場合は作成し、存在する場合は既存のエクスペリメントに新しいランを追加します。1つのエクスペリメントには多くのランが含まれます。mlflow_run_name(オプション):ラン名を設定します。省略した場合、ラン名はdefaultでエクスペリメント名(experiment_name)になります。mlflow_artifact_location(オプション): アーティファクトのルートロケーションを設定します。省略した場合、新しいエクスペリメントでは default DBFS ロケーションが使用され、既存のエクスペリメントではexperiment_nameに関連付けられたロケーションが使用されます。Unity Catalog ボリュームの場合は、/Volumes/<catalog>/<schema>/<volume>/...を使用します。既存のエクスペリメントの場合、指定するロケーションはエクスペリメントのアーティファクトの場所と一致しているか、省略されている必要があります。max_retries(オプション):各再試行は同じエクスペリメントにおける新しい MLflow ランとなるため、試行を比較できます。元の送信と再試行は、1 つのジョブランを共有します。
Jobs、MLflow、および以前のワークロードの間で切り替えます
3 つの場所からランにアクセスできます:
- Jobs :Jobs の実行ページには実行一覧が表示され、各ランから対応する MLflow のランとエクスペリメントにリンクできます。
- MLflow :エクスペリメントページには、MLflowエクスペリメントが一覧表示されます。
- Previous workloads :
air get run <job-run-id>は、ランのジョブ、エクスペリメント、およびMLflowランへのクリック可能なLinkを表示します。air list runsには過去のランの一覧が表示され、特定のランをフィルタリングして見つけることができます。
air get run <job-run-id> # Links to the job, experiment, and MLflow run
air list runs # List previous runs; filter to find a specific run
システムメトリクス
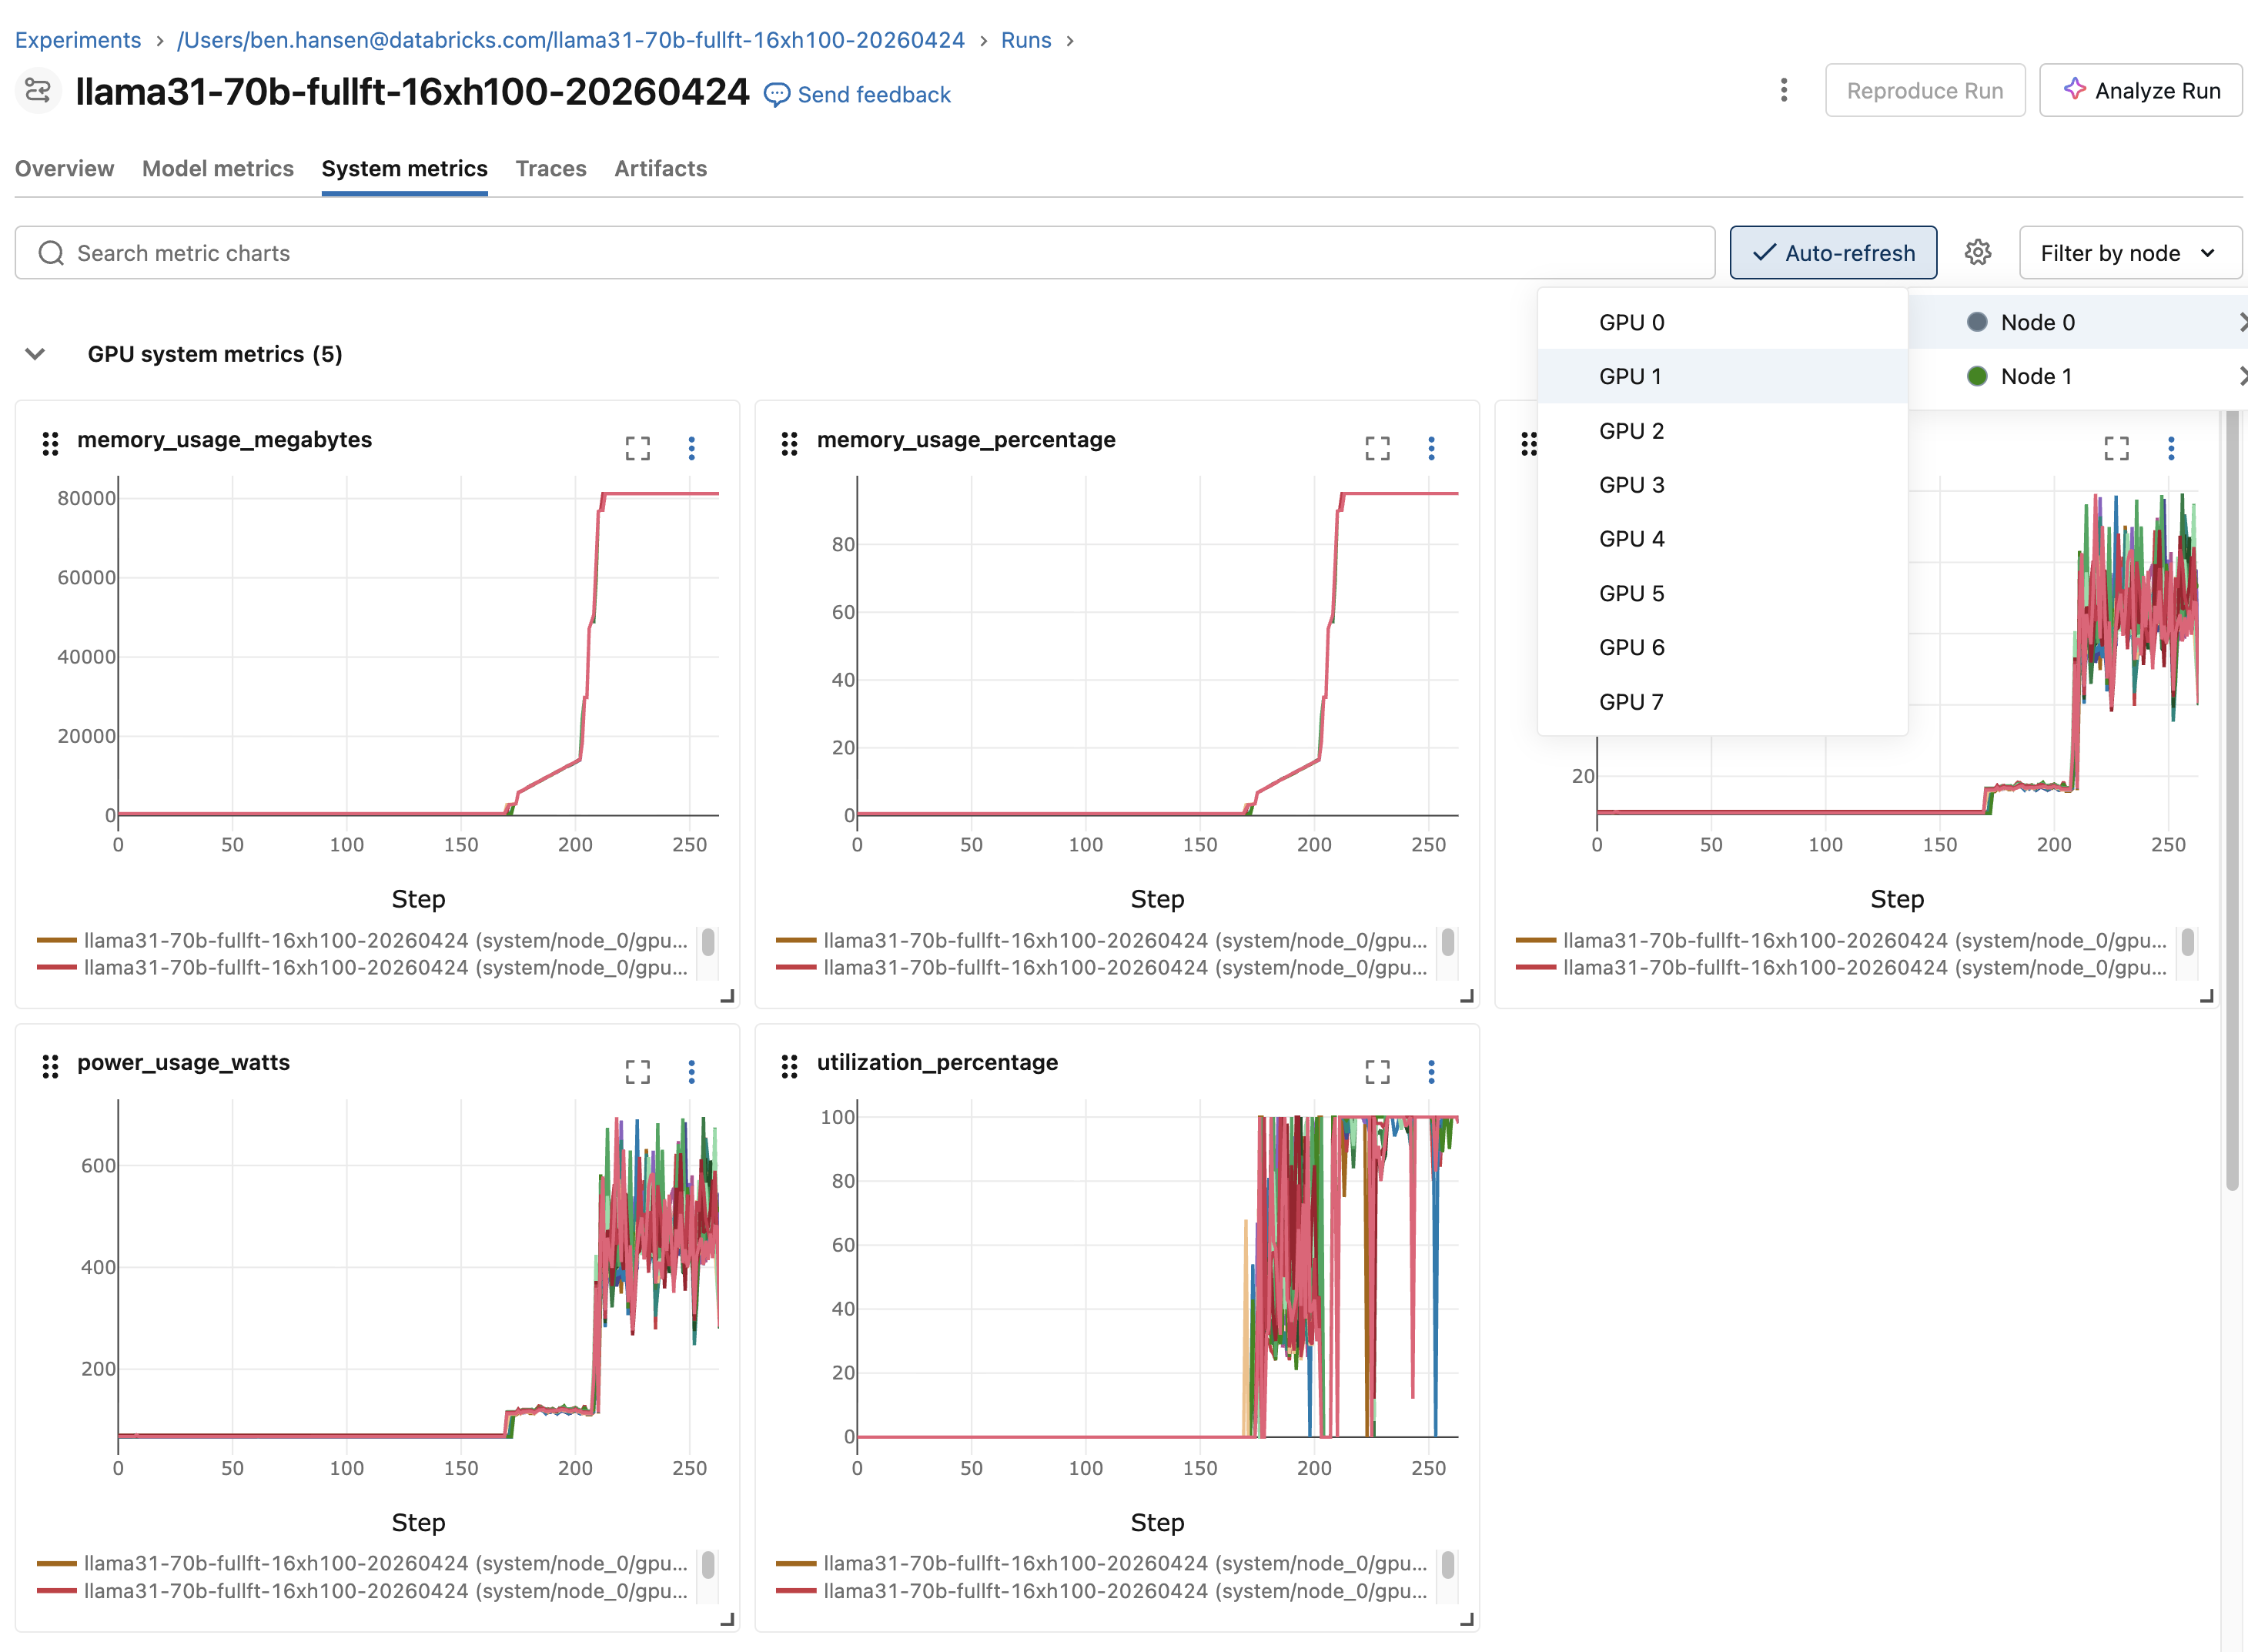
GPU、CPU、およびメモリのシステムメトリクスは、すべてのランで自動的に取得されます。設定は必要ありません。これらは、MLflow ランの System メトリクス tab で表示できます。
Log custom メトリクス
プラットフォームは MLflow ランを作成し、MLFLOW_RUN_ID 環境変数を介してその ID をトレーニングプロセスに公開します。MLflow tracking API を使用して、独自のパラメーター、メトリクス、およびアーティファクトをそのランにLogに記録します。
分散(マルチノード)ワークロードでは、すべてのノードが同じ MLflow ランを共有します。ランク0のプロセスからのみ Log を出力し、各メトリクスが一度だけ記録されるようにします:
import os

import mlflow

# Log from rank 0 only; all nodes share the same MLFLOW_RUN_ID.
if os.environ.get("RANK", "0") == "0":
    with mlflow.start_run(run_id=os.environ["MLFLOW_RUN_ID"]):
        mlflow.log_param("learning_rate", 3e-4)
        for step, loss in enumerate(training_losses):
            mlflow.log_metric("train_loss", loss, step=step)
Logsとアーティファクト
air logs を使用してランのLogsをストリームまたはdownloadします:
air logs <job-run-id> # Stream logs from node 0
air logs <job-run-id> --node 2 # Logs from a specific node
air logs <job-run-id> --download-to ./logs/ # Download instead of streaming
Logs は、MLflow ランのアーティファクトとしても利用できます。モデルのチェックポイントを永続化するには、それらを Unity Catalog ボリュームに書き込みます。チェックポイント パターンとボリュームの管理については、エクスペリメントの追跡と観察可能性を参照してください。