レガシ Python CLI でランを追跡する
このドキュメントは廃止されており、更新されない可能性があります。
databricks-air パッケージでインストールされる Python ベースの air CLI は現在廃止されており、アクティブにメンテナンスされていません。
新しいワークロードには Databricks CLI を使用してください。AI ランタイム での Databricks CLI の使用を参照してください。
air run で送信する各ワークロードは、Databricks ジョブ ランと MLflow ランの両方です。
- ジョブ実行(ワークスペースの [ジョブとパイプライン] ページで確認可能)は、ステータス、コンピュート、再試行、ドライバーの出力といった実行状況を追跡します。
- MLflowのランは、パラメーター、メトリクス、システムメトリクス、アーティファクトといったエクスペリメントを追跡します。
1 回のサブミッションで 1 回のジョブ ランと 1 回の MLflow ランが作成されます。再試行のたびに新しいMLflowランが作成されます。
エクスペリメントとラン
次の Workload YAML フィールドは、MLflow エクスペリメント、ラン、およびアーティファクト ストレージを制御します。
experiment_name: my-training # Creates or appends to this MLflow experiment
mlflow_run_name: baseline-lr3e5 # Names the MLflow run for this submission
# Stores artifacts in a UC volume
mlflow_artifact_location: /Volumes/main/default/mlflow-artifacts/my-training
compute:
  num_accelerators: 8
  accelerator_type: GPU_8xH100
command: torchrun --nproc_per_node=8 train.py
max_retries: 2
experiment_name(必須):指定した名前のエクスペリメントが存在しない場合は新規作成し、存在する場合は既存のエクスペリメントに新しいランを追加します。エクスペリメントには多くのランが含まれます。mlflow_run_name(オプション)ラン名を設定します。省略した場合、ラン名はdefaultでエクスペリメント名 (experiment_name) になります。mlflow_artifact_location(任意): アーティファクトのルートの場所を設定します。省略された場合、新しいエクスペリメントは default DBFS ロケーションを使用し、既存のエクスペリメントはexperiment_nameに関連付けられたロケーションを使用します。Unity Catalog ボリュームの場合、/Volumes/<catalog>/<schema>/<volume>/...を使用します。既存のエクスペリメントの場合、指定された場所はエクスペリメントのアーティファクトの場所と一致しているか、省略されている必要があります。max_retries(オプション):各再試行は同じエクスペリメントにおける新しい MLflow ランであるため、試行を比較できます。元のサブミッションとその再試行は、1 つのジョブランを共有します。

Jobs、MLflow、および以前のワークロード間を移動します
ランは、次の3つの場所から取得できます。
- ジョブ : [ラン] 実行ページにはランが一覧表示され、各ランはMLflowランとエクスペリメントにLink。
- MLflow : エクスペリメントページには、MLflow エクスペリメントがリストされます。
- 以前のワークロード :
air get run <job-run-id>ランのジョブ、エクスペリメント、MLflowランのクリック可能なLinkを表示します。air list runsには以前のランが一覧表示され、特定のランを検索するためにフィルタリングすることができます。
air get run <job-run-id> # Links to the job, experiment, and MLflow run
air list runs # List previous runs; filter to find a specific run
システムメトリクス
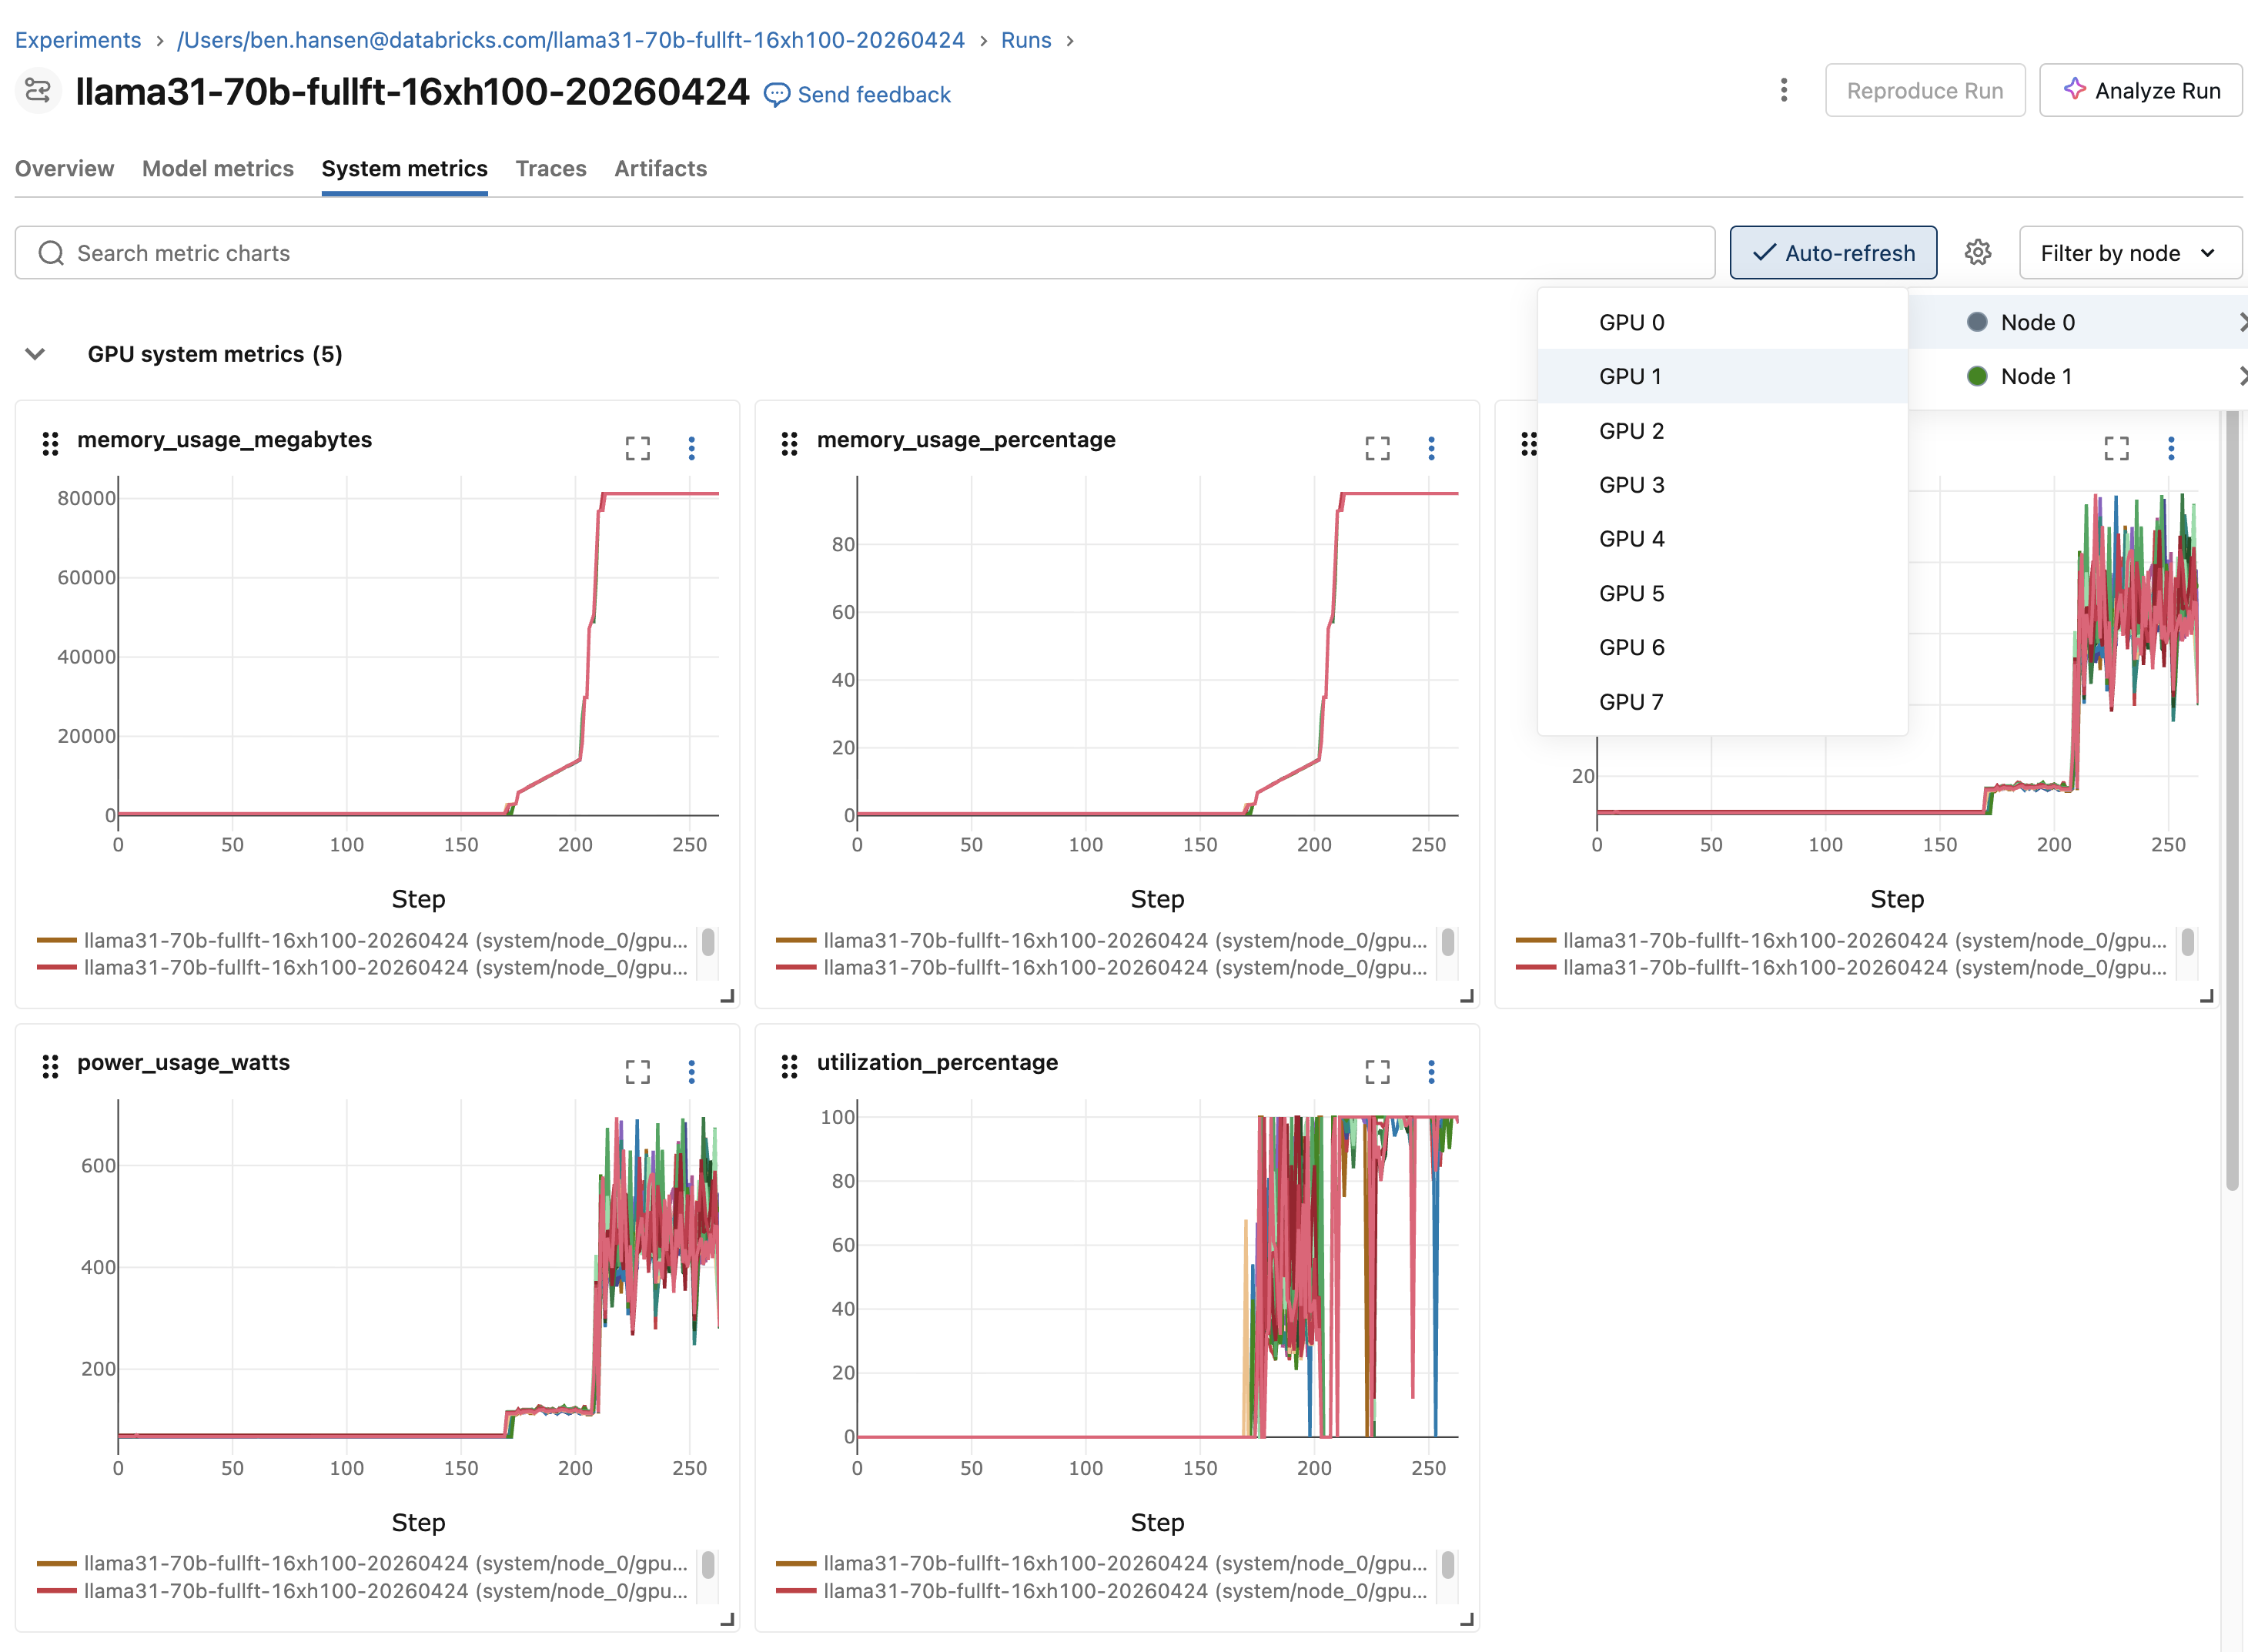
GPU、CPU、およびメモリのシステム メトリクスは、すべてのランで自動的にキャプチャされます。設定は不要です。MLflow ランの システム メトリクス tabでこれらを表示します。
カスタムメトリクスのログ記録
プラットフォームはMLflowランを作成し、 MLFLOW_RUN_ID環境変数を介してトレーニングプロセスにそのIDを公開します。MLflowトラッキングAPI を使用して、独自のパラメーター、メトリクス、アーティファクトをそのランにログに記録します。
分散(マルチノード)ワークロードでは、すべてのノードで同じ MLflow ランが共有されます。ランク0のプロセスからのみログを記録し、各メトリクスが1回だけ記録されるようにします。
import os

import mlflow

# Log from rank 0 only; all nodes share the same MLFLOW_RUN_ID.
if os.environ.get("RANK", "0") == "0":
    with mlflow.start_run(run_id=os.environ["MLFLOW_RUN_ID"]):
        mlflow.log_param("learning_rate", 3e-4)
        for step, loss in enumerate(training_losses):
            mlflow.log_metric("train_loss", loss, step=step)
Logsとアーティファクト
air logs でランのログをストリームまたはdownloadします:
air logs <job-run-id> # Stream logs from node 0
air logs <job-run-id> --node 2 # Logs from a specific node
air logs <job-run-id> --download-to ./logs/ # Download instead of streaming
Logs は MLflow ランのアーティファクトとしても利用できます。モデルのチェックポイントを永続化するには、Unity Catalog ボリュームに書き込みます。チェックポイントのパターンについては、 AI ランタイムでのトレーニングのパフォーマンスと耐障害性の向上を参照してください。