特徴量ビューAPIリファレンス
プレビュー
この機能は パブリック プレビュー段階です。ワークスペース管理者は、 プレビュー ページからこの機能へのアクセスを制御できます。Databricksのプレビューを管理するを参照してください。
アクセス制御
特徴量は、ガバナンス可能な Unity Catalog オブジェクトです。特徴量へのアクセスは、CREATE FEATURE、READ FEATURE、および MANAGE の Unity Catalog 権限によって制御されます。詳細については、Unity Catalog 権限のリファレンスを参照してください。
CREATE FEATURE: Required to create a feature in a schema.create_featureandregister_featurerequireCREATE FEATUREon the parent schema.Following the principle of least privilege, grantCREATE FEATUREat the schema level; you can also grant it on a catalog to allow creating features in any schema in that catalog.READ FEATURE: フィーチャのメタデータを読み取るために必要です。get_feature、create_training_set、およびlist_materialized_featuresでは、フィーチャに対してREAD FEATUREが必要です。この権限では、ソースまたはマテリアライズド出力テーブル内のフィーチャデータへのアクセスは付与されません。トレーニングやサービングのためにそのデータを読み取るには、該当するテーブルに対するSELECTも必要です。スキーマまたはカタログで付与されたREAD FEATUREは、そのスキーマまたはカタログに含まれる現在および将来のすべてのフィーチャに適用されます。MANAGE: 特徴量のライフサイクルと権限を管理するために必要です。delete_featureによる特徴量の削除と、materialize_featuresによる特徴量のマテリアライズには、その特徴量に対するMANAGEが必要です。delete_materialized_featureを使用したマテリアライズされた特徴量の削除はMANAGEの管理対象外であり、マテリアライズされた特徴量の作成者のみが削除できます。
すべての特徴量操作には、親カタログに対するUSE CATALOGと親スキーマに対するUSE SCHEMAも必要です。MANAGEとREAD FEATUREがマテリアライズに適用される方法については、権限を参照してください。
特徴量ビューAPI
Feature コンストラクタと register_feature()
推奨されるアプローチは、Featureオブジェクトをローカルで構築し、register_featureを使用してUnity Catalogに永続化することです。この2段階のワークフローでは、特徴量(create_training_setを含む)を登録する前に試すことができます。
Feature(
    source: DataSource,                                    # Required: DeltaTableSource, StreamSource, RequestSource, or FeatureViewSource
    function: Union[AggregationFunction, ColumnSelection, CustomUDF], # Required for all features
    entity: Optional[List[str]] = None,                    # Required for DeltaTableSource and StreamSource
    timeseries_column: Optional[str] = None,               # Required for DeltaTableSource and StreamSource
    name: Optional[str] = None,                            # Optional: Feature name (auto-generated if omitted)
    description: Optional[str] = None,                     # Optional: Feature description
)
FeatureEngineeringClient.register_feature() ローカルで構築された Feature を Unity Catalog に登録する。
FeatureEngineeringClient.register_feature(
    feature: Feature,       # Required: A Feature instance (not already registered)
    catalog_name: str,      # Required: UC catalog name
    schema_name: str,       # Required: UC schema name
) -> Feature
from databricks.feature_engineering.entities import Feature, DeltaTableSource, AggregationFunction, Sum, RollingWindow
from datetime import timedelta

# Step 1: Construct the feature locally
feature = Feature(
    source=DeltaTableSource(catalog_name="main", schema_name="store", table_name="transactions"),
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)

# Step 2: Register in Unity Catalog
fe = FeatureEngineeringClient()
registered_feature = fe.register_feature(
    feature=feature,
    catalog_name="main",
    schema_name="store",
)
create_feature()
FeatureEngineeringClient.create_feature() 単一のステップで、Unity Catalog内の機能を検証、構築し、すぐに登録します。最初にローカルで機能のエクスペリメントをする必要がない場合、これを使用します。
FeatureEngineeringClient.create_feature(
    source: DataSource,                                    # Required: DeltaTableSource, StreamSource, RequestSource, or FeatureViewSource
    function: Union[AggregationFunction, ColumnSelection, CustomUDF], # Required for all features
    catalog_name: str,                                     # Required: The catalog name for the feature
    schema_name: str,                                      # Required: The schema name for the feature
    entity: Optional[List[str]] = None,                    # Required for DeltaTableSource and StreamSource
    timeseries_column: Optional[str] = None,               # Required for DeltaTableSource and StreamSource
    name: Optional[str] = None,                            # Optional: Feature name (auto-generated if omitted)
    description: Optional[str] = None,                     # Optional: Feature description
) -> Feature
パラメーター:
source:特徴量計算で使用されるデータソース(DeltaTableSource、StreamSource、RequestSource、またはFeatureViewSource)。function: オペレーターと時間枠をバンドルするAggregationFunction、パススルー特徴量のColumnSelection("column_name")、または行ごとの変換のCustomUDF。互換性のあるソースタイプについては、サポートされている関数を参照してください。catalog_name特徴量に対するUnity Catalogのカタログ名。schema_name:特徴量のUnity Catalogスキーマ名です。entity集計キーまたは検索キー(プライマリキー)を定義する列名のリスト。DeltaTableSourceおよびStreamSourceに必要です。たとえば、["user_id"]はユーザーごとに集計または検索を行います。RequestSourceおよびFeatureViewSourceでは省略します。timeseries_column:時間ウィンドウ集計または最新値の選択に使用される Timestamp 列。DeltaTableSourceおよびStreamSourceに必要です。RequestSourceおよびFeatureViewSourceでは省略します。name:任意の機能名。省略した場合、入力列、関数、およびウィンドウから自動生成されます(例:amount_avg_rolling_7d)。description:特徴量のオプションの説明。
戻り値: 検証済みの特徴量インスタンス
発生: いずれかの検証が失敗した場合、ValueErrorが発生します。
delete_feature()
Unity Catalogから、その完全修飾名で特徴量を削除します。
FeatureEngineeringClient.delete_feature(
    full_name: str,  # Required: '<catalog>.<schema>.<feature_name>'
) -> None
fe.delete_feature(full_name="main.store.amount_sum_rolling_7d")
機能を削除する前に、それを参照しているモデルやfeature specを削除または更新してください。マテリアライズされた特徴量が残っている間は、機能を削除できません。最初にマテリアライズされた特徴量を削除してから、機能を削除してください。How to delete a materialized featureを参照してください。
自動生成された名前
nameが省略されている場合、名前は自動的に生成されます。生成される名前はパターン:{column}_{function}_{window}に従います。例えば:
price_avg_rolling_1h(1時間あたりの平均価格)transaction_count_rolling_30d_1d(イベントの Timestamp からの 1 日遅延を伴う 30 日間のトランザクション数)
サポートされている関数
集計関数
集計関数は、時間ウィンドウに記載されているように、時間ウィンドウと共に AggregationFunction でラップされています。各関数は、集計するソース列を指定する input パラメーターを受け取ります。
関数 | 説明 | 使用例 |
|---|---|---|
| 値の合計 | ユーザーごとの1日のアプリ使用量 (単位: 分) |
| 平均値 | 平均トランザクション額 |
| レコード数 | ユーザーあたりのログイン数 |
| 最小値 | ウェアラブルデバイスによって記録された最低心拍数 |
| 最大値 | セッションあたりの最大トランザクション量 |
| 母集団標準偏差 | すべての顧客における日次取引額の変動 |
| サンプル標準偏差 | 広告キャンペーンのクリック率の変動性 |
| 母集団分散 | 工場におけるIoTデバイスのセンサー読み取り値の分散 |
| サンプルバリアンス | サンプリングされたグループ全体での映画の評価の広がり |
| おおよそのユニークカウント | 購入されたアイテムの個別カウント |
| 近似パーセンタイル | p95 応答レイテンシ |
| 最初の値 | 最初のログインTimestamp |
| 最後の値 | 最新の購入額 |
| 配列としての最初の | セッションで閲覧された最初の3つの製品 |
| 配列としての最後の | 最新のサポートケースステータス3件 |
| 配列としての最初の | 閲覧された最初の3つの個別の製品カテゴリ |
| 配列としての最後の | 最新の3件の個別の加盟店カテゴリ |
First、Last、FirstN、LastN、FirstDistinct、および LastDistinct は、defaultでNull値を含みます。Null値をスキップするには、Nullである入力列を明示的に除外する filter_condition を追加します。
FirstN、LastN、FirstDistinct、および LastDistinct は、特徴量の timeseries_column を使用して入力行を順序付けし、最大 n 個の値を含む配列を返します。n パラメーターには正の整数を指定する必要があります。FirstN および FirstDistinct は、最も古いものから最新のものへと値を選択します。LastN および LastDistinct は、最新から最も古い順に値を選択し、選択した値をTimestamp順に返します。FirstDistinct および LastDistinct は、その方向に値を選択しながら重複する値を削除します。
例えば、エンティティのソース行が event_time によって ["A", "A", "B", "C", "B", "B"] として順序付けられている場合、以下の関数は次を返します。
関数 | 結果 |
|---|---|
|
|
|
|
|
|
|
|
FirstN、LastN、FirstDistinct、および LastDistinct には、databricks-feature-engineering バージョン 0.17.0 以降が必要です。
カスタムUDF
CustomUDF 登録済みの Unity Catalog Python ユーザー定義関数 (UDF) を各行に適用します。これを使用して、リクエスト入力を変換するか、特徴量を組み合わせます。行を集計したり、時間枠を定義したりしません。
CustomUDF(
    function_name="main.ecommerce.log_amount_udf",
    input_bindings={"amount": "transaction_amount"},
)
input_bindings 各 UDF パラメーター名をインプットにマップします。RequestSourceの場合、入力はソース列名です。FeatureViewSourceについては、上流の機能参照です。default値を持つパラメーターを含め、すべての UDF パラメーターをバインドします。暗黙的な数値キャストを行わずに、入力タイプが UDF パラメーターのタイプと完全に一致している必要があります。スカラー入力と戻り値のタイプを使用します。
ソース | 挙動 |
|---|---|
| トレーニング DataFrame または推論リクエストの列を変換します。 |
| 上流の特徴量値を結合します。「FeatureViewSource」を参照してください。 |
Delta をバックアップとした CustomUDF の特徴量は、マテリアライズまたはオンラインサービングを行うことができません。トレーニングとサービングのためにテーブルをバックアップとした特徴量値を変換するには、Delta をバックアップとした集計または列選択の特徴量を定義し、FeatureViewSource を介してそれを参照します。
CustomUDF StreamSourceではサポートされていません。ストリーミング特徴量の出力を変換するには、FeatureViewSource を介してその特徴量を参照します。
CustomUDF RequestSource を使用するには、databricks-feature-engineering バージョン 0.17.0 以降が必要です。
CustomUDFを使用するには、UDFに対するEXECUTE権限、その親カタログに対するUSE CATALOG権限、およびその親スキーマに対するUSE SCHEMA権限が必要です。
次の例では、NumPy を使用して log(1 + amount) をコンピュートし、大規模なトランザクション金額のスケールを削減します。カスタム UDF 依存関係を有効にして、Serverless コンピュート上で実行します。main.ecommerce スキーマが存在している必要があります。
spark.sql("""
CREATE OR REPLACE FUNCTION main.ecommerce.log_amount_udf(amount DOUBLE)
RETURNS DOUBLE
LANGUAGE PYTHON
ENVIRONMENT (
  dependencies = '["numpy==1.26.4"]',
  environment_version = '5'
)
AS $$
import numpy as np

if amount is None or not np.isfinite(amount) or amount < 0:
    return None
return float(np.log1p(amount))
$$
""")
リクエスト列 transaction_amount を UDF パラメーター amount にバインドする特徴量を登録する:
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    CustomUDF, FieldDefinition, RequestSource, ScalarDataType,
)

fe = FeatureEngineeringClient()

log_transaction_amount = fe.create_feature(
    source=RequestSource(
        schema=[
            FieldDefinition(name="transaction_amount", data_type=ScalarDataType.DOUBLE),
        ]
    ),
    function=CustomUDF(
        function_name="main.ecommerce.log_amount_udf",
        input_bindings={"amount": "transaction_amount"},
    ),
    catalog_name="main",
    schema_name="ecommerce",
    name="log_transaction_amount",
)
UDF の ENVIRONMENT は、オフライン計算の依存関係を構成します。オンラインサービングの場合は、create_feature_spec(extra_pip_requirements=...) または log_model(extra_pip_requirements=...) でもパッケージを宣言してください。これらは UDF から自動的にはコピーされません。Feature Serving の依存関係およびモデルの依存関係をご覧ください。
CustomUDF 特徴量をマテリアライズすることはできません。リクエストバックおよび特徴量バックの UDF は、トレーニングおよびサービング中にオンデマンドで実行されます。依存関係チェーン内の各 UDF はコンピュートを追加するため、関数とチェーンは小さく保ってください。UDF は、オフラインで None またはオンラインで NaN になる可能性がある、欠落した入力を処理する必要があります。
欠損値の処理に関するガイダンスについては、欠損している特徴量の値を処理する方法を参照してください。
ColumnSelection(パススルー)
ColumnSelection 集計を適用せずにソースから単一の列を選択します。それは直接 function パラメーターにラップされています(AggregationFunction の中ではありません)。戻り値の型はソーススキーマから推論されます。
関数 | 説明 | 使用例 |
|---|---|---|
| 列の最新値(集計なし) | 最新のベンダーカテゴリ、リクエストフィールドのパススルー |
ColumnSelection は次のデータソースをサポートしています。
DeltaTableSource:時点結合によりエンティティキーごとに最新の値を返します(ルックバックウィンドウ集計なし)。StreamSource: ストリームからエンティティキーごとの最新の値を返します(ルックバック期間の集計は行われません)。RequestSource** **:推論時に提供された値(またはトレーニング時にラベル付けされたDataFrameから抽出された値)を渡します。
DeltaTableSourceの場合、ColumnSelectionの特徴量は、最新値の選択の前に適用されるfilter_conditionおよびtransformation_sqlをサポートします(集計特徴量と同じ)。
from databricks.feature_engineering.entities import (
    ColumnSelection, DeltaTableSource, Feature, FieldDefinition,
    RequestSource, ScalarDataType,
)

delta_source = DeltaTableSource(
    catalog_name="main", schema_name="feature_store", table_name="transactions",
)

request_source = RequestSource(
    schema=[
        FieldDefinition(name="session_duration", data_type=ScalarDataType.DOUBLE),
    ]
)

# ColumnSelection from a Delta table
latest_amount = Feature(
    source=delta_source,
    function=ColumnSelection("amount"),
    entity=["user_id"],
    timeseries_column="transaction_time",
    name="latest_transaction_amount",
)

# ColumnSelection from a RequestSource
session_feature = Feature(
    source=request_source,
    function=ColumnSelection("session_duration"),
    name="session_duration",
)
例:集計と列選択機能
次の例では、同じデータソースに対して定義された機能を示します。
from databricks.feature_engineering.entities import (
    AggregationFunction, Feature, Sum, Avg, ApproxCountDistinct,
    ColumnSelection, RollingWindow,
)
from datetime import timedelta

window = RollingWindow(window_duration=timedelta(days=7))

sum_feature = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(Sum(input="amount"), window),
)

avg_feature = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(Avg(input="amount"), window),
)

distinct_count = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(ApproxCountDistinct(input="product_id", relativeSD=0.01), window),
)

# Column selection (no aggregation, no time window)
latest_amount = Feature(
    source=source,
    function=ColumnSelection("amount"),
    entity=["user_id"],
    timeseries_column="event_time",
    name="latest_amount",
)
フィルター条件を持つ機能
filter_condition パラメーターを使用すると、集計の計算や最新の列値の選択を行う 前に 、ソーステーブルから行をフィルター処理できます。これは、データのグループ化および集計の前に適用される SQL の WHERE 句として機能します。
集計機能の場合、filter_conditionは、GROUP BYの前に適用されるSQL WHERE句のように、集計前に行をフィルター処理します。これにより、粒度が変更されることはありません。粒度は常に、特徴量定義のentityによって定義されます。
フィルターは、特徴量コンピュテーションに必要なデータのスーパーセットを含む大規模なソーステーブルを扱う際に役立ち、これらのテーブル上に個別のビューを作成する必要性を最小限に抑えます。
from databricks.feature_engineering.entities import AggregationFunction, Sum, Count, RollingWindow, DeltaTableSource
from datetime import timedelta

# Source with filter applied at the source level
high_value_transactions = DeltaTableSource(
    catalog_name="main",
    schema_name="ecommerce",
    table_name="transactions",
    filter_condition="amount > 100",  # Only transactions over $100
)

high_value_sales = Feature(
    source=high_value_transactions,
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=30))),
)

# Multiple conditions
completed_orders_source = DeltaTableSource(
    catalog_name="main",
    schema_name="ecommerce",
    table_name="orders",
    filter_condition="status = 'completed' AND payment_method = 'credit_card'",
)

completed_orders = Feature(
    source=completed_orders_source,
    entity=["user_id"],
    timeseries_column="order_time",
    function=AggregationFunction(Count(input="order_id"), RollingWindow(window_duration=timedelta(days=7))),
)

# Filter on a StreamSource
from databricks.feature_engineering.entities import StreamSource

purchase_stream = StreamSource(
    full_name="main.ecommerce.transactions_stream",
    filter_condition="value.event_type = 'purchase'",
)

purchase_total = Feature(
    source=purchase_stream,
    entity=["value.user_id"],
    timeseries_column="value.event_time",
    function=AggregationFunction(Sum(input="value.amount"), RollingWindow(window_duration=timedelta(hours=1))),
)
データソース
DeltaTableSource
DeltaTableSource ソーステーブルから特徴量がどのように計算されるかを定義するために使用される、一時的なPythonオブジェクトです。新しいテーブルは作成されません。データの読み取りと特徴量の集計のための設定を指定します。
DeltaTableSource(
    catalog_name: str,                              # Required: Catalog name
    schema_name: str,                               # Required: Schema name
    table_name: str,                                # Required: Table name
    filter_condition: Optional[str] = None,         # Optional: SQL WHERE clause to filter source data
    transformation_sql: Optional[str] = None,       # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,         # Required if transformation_sql is set: schema of the resulting DataFrame
    lateness: Optional[SourceLateness] = None,       # Optional: Expected source settling time
)
パラメーター:
catalog_name、schema_name、table_name:Unity CatalogのソースDeltaテーブルを識別します。filter_condition:集計または列の選択の前に適用されるSQLWHERE句。例:"status = 'completed'"。transformation_sqlソーステーブルに適用される SQLSELECT式。集計や列の選択の前に、これを使用して列の名前の変更、型のキャスト、または派生列のコンピュートを行います。省略した場合は、すべての列が選択されます(*)。例:"user_id, CAST(amount AS DOUBLE) AS amount, event_time"。dataframe_schema:変換後の結果のDataFrameのスキーマ。Spark StructType JSON形式(df.schema.json()から)。transformation_sqlが提供されている場合、必須です。 これは、変換によって生成される列名と型をシステムに伝えます。lateness:イベント時間において、ソースが完全に揃うまでに通常かかる時間を記述するSourceLatenessオブジェクト。省略した場合、ソースは即座に完了したと見なされます。
filter_condition と transformation_sql の両方が設定されている場合、結果のクエリーは次のようになります:SELECT {transformation_sql} FROM {table} WHERE {filter_condition}。
SourceLateness.settling_delay は、オンラインのマテリアライズベーションに影響を与える一貫したETLの遅延をトレーニング中にシミュレートするための推奨される方法です。Databricks は、トレーニングデータがオンラインでまだ転送中であったデータを使用しないように、該当するトレーニング評価時間をこの期間だけ後方にシフトします。マテリアライズベーション中、Databricksは完了したウィンドウをパブリッシュする前に同じ期間待機し、その間の期間中は最後に完了したウィンドウを提供します。
たとえば、深夜0時が協定世界時(UTC)の07:00に対応するローカルタイムゾーンにおいて、日次ETLジョブが深夜0時の8時間後に完了すると仮定します。セトリング遅延を 8 時間、ウィンドウオフセットを 7 時間に設定します。
from datetime import timedelta
from databricks.feature_engineering.entities import (
    DeltaTableSource,
    SourceLateness,
    TumblingWindow,
)

source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    lateness=SourceLateness(settling_delay=timedelta(hours=8)),
)

window = TumblingWindow(
    window_duration=timedelta(days=1),
    offset=timedelta(hours=7),
)
timeseries_column の型は TimestampType または TimestampNTZType である必要があります。DateType は時系列ではサポートされていません。最初にカラムを TimestampType にキャストしてください(例:transformation_sql を使用)。
例:列の変換に transformation_sql を使用する
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="raw_events",
    transformation_sql="user_id, CAST(price_cents AS DOUBLE) / 100 AS price, event_time",
    filter_condition="event_type = 'purchase'",
    dataframe_schema=spark.sql(
        "SELECT user_id, CAST(price_cents AS DOUBLE) / 100 AS price, event_time FROM main.analytics.raw_events LIMIT 0"
    ).schema.json(),
)
例:PySpark DataFrameからtransformation_sqlとdataframe_schemaを導出する
変換をPySparkクエリーとして記述し、その後、結果のDataFrameからスキーマを抽出できます。
df = spark.sql(f"""
  SELECT user_id, CAST(amount AS DOUBLE) / 100 AS amount_dollars, event_time
  FROM main.analytics.events
  WHERE event_date >= date_sub(current_date(), 7)
  LIMIT 0
""")

# Use df.schema.json() as the dataframe_schema
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    transformation_sql="user_id, CAST(amount AS DOUBLE) / 100 AS amount_dollars, event_time",
    filter_condition="event_date >= date_sub(current_date(), 7)",
    dataframe_schema=df.schema.json(),
)
サポートされているtransformation_sql式
DeltaTableSource および StreamSource 上の transformation_sql にも同じルールが適用されます。
transformation_sql 任意の行単位の式をサポートします。操作は各行に対して独立して評価されます。これらは行数やソースとの1対1の対応関係を変更しません。行単位の式には、列の名前変更、キャスト、算術演算などが含まれます。
SUM()やCOUNT()のような集計など、形状や行数を変更する操作はサポートされていません。代わりに特徴量定義でAggregationFunctionを使用してください。
DeltaTableSource.from_sql()
便宜上、SQLクエリーからDeltaTableSourceを作成できます。このメソッドはクエリーを解析し、テーブル名、transformation_sql、およびfilter_conditionを自動的に抽出します。
DeltaTableSource.from_sql(
    sql: str,                           # Required: SQL SELECT query
    spark: SparkSession,                # Required: active SparkSession (for schema inference)
) -> DeltaTableSource
シンプルなSELECT ... FROM ... [WHERE ...]クエリーのみがサポートされています。複雑なSQL(JOIN、サブクエリー、CTE、UNION)は拒否されます。複雑なクエリーの場合は、transformation_sqlとfilter_conditionでDeltaTableSourceを直接構築します。
from databricks.feature_engineering.entities import (
    AggregationFunction,
    DeltaTableSource,
    Feature,
    Sum,
    TumblingWindow,
)

source = DeltaTableSource.from_sql(
    spark=spark,
    sql=f"SELECT customer_id, event_ts, amount * 2 AS doubled_amount, amount FROM {CATALOG}.{SCHEMA}.{TABLE}",
)

feature = Feature(
    source=source,
    function=AggregationFunction(Sum(input="doubled_amount"), time_window=TumblingWindow(window_duration=timedelta(days=7))),
    entity=["customer_id"], timeseries_column="event_ts",
)
で反復 to_dataframe()
特徴量コンピュテーションに使用されるデータをプレビューするには、source.to_dataframe()を使用します。これは、期待される結果が得られるまでfilter_conditionとtransformation_sqlを反復するのに役立ちます。
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    filter_condition="event_type = 'purchase'",
)

# Preview the filtered source data
source.to_dataframe().display()
エンティティの理解
エンティティ列は、特徴量の集計レベルを定義します。これらはFeatureの定義で指定され、DeltaTableSourceでは指定されません。エンティティが決定するもの:
- データのグループ化方法 :特徴量は、エンティティ値の一意の組み合わせごとに集計されます(SQLの
GROUP BYに類似)。 - 主キー構造 :各一意のエンティティの組み合わせは、コンピュートされた特徴の1行になります。
例:顧客レベルの機能
次のコードは、顧客レベルで特徴量を集計します(顧客ごとに 1 行)。
from databricks.feature_engineering.entities import DeltaTableSource

source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="user_events",
)

Feature(
    source=source,
    entity=["user_id"],                # Features aggregated per user
    timeseries_column="event_time",    # Timestamp for time windows
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)
例:顧客・ストア レベルの特徴量
より詳細なレベルで特徴を集約するには(顧客と店舗の組み合わせごとに1行)、複数のエンティティ列を使用します:
source = DeltaTableSource(
    catalog_name="main",
    schema_name="retail",
    table_name="transactions",
)

Feature(
    source=source,
    entity=["user_id", "store_id"],  # Features aggregated per user-store pair
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)
集計の異なるレベル(例えば、顧客レベルや顧客ストアレベル)で特徴量が必要な場合、特徴量定義で異なるentity値を使用します。異なるエンティティ構成を持つ特徴量間で同じDeltaTableSourceを共有できます。
StreamSource
StreamSource ストリームを参照します。ストリームには、ストリーミングソースの接続、認証、スキーマ、取り込みの設定が含まれています。Kafkaの場合、特徴量定義内のカラム参照は、メッセージのどの部分を読み取るかを示すため、value.またはkey.をプレフィックスとして付ける必要があります。
StreamSource(
    full_name: str,                       # Required: Three-part Stream name (catalog.schema.stream)
    filter_condition: Optional[str] = None,      # Optional: SQL WHERE clause applied before aggregation
    transformation_sql: Optional[str] = None,    # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,      # Required if transformation_sql is set: schema of the resulting DataFrame
    lateness: Optional[SourceLateness] = None,    # Optional: Expected source settling time
)
パラメーター:
full_name:ストリームの完全な3部構成の名前(例:"my_catalog.my_schema.my_stream")。filter_condition(オプション):集計前にストリームデータに適用されるSQLWHERE句で、ドットプレフィックス付きの列参照(例えば、"value.event_type = 'purchase'")を使用します。transformation_sql(オプション): 集計または列選択の前に適用されるSQLSELECT式。keyおよびvalue構造体へのドットプレフィックス参照を使用します。DeltaTableSourceと同じ行単位の式をサポートしています。省略した場合、ソースはすべての列(*)を使用します。dataframe_schema:投影された出力のSparkStructTypeJSONスキーマ。transformation_sqlを設定する場合に必要です。lateness:ストリームがイベント時間内で完了するまでに通常かかる時間を記述するSourceLatenessオブジェクト。SourceLateness.settling_delayを参照してください。
from databricks.feature_engineering.entities import StreamSource

stream_source = StreamSource(
    full_name="my_catalog.my_schema.my_stream",
    filter_condition="value.event_type = 'purchase'",
)
keyおよびvalue構造体を公開するストリームの取り込みテーブルに対してプロジェクションを実行し、dataframe_schemaを導出します。
transformation_sql = (
    "value.amount * value.conversion_rate AS converted_amount, "
    "struct(value.user_id AS user_id, value.event_time AS time) AS event"
)

ingestion_table = "my_catalog.my_schema.events_ingestion"
dataframe_schema = spark.sql(
    f"SELECT {transformation_sql} FROM {ingestion_table} LIMIT 0"
).schema.json()

stream_source = StreamSource(
    full_name="my_catalog.my_schema.my_stream",
    transformation_sql=transformation_sql,
    dataframe_schema=dataframe_schema,
)
RequestSource
RequestSource 事前に実体化されたテーブルから検索されるのではなく、リクエストペイロード内の推論時に提供されるデータのスキーマを定義します。トレーニング中に、これらの列はcreate_training_setに渡されたラベル付きDataFrameから抽出されます。モデルサービング中に、呼び出し元はそれらをHTTPリクエストペイロードに含める必要があります。
RequestSource CustomUDF または ColumnSelection フィーチャー ビュー関数で使用できます。集計関数や時間枠はサポートされていません。
スキーマの定義
スキーマをFieldDefinitionオブジェクトのリストとして定義します。各オブジェクトは、列名とScalarDataTypeを指定します。
from databricks.feature_engineering.entities import (
    FieldDefinition, RequestSource, ScalarDataType,
)

request_source = RequestSource(
    schema=[
        FieldDefinition(name="transaction_amount", data_type=ScalarDataType.DOUBLE),
        FieldDefinition(name="vendor_id", data_type=ScalarDataType.STRING),
        FieldDefinition(name="transaction_id", data_type=ScalarDataType.STRING),
        FieldDefinition(name="transaction_time", data_type=ScalarDataType.DATE),
    ]
)
サポートされているデータ型
RequestSource ScalarDataTypeで定義されているスカラー型をサポートします:INTEGER、FLOAT、BOOLEAN、STRING、DOUBLE、LONG、TIMESTAMP、DATE、SHORT。配列、マップ、構造体などの複合型はサポートされていません。
リクエストデータがどのようにハイドレートされるか
コンテキスト | 挙動 |
|---|---|
**トレーニング**( | 列はラベル付きDataFrameから抽出されます。型は宣言されたスキーマに対して検証されます。不一致があるとエラーが発生します(暗黙的なキャストなし)。 |
サービング (モデルEndpoint) | HTTPリクエストでは、 |
モデルシグネチャ
RequestSource特徴を含むトレーニングセットでlog_modelを使用してモデルがログに記録されると、必要な入力としてRequestSource列がMLflowモデル署名に追加されます。これは、サービングEndpointのAPIスキーマが、呼び出し元が推論時に提供する必要があるフィールドを反映していることを意味します。
FeatureViewSource
FeatureViewSource 他の特徴量ビューの出力を CustomUDF の入力として使用します。特徴量を連鎖させることで、有向非巡回グラフ(DAG)が作成されます。たとえば、マージン特徴量は収益とコストの集計を組み合わせることができ、別の特徴量でそのマージンを変換できます。
FeatureViewSourceにはdatabricks-feature-engineeringのバージョン0.18.0以降を使用してください。
features には、機能名の文字列ではなく、Feature オブジェクトのリストを渡します。get_feature を使用して登録済みの特徴量を取得します。input_bindings で、登録された各特徴量の full_name を使用します。ローカルの未登録の特徴量の場合は、代わりにその name を使用します。
次の例では、2つの登録済み機能(revenue_sum_7dおよびcost_sum_7d)を想定しています。これらはDOUBLEによってcustomer_idの値目を返し、ポイントインタイム・コンピュートにevent_timeを使用します:
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import CustomUDF, FeatureViewSource

fe = FeatureEngineeringClient()
revenue = fe.get_feature(full_name="main.ecommerce.revenue_sum_7d")
cost = fe.get_feature(full_name="main.ecommerce.cost_sum_7d")

spark.sql("""
CREATE OR REPLACE FUNCTION main.ecommerce.margin_udf(revenue DOUBLE, cost DOUBLE)
RETURNS DOUBLE
LANGUAGE PYTHON
AS $$
import math

if revenue is None or cost is None:
    return None
if not math.isfinite(revenue) or not math.isfinite(cost) or revenue <= 0:
    return None
return (revenue - cost) / revenue
$$
""")

margin = fe.create_feature(
    source=FeatureViewSource(features=[revenue, cost]),
    function=CustomUDF(
        function_name="main.ecommerce.margin_udf",
        input_bindings={"revenue": revenue.full_name, "cost": cost.full_name},
    ),
    catalog_name="main",
    schema_name="ecommerce",
    name="margin",
)
次の制限が適用されます:
- 関数としてサポートされているのは
CustomUDFのみです。アップストリームの特徴量は、集計、列の選択、またはその他のCustomUDFの特徴量にすることができます。 - 派生特徴量の
entityとtimeseries_columnを省略します。各上流の特徴量は、それぞれ独自のエンティティ、Timestamp、ウィンドウ定義を保持します。 - 特徴量には 1 つのソースがあります。リクエスト値をテーブルでバックアップされた特徴量と組み合わせるには、
RequestSource特徴量を定義し、FeatureViewSourceを介して両方を参照します。 - 宣言されたすべての上流特徴量を
input_bindingsで使用する必要があります。循環は許可されません。 - 派生特徴量を登録する前に、上流の特徴量を登録します。実験のために、ローカルの未登録グラフを
create_training_setと共に使用できます。 - トレーニングまたはサービングを行うには、派生した特徴量とその推移的アップストリーム特徴量に対する
READ FEATUREまたはMANAGE権限が必要です。カタログやスキーマの間でも、登録とサービングのためにグラフ全体で固有の特徴量名を使用してください。 - 1つの特徴量は、最大 20個の直接の上流特徴量を参照できます。登録済みのグラフでは、ベース特徴量を含めて、依存関係パスに沿って最大 5個の特徴量の深さがサポートされます。
FeatureViewSourcecompute_featuresを使用して特徴量をマテリアライズまたは評価することはできません。create_training_setを使用してそれらをオフラインで評価します。オンラインサービングを行うには、代わりにサポートされているテーブルバックアップ形式のアップストリーム特徴量をマテリアライズしてください。
依存関係の評価と出力の選択については、Train with FeatureViewSource features を参照してください。デプロイについては、Serve derived features を参照してください。
トレーニングと推論API
create_training_set およびscore_batchが、ソースデータから特定の時点に正しい特徴量値をオンデマンドでコンピュートします。オフラインマテリアライゼーションをサポートする機能(Deltaテーブルソースでのスライディングウィンドウ集計など)の場合、まず機能をオフラインストアにマテリアライズすると、両方の操作のパフォーマンスが向上します。マテリアライズされたオフラインの特徴量が利用可能な場合、操作はソースから特徴量値を再計算する代わりに、事前に計算されたオフラインデータを読み取ります。オフラインストアに特徴量をマテリアライズするには、特徴量ビューをマテリアライズするを参照してください。
create_training_set()
時点補正された特徴量計算を含むトレーニングデータセットを作成します。詳細については、フィーチャービューでモデルをトレーニングするを参照してください。
FeatureEngineeringClient.create_training_set(
    df: DataFrame,                                # DataFrame with training data
    features: Optional[List[Feature]],            # List of Feature objects
    label: Union[str, List[str], None],           # Label column name(s)
    exclude_columns: Optional[List[str]] = None,  # Optional: columns to exclude
) -> TrainingSet
log_model()
Logs a model with feature metadata for リネージ tracking and automatic feature lookup during inference.詳細については、フィーチャービューでモデルをトレーニングするを参照してください。
FeatureEngineeringClient.log_model(
    model,                                    # Trained model object
    artifact_path: str,                       # Path to store model artifact
    flavor: ModuleType,                       # MLflow flavor module (e.g., mlflow.sklearn)
    training_set: TrainingSet,                # TrainingSet used for training
    registered_model_name: Optional[str],     # Optional: register model in Unity Catalog
)
score_batch()
自動の特徴量ルックアップを使用して、オフラインバッチ推論を実行します。モデルと一緒に保存されている特徴量メタデータを使用して、時点に合った特徴量をコンピュートし、トレーニングとの一貫性を確保します。
FeatureEngineeringClient.score_batch(
    model_uri: str,                           # URI of logged model (e.g., "models:/catalog.schema.model/1")
    df: DataFrame,                            # DataFrame with entity keys and timestamps
) -> DataFrame
入力 DataFrame には、トレーニング中に使用されたエンティティ列と時系列列が含まれている必要があります。特徴はソースデータから自動的にコンピュートされます。
fe = FeatureEngineeringClient()

# Batch scoring with automatic feature lookup
predictions = fe.score_batch(
    model_uri="models:/main.ecommerce.fraud_model/1",
    df=inference_df,
)
predictions.display()
時間ウィンドウ
フィーチャービューは、時間ウィンドウベースの集計におけるルックバック動作を制御するための4つのウィンドウタイプをサポートしています。利用可能なウィンドウタイプは、特徴量のソースによって異なります。ストリーミングソースの特徴量ではローリングウィンドウとソートゥースウィンドウを使用でき、バッチソースの特徴量ではローリングウィンドウ、タンブリングウィンドウ、スライディングウィンドウを使用できます。
- ローリングウィンドウはイベント時間から遡って参照します。期間と遅延は明示的に定義されています。
- タンブリングウィンドウは、固定された重複しない時間ウィンドウです。各データポイントは1つのウィンドウにのみ属します。
- スライディングウィンドウは、設定可能なスライド間隔を持つ、重複するローリング時間ウィンドウです。
- Sawtooth ウィンドウは、バッチとストリーミングのハイブリッドパスを使用して、ストリーミングソース全体で長いルックバックウィンドウを最新の状態に保ちます。Sawtooth ウィンドウを参照してください。
次の図は、タンブリング、スライディング、ローリング、および Sawtooth ウィンドウのタイプを示しています。
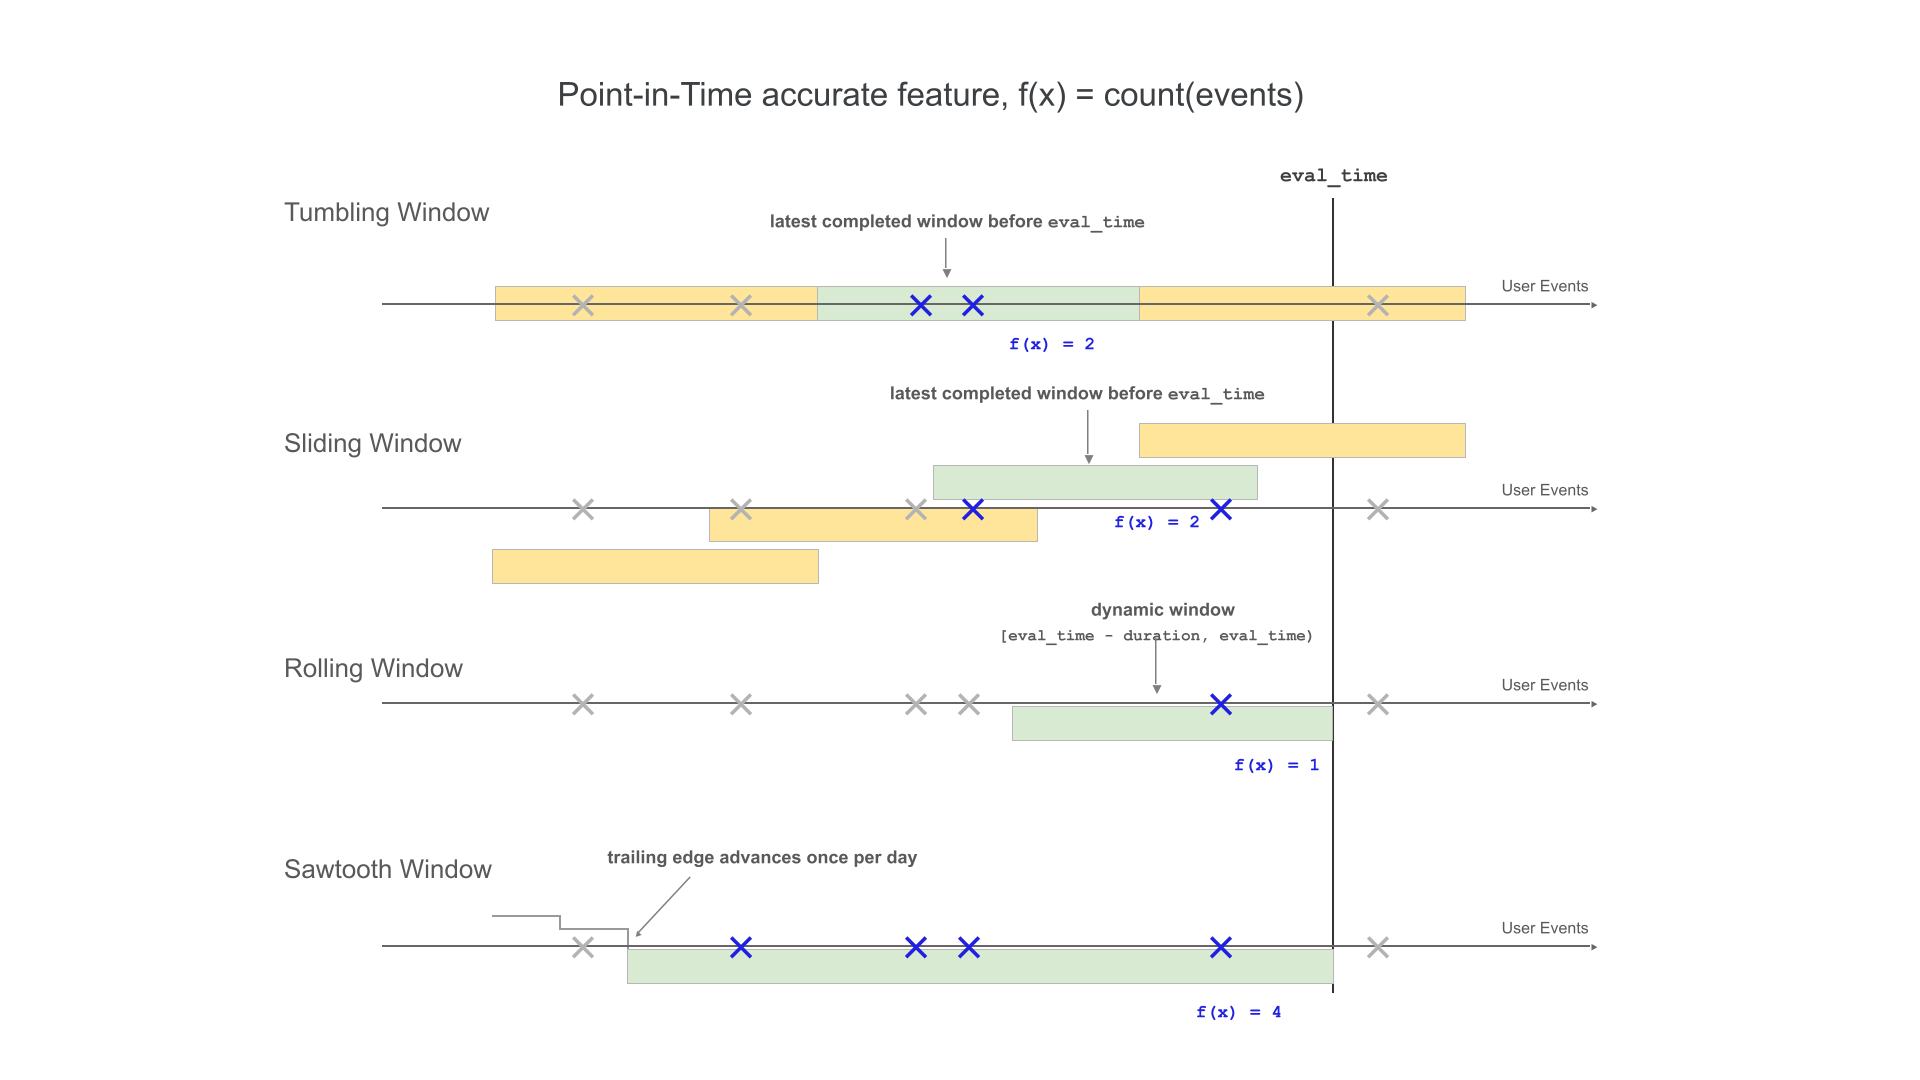
時間ウィンドウのタイミング
delay を使用して、過去の分析時点のウィンドウを評価します。たとえば、7日間の遅延がある30日間のウィンドウでは、評価時点の1週間前の時点として30日間の値がコンピュートされます。delay は、ソースの到着時間とは独立しています。ソースデータの到着にかかる時間をモデル化するには、代わりに SourceLateness.settling_delay を構成します。
両方の設定が存在する場合、それらは合成されます。Databricksは、ソースのセトリング遅延の経過後にウィンドウが完了したとみなし、分析遅延を使用してそれを評価します。
offsetを使用して、固定ウィンドウ境界の配置を変更します。default, タンブリングウィンドウとスライディングウィンドウは UTC の深夜 0 時に揃えられます。たとえば、22 時間のオフセットにより、1 日の境界が 22:00 UTC に合わせられます。ローカルタイムゾーンで境界を近似するには、UTC に対する静的オフセットを構成します。オフセットは、夏時間の調整、評価時間のシフト、または到着遅延データのモデル化を行いません。
次の表は、これらのフィールドのサポート状況をまとめたものです。
フィールド | サポートされているウィンドウ | 制約 |
|---|---|---|
| ローリング、タンブリング、スライディング | 負の値ではない必要があります。 |
| タンブリングおよびスライディング | 0以上であり、期間*よりも短い必要があります。 |
| ローリング、タンブリング、およびスライディング特徴量 | 負の値ではない必要があります。 |
| ローリング、タンブリング、スライディング | 指定する必要があるのは |
*期間: タンブリングウィンドウの場合、オフセットはwindow_durationより短くする必要があります。スライディングウィンドウの場合、slide_duration より短くする必要があります。
開始時刻
機能が出力を行える最も早いイベント時間境界をUTCで設定するには、start_timeを使用します。境界は包括的です。start_timeは出力をゲートします。これにより、ウィンドウが読み取る履歴上のソース行が制限されることはなく、ウィンドウの配置が変更されることもありません。start_timeが2つの整列された境界の間にある場合、最初に適格となる固定ウィンドウ出力は次の境界になります。
start_timeを使用すると、ソースで完全なウィンドウ期間が経過する前に、固定期間ウィンドウを出力できます。これらの早期出力では、利用可能なソース履歴が使用されます。たとえば、2024年1月1日にデータが開始するソースに対して、1年間の window_duration と1日間の slide_duration を持つスライディング ウィンドウを考えてみます。
start_timeがない場合、完全な1年間のウィンドウを形成できるようになった時点で、この機能は2025年1月1日に初めて出力されます。start_timeを2024年8月21日に設定すると、この機能は2024年8月21日に初めて発行されます。その出力は、2024年1月1日以降の利用可能なソース履歴のみをカバーしています。ウィンドウは2025年1月1日に完全な1年スパンに達し、それ以降は完全な出力を生成します。
start_timeはウィンドウの配置を変更しないため、配置された2つの境界の間の値によって新しい境界が作成されることはありません。UTCの深夜0時に日次境界を持つタンブリングウィンドウの場合、06:00 UTCのstart_timeは、次の深夜0時の境界で最初に出力されます。境界上に正確に収まるstart_timeは、境界が包括的であるため、その境界で出力されます。
start_timeが設定されていない場合、タンブリングウィンドウおよび固定期間のスライディングウィンドウは、完全なウィンドウを形成できるようになった後の整列された境界で最初に発信されます。ライフタイムスライディングウィンドウおよびローリングウィンドウは、適格なソースデータが存在しそうになるとすぐに発信されます。
start_time ローリング、タンブリング、またはスライディングウィンドウでDeltaTableSourceを使用するバッチ特徴量に対してサポートされています。StreamSourceまたはSawtoothWindowではサポートされていません。
例えば:
from datetime import datetime, timedelta
from databricks.feature_engineering.entities import SlidingWindow

window = SlidingWindow(
    window_duration=timedelta(days=365),
    slide_duration=timedelta(days=1),
    start_time=datetime(2024, 8, 21),
)
ローリング ウィンドウ
RollingWindow 以前はContinuousWindowという名前でした。以前のSDKバージョンから移行している場合は、インポートをそれに応じて更新してください。
ローリング ウィンドウは最新のリアルタイム集計であり、通常はストリーミング データで使用されます。ストリーミングパイプラインでは、イベントの入力または出力など、固定長ウィンドウの内容が変更された場合にのみ、ローリングウィンドウは新しい行を出力します。トレーニングパイプラインでローリングウィンドウ特徴量が使用される場合、特定のイベントのTimestampの直前にある固定長ウィンドウ期間を使用して、ソースデータに対して正確な時点の特徴量計算が実行されます。これは、オンライン/オフラインのずれやデータ漏洩を防ぐのに役立ちます。T時点の特徴量は、[T − 期間, T)からイベントを集約します。
class RollingWindow(TimeWindow):
    window_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
次の表に、ローリングウィンドウのパラメーターを示します。ウィンドウの開始時刻と終了時刻は、これらのパラメーターに基づいて次のように決まります。
- 開始時刻:
evaluation_time - window_duration - delay(含む) - 終了時刻:
evaluation_time - delay(排他的)
パラメーター | 制約 |
|---|---|
| 0 以上である必要があります。評価Timestampから分析ウィンドウを後方にシフトします。 |
| 0より大きい必要があります。 |
| 機能が出力の発行を開始できる最も早いイベント時刻の境界。 |
from databricks.feature_engineering.entities import RollingWindow
from datetime import timedelta

# Look back 7 days from evaluation time
window = RollingWindow(window_duration=timedelta(days=7))
以下のコードを使用して、遅延を伴うローリングウィンドウを定義します。
# Compute a 7-day value as of one day before the evaluation time
window = RollingWindow(
    window_duration=timedelta(days=7),
    delay=timedelta(days=1)
)
ローリングウィンドウの例
-
window_duration=timedelta(days=7)現在の評価時間で終了する7日間のルックバックウィンドウを作成します。7日目の午後2時のイベントの場合、これは0日目の午後2時から7日目の午後2時までの(7日目の午後2時は含まず)すべてのイベントを含みます。 -
window_duration=timedelta(hours=1), delay=timedelta(minutes=30):これにより、評価時間の 30 分前に終了する 1 時間のルックバックウィンドウが作成されます。午後3時のイベントの場合、これには午後1時30分から午後2時30分まで(午後2時30分は含まない)のすべてのイベントが含まれます。
Lastを使用して最新値の新しさを制限する
最新の値が期間限定でのみ有効な場合は、Last と RollingWindow を組み合わせます。評価時には、この間隔内で最新のTimestampを持つ行の値が特徴量によって返されます。
[evaluation_time - delay - window_duration, evaluation_time - delay)
間隔内の最新行に null 値が含まれている場合、特徴量は null を返します。null 入力値を除外する場合は、ソースに filter_condition を設定します。
この組み合わせは ColumnSelection と異なります。ColumnSelection は、経過時間に基づいて有効期限切れにすることなく、観測された最新の NULL ではない値を返します。
バッチ特徴量の場合、この組み合わせには特別なオンライン専用のマテリアライゼーションモードがあります。DeltaTableSource、Last、RollingWindow、およびTableTriggerのみをサポートします。新鮮度で境界が設定された最新値のマテリアライズを参照してください。
タンブリングウィンドウ
タンブリングウィンドウを使用して定義された特徴量の場合、集計は、スライド間隔で進む所定の固定長ウィンドウで計算され、時間を完全に分割する重複しないウィンドウが生成されます。その結果、ソース内の各イベントは正確に1つのウィンドウに寄与します。時刻tの特徴量は、t (排他的) 以前に終了するウィンドウからデータを集計します。ウィンドウはUnixエポックで開始します。
class TumblingWindow(TimeWindow):
    window_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    offset: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
次の表に、タンブリングウィンドウのパラメーターを示します。
パラメーター | 制約 |
|---|---|
| 0より大きい必要があります。 |
| 0以上である必要があります。評価Timestampから分析ウィンドウを後方にシフトします。 |
| 0以上で、 |
| 機能が出力の発行を開始できる最も早いイベント時刻の境界。 |
from databricks.feature_engineering.entities import TumblingWindow
from datetime import timedelta

window = TumblingWindow(
    window_duration=timedelta(days=1),
    delay=timedelta(hours=2),
    offset=timedelta(hours=22),
)
タンブリングウィンドウの例
window_duration=timedelta(days=5)これは、それぞれ5日間の事前に決定された固定長のウィンドウを作成します。例:ウィンドウ #1 は Day 0 から Day 4 にわたり、ウィンドウ #2 は Day 5 から Day 9 にわたり、ウィンドウ #3 は Day 10 から Day 14 にわたり、などです。具体的には、ウィンドウ #1 は、Day 0 の00:00:00.00に開始する Timestamp を持つすべてのイベントから、Day 5 の Timestamp00:00:00.00を持つイベントまで(ただし、含まず)を含みます。各イベントは厳密に1つのウィンドウに属します。
スライディングウィンドウ
スライディングウィンドウを使用して定義された特徴量の場合、集計はスライド間隔で進むウィンドウ上で計算されます。スライディングウィンドウには、固定期間またはライフタイム期間のいずれかを設定できます。固定期間ウィンドウは重複するため、各ソースイベントは複数のウィンドウの集計に寄与する可能性があります。ライフタイムウィンドウには、ウィンドウ終了前のすべてのソースイベントが含まれます。時刻tの特徴量は、t(排他的)以前に終了するウィンドウからのデータを集計します。ウィンドウはUnixエポックに準拠しています。
class SlidingWindow(TimeWindow):
    window_duration: Optional[datetime.timedelta]
    slide_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    offset: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
次の表に、スライディングウィンドウのパラメーターを示します。
パラメーター | 制約 |
|---|---|
| 固定期間ウィンドウの場合は、正の値を設定する必要があります。有効期間ウィンドウには |
| 正の値を設定してください。固定期間ウィンドウの場合、 |
| 0以上である必要があります。評価Timestampから分析ウィンドウを後方にシフトします。 |
| 0以上で、 |
| 機能が出力の発行を開始できる最も早いイベント時刻の境界。 |
from databricks.feature_engineering.entities import SlidingWindow
from datetime import timedelta

window = SlidingWindow(
    window_duration=timedelta(days=7),
    slide_duration=timedelta(days=1),
    delay=timedelta(hours=2),
    offset=timedelta(hours=22),
)
スライディングウィンドウの例
window_duration=timedelta(days=5), slide_duration=timedelta(days=1)これにより、毎回1日ずつ進む重複する5日間のウィンドウが作成されます。例: ウィンドウ #1は0日目から4日目まで、ウィンドウ #2は1日目から5日目まで、ウィンドウ #3は2日目から6日目までといった具合です。各ウィンドウには、開始日の00:00:00.00から終了日の00:00:00.00まで (ただしは含まない) のイベントが含まれます。ウィンドウが重複しているため、単一のイベントが複数のウィンドウに属することができます (この例では、各イベントは最大5つの異なるウィンドウに属します)。
有効期間ウィンドウ
ライフタイムウィンドウを作成するには、window_duration=Noneを設定します。各スライド境界において、特徴量はその境界より前のTimestampを持つエンティティのすべてのソースイベントを集計します。例えば、1日のスライドでは、1日1回累積値が生成されます。
有効期間ウィンドウはSlidingWindowでのみサポートされています。RollingWindowおよびTumblingWindowには、有限のwindow_durationが必要です。
ライフタイムウィンドウには、window_duration=Noneとワークスペースの有効化をサポートするdatabricks-feature-engineeringクライアントバージョンが必要です。以前のクライアントバージョンでは、この構文はサポートされていません。
from datetime import timedelta
from databricks.feature_engineering.entities import (
    AggregationFunction,
    DeltaTableSource,
    Feature,
    SlidingWindow,
    Sum,
)

lifetime_spend = Feature(
    source=DeltaTableSource(
        catalog_name="main",
        schema_name="store",
        table_name="transactions",
    ),
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(
        Sum(input="amount"),
        SlidingWindow(
            window_duration=None,
            slide_duration=timedelta(days=1),
        ),
    ),
    name="lifetime_spend",
)
ソートゥース ウィンドウ
ベータ版
SawtoothWindow はベータ版です。
Sawtooth ウィンドウは、最近のイベントに対する非常に新鮮な更新と、履歴データの毎日のコンパクション(圧縮)をサポートする集計です。そのトレーリング(古い)エッジは固定された日単位のステップで進み、リーディング(最近の)エッジは最新のイベントに合わせて更新されるため、有効なウィンドウの長さは1日を通して「のこぎり状」に変化します。ウィンドウの大部分はストリームの取り込みテーブルのデータから提供され、直近の2日間のみがライブストリームから提供されます。これは、新鮮な更新に対する応答性を維持しながら、長時間ウィンドウ(数年単位までスケール可能)を効率的にコンピュートするための妥協案です。
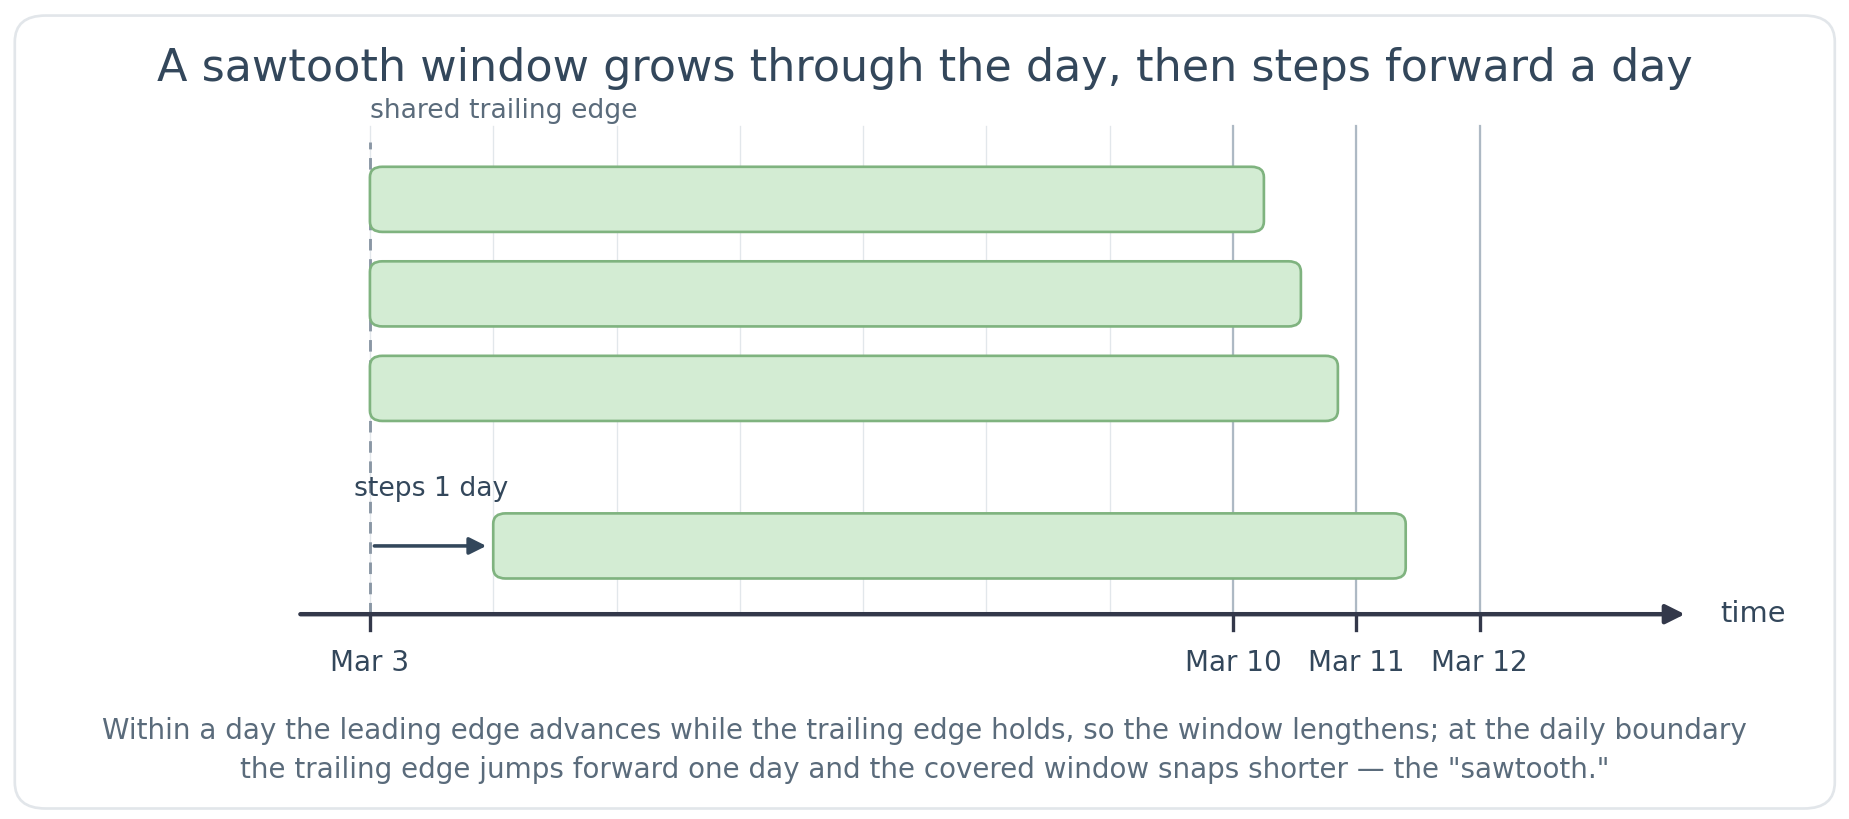
Sawtooth ウィンドウは、バッチとストリーミングのハイブリッドパス上でマテリアライズされます。バッチパイプラインはウィンドウの大部分を保持し、ストリーミングパイプラインは最新のデータをリアルタイムで維持します。これら2つは読み取り時にMergeされるため、モデルやサービングコンシューマーからは単一の特徴量として扱われます。
ウィンドウの履歴部分はバッチパイプラインによってコンピュートされるため、ウィンドウが数か月または数年にわたる場合でも、マテリアライズ開始直後にソートゥース特徴量を提供できるようになります。ローリング ウィンドウは、その全ウィンドウ期間が経過した後にのみ完了します。最小の window_duration は 2 日(強制される下限)より大きければなりません。Databricks では、7 日を超える期間にはソートゥース ウィンドウを推奨しています。2日以上7日までのウィンドウについては、ローリング ウィンドウの固定長の精度と、ソートゥース ウィンドウのより高速な本番運用への対応のどちらかを選択します。
ソートゥース特徴量は、すでに存在する履歴に依存します。ストリームの取り込みテーブルには、少なくともウィンドウの全期間をカバーするデータが含まれている必要があります。含まれていない場合、計算されたウィンドウが不完全になります。2 日が完全に経過する前は、特徴量にはこれまでにマテリアライズされたデータのみが反映されます。完全に 2 日が経過するまでは、本番運用で特徴量を提供することはお勧めしません。空のウィンドウに対する集計では、Sum および Count に対しては 0 が返され、Avg、Min、Max、First、Last、VarPop、VarSamp、StddevPop、および StddevSamp に対しては null が返されます。
Sawtooth 特徴量の準備ができているかどうかを確認するには、カタログエクスプローラーで「Feature View」を開きます。マテリアライズ済み特徴量セクションでは、特徴量の最終マテリアライズ時刻が進み、ステータスが成功を示した時点で、バッチバックフィルは完了です。ストリーミング部分は、Lakeflow 宣言型パイプラインによってマテリアライズされます。Feature View が検証を通過すると、マテリアライズ済み特徴量はそのパイプラインにリンクされ、そこでランステータスを監視できます。
Sawtooth ウィンドウには StreamSource が必要であり、StreamingMode を使用してマテリアライズされます。
class SawtoothWindow(TimeWindow):
    window_duration: datetime.timedelta
Sawtooth ウィンドウのエッジは、ローリングウィンドウとは異なる動きをします。リーディングエッジは最新のイベントを追跡し、トレーリングエッジは継続的ではなく1日1回進みます。毎日18:00 UTCの固定カットオフで、トレーリングエッジはその日のUTC深夜の境界まで進みます。その結果、有効なウィンドウは window_duration よりわずかに長くなり、次のカットオフで1日分戻るまで、1日を通して増加します。トレーニングとサービングは同じ18:00 UTCのカットオフを使用するため、オフラインのトレーニングとオンラインのサービングは一貫性を保ちます。
パラメーター | 制約 |
|---|---|
| 2日より長く設定する必要があります。日単位の整数ではない期間(例: |
ソートゥースウィンドウでは、Sum、Avg、Count、Min、Max、First、Last、VarPop、VarSamp、StddevPop、および StddevSamp の集計関数がサポートされています。
ノコギリ波ウィンドウの例
次の例は、ユーザーのトランザクションの7日間のカウントを示しています。リーディングエッジは現在のイベントを追跡し、トレーリングエッジは1日ずつ前進します。3月10日のイベントの場合、ウィンドウは約3月3日まで遡ります。3月10日が経過するにつれて、リーディングエッジは前進し続けますが、トレーリングエッジは保持されるため、カバーされる期間は拡大します。その後、3月11日の開始時に、トレーリングエッジは約3月4日まで進みます。有効なウィンドウは常に7日間より少し長くなります。直近の2日間はライブストリームから提供され、それ以前の日付はストリームの取り込みテーブルから提供されます。
from databricks.feature_engineering.entities import SawtoothWindow
from datetime import timedelta

# 7-day window kept continuously fresh with streaming data
window = SawtoothWindow(window_duration=timedelta(days=7))
ノコギリ波ウィンドウの制限
delayパラメーターはサポートされていません。SourceLateness.settling_delayはサポートされていません。Sum、Avg、Count、Min、Max、First、Last、VarPop、VarSamp、StddevPop、およびStddevSamp以外の集計関数はサポートされていません(例:ApproxCountDistinct、ApproxPercentile、FirstN、LastN、FirstDistinct、LastDistinct)。- Sawtooth ウィンドウには
StreamSourceが必要です。DeltaTableSourceはサポートされていません。
Materialization Trigger
トリガーは、実体化パイプラインが実行されるタイミングを制御します。Triggerタイプはフィーチャータイプによって異なります。
CronSchedule
バッチ集計機能には CronSchedule を使用します。By default, Databricks は集計ウィンドウからスケジュールを派生させます。派生スケジュールでは、ウィンドウ期間、ウィンドウdelayおよびoffset、ならびにソースsettling_delayが考慮されるため、ソースデータの完了が予想される前にランがウィンドウをパブリッシュすることはありません。派生スケジュールは、タンブリングウィンドウおよびスライディングウィンドウをサポートしています。
派生スケジュールをリクエストするには、cron 式を省略します。CronSchedule() と明示的な CronSchedule(mode=CronScheduleMode.DERIVED) 形式は同等です:
from databricks.feature_engineering.entities import (
    CronSchedule,
    CronScheduleMode,
)

trigger = CronSchedule(mode=CronScheduleMode.DERIVED)
quartz_cron_expression に CronScheduleMode.DERIVED を設定しないでください。マテリアライズされた特徴量を取得すると、返されるスケジュールに Databricks が計算した cron 式が含まれる場合があります。
スケジュールを直接制御するには、Quartz cron式を指定します。式を指定すると、CronScheduleMode.MANUAL が推論されます。
from databricks.feature_engineering.entities import CronSchedule

trigger = CronSchedule(
    quartz_cron_expression="0 0 * * * ?",  # Hourly
    timezone_id="UTC",
)
TableTrigger
ColumnSelection 特徴量または DeltaTableSource に裏打ちされた集約特徴量 (AggregationFunction) には、TableTrigger を使用します。アップストリームの Delta テーブルが新しい commit を受け取るたびに、パイプラインが実行されます。
集計機能の場合、パイプラインはすべての commit ごとに実行されないようにスロットルされます。パイプラインは、機能のウィンドウ長の半分につき最大 1 回実行されますが、5 分より短い間隔で実行されることはありません。例えば、1 時間のタンブリングウィンドウを持つ機能は 30 分ごとに最大 1 回実行され、8 時間のウィンドウを持つ機能は 4 時間ごとに最大 1 回実行されます。ウィンドウの半分が 5 分未満の場合、5 分という下限が適用されるため、10 分以下のウィンドウは 5 分ごとに最大 1 回実行されます。ウィンドウが 5 分未満の集計機能では TableTrigger を使用できません。代わりにストリーミング Trigger を使用してください。
from databricks.feature_engineering.entities import TableTrigger

trigger = TableTrigger()
StreamingMode
StreamSourceによってサポートされる特徴量にはStreamingModeを使用します。パイプラインは、継続的なストリーミングパイプラインとして実行されます。
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    StreamSource, Feature, AggregationFunction, Sum,
    RollingWindow, OnlineStoreConfig, StreamingMode,
)
from datetime import timedelta

fe = FeatureEngineeringClient()

stream_source = StreamSource(full_name="my_catalog.my_schema.my_stream")

streaming_feature = fe.create_feature(
    source=stream_source,
    entity=["value.user_id"],
    timeseries_column="value.event_time",
    function=AggregationFunction(
        operator=Sum(input="value.amount"),
        time_window=RollingWindow(window_duration=timedelta(hours=1)),
    ),
    catalog_name="my_catalog",
    schema_name="my_schema",
    name="user_purchase_sum",
)

fe.materialize_features(
    features=[streaming_feature],
    online_config=OnlineStoreConfig(
        catalog_name="my_catalog",
        schema_name="my_schema",
        table_name_prefix="streaming_features_serving",
        online_store_name="feature_store_online",
    ),
    trigger=StreamingMode(),
)
Triggerの選択
各特徴量は1つの Trigger を使用します。特徴量タイプ別のオプションは次のとおりです:
特徴量タイプ | トリガー | 実行するとき |
|---|---|---|
集計( |
| 派生スケジュールまたは手動スケジュール |
集計( |
| 各ソーステーブルcommit時 |
|
| 各ソーステーブルcommit時 |
からの特徴量 |
| 連続ストリーミング |
単一のmaterialize_features呼び出しで、異なるTriggerタイプを必要とする特徴量をマテリアライズすることはできません。代わりに、個別の呼び出しを発行します。