オンデマンド プロビジョニング済みthroughput 基盤モデル API
このページでは、基盤モデルAPIsのオンデマンド プロビジョニング済みthroughputを使用してモデルをデプロイする方法について説明します。
オンデマンドのプロビジョニング済みthroughputとは何ですか?
Databricksでプロビジョニング スループットのモデルサービングEndpointを作成すると、提供する基盤モデルに対して一貫したthroughputを保証するために、専用の推論容量を割り当てます。基盤モデルを提供するモデルサービングEndpointは、モデルユニットのチャンクでプロビジョニングできます。割り当てるモデルユニットの数によって、本番運用のAIアプリケーションを確実にサポートするために必要なthroughputを正確に購入できます。
オンデマンドのプロビジョニング済みthroughputには、期間のコミットメントはありません。割り当てた容量に対して料金が発生し、いつでも変更または削除できます。
より低い単価で固定の 1 か月または 3 か月の期間で容量を予約する場合は、基盤モデル APIs でプロビジョニングされた throughput を予約するを参照してください。
プロビジョニング済み throughput Endpoint でサポートされているモデル アーキテクチャの一覧については、リージョン別のモデルの可用性を参照してください。
専用の容量が必要ない場合は、Databricksは基盤モデルAPIの優先トークン単位の従量課金を推奨しています。
必要条件
要件を参照してください。
[推奨]Unity Catalog から基盤モデルをデプロイする
Databricks では、Unity Catalog にプレインストールされている基盤モデルを使用することをお勧めします。 これらのモデルは、スキーマai (system.ai) のカタログsystemの下にあります。
組織が 基盤モデル Unity Catalog 権限 を使用してモデルアクセスを制限している場合、許可されていないモデルのプロビジョニングスループットエンドポイントは手動で削除する必要があります。
基盤モデルをデプロイするには:
- カタログエクスプローラで
system.aiに移動します。 - デプロイするモデルの名前をクリックします。
- モデル ページで、 このモデルをサービング ボタンをクリックします。
- サービングエンドポイントの作成 ページが表示されます。 UI を使用してプロビジョニングされたスループットエンドポイントを作成するを参照してください。
Unity Catalog の system.ai から Meta Llama モデルをデプロイするには、該当する Instruct バージョンを選択する必要があります。Meta Llama モデルの基本バージョンは、Unity Catalog からのデプロイではサポートされていません。サポートされている Meta Llama モデルのバリアントについては、 Databricks でホストされている基盤モデル を参照してください。
UI を使用してプロビジョニングされたスループットエンドポイントを作成する
記録済みモデルが Unity Catalogになったら、次の手順でプロビジョニング スループット サービング エンドポイントを作成します。
- ワークスペースの サービング UI に移動します。
- サービング エンドポイントの作成 を選択します。
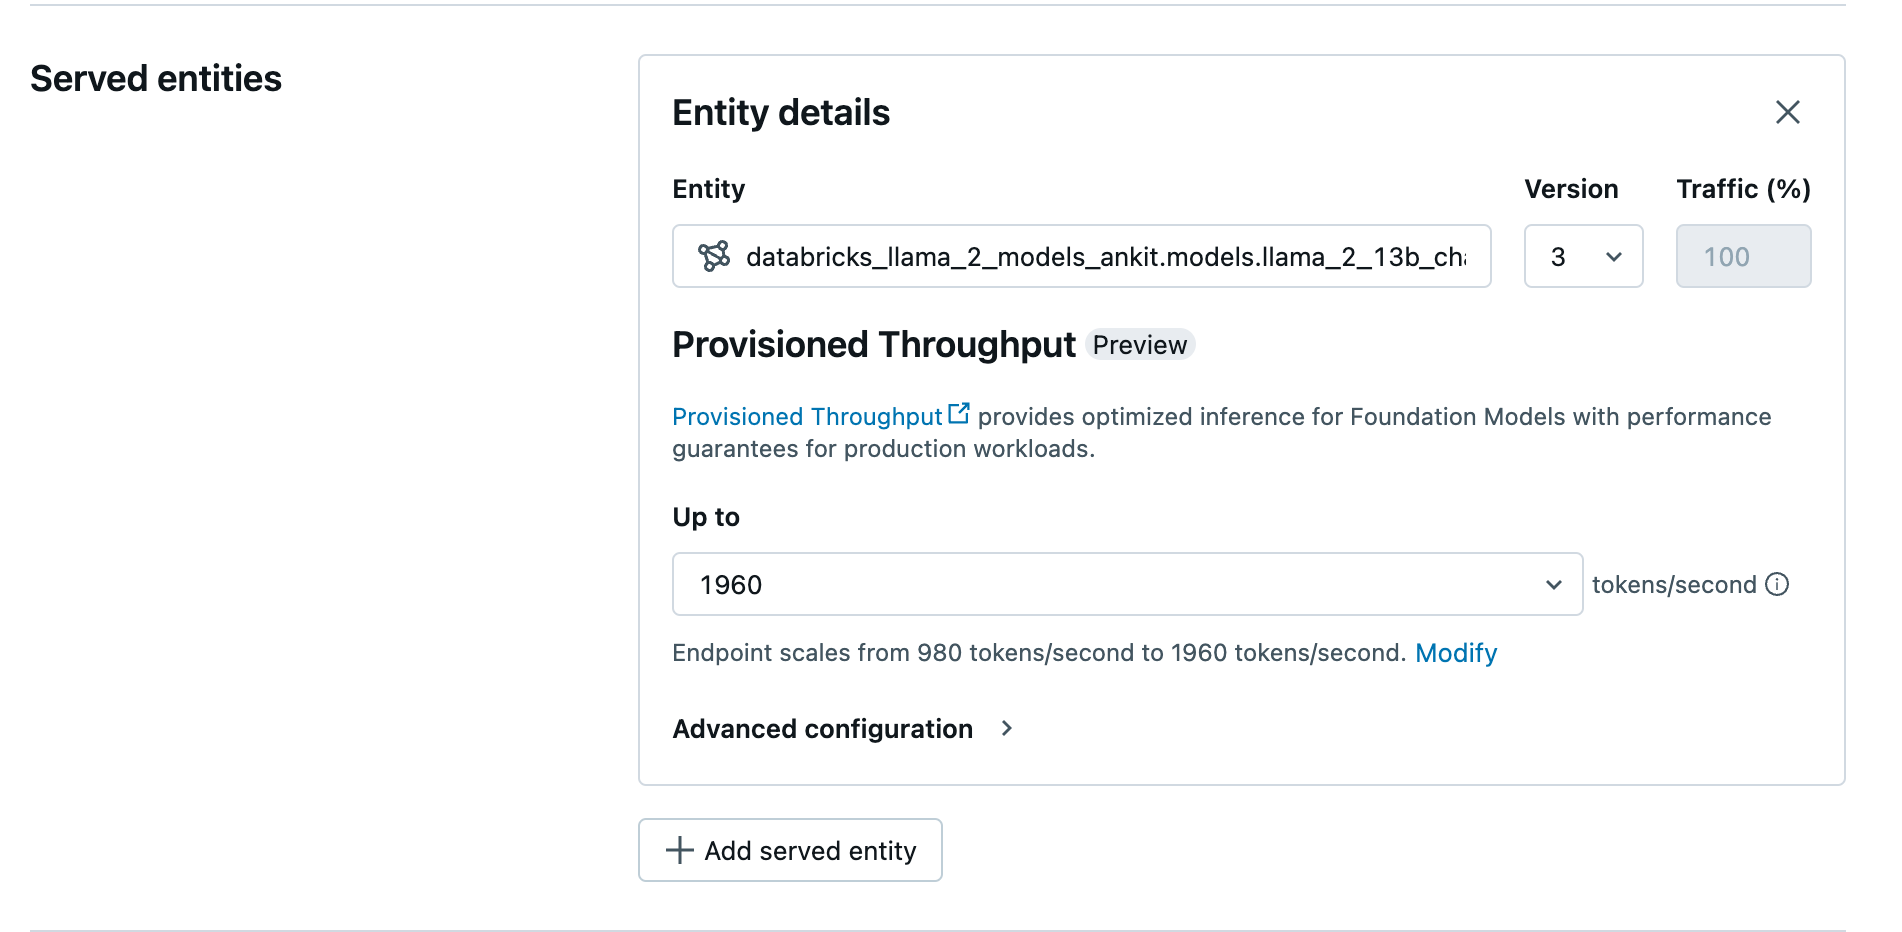
- エンティティ フィールドで、Unity Catalog からモデルを選択します。対象モデルの場合、提供されるエンティティの UI には プロビジョニングされたスループット 画面が表示されます。
- 最大 ドロップダウンでは、エンドポイントの 1 秒あたりの最大トークンスループットを構成できます。
- プロビジョニングされたスループットエンドポイントは自動的にスケーリングされるため、 変更 を選択して、エンドポイントがスケールダウンできる 1 秒あたりの最小トークン数を表示できます。
REST API を使用してプロビジョニングされたスループットエンドポイントを作成する
プロビジョニングされた throughput Endpoint を作成するための REST API リクエストは、基盤モデルが容量を throughput バンドで測定するか、モデルユニットで測定するかによって異なります。どのメジャーがモデルに適用されるかを確認するには、プロビジョニング済み throughputのモデルユニットを参照してください。
Python を使用する場合は、 MLflow デプロイ SDK を使用してエンドポイントを作成することもできます。
次の例では、 throughput帯域 を使用する基盤モデルのEndpointを作成します。これらのモデルについては、リクエストで min_provisioned_throughput フィールドと max_provisioned_throughput フィールドを指定する必要があります。モデルに適したプロビジョニング済み throughput の範囲を特定するには、プロビジョニング済み throughput を段階的に取得するを参照してください。
import requests
import json

# Set the name of the MLflow endpoint
endpoint_name = "prov-throughput-endpoint"

# Name of the registered MLflow model
model_name = "ml.llm-catalog.foundation-model"

# Get the latest version of the MLflow model
model_version = 3

# Get the API endpoint and token for the current notebook context
API_ROOT = "<YOUR-API-URL>"
API_TOKEN = "<YOUR-API-TOKEN>"

headers = {"Content-Type": "text/json", "Authorization": f"Bearer {API_TOKEN}"}

optimizable_info = requests.get(
  url=f"{API_ROOT}/api/2.0/serving-endpoints/get-model-optimization-info/{model_name}/{model_version}",
  headers=headers).json()

if 'optimizable' not in optimizable_info or not optimizable_info['optimizable']:
  raise ValueError("Model is not eligible for provisioned throughput")

chunk_size = optimizable_info['throughput_chunk_size']

# Minimum desired provisioned throughput
min_provisioned_throughput = 2 * chunk_size

# Maximum desired provisioned throughput
max_provisioned_throughput = 3 * chunk_size

# Send the POST request to create the serving endpoint
data = {
  "name": endpoint_name,
  "config": {
    "served_entities": [
      {
        "entity_name": model_name,
        "entity_version": model_version,
        "min_provisioned_throughput": min_provisioned_throughput,
        "max_provisioned_throughput": max_provisioned_throughput,
      }
    ]
  },
}

response = requests.post(
  url=f"{API_ROOT}/api/2.0/serving-endpoints", json=data, headers=headers
)

print(json.dumps(response.json(), indent=4))
次の例では、 モデルユニット を使用する基盤モデルのEndpointを作成します。これらのモデルの場合、リクエストで provisioned_model_units フィールドを指定し、/api/2.0/serving-endpoints/pt Endpoint に POST リクエストを送信します。
import requests
import json

# Set the name of the provisioned throughput endpoint
endpoint_name = "prov-throughput-endpoint"

# Name of the foundation model
model_name = "system.ai.gpt-oss-120b"

# Get the latest version of the foundation model
model_version = 1

# Get the API endpoint and token for the current notebook context
API_ROOT = "<YOUR-API-URL>"
API_TOKEN = "<YOUR-API-TOKEN>"

headers = {"Content-Type": "text/json", "Authorization": f"Bearer {API_TOKEN}"}

optimizable_info = requests.get(
  url=f"{API_ROOT}/api/2.0/serving-endpoints/get-model-optimization-info/{model_name}/{model_version}",
  headers=headers).json()

if 'optimizable' not in optimizable_info or not optimizable_info['optimizable']:
  raise ValueError("Model is not eligible for provisioned throughput")

chunk_size = optimizable_info['model_unit_chunk_size']

# Desired provisioned throughput
desired_model_units = 2 * chunk_size

# Send the POST request to create the serving endpoint
data = {
  "name": endpoint_name,
  "config": {
    "served_entities": [
      {
        "entity_name": model_name,
        "entity_version": model_version,
        "provisioned_model_units": desired_model_units,
      }
    ]
  },
}

response = requests.post(
  url=f"{API_ROOT}/api/2.0/serving-endpoints/pt", json=data, headers=headers
)

print(json.dumps(response.json(), indent=4))
チャット完了タスクのログ確率
チャット完了タスクの場合、 logprobsを使用して、大規模言語モデル生成プロセスの一部としてサンプリングされるオフラインのログ確率を提供できます。 logprobs 、分類、モデルの不確実性の評価、評価メトリックの実行など、さまざまなシナリオに使用できます。 詳細については、 Chat Completions API参照してください。
プロビジョニングされたスループットを段階的に取得
プロビジョニングされたスループットは、1 秒あたりのトークンの増分で使用でき、特定の増分はモデルによって異なります。 ニーズに適した範囲を特定するために、Databricks では、プラットフォーム内でモデル最適化情報 API を使用することをお勧めします。
GET api/2.0/serving-endpoints/get-model-optimization-info/{registered_model_name}/{version}
API からの応答の例を次に示します。
{
  "optimizable": true,
  "model_type": "llama",
  "throughput_chunk_size": 980
}
{
  "optimizable": true,
  "model_type": "gte",
  "throughput_chunk_size": 980
}
制限
- GPU 容量の問題により、モデルのデプロイが失敗する場合があり、その結果、エンドポイントの作成または更新中にタイムアウトが発生します。 Databricksアカウントチームに連絡して解決してください。