throughputが最適化された(Triton)モデルサービングEndpointをデプロイする
ベータ版
この機能はベータ版です。ワークスペース管理者は、 プレビュー ページからこの機能へのアクセスを制御できます。Databricksのプレビューを管理するを参照してください。
カスタムModel Servingでは、NVIDIA Triton Inference Serverバックエンドの背後でGPU Endpointをランできます。Tritonは、モデルに到達する前に受信リクエストをまとめてバッチ処理するため、同時実行時のGPUバウンドモデルでのthroughputが向上します。このページでは、Tritonが役立つケース、GPUサービングEndpointで有効にする方法、およびそれがアクティブであることを確認する方法について説明します。
Tritonを使用する場合
Triton は GPU 上で並列リクエストをバッチにまとめるため、GPU がボトルネックの場合に最も効果を発揮します。throughput の向上が大きくなる可能性のある、リアルタイムの high concurrency トラフィック下で実行される、負荷が高くバッチ処理可能な GPU ワークロードが適しています:
- BERTおよびその他のトランスフォーマーの推論
- 埋め込みモデル
- 画像の分類
- オブジェクト検出
Triton は、GPU がボトルネックになっていない場合(CPU で画像のでコードとサイズ変更を行う小規模モデルやビジョンモデルなど)には、あまり効果を発揮しません。ここでは、GPU が CPU の前処理を待ってアイドル状態になるため、その前段でのバッチ処理は処理のステップを増やすだけになります。前処理を GPU に移行することが、このようなモデルでメリットが得られる理由です。
バッチ処理では、リクエストあたりのレイテンシをわずかに増加させる代わりにthroughputを向上させます。効果は同時実行数によって異なります。トラフィックが少ない場合、バッチは小さいままとなり、メリットは限定的です。広くリリースする前に、1つのEndpointから起動、現実的な同時実行数でthroughputとレイテンシの両方を測定します。
要件
この機能を利用するには、次の条件が必要です:
- ワークスペースでプレビューが有効になっています。 ワークスペース管理者は、 プレビュー ページからプレビューを有効にします。「Databricks プレビューの管理」を参照してください。これを完了するまで、以下の機能は動作しません。
- GPU サービング 提供されるエンティティは、GPU ワークロードタイプ(
GPU_SMALL、GPU_MEDIUM、GPU_LARGEなど)を使用する必要があります。Triton は CPU Endpoint では無効(no-op)です。 - バッチ処理に適したモデル。 モデルはバッチ処理に対応している必要があります。入力数が出力数と一致し(N個の入力に対してN個の出力が生成される)、リクエスト間にリクエスト間の依存関係がないこと。また、モデルは1回の呼び出しでバッチ全体を処理する必要があります。
pyfuncでは、入力を1つずつループ処理するのではなく、バッチを一度に渡します(例:model(**batched_inputs))。アイテムごとのループではバッチ処理のメリットが得られません。 - 迅速なデプロイパス上のモデル。 モデルを
env_pack="databricks_model_serving"に登録し、そのウェイトや環境を展開可能なアーティファクトとしてステージ化します。コンテナ構築パスにフォールバックするモデルは、Tritonバックエンドを取得できません。Serverless GPUのコンピュートv4、v5、またはv6(スタンダードとAIの両方)から登録してください。モデル モデルサービングEndpointについてはExpressデプロイメントを参照してください。
ステップ1: エクスプレスデプロイメント用にモデルを登録する
モデルをログに記録し、env_pack="databricks_model_serving"に登録します。Serverless GPUランタイムからこれを実行します。非GPUランタイムからログを記録するとCPU依存関係がパッケージ化され、GPU Endpointの起動に失敗します。
import mlflow

mlflow.set_registry_uri("databricks-uc")

with mlflow.start_run():
    model_info = mlflow.pyfunc.log_model(
        artifact_path="model",
        python_model=MyModel(),
        # An input example enables automatic tuning of batching parameters in PuPr.
        input_example=example,
    )

# env_pack puts the model on the express deployment path (required for Triton).
mlflow.register_model(
    model_info.model_uri,
    "<catalog>.<schema>.<model>",
    env_pack="databricks_model_serving",
)
ステップ 2:throughputの最適化を有効にし、Endpointを作成する
エンドポイントを作成する際にリクエストバッチングをオンにしてください。これはTriton上でモデルを扱い、Databricksはモデルのプロファイルと調整されたバッチ設定を適用します。
バッチ処理は、次の条件のすべてを満たしている場合にのみ利用できます。
- 提供されるエンティティは、CPUではなくGPUワークロードタイプを使用します。
- 提供されているモデルにはカスタムエントリーポイントがありません。
- モデルバージョンは express-deployment(SOD)の対象です。「ステップ 1」を参照してください。
- ワークスペースでプレビューが有効になっています。要件を参照してください。
Serving UIから通常のGPU EndpointとしてEndpointを作成します:
- サービングEndpointの作成 フォームで、エクスプレスデプロイメントの対象となるモデルバージョンとGPUワークロードタイプを選択します。
- throughput を選択します。このチェックボックスは、上記の条件が満たされている場合にのみ表示されます。
- Endpointの設定を完了し、 作成 を選択します。
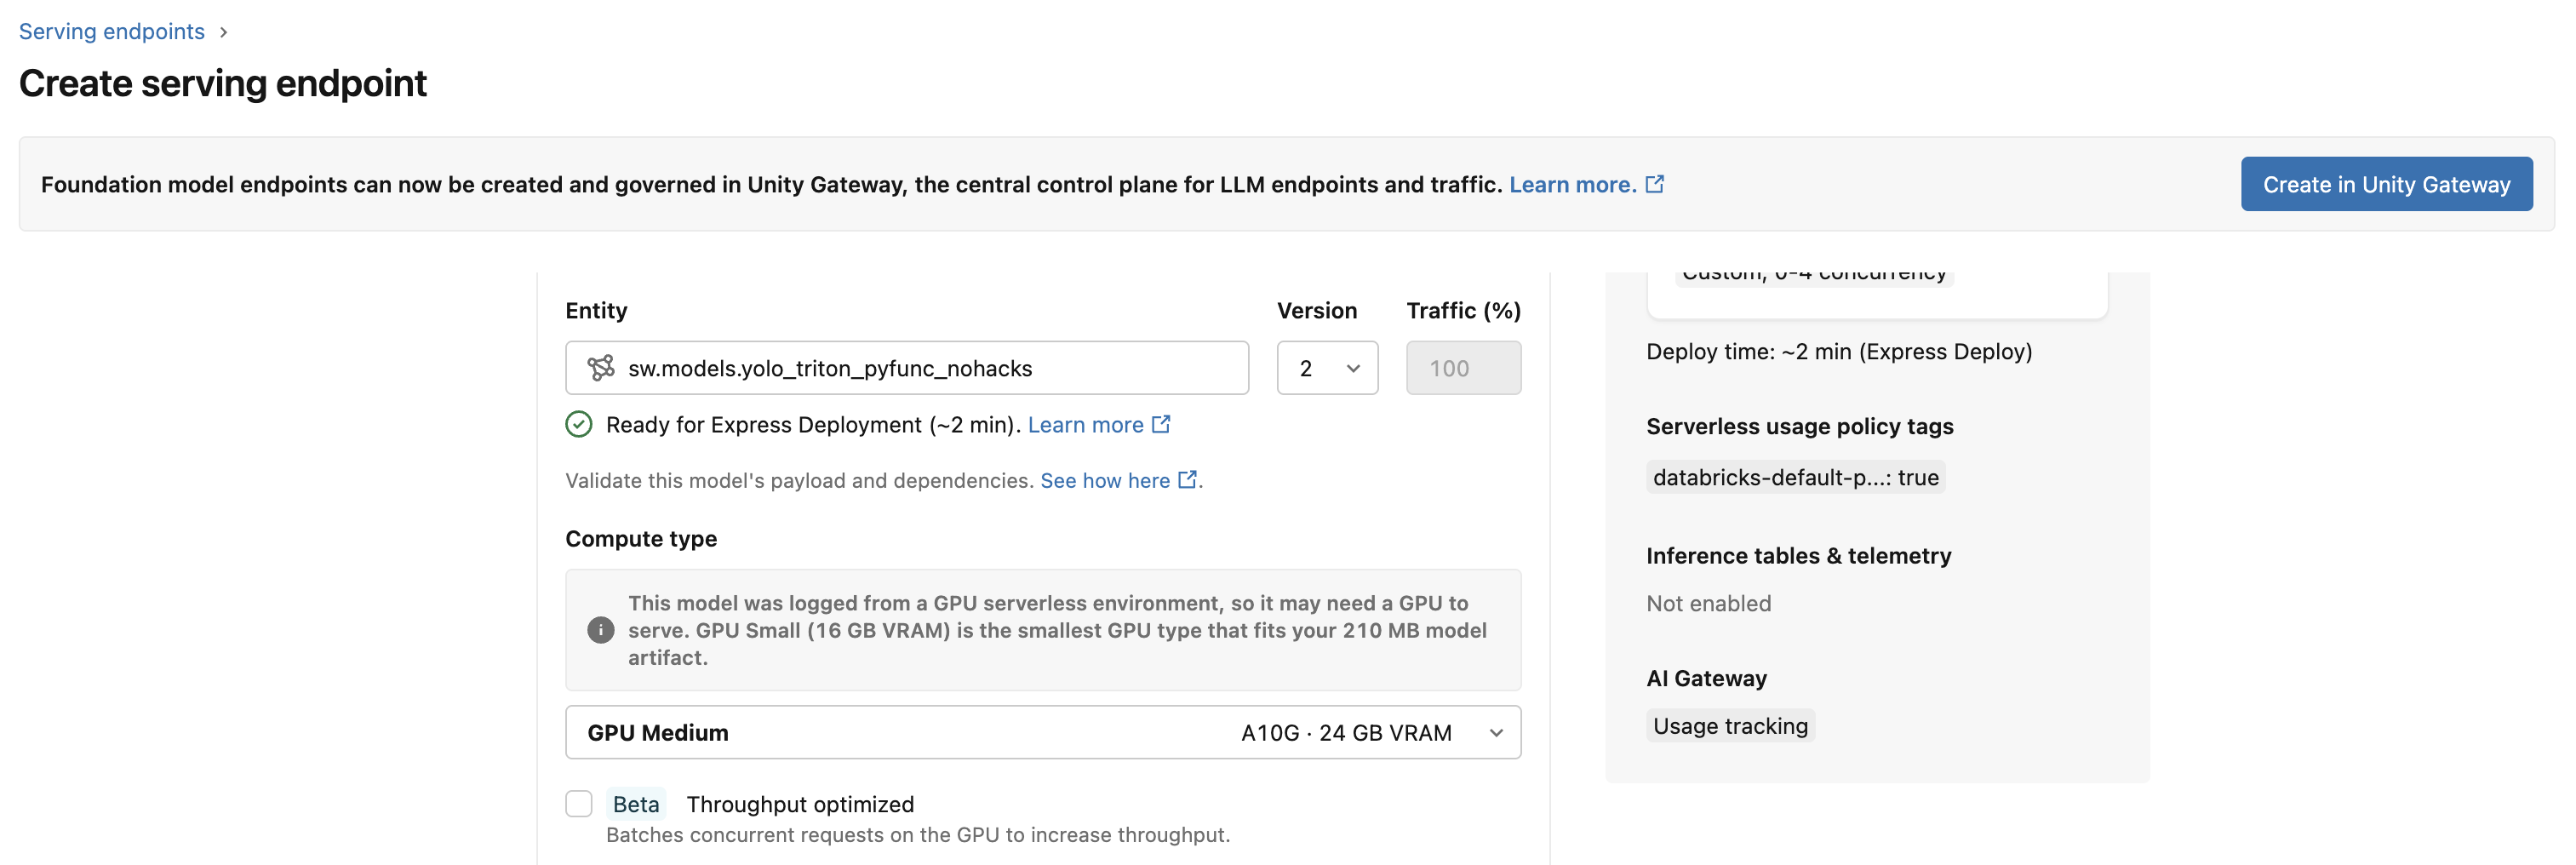
後で設定を変更するには、Endpointを編集して「 throughput optimized」を選択するかクリアしてください。バッチ決定は各展開時に再評価され、次の展開でTritonのロールインまたはアウトが決定され、既に実行中のデプロイに遡って適用されません。
ステップ 3:Endpointをクエリーする
Endpointがサービスを受けているかを確認するために小規模なバッチを送信します。モデルが想定する入力形状と一致させてください。
import numpy as np
import requests

host = "https://<workspace-host>"
endpoint = "my-detector"

batch = np.zeros((2, 3, 224, 224), dtype=np.float32)  # example input shape

resp = requests.post(
    f"{host}/serving-endpoints/{endpoint}/invocations",
    headers={
        "Authorization": f"Bearer {DATABRICKS_TOKEN}",
        "Content-Type": "application/json",
    },
    json={"inputs": batch.tolist()},
)
resp.raise_for_status()
predictions = np.array(resp.json()["predictions"])
ステップ4:Tritonが有効であることを確認します
READYのステータスだけでは、Tritonバックエンドがアタッチされていることを 証明できません 。現在、これ専用のAPIフィールドやUIバッジはなく、READY Endpointはどちらの場合も同じように見えます。次のいずれかで確認します。
- サービス Logs。 Endpoint のサービス Logs で、Triton の Startup 行(Triton Inference Server のバナーとモデル読み込みメッセージ)を確認してください。その存在は、バックエンドがアタッチされたことを意味します。サンプルログを以下に示します。
[ts/g7zw9] I0911 22:42:18.894428 1 cuda_memory_manager.cc:107] "CUDA memory pool is created on device 0 with size 67108864"
[ts/g7zw9] I0911 22:42:18.916439 1 model_lifecycle.cc:473] "loading: model:1"
[ts/g7zw9] I0911 22:42:23.775240 1 python_be.cc:2289] "TRITONBACKEND_ModelInstanceInitialize: model_0_0 (GPU device 0)"
[ts/g7zw9] I0911 22:43:22.356197 1 model_lifecycle.cc:849] "successfully loaded 'model'"
[ts/g7zw9] I0911 22:43:22.357208 1 server.cc:681]
[ts/g7zw9] +-------+---------+--------+
[ts/g7zw9] | Model | Version | Status |
[ts/g7zw9] +-------+---------+--------+
[ts/g7zw9] | model | 1       | READY  |
[ts/g7zw9] +-------+---------+--------+
[ts/g7zw9] I0911 22:43:22.387088 1 grpc_server.cc:2562] "Started GRPCInferenceService at 127.0.0.1:8001"
[ts/g7zw9] I0911 22:43:22.387651 1 http_server.cc:4809] "Started HTTPService at 127.0.0.1:8002"
[ts/g7zw9] I0911 22:43:22.430569 1 http_server.cc:358] "Started Metrics Service at 0.0.0.0:8003"
- Endpoint にアタッチされたバックエンドを確認するには、 Databricks アカウント チームにお問い合わせください 。そうでない場合は、理由を確認できます。一般的な原因については、トラブルシューティングを参照してください。
次に、現実的な同時実行環境でベンチマークを実行してください。Triton の throughput 向上は負荷がかかった状態で現れ、バッチ処理によってリクエストごとのレイテンシが多少増加するため、ロールアウトする前に両方を測定してください。
(オプション)バッチ処理のチューニング
バッチ処理のdefaultはデプロイごとに調整可能です。Endpointに合わせて調整するには、Databricksアカウントチームにお問い合わせください。
トラブルシューティング
問題 | 原因と修正 |
|---|---|
| throughputの最適化が有効になっていないか、プレビューがオフになっています。プレビューがオンになっていること、および throughputの最適化 が有効になっていることを確認し(ステップ2)、再デプロイしてください。 |
Triton バックエンドがないため、デプロイはフォールバックしました。 | このモデルはエクスプレスデプロイメントパスにありません。 |
非Triton Endpointと比較してthroughputの向上はありません | このモデルはGPUに依存していません(GPUがアイドル状態であったり、前処理がCPUに依存したりすることはありません)。これは想定内のことです。ビジョンモデルの場合、画像のデコードとリサイズ処理をGPUで行うようにします。 |
Tritonは大きな入力値でクラッシュする |
|
Endpointは定常状態のトラフィック中に、最大同時実行数まで過剰にプロビジョニングします。 | オートスケールは現在アグレッシブであり、早期に最大同時実行数までプロビジョニングされる可能性があります。オートスケールをより保守的にチューニングするには、Databricks アカウント チームにお問い合わせください。 |
フィードバックや質問については、Databricksアカウントチームにお問い合わせください。