評価と改善
コーディングエージェントのクイックスタート
コーディングエージェントを使用していますか?次のプロンプトを貼り付けます:
Read the documentation at https://docs.databricks.com/aws/en/mlflow3/genai/eval-monitor and set up evaluation for my agent using scorers and an evaluation dataset.
MLflow との統合を深めるには、必要に応じて mlflow/skills をインストールしてください。
評価では、エージェントが実際に優れているかどうか(応答が正確、根拠がある、安全である、完全であるか)を測定します。MLflow は、品質評価を各トレースに添付する LLM ジャッジやコードベースのチェックなどの スコアラー を使用してトレースをスコア付けします。まずは UI からいくつかのトレースをスコア付けし、アプリの成熟に伴って同じスコアラーを繰り返し可能な mlflow.genai.evaluate() ループに移行します。
クイック概要: UI からのトレースのスコアリング
コードを使用せずに、既存のトレースを評価します:
-
In the Traces tab, select a few traces using the row checkboxes.
-
Actions をクリックし、 Evaluate を選択します。
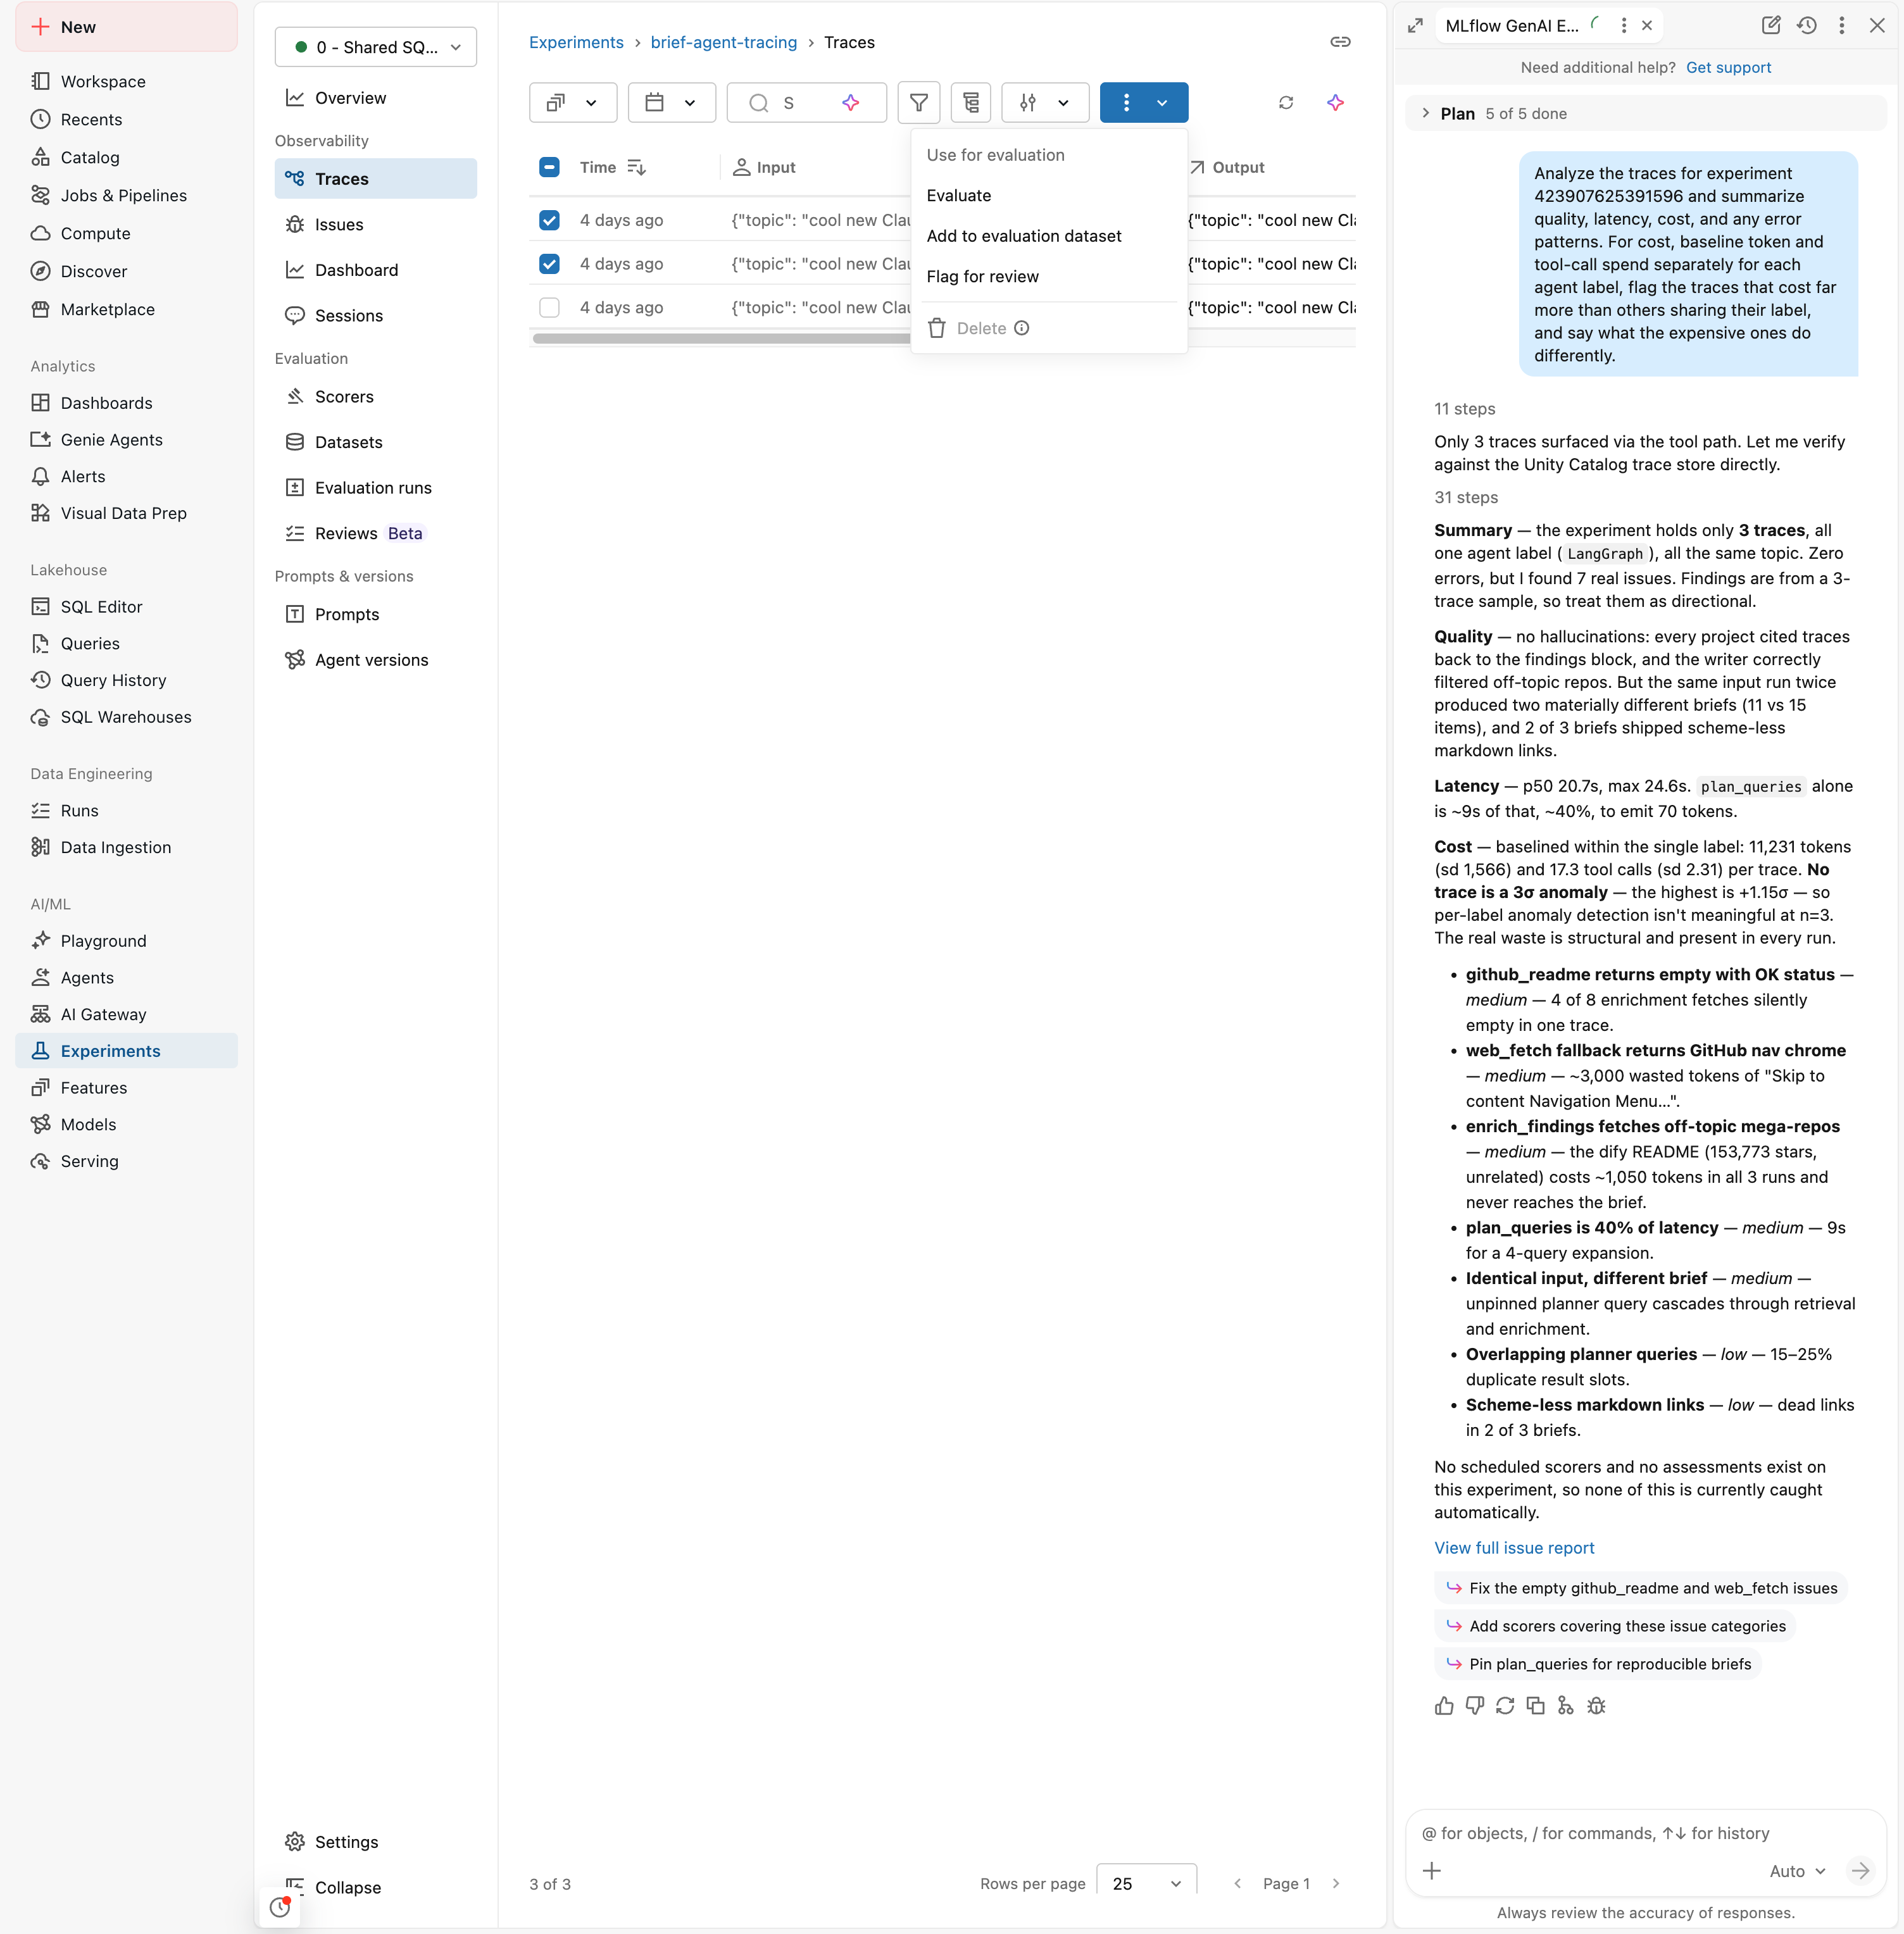
-
ラン スコアラー ダイアログで、1つ以上のスコアラーを選択します: 構築済みLLMジャッジ スコアラー(正しさ、完全性、流暢性など)から選択するか、既存の 登録済みスコアラー のいずれかを再利用するか、 [スコアラーの作成] をクリックします。
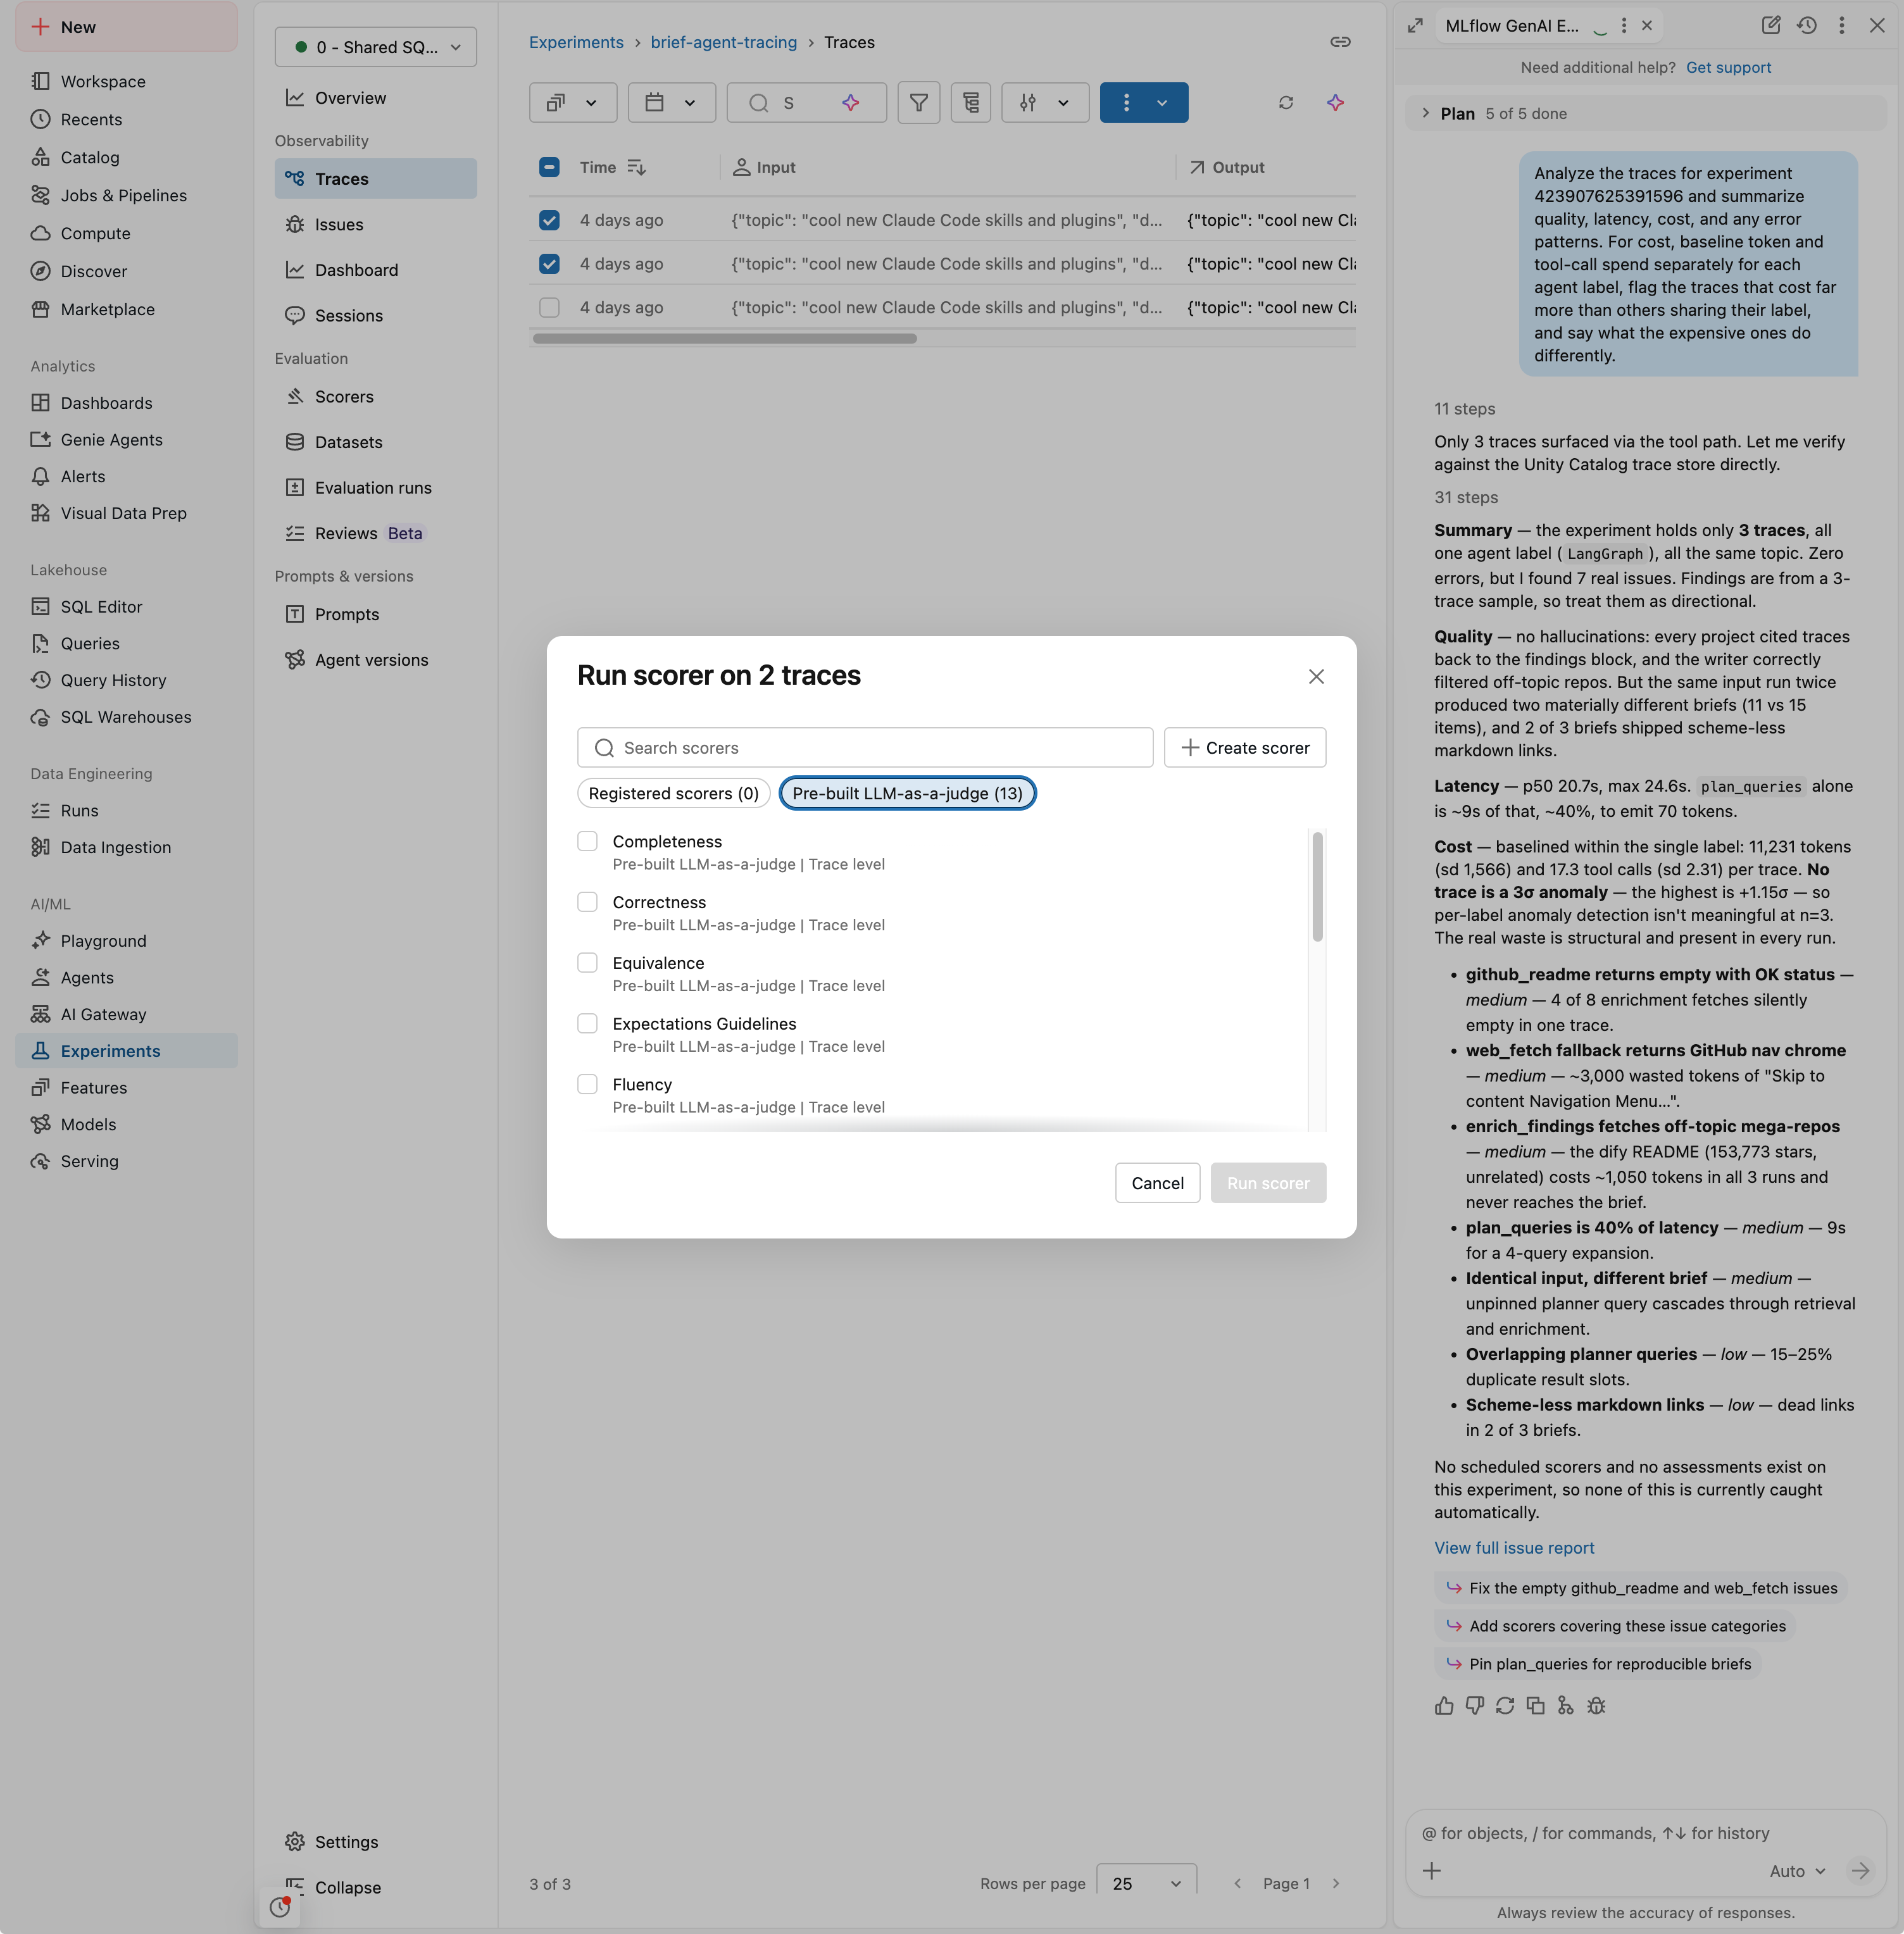
-
[スコアラーを実行] をクリックします。MLflowは選択したトレースに対してスコアラーを実行し、各結果をフィードバックとしてそのトレースに添付し、 [評価ラン] tabの下にランを記録します。
これは、プログラムによる評価を実行するのと同じスコアリングです。ここで選択したジャッジは組み込みの LLM ジャッジであり、結果はエクスペリメント内のスコアラーフィードバック付きのトレースとして記録されます。
次のステップ
- チュートリアル: エージェントの評価と改善 — 評価データセットに対して
mlflow.genai.evaluate()を実行し、アプリのバージョン全体を一度にスコアリングしてバージョンを比較します。 - スコアラーとLLMジャッジ — 組み込みのジャッジ、それぞれの測定内容、およびそれらの使用時期。
- 本番運用モニタリングを設定 — 本番運用トラフィックのサンプルに対して、これらと同じスコアラーを自動的に実行します。