フィードバックを収集してデータセットを構築する
コーディング エージェントのクイックスタート
コーディングエージェントを使用していますか?このプロンプトを貼り付けてください:
Read the documentation at https://docs.databricks.com/aws/en/mlflow3/genai/human-feedback and set up human feedback collection and evaluation datasets for my agent.
MLflowとのより深い統合のために、必要に応じてmlflow/skillsをインストールしてください。
人間による判断 (開発者、ユーザー、ドメイン エキスパートからの評価、コメント、正解データとなる期待値) により、評価がアプリにとっての「良好」の実際の意味と一致した状態に保たれます。MLflowでは、その判断をトレースに直接記録でき、正解データの期待値を持つトレースは、自動評価のためのすぐに使えるテストケースになります。
クイック概要: トレースをテストケースに変換する
- Traces tabで、トレースをクリックして開きます。
- [評価] をクリックし、 [期待値の追加] をクリックして正解(グラウンドトゥルース)を記録します。期待値は、その入力、出力、およびその他のフィードバックとともにトレースに保存されます。
- [Dataset に追加] をクリックして、トレースをエクスペクテーションとともに評価データセットに追加します。
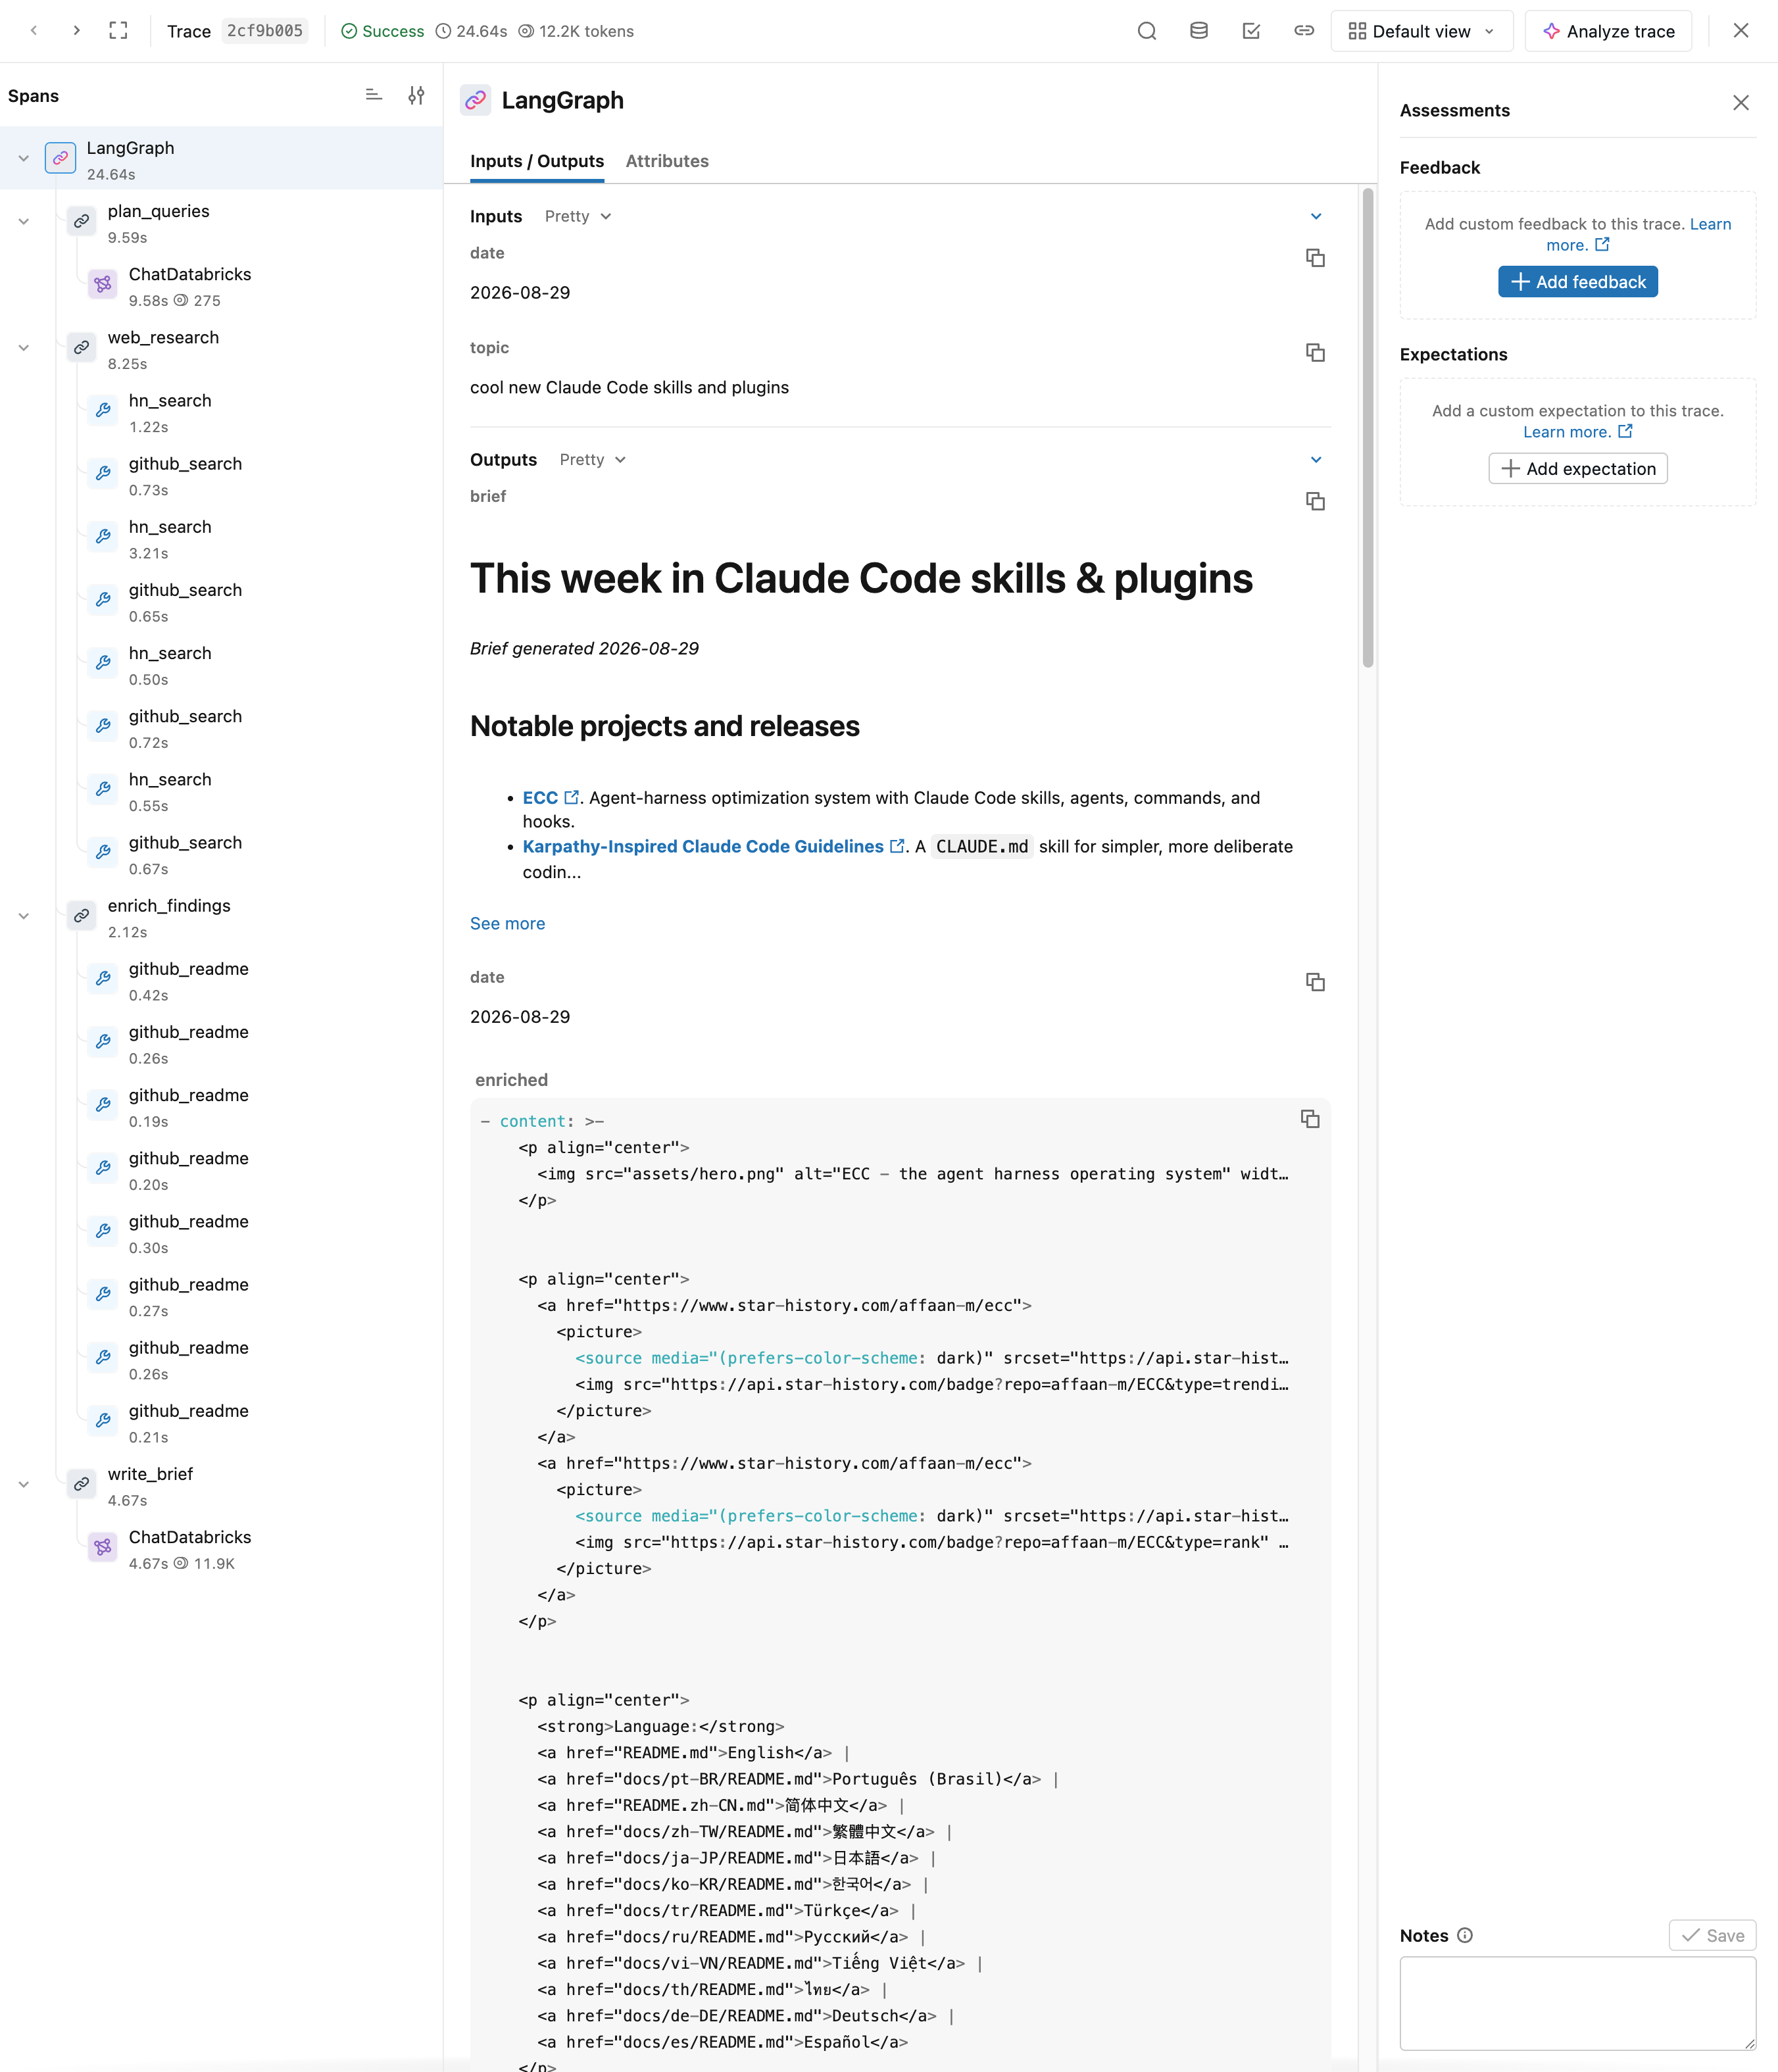
そのトレースがテストケースになりました。実際のインタラクションで期待される回答をキャプチャし、将来のバージョンを評価できるデータセットに昇格させました。フィードバックはトレースに紐づいているため、開発者だけでなくトレースをレビューするすべての人が、トレースUIを離れることなくこれを行うことができます。
フィードバックを残すユーザー
フィードバックには2つの形式があります。 フィードバック はアプリの実際の出力を評価し(応答は良好でしたか?)、 期待値 は正解であるグラウンド トゥルース出力を定義します。判定の各ソースには独自のメカニズムがあります。
開発者
品質ノートを追跡し、回帰テスト用の例をマークするために、構築時にトレースに注釈を付けます。開発者としてトレースにラベルを付けるを参照してください。
ドメイン エキスパート
Review Appを通じて分野の専門家に協力を依頼し、高品質な応答がどのようなものかを定義するとともに、LLMジャッジをビジネス要件に合わせて調整します。アプローチは2つあります。Chat UIでエージェントをテストするか、専門家やコラボレーターがトレースにラベルを付けられるようにするかです。
新しい人間のレビューによるワークフローの場合、Databricks では、トレースやデータセット レコードを 1 つずつレビュアーにルーティングするレビュー キュー(ベータ)を推奨しています。
エンドユーザー
デプロイされたアプリのユーザーからのフィードバックをキャプチャして、問題のあるクエリーを検出し、成功したインタラクションを保存します。トレースのエンリッチ: タグ、コンテキスト、およびフィードバックを参照してください。
次のステップ
- 専門家やコラボレーターによるトレースのラベル付けを有効にする - ドメインの専門家やコラボレーターを招いてトレースにラベルを付けます。
- MLflow 評価データセットの構築 - ラベル付けされたトレースとエクスペクテーションをデータセットにパッケージ化します。
- 評価と改善 - 作成したデータセットに対してアプリを評価し、改善します。