同期されたテーブルでレイクハウスデータを提供する
同期テーブルを使用すると、Unity Catalog から Lakebase Postgres を通じてアナリティクス グレードのデータを提供できます。Unity Catalog テーブルは Postgres に同期されるため、アプリケーションは低レイテンシで lakehouse データを直接クエリーできます。このプロセスは一般にリバース ETL(抽出、変換、ロード)と呼ばれます。lakehouseはアナリティクスと強化のために最適化されており、Lakebase は高速なルックアップ スタイルのクエリーと完全なACIDトランザクションを必要とする運用ワークロード向けに設計されています。同期されたテーブルは、リアルタイム アプリケーションでデータを提供できる状態を維持することで、分析ストレージと運用システム間のギャップを埋めます。
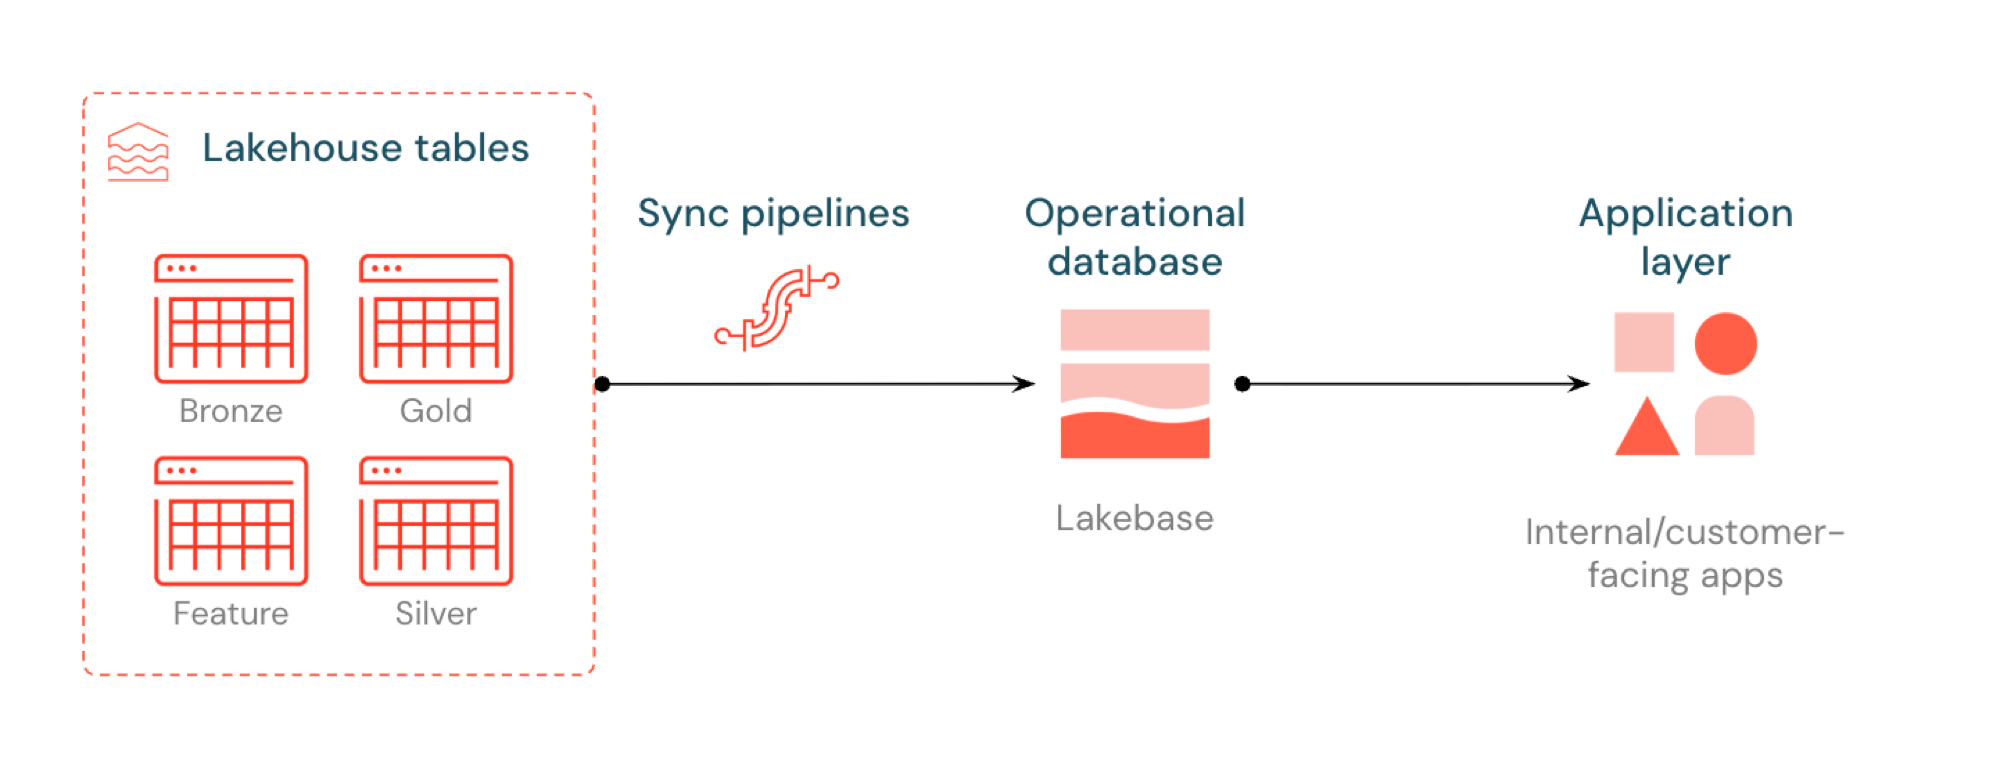
使用例
同期テーブルは、次のようなデータ提供のユースケースに使用できます。
- Databricks Appsに最新のユーザー プロファイルを提供するパーソナライゼーション エンジン
- モデル予測や特徴量を提供するアプリケーション レイクハウスのコンピュート
- KPIをリアルタイムで表示する顧客向けダッシュボード
- リスクスコアを提供し、即時の対応を可能にする不正行為検出サービス
- レイクハウスデータから強化された顧客レコードを提供するサポートツール
サポートされているソース
同期されたテーブルは、次のUnity Catalogソース タイプをサポートします。
- 管理対象および外部Deltaテーブル
- 管理対象および外部の Iceberg テーブル
- ビューとマテリアライズドビュー
仕組み
Databricks 同期テーブルは、 Lakebase にUnity Catalogデータの管理されたコピーを作成します。 同期されたテーブルを作成すると、次のものが得られます。
- 同期パイプラインを参照する Unity Catalog 内の同期テーブル
- Lakebase の Postgres テーブル (読み取り専用、アプリケーションからクエリ可能)
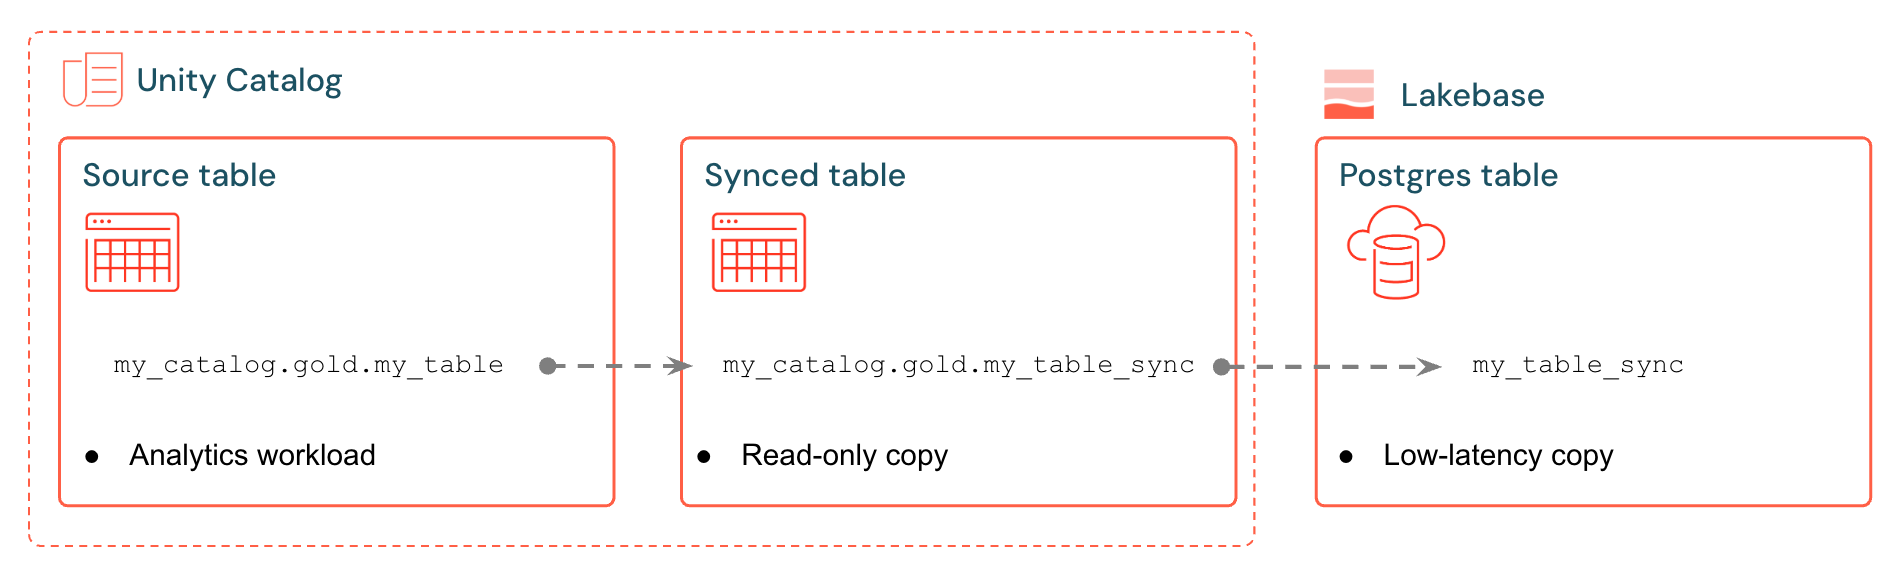
たとえば、ゴールド テーブル、エンジニアリングされた特徴、または ML 出力をanalytics.gold.user_profilesから新しい同期テーブルanalytics.gold.user_profiles_syncedに同期できます。Postgres では、Unity Catalog スキーマ名は Postgres スキーマ名になるため、 gold.user_profiles_syncedのように表示されます。
SELECT * FROM gold.user_profiles_synced WHERE user_id = 12345;
アプリケーションは標準の Postgres ドライバーで接続し、同期されたデータを独自の運用状態と一緒にクエリーし、同じデータベース内の独自のテーブルへの挿入、更新、削除を処理します。
同期パイプラインは、マネージド LakeFlow Pipelines を使用して、ソース テーブルからの変更で Unity Catalog 同期テーブルと Postgres テーブルの両方を継続的に更新します。各同期では、Lakebase データベースへの最大 16 個の接続を使用できます。接続制限は、コンピュートサイズによって異なります。コンピュート仕様を参照してください。
Postgres で同期テーブルを直接変更することは可能ですが、 Databricksソースによるデータ完全性を保護するために読み取りクエリのみを実行することを強くお勧めします。 同期テーブルでサポートされている操作については、 「Postgres の同期テーブルで許可されている操作」を参照してください。
LTAP Direct Writes による高速同期
ベータ版
LTAP 直接書き込みはベータ版です。同期テーブルが一般提供されています。
LTAP 直接書き込みは、大量のロードを高速化するオプションの同期テーブル設定です。これはLTAPアーキテクチャの一部です。defaultではオフになっており、 同期テーブルの作成 ダイアログの 同期設定 の下にある LTAP直接書き込み を選択することで、同期テーブルごとにオプトインします。有効にすると、ライブ コンピュート Endpointを介して一括書き込みをルーティングする代わりに、データの書き込みが Lakebase Branchを支えるストレージ層に直接行われるため、ロードがより速く完了し、実行中にエンドポイントにクエリー負荷が追加されることはありません。
LTAP Direct Writes が何を高速化するかは、同期モードによって異なります:
- すべてのモード : 初期ロード。すべての同期テーブルはソースの完全コピーをロードすることから始まり、その最初のロードで LTAP Direct Writes が使用されます。
- スナップショット : スナップショット モードは毎回完全更新を実行するため、その後のすべての同期。
- Trigger および 連続 : 初期ロードのみ。その後の更新は一括ロードではなく、チェンジデータフィードを通じて増分的に適用されます。
LTAP 直接書き込みは、Postgres 16、17、または 18 を実行する Lakebase プロジェクトでサポートされています。 LTAP 直接書き込み のチェックボックスが表示されない場合は、ワークスペース管理者がプレビュー ページ から LTAP 直接書き込み プレビューを有効にする必要があります。LTAP 直接書き込みは同期テーブルを作成するときに選択するため、既存の同期テーブルに後から追加することはできません。既存の同期テーブルで LTAP 直接書き込みを使用するには、その同期テーブルを削除し、新しいテーブルを作成します。
同期モード
アプリケーションのニーズに応じて適切な同期モードを選択します。
モード | 説明 | いつ使うか | パフォーマンス |
|---|---|---|---|
スナップショット | すべてのデータの1回限りのコピー | ソースの変更がサイクルあたり行数の10%を超えています | ソースデータの10%以上を変更する場合、10倍の効率化 |
トリガー | オンデマンドまたは一定間隔で実行されるスケジュール更新 | ソース行は既知の周期で変更されます。挿入、更新、削除は更新ごとに伝播されます。 | コストとラグのバランスが良い。5分間隔で実行すると高価になります |
連続 | 数秒の遅延でリアルタイムストリーミング | 変更はLakebaseにほぼリアルタイムで反映される必要がある | 遅延は最低、コストは最高。最小15秒間隔 |
同期テーブルの作成 ダイアログでは、 スナップショット と Trigger はいずれも 詳細設定 で使用できる オンデマンド の同期モードですが、 連続 は別のモードです。
ソースの要件は同期モードによって異なります。
- スナップショット は同期のたびにすべてのデータをコピーするため、ソースは
SELECT *をサポートしている必要があります。 - Triggered (トリガー)および Continuous (連続)は行レベルの変更を増分的に適用するため、ソースはチェンジデータフィードを提供する必要があります。ソースで書き込み時の チェンジデータフィード を有効にするか、自動チェンジデータフィードを使用してください。Triggered または Continuous ソースにチェンジデータフィードがない場合、UI に実行すべき正確な
ALTER TABLEコマンドを含む警告が表示されます。
自動チェンジデータフィードは、ソースでの書き込み時のチェンジデータフィードを必要とする代わりに、読み取り時に行レベルの変更を計算します。これにより、 Apache Iceberg テーブルを含む多くのソースタイプが、 トリガー または 連続 モードで同期できるようになります。自動チェンジデータフィードがサポートするソースタイプについては、自動チェンジデータフィードのドキュメントを参照してください。
同期テーブルを作成する
前提条件
必要なもの:
- Lakebase が有効になっている Databricks ワークスペース。
- Lakebase プロジェクト (プロジェクトの作成を参照)。
- 同期するUnity Catalogテーブル。
- 同期テーブルを作成するための権限。使用するスキーマで USE_SCHEMA および CREATE_TABLE 権限が必要です。これらの権限を付与するには、Unity Catalog での権限の管理を参照してください。
Triggered または Continuous モードの場合、ソースでチェンジデータフィードを提供する必要があります。対象となる Delta Lake ソース テーブルでレガシーなチェンジデータフィードを有効にするか、Apache Iceberg テーブルなどのソースに対して自動チェンジデータフィードを使用します。
Deltaソーステーブルで書き込み時のチェンジデータフィードを有効にするには、以下を実行します:
ALTER TABLE your_catalog.your_schema.your_table
SET TBLPROPERTIES (delta.enableChangeDataFeed = true)
同期テーブルを作成する前に、次の点を確認してください。
- ソース : サポートされているソースタイプは、 サポートされているソースに一覧表示されます。
- 名前と制限 : 命名規則、接続の使用、ソースごとの制限はキャパシティ プランニングに記載されています。
- 列のデータ型 : 型のマッピング、サポートされていないデータ型、同期エラーを引き起こす文字については、データ型と互換性を参照してください。
- 作成者のID : 同期テーブルを作成したIDには、そのテーブルへのアクセス権が付与されます。後でそのアクセス権を再割り当てすることはできません。同期テーブルを作成するユーザーのアクセス権を参照してください。
- UI
- CLI
- Python SDK
- Java SDK
- curl
-
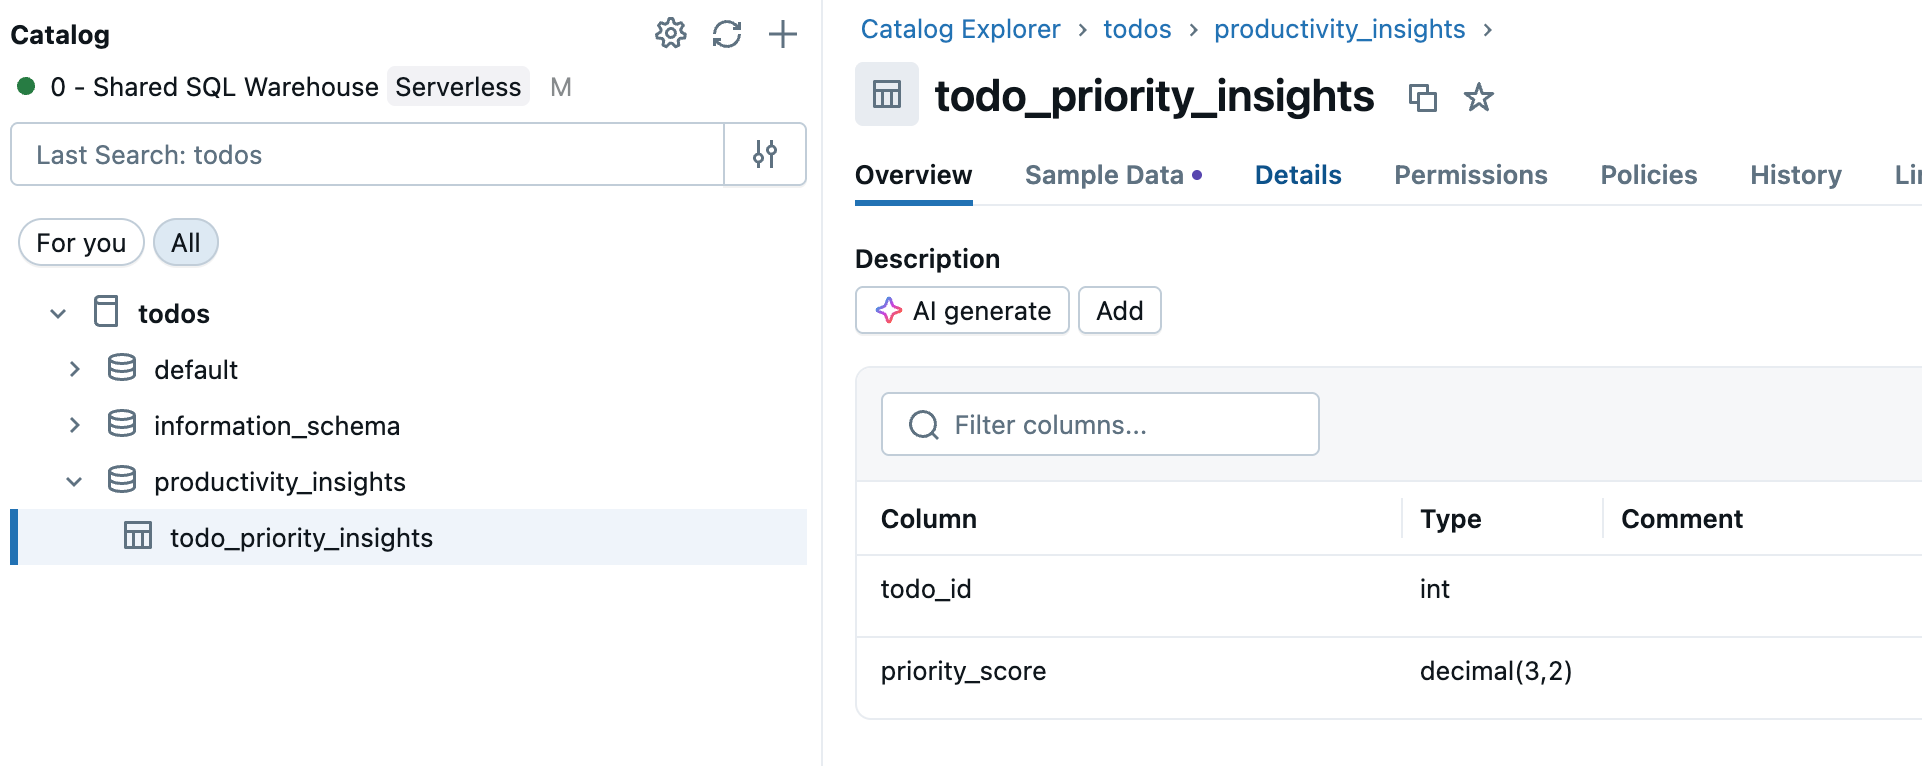
Lakehouse で、ワークスペースのサイドバーにある Catalog に移動し、同期する Unity Catalog テーブルを選択します。
-
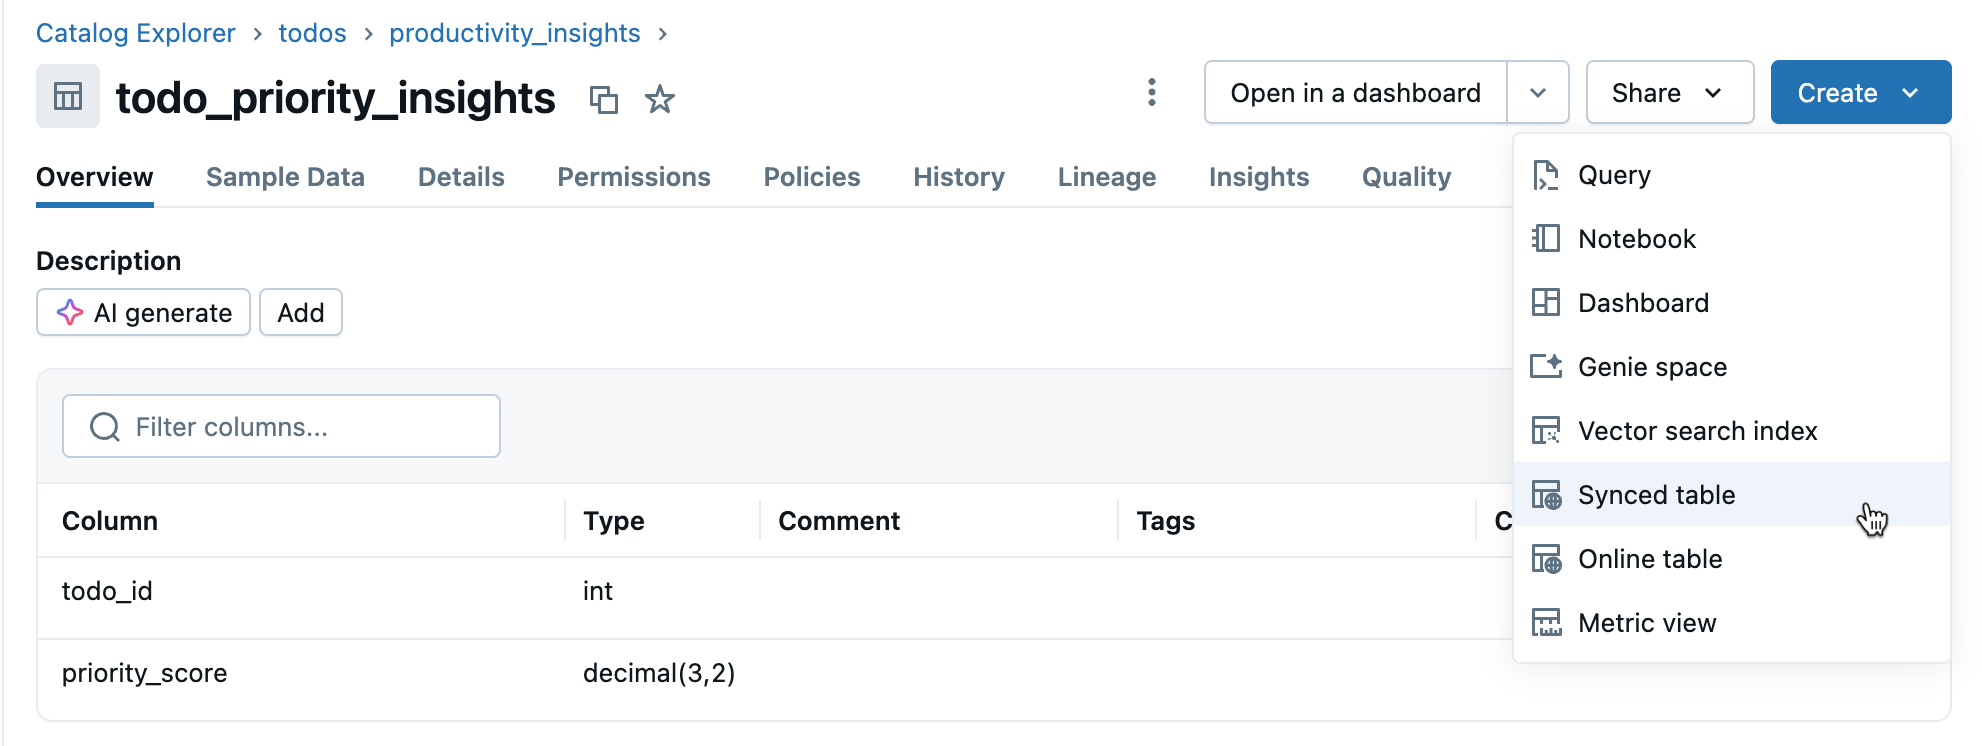
テーブルの詳細ビューから、 [作成] > [同期されたテーブル] をクリックします。
-
同期テーブルを作成 ダイアログで以下のセクションを設定し、 作成 をクリックします。
配信先
- Name :同期するテーブルのカタログとスキーマを選択し、テーブル名を入力します。これにより、Unity Catalog同期テーブルとクエリー可能なPostgresテーブルの両方が作成されます。カタログおよびスキーマのリストには、 USE_SCHEMA 権限および CREATE_TABLE 権限を持っているUnity Catalogのスキーマのみが含まれます。期待するスキーマが表示されない場合は、カタログ管理者に権限を確認してください。
- Lakebase Postgresデータベース : Database type を オートスケール に設定し、 Project 、 Branch 、 Postgres database を選択します。
同期設定
-
同期モード : オンデマンド または 連続 を選択します。 オンデマンド の場合は、 詳細設定 を展開し、 スナップショット または Trigger を選択します。ガイダンスについては、同期モードを参照してください。
-
LTAPダイレクト書き込み : (オプション) 初回ロードを高速化する場合は、このチェックボックスを選択します。このオプションは、Postgres 16、17、または 18 を実行している Lakebase プロジェクトでサポートされています。このチェックボックスが表示されない場合は、ワークスペース管理者が プレビュー ページ から LTAPダイレクト書き込み を有効にする必要があります。LTAPダイレクト書き込みによる高速同期を参照してください。
パイプライン設定
- パイプライン :この同期されたテーブル用のパイプラインを作成するには Create new を選択し、再利用するには Use existing を選択します。
- Serverless使用ポリシー :(オプション)同期パイプラインのServerless使用ポリシーを選択します。
スキーマ
- プライマリーキー : プライマリーキーを確認します(通常は自動検出されます)。各プライマリ・キー値がソース内で一意である場合、 一意 を選択したままにします。プライマリ・キー値が繰り返される可能性がある場合は、 一意 を解除し、 時系列キー を設定します。同期テーブルを作成した後、プライマリ・キーまたは時系列キーを変更することはできません。
同期されたテーブルでは、主キーの列はNULL値を許容しません。主キー列にNULL値を持つ行は 同期から除外されます 。
-
Timeseries Key :(オプション)ソース内で主キー値が重複する可能性がある場合は、列を選択して重複排除を構成します。その後、同期されたテーブルには、各主キーの最新の時系列キー値を持つ行のみが含まれます。時系列キーのない障害モードについては、重複するキーを参照してください。
-
列タイプのカスタマイズ : (オプション) ソース列を Postgres 型にマッピングする方法を上書きします。列を
vectorまたはhalfvecにマッピングする場合は、最初に宛先データベースにベクター拡張機能をインストールしてください。カスタム型マッピングを参照してください。
Trigger または Continuous を選択していて、まだチェンジデータフィードを有効にしていない場合は、ランする正確なコマンドを示す警告が表示されます。 4. カタログ 内の同期済みテーブルを監視します。 概要 タブには、同期ステータス、構成、パイプラインステータス、および最終同期タイムスタンプが表示されます。手動で更新するには、 今すぐ同期 してください。
databricks postgres create-synced-table my-catalog.sales.orders \
  --json '{
    "spec": {
      "source_table_full_name": "main.sales.orders",
      "branch": "projects/my-project/branches/production",
      "primary_key_columns": ["order_id"],
      "scheduling_policy": "SNAPSHOT",
      "postgres_database": "mydb",
      "create_database_objects_if_missing": true
    }
  }'
SYNCED_TABLE_ID の位置引数は catalog.schema.table の形式を使用します。Postgresでは、テーブル {table} は、postgres_database (ここでは mydb) で設定したデータベース内のスキーマ {schema} で作成されます。コマンドは、デフォルトで操作が完了するのを待機します。利用可能なすべてのオプションについては、databricks postgres create-synced-tableを参照してください。
defaultの列型のマッピングを上書きするには、 type_overrides を spec に追加します。カスタム型マッピングを参照してください。
from databricks.sdk import WorkspaceClient
from databricks.sdk.service.postgres import (
    SyncedTable,
    SyncedTableSyncedTableSpec,
    SyncedTableSyncedTableSpecSyncedTableSchedulingPolicy,
)

w = WorkspaceClient()

synced_table = w.postgres.create_synced_table(
    synced_table=SyncedTable(spec=SyncedTableSyncedTableSpec(
        source_table_full_name="main.sales.orders",
        branch="projects/my-project/branches/production",
        primary_key_columns=["order_id"],
        scheduling_policy=SyncedTableSyncedTableSpecSyncedTableSchedulingPolicy.SNAPSHOT,
        postgres_database="mydb",
        create_database_objects_if_missing=True,
    )),
    synced_table_id="my-catalog.sales.orders",
).wait()

print(f"Synced table created: {synced_table.name}")
synced_table_idはcatalog.schema.table形式を使用し、 Unity Catalog同期テーブル名になります。 Postgresでは、 {table}テーブルは、 {schema}スキーマ内に作成され、 postgres_databaseで設定したデータベース(ここではmydb )内に配置されます。
import com.databricks.sdk.WorkspaceClient;
import com.databricks.sdk.service.postgres.*;
import java.util.List;

WorkspaceClient w = new WorkspaceClient();

SyncedTable syncedTable = w.postgres().createSyncedTable(
    new CreateSyncedTableRequest()
        .setSyncedTableId("my-catalog.sales.orders")
        .setSyncedTable(new SyncedTable()
            .setSpec(new SyncedTableSyncedTableSpec()
                .setSourceTableFullName("main.sales.orders")
                .setBranch("projects/my-project/branches/production")
                .setPrimaryKeyColumns(List.of("order_id"))
                .setSchedulingPolicy(SyncedTableSyncedTableSpecSyncedTableSchedulingPolicy.SNAPSHOT)
                .setPostgresDatabase("mydb")
                .setCreateDatabaseObjectsIfMissing(true))))
    .waitForCompletion();

System.out.println("Synced table created: " + syncedTable.getName());
curl -X POST "https://your-workspace.cloud.databricks.com/api/2.0/postgres/synced_tables?synced_table_id=my-catalog.sales.orders" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" \
  -H "Content-Type: application/json" \
  -d '{
    "spec": {
      "source_table_full_name": "main.sales.orders",
      "branch": "projects/my-project/branches/production",
      "primary_key_columns": ["order_id"],
      "scheduling_policy": "SNAPSHOT",
      "postgres_database": "mydb",
      "create_database_objects_if_missing": true
    }
  }'
これは、実行時間の長い操作を返します。返されたnameフィールドをdone: trueになるまでポーリングします。長時間実行される操作を参照してください。認証設定については、 「認証」を参照してください。
後続の同期をスケジュールまたはトリガーする
同期テーブルを作成すると、初期ロードが自動的に実行されます。その後、同期のラン方法は同期モードによって異なります。
- 連続 モードでは、変更が発生するたびに変更がストリームされます。同期をTriggerする必要はありません。
- スナップショット モードと Trigger モードは、Triggerされたときにのみ同期されます。同期を手動でランするには、 カタログ で同期されたテーブルを開き、 概要 tabで 今すぐ同期 をクリックします。同期を自動的に実行するには、同期されたテーブルのパイプラインをLakeflow Jobsのジョブに Database Table Sync パイプライン タスクとして追加し、次のいずれかのTriggerを使用するようにジョブを構成します:
- ソース テーブルの更新でトリガーする: Trigger モードに最適です。
- スケジュールでTrigger: スナップショット モードに最適です。
ソーステーブルの更新時にトリガーする
ソースUnity Catalogテーブルが更新されたときにジョブを起動します。 トリガー モードでは、新しい変更のみが段階的に適用されるため、継続モードのような常時オンのコストをかけずに、ほぼリアルタイムの最新状態が提供されます。
- ワークスペースで、サイドバーの
 ジョブ & パイプライン をクリックします。
- [ジョブの作成] をクリックするか、既存のジョブを開きます。
- [タスク] タブで、 [+ 別のタスク タイプを追加] をクリックします。
- [取り込みと変換] の下で、 [データベース テーブル同期パイプライン] を選択します。
- [パイプライン] フィールドで、同期テーブルに関連付けられたパイプラインを選択します。
- [スケジュールとトリガー] の下で、 [トリガーの追加] をクリックします。
- トリガー タイプとして テーブル更新を 選択します。
- [テーブル] の下で、監視するソースUnity Catalogテーブルを選択します。
- 保存 をクリックします。
スケジュールに従ってトリガーする
一定のリズムで同期を実行します。夜間または毎週の完全更新が最も効率的なパターンとなる スナップショット モードに適しています。
- ワークスペースで、サイドバーの ジョブ & パイプライン をクリックします。
- [ジョブの作成] をクリックするか、既存のジョブを開きます。
- [タスク] タブで、 [+ 別のタスク タイプを追加] をクリックします。
- [取り込みと変換] の下で、 [データベース テーブル同期パイプライン] を選択します。
- [パイプライン] フィールドで、同期テーブルに関連付けられたパイプラインを選択します。
- [スケジュールとトリガー] の下で、 [トリガーの追加] をクリックします。
- トリガー タイプとして [スケジュール済み] を選択します。
- cron スケジュールとタイムゾーンを設定し、 「保存」 をクリックします。
同期ステータスを確認する
同期済みテーブルの現在の状態と最終同期時刻を確認するには:
同期中、パイプラインは INITIALIZING イベントを報告しながらすべてのデータ処理を実行します。大規模な同期では、フルランに対して INITIALIZING が報告される場合があります。これは想定内の挙動であり、パイプラインが停止していることを意味するものではありません。
- UI
- Python SDK
- Java SDK
- curl
カタログ で、同期済みのテーブルに移動し、 「概要」 タブを選択します。現在の同期状態、パイプラインの状態、および最終同期のタイムスタンプが表示されます。
from databricks.sdk import WorkspaceClient

w = WorkspaceClient()

table = w.postgres.get_synced_table("synced_tables/my-catalog.sales.orders")
print(f"State: {table.status.detailed_state}")
print(f"Last sync: {table.status.last_sync_time}")
print(f"Message: {table.status.message}")
import com.databricks.sdk.WorkspaceClient;
import com.databricks.sdk.service.postgres.SyncedTable;

WorkspaceClient w = new WorkspaceClient();

SyncedTable table = w.postgres().getSyncedTable("synced_tables/my-catalog.sales.orders");
System.out.println("State: " + table.getStatus().getDetailedState());
System.out.println("Last sync: " + table.getStatus().getLastSyncTime());
System.out.println("Message: " + table.getStatus().getMessage());
curl "https://your-workspace.cloud.databricks.com/api/2.0/postgres/synced_tables/my-catalog.sales.orders" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}"
データ型と互換性
同期テーブルの作成時に、 Unity Catalog データ型は Postgres 型にマッピングされます。複合型(ARRAY、 MAP、 STRUCT)および VARIANT は、 Postgres では JSONB として格納されます。
ソース列タイプ | Postgresの列タイプ |
|---|---|
BIGINT | BIGINT |
バイナリ | バイト |
ブール値 | ブール値 |
DATE | DATE |
DECIMAL(p,s) | NUMERIC |
DOUBLE | DOUBLE PRECISION |
FLOAT | REAL |
INT | INTEGER |
INTERVAL | INTERVAL |
SMALLINT | SMALLINT |
STRING | TEXT |
TIMESTAMP | TIMESTAMP WITH TIME ZONE |
TIMESTAMP_NTZ | TIMESTAMP WITHOUT TIME ZONE |
TINYINT | SMALLINT |
ARRAY<elementType> | JSONB |
MAP<keyType,valueType> | JSONB |
STRUCT<fieldName:fieldType[, ...]> | JSONB |
バリエーション | JSONB |
GEOGRAPHY、GEOMETRY、およびOBJECTのデータ型はサポートされていません。
カスタム型マッピング
同期テーブルを作成する際、type_overrides を使用して特定の列の default Delta-to-Postgres 型マッピングを上書きできます。
vector型およびhalfvec型には、アップグレード先データベースでのベクトル拡張機能が必要です。同期テーブルを作成しても拡張機能はインストールされないため、同期テーブルを作成する前にインストールしてください。lakebase_vector を使用してください。これはLakebase Searchを通じて近似最近傍(ANN)ベクトル検索を追加し、依存関係として pgvector をインストールします:
CREATE EXTENSION IF NOT EXISTS lakebase_vector CASCADE;
Lakebase Search を使用せずに vector 型および halfvec 型を使用するには、CREATE EXTENSION IF NOT EXISTS vector; を使用して pgvector を個別にインストールしてください。varchar型には拡張機能は不要です。
ソース列タイプ | PostgreSQL型 | サイズ | 定義 ( | 使用例 |
|---|---|---|---|---|
|
| エンベディングの次元 |
| エンベディングを |
|
| エンベディングの次元 |
| 半精度エンベディング。ストレージ容量は約半分です。 |
|
| 最大長 |
| defaultの代わりに、長さ制限付きの |
size は、このテーブルのすべてのタイプで必須です。有効範囲は以下のとおりです:
vectorおよびhalfvec: 1 ~ 16,000、エンベディングの次元数。varchar: 1~10,485,760(最大文字数)。
カスタム型マッピングは、同期テーブルを作成するときに設定可能です。UI で、 同期テーブルの作成 ダイアログの スキーマ の下にある 列型のカスタマイズ を使用します。API、CLI、および Databricks SDK で type_overrides を使用します。
ソーステーブル main.docs.chunks(id BIGINT, title STRING, embedding ARRAY<FLOAT>) の場合、以下は Postgres において title を varchar(256) に、embedding を vector(1024) にマッピングします:
databricks postgres create-synced-table main.docs.chunks_pg \
  --json '{
    "spec": {
      "source_table_full_name": "main.docs.chunks",
      "branch": "projects/my-project/branches/production",
      "primary_key_columns": ["id"],
      "scheduling_policy": "SNAPSHOT",
      "postgres_database": "mydb",
      "create_database_objects_if_missing": true,
      "type_overrides": [
        { "column_name": "title", "pg_type": "PG_SPECIFIC_TYPE_VARCHAR", "size": 256 },
        { "column_name": "embedding", "pg_type": "PG_SPECIFIC_TYPE_VECTOR", "size": 1024 }
      ]
    }
  }'
オーバーライドがない場合、title は TEXT になり、embedding は JSONB になります。
無効な文字を処理する
ヌル バイト (0x00) などの特定の文字は、 Unity Catalog文字列、ARRAY、MAP、または STRUCT 列では許可されますが、Postgres のTEXTまたは JSONB 列ではサポートされません。 これにより、次のようなエラーが発生し、同期が失敗する可能性があります。
ERROR: invalid byte sequence for encoding "UTF8": 0x00
ERROR: unsupported Unicode escape sequence DETAIL: \u0000 cannot be converted to text
- 最初のエラーは、トップレベルの文字列列にヌルバイトが現れた場合に発生します。これは、Postgres
TEXTに直接マッピングされます。 - 2 番目のエラーは、
STRUCT、ARRAY、またはMAPの複合型の中にネストされた文字列にヌルバイトが現れた場合に発生し、JSONBとしてシリアル化されます。シリアライズ中、すべての文字列はPostgresTEXTにキャストされますが、\u0000は許可されていません。
ソリューション:
-
文字列フィールドをサニタイズ : 同期する前にサポートされていない文字を削除します。文字列列の null バイトの場合:
SQLSELECT REPLACE(column_name, CAST(CHAR(0) AS STRING), '') AS cleaned_column FROM your_table -
BINARY に変換 : 生のバイトを保持する必要がある文字列列の場合は、BINARY 型に変換します。
キャパシティプランニング
同期されたテーブルの実装を計画するときは、次のリソース要件を考慮してください。
- 接続の使用状況 : 各同期テーブルは、Lakebaseデータベースへの接続を最大16個使用し、これらはプロジェクトの接続制限にカウントされます。
- サイズクォータ :同期されたすべてのテーブルにわたる論理データの合計が、Branchのデータベースストレージクォータにカウントされます。より大きなクォータが必要な場合は、Databricksサポートにお問い合わせください。個々のテーブルにクォータはありませんが、Databricksでは、更新が必要なテーブルについては1 TBを超えないようにすることをお勧めします。
- フル更新サイズ : フル更新をトリガーしても、新しい同期が完了するまでPostgresの古いバージョンは削除されません。更新中、両方のバージョンが一時的に論理データベース サイズのクォータに計上されます。
- ソースごとのテーブル数 :1つのソーステーブルには、最大20個の同期テーブルを含めることができます。
- 命名要件 : データベース、スキーマ、およびテーブル名には、英数字とアンダースコア (
[A-Za-z0-9_]+) のみを含めることができます。 - コレクション識別子に関するガイダンス :コレクションUnity Catalogテーブルの列名またはテーブル名には、大文字や特殊文字を使用しないでください。 それらの識別子を保持する場合は、Postgresで参照する際に引用符で囲む必要があります。
- スキーマ進化 : トリガー モードと連続モードでは、追加的なスキーマ変更 (列の追加など) のみがサポートされています。
- テーブル定義の変更 : 同期されたテーブルの定義をその場で更新することは、どのインターフェース(UI、SDK、CLI、REST API、Terraform、または DAB)でもサポートされていません。プライマリーキーや時系列キーを変更する場合、または非加算的なスキーマ変更を行う場合は、同期されたテーブルを削除して新しく作成してください。
- 重複キー : ソース テーブルで 2 つの行が同じ主キーを持っている場合、時系列キーを使用して重複排除を構成しない限り、同期パイプラインは失敗します。
- API冪等性 :同期テーブルAPIs冪等性を持つため、一時的なエラーが発生した場合は再試行して、タイムリーな操作を保証します。
- 更新レート : Lakebase の場合、同期パイプラインは、キャパシティー ユニット (CU) あたり 1 秒あたり約 150 行の Continuous 書き込みとTrigger書き込み、および CU あたり 1 秒あたり最大 2,000 行のスナップショット書き込みをサポートします。
Postgres の同期テーブルで許可される操作
Databricks では、誤って上書きしたりデータの不整合が生じたりしないように、同期されたテーブルに対して Postgres で次の操作のみを実行することを推奨しています。
- 読み取り専用クエリ
- インデックスの作成 (同期済みテーブルにインデックスを追加を参照)
- テーブルを削除する( Unity Catalogから同期されたテーブルを削除した後、スペースを解放するため)
Postgres で同期されたテーブルを他の方法で変更することは可能ですが、同期パイプラインに干渉します。
同期テーブルにインデックスを追加する
同期テーブルは主キーインデックス付きで作成されます。他のインデックスを追加するには、テーブルの作成後に Postgres で作成してください。たとえば、VARIANTソース列から同期された列など、JSONB列の包含クエリーをサポートするには、GINインデックスを作成します。
CREATE INDEX orders_payload_gin ON sales.orders USING GIN (payload);
同期テーブルに作成したインデックスは、同期後も保持されます。各 スナップショット 同期や完全更新を含むフルロードのたびにインデックスが再構築されるため、インデックスを追加するたびに同期時間が長くなります。 Trigger モードと Continuous モードでは、各インデックスによって増分更新も遅くなります。
インデックスを作成するには、同期テーブルの所有者または作成者、databricks_superuser、または同期テーブルのマネージャーとして追加されたユーザーである必要があります。「同期テーブルの操作を管理する」を参照してください。
インデックスを作成する際は、次の点に留意してください。
- 同期されたテーブルはパーティション分割されたテーブルです。 Postgres はパーティション分割されたテーブルでの
CREATE INDEX CONCURRENTLYをサポートしていないため、代わりにCREATE INDEXを使用してください。CREATE INDEXは、ビルドが完了するまで、同期パイプラインからの書き込みを含め、テーブルへの書き込みをブロックします。同期が待機している間にビルドに 20 分以上かかる場合、同期は失敗し、自動的に再試行されません。更新されたデータのスワップ待ちのフルロードがない限り、クエリーは引き続きテーブルを読み取ることができます。大きなテーブルの場合は、同期が実行されていないときにインデックスを作成してください。 - Postgres クライアントから長いインデックスのビルドをランします。 大きなテーブルのインデックス構築は時間がかかることがあります。SQL エディターではなく psql などのクライアントからビルドをランします。
同期されたテーブルが LTAPダイレクト書き込みを使用する場合、Bツリーインデックスのみが、その後の完全な読み込みをLTAPダイレクト書き込みで保持します。GINなどの他のインデックスタイプの場合、これらの読み込みには標準の同期パスが使用されます。初期読み込みは影響を受けません。
所有権と許可
同期されたテーブルは、内部の databricks_writer_<dbid> ロールによって所有され、作成したユーザーによっては所有されません。これは同期パイプラインが管理しているためです(Postgres ロールを参照してください)。行レベルセキュリティの構成のような所有者のみのコマンドは、同期されたテーブルで直接実行することはできません。
これは一般的なPostgresのルールに対する例外で、作成したオブジェクトは、そのログインがPostgresにロールとして存在する場合、Databricks IDが所有します。パイプラインはユーザーに代わって同期されたテーブルを作成します。
同期テーブルを作成するユーザーのアクセス
同期されたテーブルを作成すると、お客様の Databricks ID は自動的に使用するためのアクセス権が付与されます。databricks_superuser の対応は必要ありません。同期されたテーブルに対して、お客様のIDに次の特権が付与されます。
オブジェクト | 権限 | 目的 |
|---|---|---|
同期テーブル |
| テーブルの読み取りまたはクリア |
スキーマ |
| スキーマを使用し、インデックスなどのオブジェクトを作成します |
INSERT または UPDATE は付与されていません。パイプラインがテーブルのデータを所有しているため、直接書き込みは次回の更新時に上書きされます。DELETE と TRUNCATE はテーブルのみをクリアします。次回の更新で、ソースからテーブルにデータが再投入されます。
このアクセスは、同期されたテーブルに対する Unity Catalog の権限に由来し、Unity Catalog で管理されます。変更するには、ユーザーの Unity Catalog 権限を更新します。Postgres で Databricks ID から直接 REVOKEすることはできません。
このアクセスは、同期テーブルを作成したIDに結び付けられています。パイプラインの 実行ユーザー の変更では、再割り当ては行われません。別の所有者IDを使用するには、そのIDで同期テーブルを再作成します。
同期テーブルへのアクセスを管理する
同期テーブルが作成されると、 databricks_superuserは Postgres から同期テーブルを読み取ることができます。databricks_superuserにはpg_read_all_dataがあり、これによりこのロールはすべてのテーブルから読み取ることができます。また、このロールにはpg_write_all_data権限があり、これによりこのロールはすべてのテーブルに書き込むことができます。これは、 databricks_superuserが Postgres の同期テーブルにも書き込むことができることを意味します。Lakebaseは、対象テーブルに緊急の変更を加える必要がある場合に備えて、このような書き込み動作をサポートしています。しかし、Databricksはソーステーブルを修正することを推奨しています。
-
databricks_superuserは、他のユーザーに以下の権限を付与することもできます。SQLGRANT USAGE ON SCHEMA synced_table_schema TO user;SQLGRANT SELECT ON synced_table_name TO user; -
databricks_superuserはこれらの権限を取り消すことができます。SQLREVOKE USAGE ON SCHEMA synced_table_schema FROM user;SQLREVOKE {SELECT | INSERT | UPDATE | DELETE} ON synced_table_name FROM user;
同期テーブル操作を管理する
databricks_superuserは、同期テーブルに対して特定の操作を実行する権限を持つユーザーを管理できます。同期テーブルでサポートされている操作は次のとおりです。
CREATE INDEXALTER INDEXDROP INDEXDROP TABLE
同期テーブルに対しては、その他のすべてのDDL操作は拒否されます。
これらの権限を他のユーザーに付与するには、 databricks_superuserはまずdatabricks_auth上に拡張機能を作成する必要があります。
CREATE EXTENSION IF NOT EXISTS databricks_auth;
次に、 databricks_superuserは同期テーブルを管理するユーザーを追加できます。
SELECT databricks_synced_table_add_manager('"synced_table_schema"."synced_table"'::regclass, '[user]');
databricks_superuserは、同期テーブルの管理からユーザーを削除できます。
SELECT databricks_synced_table_remove_manager('[table]', '[user]');
databricks_superuserはすべてのマネージャーを表示できます:
SELECT * FROM databricks_synced_table_managers;
同期されたテーブルを削除する
Unity Catalogから同期済みのテーブルを削除すると、対応するPostgresテーブルも削除されます。
- UI
- Python SDK
- Java SDK
- curl
カタログ で、同期されたテーブルを見つけて、 メニューを開き、 「削除」 を選択します。
from databricks.sdk import WorkspaceClient

w = WorkspaceClient()

w.postgres.delete_synced_table("synced_tables/my-catalog.sales.orders").wait()
import com.databricks.sdk.WorkspaceClient;

WorkspaceClient w = new WorkspaceClient();

w.postgres().deleteSyncedTable("synced_tables/my-catalog.sales.orders").waitForCompletion();
curl -X DELETE "https://your-workspace.cloud.databricks.com/api/2.0/postgres/synced_tables/my-catalog.sales.orders" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}"
カタログ統合
同期テーブルは、Unity Catalogの複数のカタログに表示されることがあります。このカタログの重複は、標準のカタログに同期テーブルを作成し、その宛先Postgresデータベースもデータベースカタログとして登録されている場合に発生します。その場合、同期テーブルは両方のカタログの下に表示されます。
Databricks外部のシステムに同期
Databricks 以外のシステムにデータを同期する場合は、Census や Hightouch などのPartner Connect リバース ETL ソリューションを参照してください。
その他のリソース
- データベースに接続する方法を学ぶ
- Unity CatalogにLakebaseデータベースを登録する
- Unity Catalog について詳しく学ぶ