I/Oが少ない低速のSparkステージ
ステージの実行が遅いのに読み取り、書き込み、シャッフルするデータが少ない場合、クエリー自体がボトルネックになっていることが一般的です。
このページは、最長のステージで スキューと spill と 高い I/O を除外した後に使用してください。ステージにタスクが 1 つしかない場合は、タスクが 1 つの長い Spark ステージを参照してください。
I/Oが少ないステージの処理が遅くなる原因として、次のことが考えられます:
SQL DAGを使用して、これらの問題のほぼすべてを特定します。
SQL DAG を開く
SQL DAGを開くには、ジョブページの上部にスクロールして、[ 関連するSQLクエリー ] をクリックします。
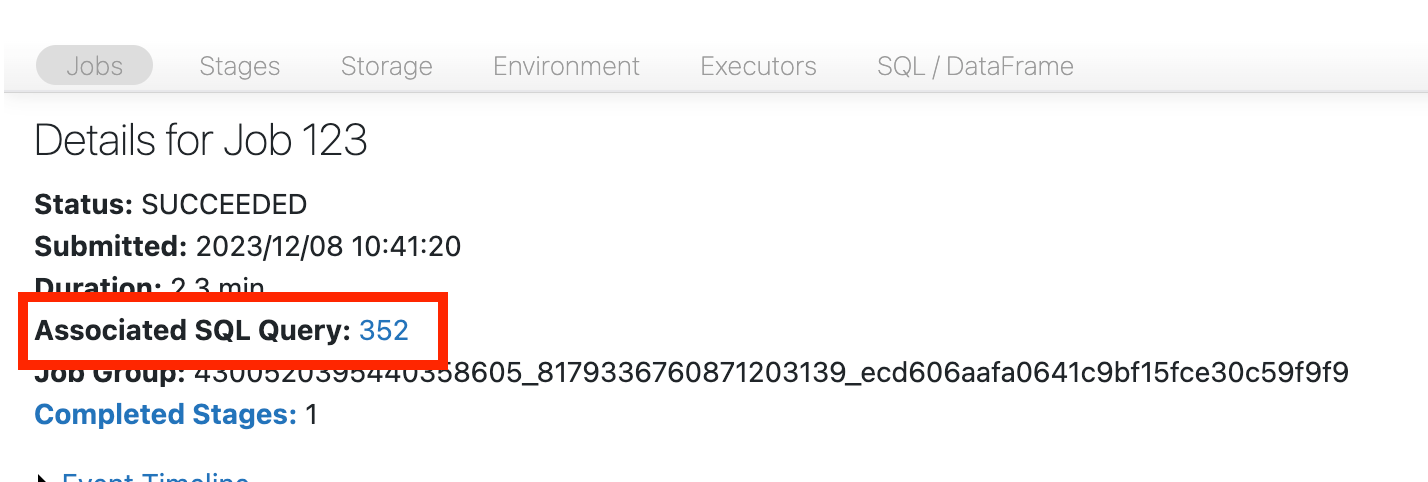
DAGが表示されます。表示されない場合は、スクロールして検索してください。

DAGを調べて、どこに時間が費やされているかを特定します。一部のノードは、その実行時間を直接表示します。たとえば、このノードは2.1分の期間を表示し、ステージIDを含みます:

他のノードは、クリックした後にのみ継続時間が表示されます。この例では、書き込みノードの期間は 1.4 分です。

これらの時間は累積的であり、経過した壁時計時間ではなく、すべてのタスクにわたるエグゼキューター時間の合計を表します。これらは経過時間とコストと相関しています。
演算子をクリックすると、出力行、ピークメモリ、spillサイズなどのメトリクスが表示されます。Sparkがレポートする演算子メトリクスの定義については、Apache Spark Web UIドキュメントの「SQLメトリクス」を参照してください。
たくさんの小さなファイルを読む
スキャン演算子が大部分の時間を消費している場合は、それをクリックして、読み取られたファイル数を確認します。

クエリーが数万ファイル以上を読み取る場合、テーブルに小さなファイルの問題がある可能性があります。ファイルは8 MB以上である必要があります。多数の列、またはカーディナリティの高い列でパーティション分割すると、ファイルが小さくなることがよくあります。
OPTIMIZEを実行すると改善する場合があります。Databricksでは、予測的最適化も有効にし、ファイルレイアウトを再検討することをお勧めします。
小さなファイルをたくさん書き込む
書き込み演算子が時間の大部分を消費している場合は、それをクリックし、書き込まれたファイル数とデータを確認します:

クエリーで数万ファイル以上書き込む場合、テーブルに小さなファイルの問題がある可能性があります。ファイルは8MB以上にする必要があります。多すぎる列または高いカーディナリティの列でパーティショニングすると、小さなファイルが生成されることがよくあります。予測的最適化を有効にするか、ファイルレイアウトを再検討するか、または最適化された書き込みをオンにします。
低速 UDF
クエリーに UDF やこのような DAG ノードが含まれている場合、UDF がボトルネックになっている可能性があります:

確認するには、UDF をコメントアウトし、パイプラインの速度を監視します。UDF がボトルネックである場合は、可能な限りネイティブ関数を使用して書き換えてください。書き換えられない場合は、UDF をランするタスクの数を確認してください。ステージのタスク数がクラスターのコア数より少ない場合は、UDFを適用する前にデータフレームをrepartition()します:
  (df
    .repartition(num_cores)
    .withColumn('new_col', udf(...))
  )
UDF は、メモリの問題を引き起こす可能性もあります。各タスクは、パーティション内のすべてのデータをメモリにロードする可能性があります。このデータが大きすぎると、クエリーが遅くなったり不安定になったりする可能性があります。再パーティション化も、各タスクを小さくすることでここで役立ちます。
デカルト結合
デカルト結合とネスト化ループ結合は非常にコストがかかります。DAG に表示される場合は、意図的なものであるかを確認し、代替案を検討してください。結合条件が間隔内のポイントまたは間隔のオーバーラップ条件である場合は、 範囲結合の最適化を参照してください。
爆発結合または分解
DAG ノードに少数の入力行とそれよりはるかに多い出力行が表示される場合は、爆発的な結合または explode() が原因である可能性があります。
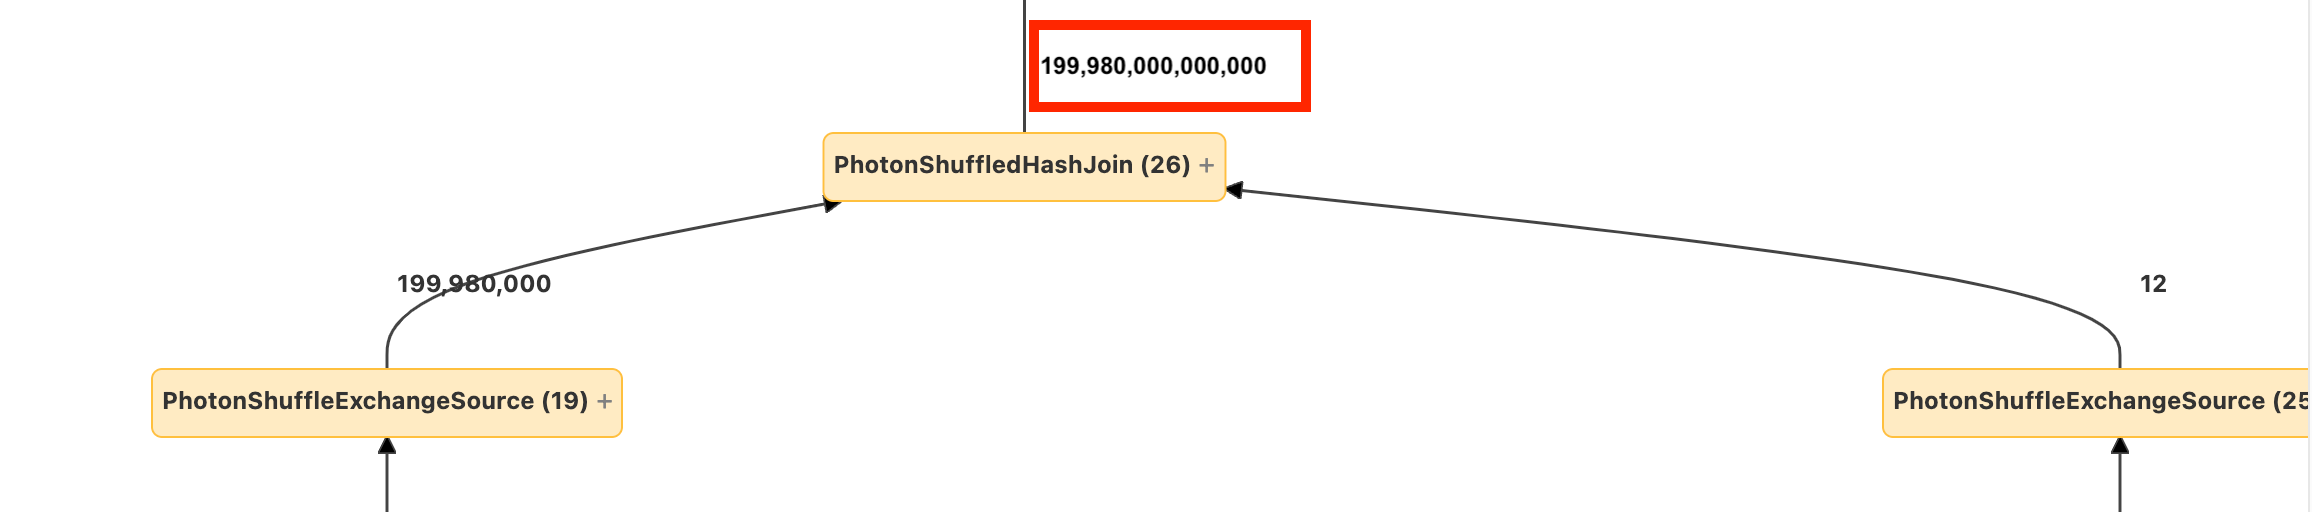
爆発的な結合を修正するには、結果のどのサブセットが必要かを判断し、結合条件を更新するか、両方のリレーションからの入力行数を減らします。「EXPLODING_JOIN」を参照してください。