SQL DAGでの高負荷な読み取りの特定
ステージの大部分がデータの読み取りに費やされている場合、読み取りを最適化する前に、どのテーブルまたはファイルを読み取るかを確認します。ステージページにはステージが読み取るデータの量は表示されますが、データの取得元は表示されません。SQL DAG は、ステージをデータを読み取るスキャンに接続します。
最長のステージの 入力が高い 場合は、このページを使用してください。ステージの入力が高くない場合は、出力とシャッフルを Sparkステージの高I/O で確認し、このガイドの他のページを使用して問題を診断します。Spark UIを使用したコストとパフォーマンスの問題の診断を参照してください。
DAGへの行き方
データを読み取るスキャンを見つけるには:
-
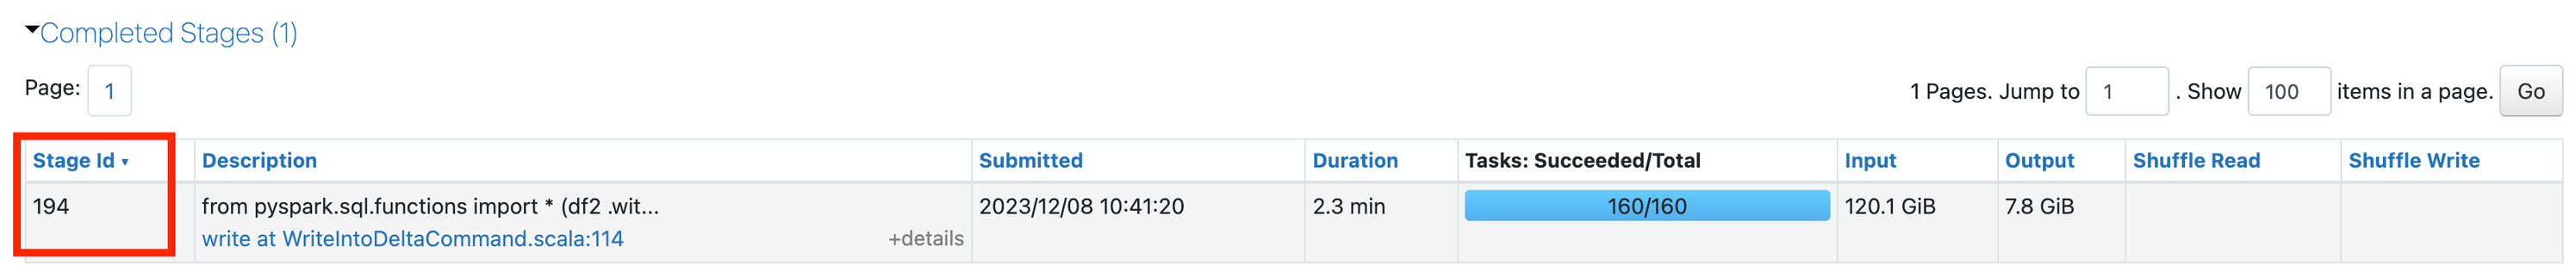
ジョブページで、読み取りを実行するステージのIDをメモします。この例では、ステージ ID は 194 です:
-
ジョブ ページの上部までスクロールし、 [関連するSQLクエリー] をクリックします。
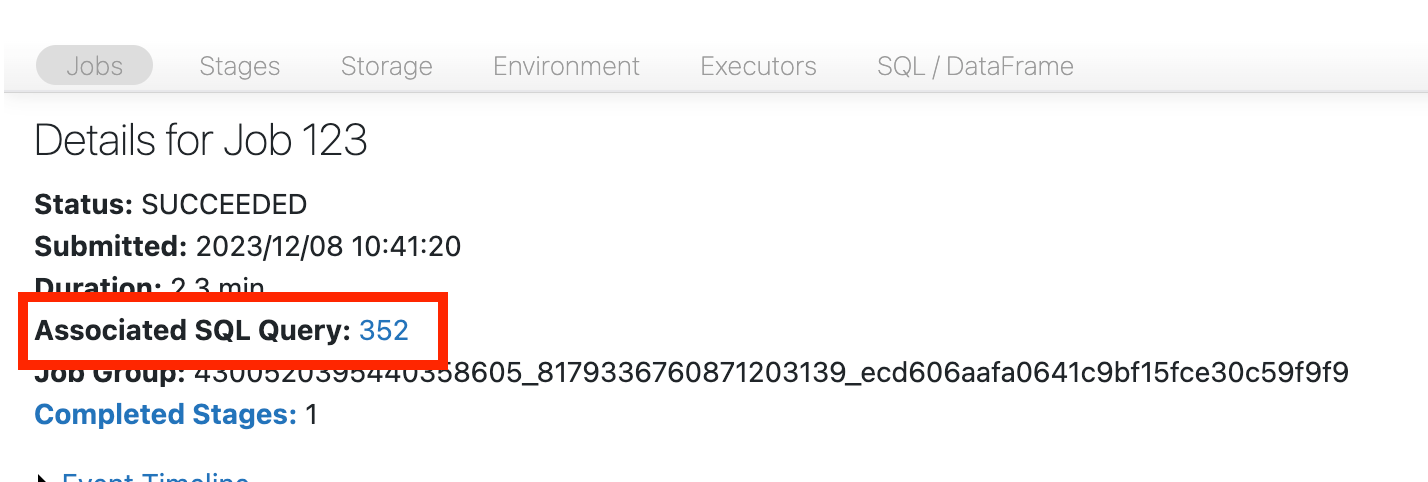
SQL DAGが表示されます。表示されない場合は、スクロールして見つけます。

-
DAG内のステージを見つけます。DAGでデータソースが明確にされない場合は、メモしたステージIDでラベル付けされたノードを探します。
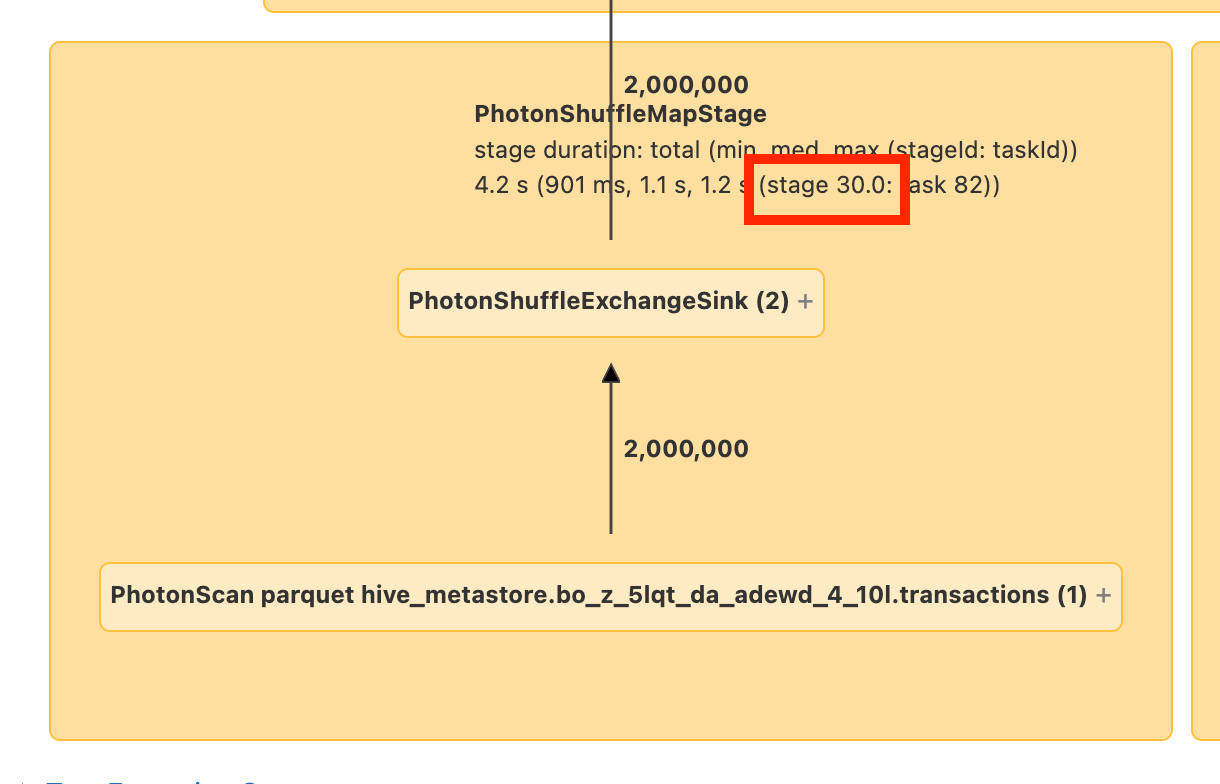
-
そのステージの スキャン ノードを見つけます。この例では、ステージは
transactionsという名前のテーブルを読み取ります: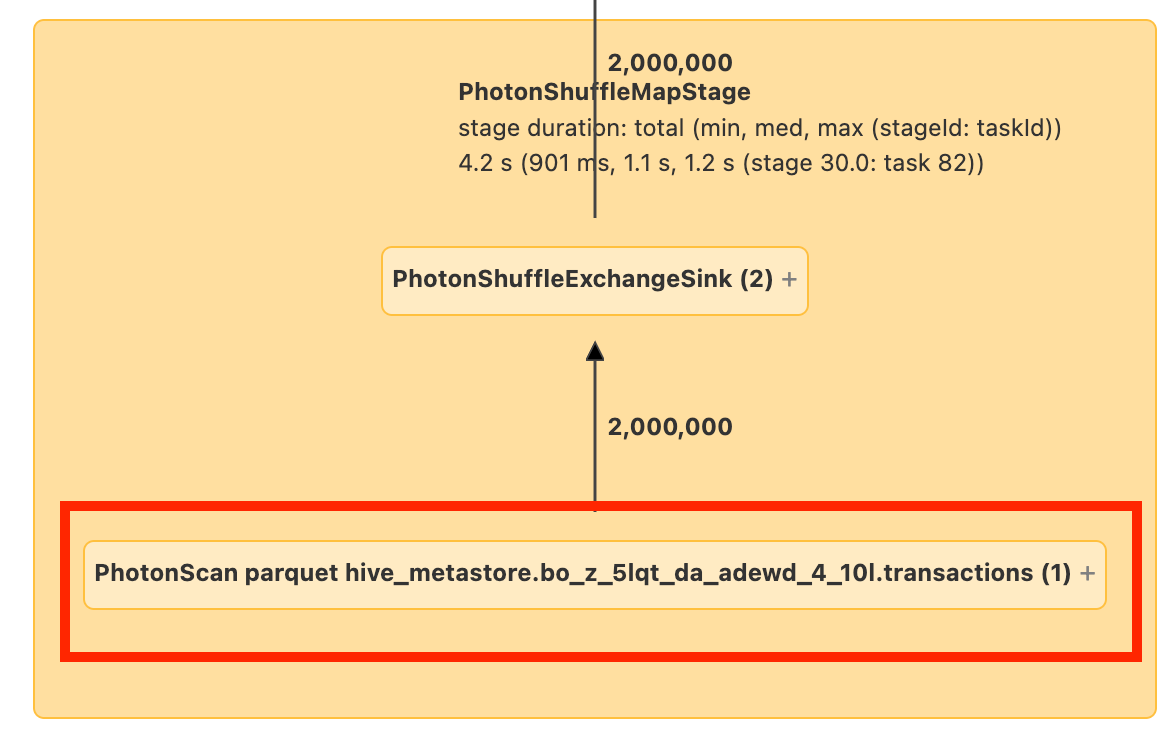
ノードが読み取るデータの場所を確認するには、ノードをクリックするか、ノードにカーソルを合わせます。
次のステップ
ステージが読み取るデータを特定した後、読み取りを減らすか高速化するアプローチを選択します。高い入力を参照してください。