Gerenciar compute serverless
Esta página explica como gerenciar o acesso ao compute serverless e como implementar limites de taxa serverless. Os administradores do workspace governam o compute serverless usando objetos de compute serverless integrados. Um objeto de compute serverless é um tipo de recurso que define o limite de permissão para cargas de trabalho serverless. Seu workspace obtém automaticamente dois objetos de compute default:
- Default Interactive Compute : Governa o acesso a notebooks e ao Databricks Connect.
- Default Automated Compute : rege o acesso a jobs e Spark Declarative Pipelines no Lakeflow.
Por **default**, todos os usuários do workspace têm Can Use em ambos os objetos, portanto, as cargas de trabalho existentes continuam a ser executadas sem quaisquer alterações. Um administrador do workspace pode remover usuários ou grupos de qualquer um dos objetos para restringir o acesso. Um usuário que perder o acesso verá a opção de compute Serverless como indisponível nas superfícies de seu produto.
Gerenciar o acesso ao compute serverless
Para controlar quem tem acesso ao compute serverless, os administradores do workspace podem editar as permissões nos objetos Default Interactive Compute e Default Automated Compute . Os administradores do Workspace têm a permissão Can Manage por default, mas podem conceder a permissão a qualquer usuário. Esses objetos de compute default não podem ser renomeados ou excluídos.

Cada objeto de compute serverless oferece suporte a dois níveis de permissão:
Permissão | Permite que você |
|---|---|
Pode usar | Execução cargas de trabalho neste compute |
Can Manage (Pode gerenciar) | Execute cargas de trabalho neste compute e edite as permissões do compute |
Você também pode gerenciar permissões para objetos de compute serverless de forma programática usando a API de permissões. Objetos de compute serverless usam o tipo de objeto serverless-compute, e cada objeto é identificado pelo seu ID.
Restringir o acesso ao serverless interativo
Para limitar quem pode usar o serverless para notebooks e Databricks Connect:
- Clique em Computação na barra lateral do workspace.
- Na tab Serverless , clique no menu kebab
 ao lado de Default Interactive Compute e, em seguida, clique em Editar permissões .
- Remova o grupo All Users ou o grupo que inclui todos os usuários do workspace.
- Adicione apenas os usuários, grupos ou Service Principals específicos que você deseja autorizar.
Se você revogar as permissões de serverless interativo de um usuário, os notebooks já anexados ao serverless falharão ao conectar quando o usuário executar uma célula e o usuário não verá mais a opção Serverless como disponível no seletor de compute do notebook. Se eles tentarem executar o Databricks Connect, a solicitação de conexão falhará com um erro indicando que o usuário não tem acesso ao serverless.
Restringir o acesso a jobs e pipelines serverless
Para limitar quem pode usar serverless em jobs e pipelines:
- Clique em Computação na barra lateral do workspace.
- Na **tab Serverless**, clique no menu kebab ao lado de **Default Automated Compute** e, em seguida, clique em **Edit permissions**.
- Remova o grupo All Users ou o grupo que inclui todos os usuários do workspace.
- Adicione apenas os usuários, grupos ou Service Principals específicos que você deseja autorizar.
Se você revogar o acesso de um usuário ao default Automatizada compute , Job e pipelines executados como esse usuário e que usam esse objeto de computação falharão na execução. Cargas de trabalho que selecionam um objeto de compute automatizada personalizado exigem permissão no objeto selecionado.
Antes de revogar o acesso de um usuário ao Default Automated Compute , audite quais jobs e pipelines os usuários afetados possuem. A seguinte query identifica cargas de trabalho serverless recentes para um usuário específico:
SELECT *
FROM system.billing.usage
WHERE usage_date >= date_add(now(), -30)
  AND billing_origin_product IN ('JOBS', 'DLT')
  AND identity_metadata.run_as = '<user_email>';
Verifique a coluna usage_metadata para ver os recursos afetados, como IDs de job e IDs de pipeline.
Auditar uso serverless
Os registros de faturamento serverless incluem um campo serverless_compute_id em usage_metadata. Use-o para rastrear em qual objeto de compute uma carga de trabalho foi executada:
SELECT
  usage_metadata.serverless_compute_id,
  identity_metadata.run_as,
  SUM(usage_quantity) AS total_dbus
FROM system.billing.usage
WHERE billing_origin_product IN ('JOBS', 'DLT', 'INTERACTIVE')
  AND usage_metadata.serverless_compute_id IS NOT NULL
  AND usage_date >= date_add(now(), -30)
GROUP BY 1, 2
ORDER BY 3 DESC;
Recursos de controle de acesso de compute serverless suportados
Os seguintes recursos estão integrados aos controles de acesso de compute serverless.
Interativo (Compute interativo default)
- Notebooks e notebooks de Runtime de AI
- Databricks Connect
Automatizado (Compute automatizado default)
- Jobs e jobs de AI Runtime
- Spark Declarative Pipelines no Lakeflow
Recursos de controle de acesso de compute serverless não suportados
Os seguintes recursos não estão integrados aos controles de acesso do compute serverless:
- Databricks SQL (DBSQL)
- Inferência de lotes (
ai_query()) - Servindo modelo
- Endpoints de throughput provisionada da API do Foundation Model
- Lakebase
- Databricks Apps
- Agent Evaluation e dados sintéticos
- Indexação de Pesquisa de AI
- Otimização preditiva
- perfil de dados
- Controle de acesso detalhado em compute dedicado. O acesso ao compute dedicado determina se um usuário pode usar o controle de acesso detalhado.
Para qualquer recurso não listado aqui, entre em contato com sua equipe de account do Databricks para perguntar sobre seu status.
Limitações de controle de acesso serverless
No caso de uma interrupção de serviço, as verificações de acesso podem falhar e permitir o acesso, e usuários que, de outra forma, teriam o acesso negado podem conseguir começar cargas de trabalho serverless. Este recurso destina-se a ajudar a governar o acesso ao compute serverless. Não utilize este recurso para garantir um limite absoluto de gastos nos valores finais faturados. O Databricks não é responsável pelos custos incorridos por cargas de trabalho executadas durante tal evento.
- Você não pode renomear ou excluir objetos de compute default.
- Jobs e pipelines que usam default compute Automatizada exigem permissão nesse objeto. Revise as cargas de trabalho ativas antes de remover o acesso de um usuário.
- O compute em segundo plano (jobs iniciados pelo sistema) está isento dos controles de acesso do compute serverless.
Definir limites de taxa no compute serverless
Um limite de taxa controla até que ponto os executores Spark de uma carga de trabalho automatizada podem fazer autoscale. Os administradores de workspace podem criar objetos de compute automatizados personalizados e atribuir um tamanho a cada um. Quando uma carga de trabalho usa o objeto de compute, esse tamanho define sua capacidade máxima de autoscale do executor Spark.
Os limites de taxa se aplicam apenas a workloads automatizados (jobs e LakeFlow Pipelines). Workloads interativos (notebooks e Databricks Connect) não têm limites de taxa.
Um tamanho mapeia para uma taxa aproximada de consumo de unidades Databricks (DBU) para executores Spark. Os limites de taxa não definem um limite rígido no custo total da carga de trabalho ou nos valores faturados finais. Eles não limitam o Driver, a máquina virtual REPL, a GPU ou os custos de refresh de view materializada e tabela de transmissão.
O limite de taxa se aplica independentemente a cada carga de trabalho que usa o objeto de compute. Dois jobs que usam o mesmo objeto de compute recebem cada um o limite total. Em um Job, o limite é compartilhado entre suas tarefas Serverless, mesmo quando as tarefas estão em execução em clusters separados. Um objeto de compute não impõe um limite agregado para todas as workloads que o utilizam.
Requisitos de limite de taxa
- Para criar um objeto de compute serverless, você deve ser um administrador de workspace ou ter o direito de criação de cluster irrestrito.
- Para editar o tamanho ou as permissões de um objeto de compute personalizado, você deve ter a permissão Pode gerenciar nesse objeto.
- Para execução uma carga de trabalho em um objeto de compute, você deve ter Pode usar ou Pode gerenciar nesse objeto.
Criar um compute serverless com um limite de taxa
- Clique em Computação na barra lateral do workspace.
- Na tab Serverless , clique em Criar compute serverless .
- Digite um nome.
- Para Size , selecione o limite de taxa a ser aplicado, de Small a 2X-Large . Deixe definido como Default para usar o limite default do seu workspace.
- Clique em Criar .
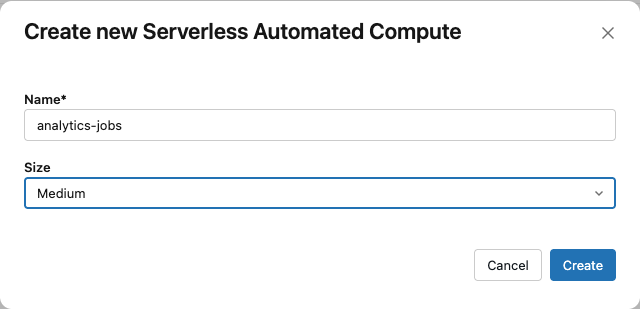
O novo objeto de compute aparece na tab Serverless com um tipo de Automatizado . Conceda acesso aos usuários antes que eles execução workloads nele. Você não pode editar o tamanho de um objeto de compute default.
Conceder acesso ao compute com limite de taxa
- Na tab Serverless , abra o objeto de compute personalizado.
- Clique em Ações e, em seguida, em Editar permissões .
- Adicione os usuários, grupos ou Service Principal que precisam de acesso.
- Conceda Can Use para execução de cargas de trabalho ou Can gerenciar para também editar o tamanho e as permissões.
- Clique em Salvar .
Alterar um limite de taxa
- Na tab Serverless , abra o objeto de compute personalizado.
- Clique em Editar .
- Para Tamanho , selecione um tamanho.
- Clique em Salvar .
Tamanhos de limite de taxa
Os tamanhos a seguir mapeiam para taxas de consumo aproximadas de executor Spark:
Tamanho | Taxa de consumo aproximada do executor |
|---|---|
Pequeno | ~60 DBUs por hora |
Médio | ~120 DBUs por hora |
Grande | ~240 DBUs por hora |
X-Large | ~480 DBUs por hora |
XXL | ~960 DBUs por hora |
Esses valores são estimativas. O uso real pode excedê-los devido à variabilidade na infraestrutura serverless e custos que o limite de taxa não cobre.
Escolher Default usa a capacidade máxima de autoscale existente do seu Workspace para workloads automatizados Serverless. O default depende da camada do seu workspace e de quaisquer limites específicos do workspace.
Executar uma carga de trabalho em um compute com limite de taxa
Um usuário com Can Use em um objeto de compute pode selecioná-lo ao configurar um job ou pipeline. A carga de trabalho é então executada sob o limite de taxa do compute. Se uma carga de trabalho não especificar um objeto de compute, ela voltará a usar o Default Automated Compute do seu workspace. Se o usuário não tiver acesso a esse default, a carga de trabalho falhará na execução.
- Jobs : Nas configurações de Compute do job, use Política de compute para selecionar o objeto de compute serverless automatizado. O seletor também pode ser rótulo como Compute Serverless . A lista mostra os objetos de compute que a identidade de execução do job pode usar. Para configurar um job com a API de Jobs, consulte Usar compute com limite de taxa com a API de Jobs.
- Pipelines : selecione o objeto de compute automatizado como o compute serverless para um pipeline no editor do Lakeflow.
Quando um limite de taxa restringe um pipeline, você pode ver o impacto na história de queries do pipeline ou na UI do Lakeflow.
Usar compute com limite de taxa com a Jobs API
Para a execução de um Job em um objeto compute com limite de taxa usando a API de Job, defina um cluster de Job que define serverless_compute.policy_id para o ID do objeto compute. Este é o mesmo objeto compute serverless automatizado selecionado como a política de compute do job. Em seguida, defina job_cluster_key em cada tarefa serverless no job para referenciar esse cluster de job. Para copiar o ID, na tab Serverless , clique no menu kebab para o objeto compute e, em seguida, clique em Copy compute ID .
{
  "job_clusters": [
    {
      "job_cluster_key": "rate_limited",
      "serverless_compute": { "policy_id": "<compute-id>" }
    }
  ],
  "tasks": [
    {
      "task_key": "ingest",
      "job_cluster_key": "rate_limited",
      "notebook_task": { "notebook_path": "/Workspace/Jobs/ingest" }
    },
    {
      "task_key": "transform",
      "job_cluster_key": "rate_limited",
      "notebook_task": { "notebook_path": "/Workspace/Jobs/transform" }
    }
  ]
}
Um job pode definir no máximo um cluster de job que define serverless_compute. A mesma configuração se aplica quando você cria, atualiza, Reset ou envia um Job e quando você implanta um Job com os Bundles de Automação Declarativa. Para o esquema completo de solicitação, consulte Criar um novo job na referência da API REST.
O campo job_clusters[].serverless_compute_id está descontinuado. Use serverless_compute.policy_id em vez disso.
Limitações de limite de taxa
- Os limites de taxa restringem apenas o autoscale do executor Spark. Outros componentes de custo, como o driver, VMs REPL, GPUs e refreshes de views materializadas ou tabelas de transmissão, não possuem limites.
- O limite de DBU por hora para cada tamanho é uma estimativa. O uso real pode exceder o alvo devido a flutuações modestas no limite aplicado e à variabilidade inerente da infraestrutura serverless.
- Um workload no tamanho 2X-Large pode apresentar desempenho abaixo das expectativas porque o tamanho físico do cluster é limitado a 256 executors. Se dois ou mais workloads 2X-Large forem agendados no mesmo cluster de runtime, cada um poderá atingir um desempenho inferior ao esperado.
- Devido a detalhes de implementação de faturamento, a mesma carga de trabalho pode incorrer em uso de DBU diferente sob diferentes tamanhos de limite de taxa.
- Não é possível definir um limite de taxa em um objeto de compute default.