Preenchimento retroativo de dados históricos com oleoduto
Na engenharia de dados, backfilling refere-se ao processo de processamento retroativo de dados históricos por meio de um pipeline de dados que foi projetado para processar dados atuais ou de transmissão.
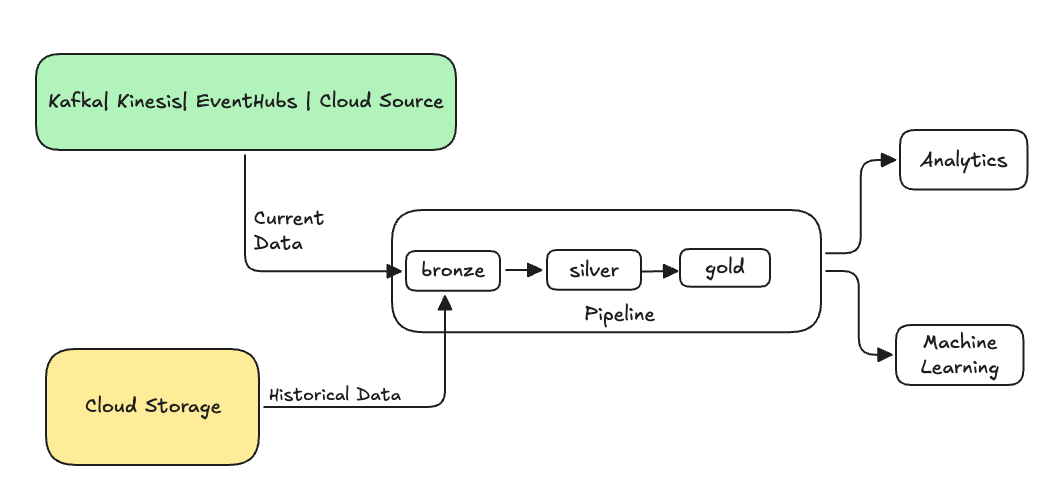
Normalmente, esse é um fluxo separado que envia dados para suas tabelas existentes. A ilustração a seguir mostra um fluxo de preenchimento enviando dados históricos para as tabelas de bronze no seu pipeline.
Alguns cenários que podem exigir um preenchimento:
- Processe dados históricos de um sistema legado para ensinar um modelo machine learning (ML) ou construir um painel de análise de tendências históricas.
- Reprocesse um subconjunto de dados devido a um problema de qualidade de dados com fonte de dados upstream.
- Seus requisitos de negócios mudaram e você precisa preencher dados para um período de tempo diferente que não foi coberto pelo pipeline inicial.
- Sua lógica de negócios mudou e você precisa reprocessar dados históricos e atuais.
O fluxo de preenchimento que você usa depende da tabela de destino e dos dados de origem. Para um destino de dimensão que muda lentamente (SCD) Tipo 1 AUTO CDC com um Snapshot autoritativo, use um fluxo AUTO CDC FROM SNAPSHOT único. Para uma migração de SCD que reproduz alterações históricas, use um fluxo AUTO CDC único.
Para backfills somente de anexo: utilize um fluxo de acréscimo especializado com a opção ONCE para preencher uma tabela de transmissão somente de anexo. Consulte append_flow ou CREATE FLOW (pipelines) para obter mais informações sobre a opção ONCE.
Considerações ao preencher dados históricos em uma tabela de transmissão
- Normalmente, acrescente os dados à tabela de transmissão bronze. As camadas silver e ouro posteriores coletam os novos dados da camada bronze.
- Garanta que seu pipeline possa lidar com dados duplicados com eficiência caso os mesmos dados sejam anexados várias vezes.
- Garanta que o esquema histórico de dados seja compatível com o esquema de dados atual.
- Considere o volume de dados e o acordo de nível de serviço (SLA) de processamento necessário e, com base nisso, configure o cluster e os tamanhos de lote.
Exemplo: Adicionar um preenchimento retroativo a um pipeline existente
Neste exemplo, digamos que você tenha um pipeline que ingere dados de registro de eventos brutos de uma fonte de armazenamento em cloud, começando em 01/01/2025. Posteriormente, você percebe que deseja preencher os três anos anteriores de data histórica para casos de uso de relatórios e análise downstream. Todos os dados estão em um único local, particionados por ano, mês e dia, no formato JSON.
pipelineinicial
Este é o código pipeline inicial que ingere incrementalmente os dados brutos de registro de eventos do armazenamento cloud .
- Python
- SQL
from pyspark import pipelines as dp

source_root_path = spark.conf.get("registration_events_source_root_path")
begin_year = spark.conf.get("begin_year")
incremental_load_path = f"{source_root_path}/*/*/*"

# create a streaming table and the default flow to ingest streaming events
@dp.table(name="registration_events_raw", comment="Raw registration events")
def ingest():
    return (
        spark
        .readStream
        .format("cloudFiles")
        .option("cloudFiles.format", "json")
        .option("cloudFiles.inferColumnTypes", "true")
        .option("cloudFiles.maxFilesPerTrigger", 100)
        .option("cloudFiles.schemaEvolutionMode", "addNewColumns")
        .option("modifiedAfter", "2025-01-01T00:00:00.000+00:00")
        .load(incremental_load_path)
        .where(f"year(timestamp) >= {begin_year}") # safeguard to not process data before begin_year
    )
-- create a streaming table and the default flow to ingest streaming events
CREATE OR REFRESH STREAMING LIVE TABLE registration_events_raw AS
SELECT * FROM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/*/*/*",
  format => "json",
  inferColumnTypes => true,
  maxFilesPerTrigger => 100,
  schemaEvolutionMode => "addNewColumns",
  modifiedAfter => "2024-12-31T23:59:59.999+00:00"
)
WHERE year(timestamp) >= '2025'; -- safeguard to not process data before begin_year
Aqui usamos a opção modifiedAfter Auto Loader para garantir que não estamos processando todos os dados do caminho de armazenamento cloud . O processamento incremental é interrompido nesse limite.
Outras fontes de dados, como Kafka, Kinesis e Azure Event Hubs, têm opções de leitor equivalentes para atingir o mesmo comportamento.
Dados de preenchimento dos últimos 3 anos
Agora você deseja adicionar um ou mais fluxos para preencher dados anteriores. Neste exemplo, tomemos os seguintes passos:
- Use o fluxo
append once. Isso executa um preenchimento único sem continuar a execução após esse primeiro preenchimento. O código permanece no seu pipeline e, se o pipeline for totalmente atualizado, o backfill será reexecutado. - Crie três fluxos de preenchimento, um para cada ano (nesse caso, os dados são divididos por ano no caminho). No Python, parametrizamos a criação dos fluxos, mas no SQL repetimos o código três vezes, uma para cada fluxo.
Se você estiver trabalhando em seu próprio projeto e não estiver usando compute serverless , talvez seja necessário atualizar o número máximo de trabalhadores para o pipeline. Aumentar o número máximo de trabalhadores garante que você tenha o recurso para processar o histórico de dados enquanto continua a processar os dados de transmissão atuais dentro do SLA esperado.
Se você usar compute serverless com dimensionamento automático aprimorado (o default), seu cluster aumentará automaticamente de tamanho quando sua carga aumentar.
- Python
- SQL
from pyspark import pipelines as dp

source_root_path = spark.conf.get("registration_events_source_root_path")
begin_year = spark.conf.get("begin_year")
backfill_years = spark.conf.get("backfill_years") # e.g. "2024,2023,2022"
incremental_load_path = f"{source_root_path}/*/*/*"

# meta programming to create append once flow for a given year (called later)
def setup_backfill_flow(year):
    backfill_path = f"{source_root_path}/year={year}/*/*"
    @dp.append_flow(
        target="registration_events_raw",
        once=True,
        name=f"flow_registration_events_raw_backfill_{year}",
        comment=f"Backfill {year} Raw registration events")
    def backfill():
        return (
            spark
            .read
            .format("json")
            .option("inferSchema", "true")
            .load(backfill_path)
        )

# create the streaming table
dp.create_streaming_table(name="registration_events_raw", comment="Raw registration events")

# append the original incremental, streaming flow
@dp.append_flow(
        target="registration_events_raw",
        name="flow_registration_events_raw_incremental",
        comment="Raw registration events")
def ingest():
    return (
        spark
        .readStream
        .format("cloudFiles")
        .option("cloudFiles.format", "json")
        .option("cloudFiles.inferColumnTypes", "true")
        .option("cloudFiles.maxFilesPerTrigger", 100)
        .option("cloudFiles.schemaEvolutionMode", "addNewColumns")
        .option("modifiedAfter", "2024-12-31T23:59:59.999+00:00")
        .load(incremental_load_path)
        .where(f"year(timestamp) >= {begin_year}")
    )

# parallelize one time multi years backfill for faster processing
# split backfill_years into array
for year in backfill_years.split(","):
    setup_backfill_flow(year) # call the previously defined append_flow for each year
-- create the streaming table
CREATE OR REFRESH STREAMING TABLE registration_events_raw;

-- append the original incremental, streaming flow
CREATE FLOW
  registration_events_raw_incremental
AS INSERT INTO
  registration_events_raw BY NAME
SELECT * FROM STREAM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/*/*/*",
  format => "json",
  inferColumnTypes => true,
  maxFilesPerTrigger => 100,
  schemaEvolutionMode => "addNewColumns",
  modifiedAfter => "2024-12-31T23:59:59.999+00:00"
)
WHERE year(timestamp) >= '2025';


-- one time backfill 2024
CREATE FLOW
  registration_events_raw_backfill_2024
AS INSERT INTO ONCE
  registration_events_raw BY NAME
SELECT * FROM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/year=2024/*/*",
  format => "json",
  inferColumnTypes => true
);

-- one time backfill 2023
CREATE FLOW
  registration_events_raw_backfill_2023
AS INSERT INTO ONCE
  registration_events_raw BY NAME
SELECT * FROM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/year=2023/*/*",
  format => "json",
  inferColumnTypes => true
);

-- one time backfill 2022
CREATE FLOW
  registration_events_raw_backfill_2022
AS INSERT INTO ONCE
  registration_events_raw BY NAME
SELECT * FROM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/year=2022/*/*",
  format => "json",
  inferColumnTypes => true
);
Esta implementação destaca vários padrões importantes.
Separação de preocupações
- O processamento incremental é independente das operações de preenchimento.
- Cada fluxo tem suas próprias configurações e configurações de otimização.
- Há uma distinção clara entre operações incrementais e de preenchimento.
Execução controlada
- Usar a opção
ONCEgarante que cada preenchimento seja executado exatamente uma vez. - O fluxo de preenchimento permanece no gráfico pipeline , mas se torna paradoxo após sua conclusão. Ele está pronto para uso na refresh completa, automaticamente.
- Há uma trilha de auditoria clara das operações de aterramento na definição do pipeline.
Otimização de processamento
- Você pode dividir o preenchimento grande em vários preenchimentos menores para um processamento mais rápido ou para controlar o processamento.
- Usando o dimensionamento automático aprimorado, escale dinamicamente o tamanho cluster com base na carga atual cluster .
evolução do esquema
- Usar
schemaEvolutionMode="addNewColumns"manipula alterações de esquema com elegância. - Você tem inferência de esquema consistente em dados históricos e atuais.
- Há um tratamento seguro de novas colunas em dados mais recentes.
Adicionar um preenchimento retroativo a uma tabela SCD Tipo 2 do AUTO CDC
Use um fluxo AUTO CDC FROM SNAPSHOT único para adicionar um Snapshot autoritativo a um destino SCD Tipo 1 que também recebe um feed contínuo de captura de dados de alterações (CDC). A versão de snapshot e a coluna de sequenciamento de CDC formam um domínio de ordenação. Um evento de CDC mais recente tem precedência sobre um snapshot mais antigo, enquanto um snapshot mais recente tem precedência sobre um evento de CDC mais antigo.
Requisitos
Antes de adicionar o preenchimento retroativo, certifique-se de que os fluxos atendam aos seguintes requisitos:
- O destino usa SCD Tipo 1.
- O destino tem exatamente um fluxo
AUTO CDC FROM SNAPSHOTe um ou mais fluxosAUTO CDCcom nomes exclusivos. - Todos os fluxos usam o mesmo número de keys na mesma ordem. Os nomes de key do fluxo de snapshot são comparados sem diferenciar maiúsculas de minúsculas com os nomes de key de
AUTO CDC. Vários fluxos deAUTO CDCdevem usar nomes de key e maiúsculas/minúsculas idênticos. - A versão de snapshot e cada coluna de sequenciamento de CDC têm exatamente o mesmo tipo de dados.
- O fluxo
AUTO CDC FROM SNAPSHOTnão define expectativas. - Os fluxos
AUTO CDCnão usamIGNORE NULL UPDATES. Em Python, não definaignore_null_updates,ignore_null_updates_column_listouignore_null_updates_except_column_list. - O pipeline usa o modo Trigger. Esse padrão não oferece suporte a pipelines contínuos.
Ambos os tipos de fluxo podem usar a interface de pipeline em SQL ou Python. Você pode misturar fluxos em SQL e Python no mesmo destino.
O Snapshot deve representar o estado completo da origem em sua versão. Se uma key de destino estiver ausente do snapshot, AUTO CDC FROM SNAPSHOT tratará a ausência como uma exclusão na versão do snapshot. Um evento de CDC com uma versão mais recente preserva ou restaura a key.
Adicionar o preenchimento retroativo
Para adicionar um preenchimento de snapshot único e continuar processando os eventos de CDC, use os passos seguintes:
- Mantenha a tabela de destino existente e seus fluxos
AUTO CDCem andamento na definição do pipeline. - Defina o snapshot autoritativo e sua versão. Para um callback em Python, a primeira invocação deve retornar um snapshot e uma versão. Retorne
Noneapenas após pelo menos um snapshot ter sido processado. - Adicione um fluxo
AUTO CDC FROM SNAPSHOTcomonce=Trueem Python ouONCEem SQL. Para um preenchimento retroativo em SQL em um destino existente, inclua uma queryWITH VERSION. Um fluxo de snapshot SQL semWITH VERSIONoferece suporte apenas a uma carga inicial em um destino vazio. - Faça uma execução de uma atualização de pipeline com Trigger para processar o preenchimento retroativo e os eventos de CDC em andamento.
O exemplo a seguir começa com um pipeline Python existente que processa incrementalmente alterações de customers_cdc. Suponha que você já tenha executado este pipeline e preenchido o destino customers:
from pyspark import pipelines as dp
from pyspark.sql.functions import col, expr

@dp.view
def customers_cdc():
    return (
        spark.readStream.table("main.bronze.customers_cdc")
        .withColumn("change_timestamp", col("change_timestamp").cast("timestamp"))
    )


dp.create_streaming_table("customers")

dp.create_auto_cdc_flow(
    name="customers_incremental_cdc",
    target="customers",
    source="customers_cdc",
    keys=["customer_id"],
    sequence_by=col("change_timestamp"),
    apply_as_deletes=expr("operation = 'DELETE'"),
    except_column_list=["operation", "change_timestamp"],
    stored_as_scd_type=1,
)
Para preencher retroativamente esse destino existente com o estado de customers_snapshot em 1º de janeiro de 2025, adicione o seguinte código à mesma definição de pipeline. Mantenha a tabela de destino existente e o fluxo AUTO CDC:
from datetime import datetime, timezone
from typing import Optional, Tuple

from pyspark.sql import DataFrame

backfill_version = datetime(2025, 1, 1, tzinfo=timezone.utc)


def backfill_snapshot_and_version(
    latest_snapshot_version: Optional[datetime],
) -> Optional[Tuple[DataFrame, datetime]]:
    if latest_snapshot_version is None:
        return (spark.read.table("main.legacy.customers_snapshot"), backfill_version)
    return None


dp.create_auto_cdc_from_snapshot_flow(
    target="customers",
    source=backfill_snapshot_and_version,
    keys=["customer_id"],
    stored_as_scd_type=1,
    once=True,
)
O callback deve retornar um snapshot e uma versão em sua primeira invocação. Se ele retornar None antes que qualquer snapshot seja processado, a atualização do pipeline falhará. Depois que o snapshot for processado, retornar None sinaliza que não há snapshots adicionais disponíveis.
A versão do snapshot é um Python datetime, que corresponde ao tipo Spark SQL TIMESTAMP. O fluxo AUTO CDC existente converte change_timestamp em TIMESTAMP para que os dois tipos de sequenciamento correspondam exatamente. O exemplo usa Python para ambos os fluxos, mas você pode definir qualquer um dos fluxos em SQL e misturar fluxos em SQL e Python no mesmo destino. Para obter detalhes sobre a sintaxe do SQL, incluindo a query WITH VERSION necessária para um destino não vazio, consulte CREATE FLOW (pipelines).
Depois que o commit do fluxo de snapshot for bem-sucedido, as atualizações incrementais subsequentes o ignorarão enquanto o fluxo AUTO CDC continuar processando novos eventos.
Uma refresh completa do destino reexecuta o fluxo de snapshot único. Mantenha o snapshot disponível e garanta que ele ainda represente o estado pretendido antes de executar uma refresh completa.
Esse padrão unificado de preenchimento não oferece suporte ao SCD Tipo 2 ou a destinos bitemporais.
Exemplo: preencher um destino SCD durante uma migração
Um cenário comum de migração é uma tabela de dimensões que mudam lentamente (SCD) que já existe em um sistema legado com anos de história acumulada, mas cujo feed de alterações original não está mais disponível. Como os eventos de alteração originais desapareceram, você reproduz a história da própria tabela legada no novo destino AUTO CDC uma única vez e, em seguida, conecta um feed de CDC recente daqui para frente. Para obter mais informações sobre AUTO CDC e os tipos de SCD, consulte The AUTO CDC APIs: Simplify captura de dados de alterações (CDC) with pipelines.
O padrão é um fluxo AUTO CDC único para a mesma tabela de transmissão que o fluxo AUTO CDC contínuo tem como destino. Um destino AUTO CDC aceita apenas fluxos AUTO CDC, portanto, a semente também deve ser um fluxo AUTO CDC. Um fluxo de acréscimo INSERT INTO ONCE simples para a mesma tabela falha na validação:
- Crie a tabela de transmissão de destino na qual seu fluxo
AUTO CDCgrava. - Seed the legacy história one time com um fluxo
AUTO CDC ONCEque lê a tabela SCD legada como uma transmissão, sequenciada pela coluna de começar de validade legada. Repita as linhas legadas como eventos de mudança em vez de moldá-las você mesmo.AUTO CDCcria as colunas de__START_ATe__END_AThistória para um destino SCD Tipo 2, portanto, não grave essas colunas diretamente. - Anexe o fluxo
AUTO CDCem andamento lendo o feed de dados alterados mais recente.AUTO CDCresolve a ordenação por key, portanto, a transição deve ser válida para cada key de negócio individualmente: a primeira alteração em tempo real de cada key deve ser sequenciada após a última alteração semeada para essa mesma key. Um valor de sequência que seja apenas posterior ao máximo legado global ainda pode estar obsoleto para uma key individual, e a primeira alteração em tempo real dessa key é então ignorada ou ordenada incorretamente.
O código a seguir cria uma tabela de transmissão que usa os passos acima:
CREATE OR REFRESH STREAMING TABLE customers_history;

-- One-time seed: replay the legacy history as change events
CREATE FLOW customers_history_seed
AS AUTO CDC ONCE INTO customers_history
FROM stream(legacy.customers_scd2)
KEYS (customer_id)
SEQUENCE BY valid_from
STORED AS SCD TYPE 2;

-- Ongoing live CDC into the same target
CREATE FLOW customers_history_cdc
AS AUTO CDC INTO customers_history
FROM stream(customers_cdc_bronze)
KEYS (customer_id)
SEQUENCE BY change_timestamp
STORED AS SCD TYPE 2;
Ambos os fluxos devem concordar quanto às suas keys, ao seu tipo de SCD e ao tipo de dados da sua coluna de sequenciamento. No exemplo anterior, ambos os fluxos são sequenciados por um Timestamp, que utiliza um único tempo de transição para separar a história semeada do feed ativo. Se a tabela legada for sequenciada por um valor de um tipo diferente do feed ativo, converta um deles para que os tipos correspondam.
O mesmo formato funciona para um destino SCD tipo 1: altere STORED AS SCD TYPE 2 para STORED AS SCD TYPE 1 em ambos os fluxos, e o destino mantém apenas a linha atual por key. Antes de confiar em qualquer um dos formatos, valide em uma amostra de chaves se a primeira alteração ativa para uma chave semeada produz exatamente uma nova versão e fecha corretamente a anterior. Uma lacuna de sequenciamento por key geralmente aparece nessa etapa.