Rastrear execuções com a CLI Python antiga
Esta documentação foi desativada e pode não estar atualizada.
A CLI air baseada em Python, instalada com o pacote databricks-air, está obsoleta e não é mais mantida ativamente.
Use a CLI do Databricks para novas cargas de trabalho. Consulte Usar a CLI do Databricks com AI Runtime.
Cada carga de trabalho que você envia com air run é uma execução de job do Databricks e uma execução do MLflow:
- A execução do job (visível na página Jobs & Pipelines do workspace) rastreia a execução: status, compute, tentativas e saída do driver.
- A execução do MLflow rastreia o experimento: parâmetros, métricas, métricas de sistema e artefatos.
Uma submissão cria uma execução de job e uma execução do MLflow. Uma nova tentativa cria uma nova execução do MLflow.
Experimentos e execuções
Os seguintes campos YAML de workload controlam o experimento MLflow, a execução e o armazenamento de artefatos:
experiment_name: my-training # Creates or appends to this MLflow experiment
mlflow_run_name: baseline-lr3e5 # Names the MLflow run for this submission
# Stores artifacts in a UC volume
mlflow_artifact_location: /Volumes/main/default/mlflow-artifacts/my-training
compute:
  num_accelerators: 8
  accelerator_type: GPU_8xH100
command: torchrun --nproc_per_node=8 train.py
max_retries: 2
experiment_name(Obrigatório): cria um experiment do MLflow com esse nome caso ele não exista, ou adiciona uma nova execução ao experiment existente. Um experiment contém muitas execuções.mlflow_run_name(Opcional): Define o nome da execução. Se omitido, o nome da execução default para o nome do experimento (experiment_name).mlflow_artifact_location(Opcional): Define a localização raiz para artefatos. Se omitido, um novo experimento usa a localização DBFS default, e um experimento existente usa a localização vinculada aoexperiment_name. Para um volume do Unity Catalog, use/Volumes/<catalog>/<schema>/<volume>/.... Para um experimento existente, a localização especificada deve corresponder à localização do artefato do experimento ou ser omitida.max_retries(Opcional): Cada tentativa de repetição é uma nova execução do MLflow no mesmo experimento, para que você possa comparar as tentativas. A submissão original e suas repetições compartilham uma execução de job.

Navegar entre Jobs, MLflow e cargas de trabalho anteriores
Você pode acessar uma execução de três locais:
- Jobs : A página de execução de Jobs lista suas execuções, e cada execução faz link para sua execução e experimento do MLflow.
- MLflow : A página Experimentos lista seus experimentos do MLflow.
- Cargas de trabalho anteriores :
air get run <job-run-id>imprime links clicáveis para o job da execução, experimento e execução do MLflow.air list runslista suas execuções anteriores e permite que você filtre para encontrar uma execução específica.
air get run <job-run-id> # Links to the job, experiment, and MLflow run
air list runs # List previous runs; filter to find a specific run
Métricas do sistema
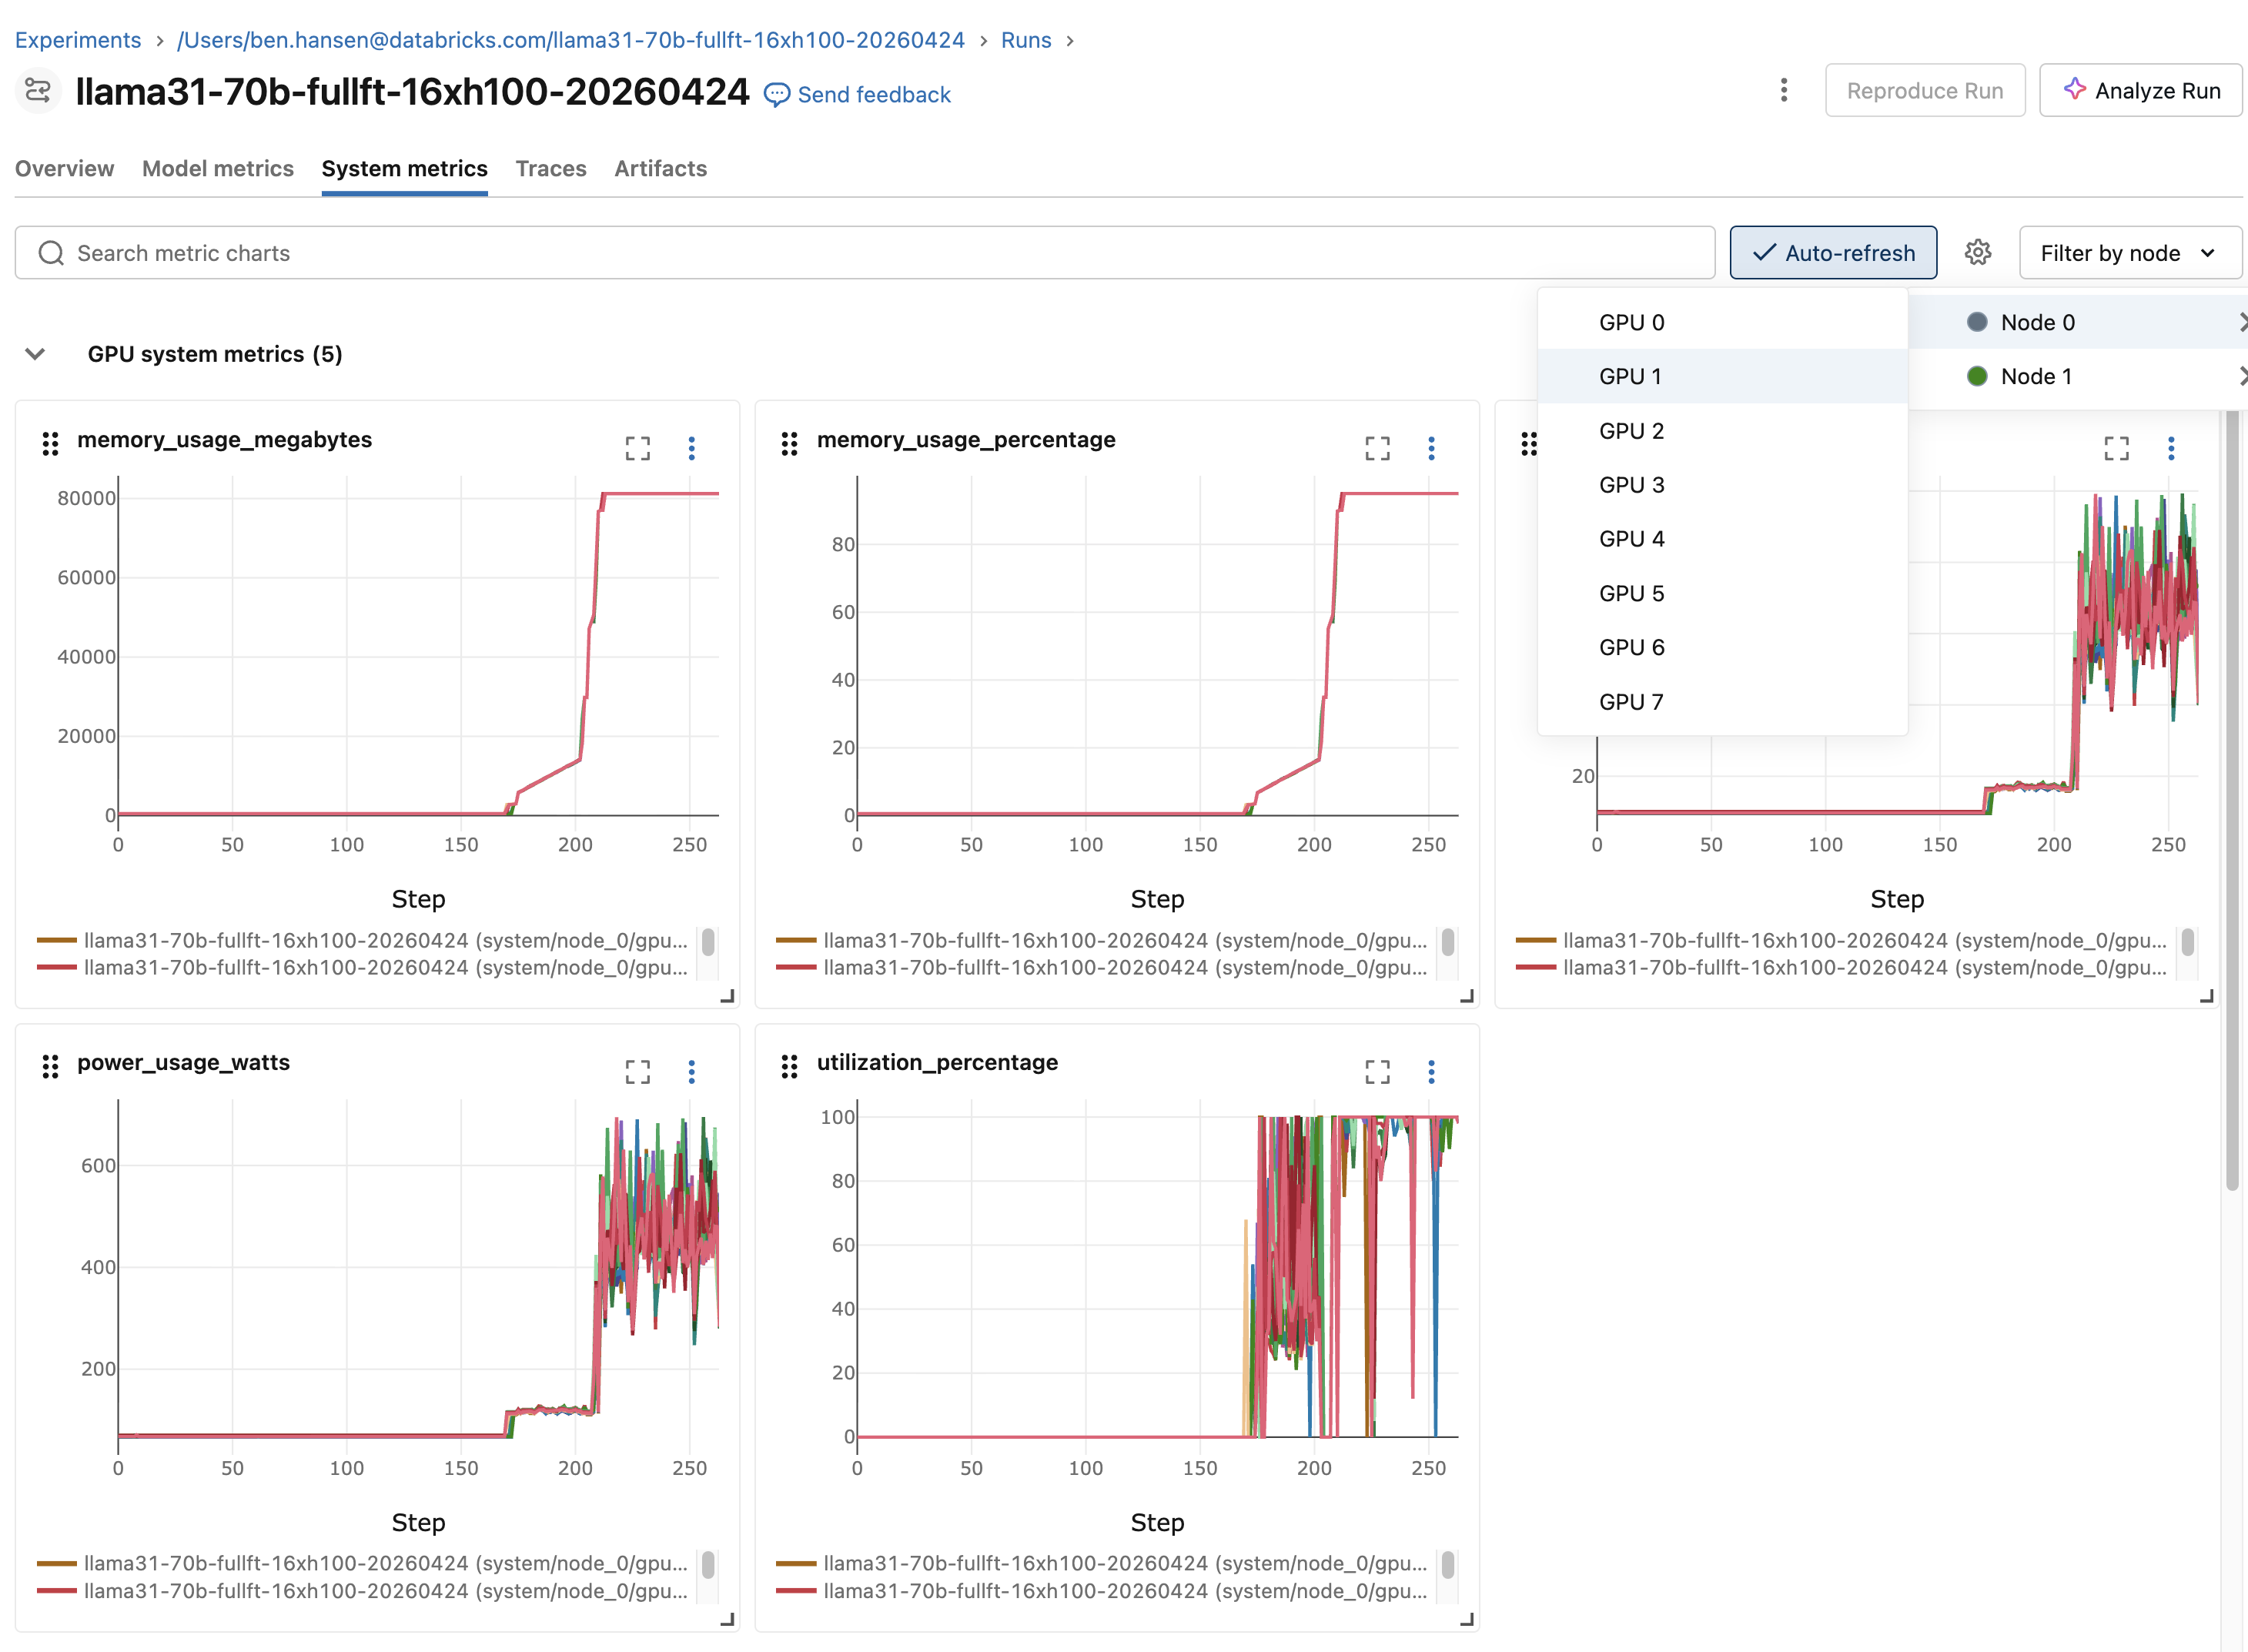
As métricas do sistema de GPU, CPU e memória são capturadas automaticamente para cada execução. Nenhuma configuração é necessária. Veja-as na tab Métricas do sistema da execução do MLflow.
Registrar métricas personalizadas
A plataforma cria a execução do MLflow e expõe seu ID ao seu processo de treinamento por meio da variável de ambiente MLFLOW_RUN_ID. Use a API de acompanhamento do MLflow para registrar seus próprios parâmetros, métricas e artefatos nessa execução.
Em cargas de trabalho distribuídas (vários nós), cada nó compartilha a mesma execução do MLflow. Registre apenas o processo de classificação 0, para que cada métrica seja registrada uma vez:
import os

import mlflow

# Log from rank 0 only; all nodes share the same MLFLOW_RUN_ID.
if os.environ.get("RANK", "0") == "0":
    with mlflow.start_run(run_id=os.environ["MLFLOW_RUN_ID"]):
        mlflow.log_param("learning_rate", 3e-4)
        for step, loss in enumerate(training_losses):
            mlflow.log_metric("train_loss", loss, step=step)
Logs e artefatos
Faça transmissão ou faça download dos Logs de uma execução com air logs:
air logs <job-run-id> # Stream logs from node 0
air logs <job-run-id> --node 2 # Logs from a specific node
air logs <job-run-id> --download-to ./logs/ # Download instead of streaming
Os logs também estão disponíveis como artefatos na execução do MLflow. Para persistir pontos de verificação de modelo, escreva-os em um volume do Unity Catalog. Para padrões de checkpoint, consulte Melhorar o desempenho e a resiliência do treinamento no AI Runtime.