Disponibilizar tabelas de recursos
As tabelas de recursos podem ser disponibilizadas de duas maneiras:
- servindo modelo : implante um modelo que foi treinado em tabelas de recursos. O mesmo endpoint é usado para a pesquisa de recursos e para a inferência de modelos. O endpoint busca ou computa valores de recursos automaticamente, usando a linhagem rastreada quando o modelo foi registrado. Use isto para servir previsões de modelos.
- Feature Serving : implante um
FeatureSpecque faça referência a tabelas de recursos diretamente, sem um modelo. O endpoint retorna as saídas de recursos solicitadas. Use isto quando um aplicativo precisar de valores de recursos em vez de previsões de modelo. Se você estiver usando recursos para inferência de modelo, o Databricks recomenda usar o servindo modelo diretamente.
Ambas as abordagens oferecem suporte a recursos pré-computados e sob demanda.
Requisitos
- Databricks Runtime 14.2 ML ou acima.
- Para usar a API do Python, o Feature Serving requer o site
databricks-feature-engineeringversão 0.1.2 ou acima, que está incorporado no Databricks Runtime 14.2 ML. Para versões anteriores do Databricks Runtime ML, instale manualmente a versão necessária usando%pip install databricks-feature-engineering>=0.1.2. Se estiver usando um notebook Databricks, o senhor deverá reiniciar o kernel Python executando este comando em uma nova célula:dbutils.library.restartPython(). - Para usar o Databricks SDK, Feature Serving requer
databricks-sdkversão 0.18.0 ou acima. Para instalar manualmente a versão necessária, use%pip install databricks-sdk>=0.18.0. Se estiver usando um notebook Databricks, o senhor deverá reiniciar o kernel Python executando este comando em uma nova célula:dbutils.library.restartPython().
Databricks Feature Serving fornece uma interface de usuário e várias opções programáticas para criar, atualizar, consultar e excluir pontos de extremidade. Este artigo inclui instruções para cada uma das opções a seguir:
- IU da Databricks
- API REST
- API do Python
- SDK da Databricks
Para usar o REST API ou MLflow Deployments SDK, o senhor deve ter um token Databricks API .
Como prática recomendada de segurança para cenários de produção, a Databricks recomenda que o senhor use tokens OAuth máquina a máquina para autenticação durante a produção.
Para testes e desenvolvimento, o site Databricks recomenda o uso de tokens de acesso pessoal pertencentes à entidade de serviço em vez de usuários do site workspace. Para criar tokens o site para uma entidade de serviço, consulte gerenciar tokens para uma entidade de serviço.
Autenticação para Feature Serving
Para obter informações sobre autenticação, consulte Autorizar acesso ao recurso Databricks.
Crie um FeatureSpec
O site FeatureSpec é um conjunto de recursos e funções definido pelo usuário. O senhor pode combinar recurso e funções em um FeatureSpec. FeatureSpecs são armazenados e gerenciados pelo site Unity Catalog e aparecem no Catalog Explorer.
As tabelas especificadas em um FeatureSpec devem ser publicadas em uma loja de recursos on-line ou em um armazenamento on-line de terceiros. Consulte Databricks Online recurso Stores.
O senhor deve usar o pacote databricks-feature-engineering para criar um FeatureSpec.
Primeiro, defina a função:
from unitycatalog.ai.core.databricks import DatabricksFunctionClient

client = DatabricksFunctionClient()

CATALOG = "main"
SCHEMA = "default"

def difference(num_1: float, num_2: float) -> float:
  """
  A function that accepts two floating point numbers, subtracts the second one
  from the first, and returns the result as a float.

  Args:
      num_1 (float): The first number.
      num_2 (float): The second number.

  Returns:
      float: The resulting difference of the two input numbers.
  """
  return num_1 - num_2

client.create_python_function(
  func=difference,
  catalog=CATALOG,
  schema=SCHEMA,
  replace=True
)
Em seguida, você pode usar a função em um FeatureSpec:
from databricks.feature_engineering import (
  FeatureFunction,
  FeatureLookup,
  FeatureEngineeringClient,
)

fe = FeatureEngineeringClient()

features = [
  # Lookup column `average_yearly_spend` and `country` from a table in UC by the input `user_id`.
  FeatureLookup(
    table_name="main.default.customer_profile",
    lookup_key="user_id",
    feature_names=["average_yearly_spend", "country"]
  ),
  # Calculate a new feature called `spending_gap` - the difference between `ytd_spend` and `average_yearly_spend`.
  FeatureFunction(
    udf_name="main.default.difference",
    output_name="spending_gap",
    # Bind the function parameter with input from other features or from request.
    # The function calculates num_1 - num_2.
    input_bindings={"num_1": "ytd_spend", "num_2": "average_yearly_spend"},
  ),
]

# Create a `FeatureSpec` with the features defined above.
# The `FeatureSpec` can be accessed in Unity Catalog as a function.
fe.create_feature_spec(
  name="main.default.customer_features",
  features=features,
)
Especifique os valores d default
Para especificar valores de default para recurso, utilize o parâmetro default_values em FeatureLookup. Veja o exemplo a seguir:
feature_lookups = [
    FeatureLookup(
        table_name="ml.recommender_system.customer_features",
        feature_names=[
            "membership_tier",
            "age",
            "page_views_count_30days",
        ],
        lookup_key="customer_id",
        default_values={
          "age": 18,
          "membership_tier": "bronze"
        },
    ),
]
Se as colunas de recurso forem renomeadas usando o parâmetro " rename_outputs ", o comando " default_values " deverá utilizar os nomes renomeados dos recursos.
FeatureLookup(
  table_name = 'main.default.table',
  feature_names = ['materialized_feature_value'],
  lookup_key = 'id',
  rename_outputs={"materialized_feature_value": "feature_value"},
  default_values={
    "feature_value": 0
  }
)
Adicionar dependências do Python
Se uma função definida pelo usuário (UDF) importar pacotes Python, declare-os ao criar o FeatureSpec. O parâmetro extra_pip_requirements requer databricks-feature-engineering versão 0.17.0 ou acima. O Feature Serving instala os pacotes MLflow e databricks-feature-lookup automaticamente.
Por exemplo, se um UDF em sua especificação de recurso importar o NumPy, adicione o requisito à especificação:
fe.create_feature_spec(
    name="main.default.customer_features_with_dependencies",
    features=features,
    extra_pip_requirements=["numpy==1.26.4"],
)
Use main.default.customer_features_with_dependencies como o nome da especificação quando você criar o endpoint.
Cada entrada em extra_pip_requirements deve ser uma string de requisito do PyPI, como numpy==1.26.4, ou o caminho para um arquivo .whl em um volume do Unity Catalog. Por exemplo, use /Volumes/main/libraries/wheels/custom_features-1.0.0-py3-none-any.whl para uma wheel que você tenha feito upload. O criador do endpoint deve ter READ VOLUME no volume e USE CATALOG e USE SCHEMA em seu catálogo pai e esquema.
Para pacotes de um repository privado, configure o repository de pacotes default do Workspace. Não coloque opções de comando do pip, como --index-url, em extra_pip_requirements.
As dependências na cláusula ENVIRONMENT de uma UDF do Unity Catalog aplicam-se à execução de SQL offline. O Feature Serving não os copia automaticamente. Declare todos os pacotes necessários para as UDFs, incluindo UDFs em recursos upstream, nos requisitos da especificação do recurso.
Se a implantação do endpoint falhar, inspecione os logs de compilação em busca de erros de instalação de pacote, conflitos de versão ou falhas de acesso ao wheel. Consulte Monitorar a qualidade do modelo e a integridade do endpoint.
Para ver um exemplo com CustomUDF e FeatureViewSource, consulte Disponibilizar recursos CustomUDF e suas dependências. Para obter dependências de servindo modelo, consulte Dependências de UDF personalizada.
Criar um endpoint
O FeatureSpec define o endpoint. Para obter mais informações, consulte Create custom servindo modelo endpoint, a documentação Python API ou a documentaçãoDatabricks SDK para obter detalhes.
Para cargas de trabalho que são sensíveis à latência ou que exigem altas consultas por segundo, a servindo modelo oferece otimização de rota no endpoint personalizado da servindo modelo, consulte Otimização de rota no endpoint da servindo.
- Databricks SDK - Python
- Python API
- REST API
from databricks.sdk import WorkspaceClient
from databricks.sdk.service.serving import EndpointCoreConfigInput, ServedEntityInput

workspace = WorkspaceClient()

# Create endpoint
workspace.serving_endpoints.create(
  name="my-serving-endpoint",
  config = EndpointCoreConfigInput(
    served_entities=[
    ServedEntityInput(
        entity_name="main.default.customer_features",
        scale_to_zero_enabled=True,
        workload_size="Small"
      )
    ]
  )
)
from databricks.feature_engineering.entities.feature_serving_endpoint import (
  ServedEntity,
  EndpointCoreConfig,
)

fe.create_feature_serving_endpoint(
  name="customer-features",
    config=EndpointCoreConfig(
    served_entities=ServedEntity(
      feature_spec_name="main.default.customer_features",
             workload_size="Small",
             scale_to_zero_enabled=True,
             instance_profile_arn=None,
    )
  )
)
curl -X POST -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints \
    -H 'Content-Type: application/json' \
    -d '"name": "customer-features",
   "config": {
       "served_entities": [
           {
               "entity_name": "main.default.customer_features",
               "workload_size": "Small",
               "scale_to_zero_enabled": true
           }
       ]
   }'
Para visualizar o endpoint, clique em "Serving" na barra lateral esquerda da interface do Databricks. Quando o estado for Pronto , o endpoint estará pronto para responder a consultas. Para saber mais sobre modelo de atividade, consulte modelo de atividade.
Salvar o DataFrame ampliado na tabela de inferência
Para endpoints criados a partir de fevereiro de 2025, o senhor pode configurar o modelo de serviço endpoint para log o DataFrame aumentado que contém os valores de recurso pesquisados e os valores de retorno de função. O DataFrame é salvo na tabela de inferência do modelo atendido.
Para obter instruções sobre como definir essa configuração, consulte log recurso lookup DataFrames to inference tables.
Para obter informação sobre tabelas de inferência, consulte Registrar solicitações e respostas para Endpoint de serviço (legado).
Obter um endpoint
O senhor pode usar o SDK da Databricks ou a API do Python para obter os metadados e o status de um endpoint.
- Databricks SDK - Python
- Python API
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

endpoint = workspace.serving_endpoints.get(name="customer-features")
# print(endpoint)
endpoint = fe.get_feature_serving_endpoint(name="customer-features")
# print(endpoint)
Obter o esquema de um endpoint
É possível utilizar o Databricks SDK ou o REST API para obter o esquema de um endpoint. Para obter mais informações sobre o esquema endpoint, consulte Obter um modelo de serviço do esquema endpoint.
- Databricks SDK - Python
- REST API
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

# Create endpoint
endpoint = workspace.serving_endpoints.get_open_api(name="customer-features")
ACCESS_TOKEN=<token>
ENDPOINT_NAME=<endpoint name>

curl "https://example.databricks.com/api/2.0/serving-endpoints/$ENDPOINT_NAME/openapi" -H "Authorization: Bearer $ACCESS_TOKEN" -H "Content-Type: application/json"
Consultar um endpoint
O senhor pode usar a REST API, o MLflow Deployments SDK ou a Serving UI para consultar um endpoint.
O código a seguir mostra como configurar as credenciais e criar o cliente ao usar o SDK do MLflow Deployments.
  # Set up credentials
  export DATABRICKS_HOST=...
  export DATABRICKS_TOKEN=...
  # Set up the client
  import mlflow.deployments

  client = mlflow.deployments.get_deploy_client("databricks")
Como prática recomendada de segurança ao se autenticar com ferramentas, sistemas, scripts e aplicativos automatizados, a Databricks recomenda que você use tokens OAuth.
Se o senhor usar a autenticação de tokens de acesso pessoal, a Databricks recomenda usar o acesso pessoal tokens pertencente à entidade de serviço em vez de usuários workspace. Para criar tokens o site para uma entidade de serviço, consulte gerenciar tokens para uma entidade de serviço.
Consultar um site endpoint usando APIs
Esta seção inclui exemplos de consulta a um endpoint usando a API REST ou o SDK do MLflow Deployments.
- MLflow Deployments SDK
- REST API
O exemplo a seguir usa a API predict() do SDK do MLflow Deployments. Esta API é experimental e a definição da API pode mudar.
import mlflow.deployments

client = mlflow.deployments.get_deploy_client("databricks")
response = client.predict(
    endpoint="test-feature-endpoint",
    inputs={
        "dataframe_records": [
            {"user_id": 1, "ytd_spend": 598},
            {"user_id": 2, "ytd_spend": 280},
        ]
    },
)
curl -X POST -u token:$DATABRICKS_API_TOKEN $ENDPOINT_INVOCATION_URL \
  -H 'Content-Type: application/json' \
  -d '{"dataframe_records": [
          {"user_id": 1, "ytd_spend": 598},
          {"user_id": 2, "ytd_spend": 280}
      ]}'
Consultar um endpoint usando a UI
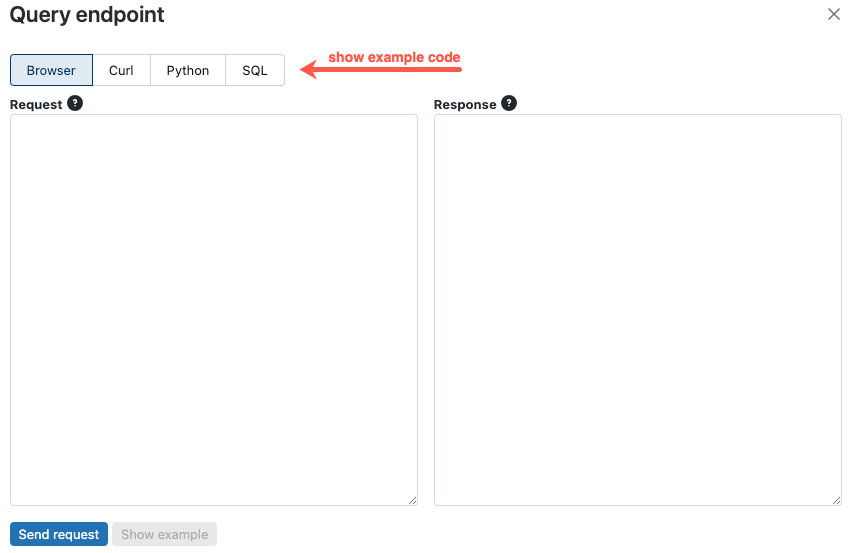
O senhor pode consultar um serviço endpoint diretamente da Serving UI. A interface do usuário inclui exemplos de códigos gerados que o senhor pode usar para consultar o endpoint.
-
Na barra lateral esquerda do site Databricks workspace, clique em Serving .
-
Clique no endpoint que o senhor deseja consultar.
-
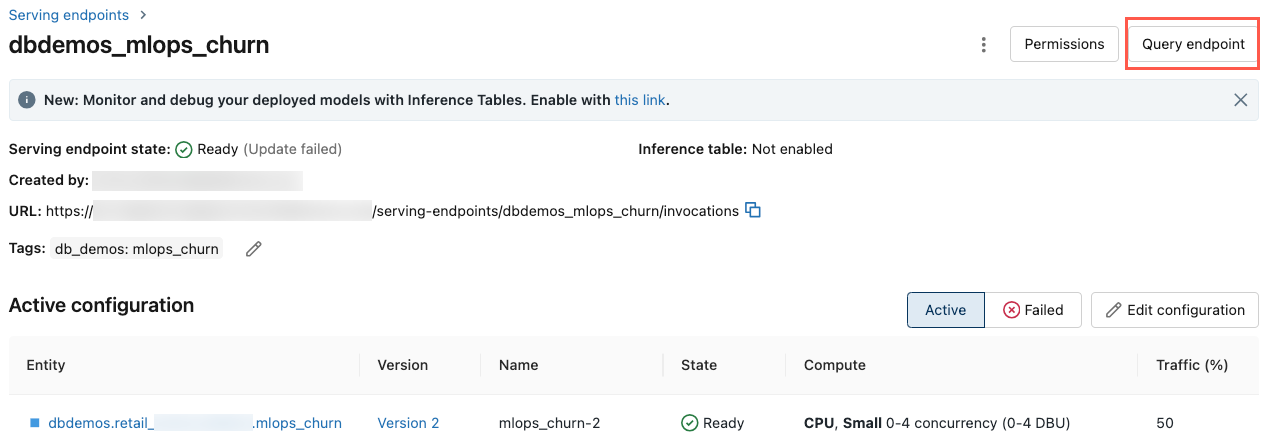
No canto superior direito da tela, clique em Query endpoint (Consultar ponto de extremidade ).
-
Na caixa Request (Solicitação ), digite o corpo da solicitação no formato JSON.
-
Clique em Enviar solicitação .
// Example of a request body.
{
  "dataframe_records": [
    { "user_id": 1, "ytd_spend": 598 },
    { "user_id": 2, "ytd_spend": 280 }
  ]
}
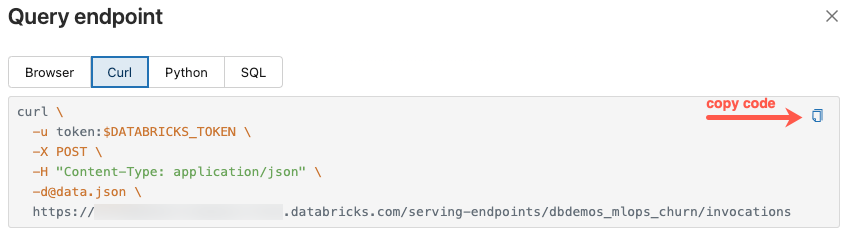
A caixa de diálogo do endpoint Query inclui um código de exemplo gerado em curl, Python e SQL. Clique na guia view e copie o código de exemplo.
Para copiar o código, clique no ícone de cópia no canto superior direito da caixa de texto.
Atualizar e endpoint
Para modificar a configuração de um endpoint Feature Serving (como alterar o FeatureSpec ou o tamanho da carga de trabalho), use sempre as APIs de atualização descritas nesta seção. Não exclua e recrie o endpoint para aplicar as alterações. A exclusão de um endpoint ativo causa indisponibilidade imediata e interrompe todos os aplicativos que o consultam.
O senhor pode atualizar um endpoint usando a REST API, o Databricks SDK ou a Serving UI.
Atualize o site endpoint usando APIs
- Databricks SDK - Python
- REST API
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

workspace.serving_endpoints.update_config(
  name="my-serving-endpoint",
  served_entities=[
    ServedEntityInput(
      entity_name="main.default.customer_features",
      scale_to_zero_enabled=True,
      workload_size="Small"
    )
  ]
)
curl -X PUT -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints/<endpoint_name>/config \
  -H 'Content-Type: application/json' \
  -d '"served_entities": [
        {
            "name": "customer-features",
            "entity_name": "main.default.customer_features_new",
            "workload_size": "Small",
            "scale_to_zero_enabled": True
        }
    ]'
Atualizar um endpoint usando a UI
Siga estas etapas para usar a Serving UI:
- Na barra lateral esquerda do site Databricks workspace, clique em Serving .
- Na tabela, clique no nome do endpoint que o senhor deseja atualizar. A tela do endpoint é exibida.
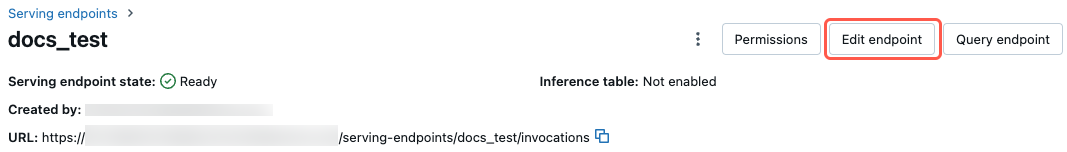
- No canto superior direito da tela, clique em Editar endpoint .
- Na caixa de diálogo Edit serving endpoint (Editar endpoint de serviço ), edite as configurações do endpoint conforme necessário.
- Clique em Atualizar para salvar suas alterações.
Excluir um endpoint
Essa ação é irreversível. A exclusão de um endpoint do Feature Serving causa indisponibilidade imediata para quaisquer aplicativos que o consultem. Se você deseja alterar a configuração do endpoint, use "Atualizar um endpoint" em vez de excluir e recriar o endpoint.
O senhor pode excluir um endpoint usando a REST API, o Databricks SDK, a Python API ou a Serving UI.
Excluir um endpoint usando APIs
- Databricks SDK - Python
- Python API
- REST API
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

workspace.serving_endpoints.delete(name="customer-features")
fe.delete_feature_serving_endpoint(name="customer-features")
curl -X DELETE -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints/<endpoint_name>
Excluir um endpoint usando a interface do usuário
Siga estas etapas para excluir um endpoint usando a Serving UI:
- Na barra lateral esquerda do site Databricks workspace, clique em Serving .
- Na tabela, clique no nome do endpoint que o senhor deseja excluir. A tela do endpoint é exibida.
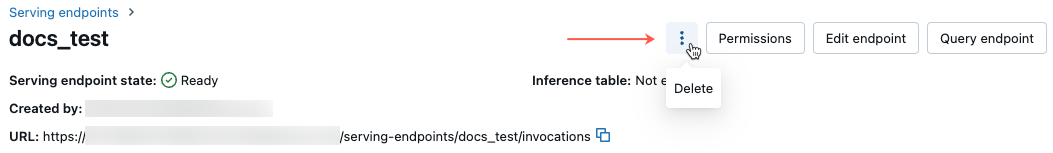
- No canto superior direito da tela, clique no menu de kebab
 e selecione Excluir.
Monitorar a integridade de um endpoint
Para obter informações sobre o logs e as métricas disponíveis para o endpoint Feature Serving, consulte Monitorar a qualidade do modelo e a saúde do endpoint.
Controle de acesso
Para obter informações sobre permissões no endpoint Feature Serving , consulte gerenciar permissões em um modelo endpointopcional.
Exemplo de notebook
Este Notebook ilustra como usar o SDK Databricks para criar um endpoint Feature Serving usando Databricks Online Feature Store.