Referência da API de Views de recurso
Visualização
Este recurso está em Prévia Pública. Administradores do Workspace podem controlar o acesso a este recurso na página **Pré-visualizações**. Consulte Gerenciar prévias do Databricks.
Controle de acesso
Recursos são objetos governáveis do Unity Catalog. O acesso a um recurso é controlado pelos privilégios CREATE FEATURE, READ FEATURE e MANAGE do Unity Catalog. Para descrições completas, consulte referência de privilégios do Unity Catalog.
CREATE FEATURE: necessário para criar um recurso em um esquema.create_featureeregister_featureexigemCREATE FEATUREno esquema pai. Seguindo o princípio do privilégio mínimo, concedaCREATE FEATUREno nível do esquema; você também pode concedê-lo em um catálogo para permitir a criação de recursos em qualquer esquema desse catálogo.READ FEATURE: necessário para ler metadados de recursos.get_feature,create_training_setelist_materialized_featuresexigemREAD FEATUREno recurso. Esse privilégio não concede acesso aos dados de recursos na origem ou em tabelas de saída materializadas. Para ler esses dados para treinamento ou serving, você também deve terSELECTnas tabelas aplicáveis.READ FEATUREconcedido em um esquema ou catálogo se aplica a todos os recursos atuais e futuros que ele contém.MANAGE: necessário para gerenciar o ciclo de vida e as concessões de um recurso. A exclusão de um recurso comdelete_featuree a materialização de um recurso commaterialize_featuresexigemMANAGEno recurso. A exclusão de um recurso materializado comdelete_materialized_featurenão é governada porMANAGE: apenas o criador do recurso materializado pode excluí-lo.
Todas as operações de recurso também exigem USE CATALOG no catálogo pai e USE SCHEMA no esquema pai. Para saber como MANAGE e READ FEATURE se aplicam à materialização, consulte Permissões.
API de View de recurso
ConstrutorFeature e register_feature()
A abordagem recomendada é construir um objeto Feature localmente e usar register_feature para persistir no Unity Catalog. Este fluxo de trabalho de duas etapas permite experimentar recursos (incluindo create_training_set) antes de registrá-los.
Feature(
    source: DataSource,                                    # Required: DeltaTableSource, StreamSource, RequestSource, or FeatureViewSource
    function: Union[AggregationFunction, ColumnSelection, CustomUDF], # Required for all features
    entity: Optional[List[str]] = None,                    # Required for DeltaTableSource and StreamSource
    timeseries_column: Optional[str] = None,               # Required for DeltaTableSource and StreamSource
    name: Optional[str] = None,                            # Optional: Feature name (auto-generated if omitted)
    description: Optional[str] = None,                     # Optional: Feature description
)
FeatureEngineeringClient.register_feature() registra um Feature construído localmente no Unity Catalog.
FeatureEngineeringClient.register_feature(
    feature: Feature,       # Required: A Feature instance (not already registered)
    catalog_name: str,      # Required: UC catalog name
    schema_name: str,       # Required: UC schema name
) -> Feature
from databricks.feature_engineering.entities import Feature, DeltaTableSource, AggregationFunction, Sum, RollingWindow
from datetime import timedelta

# Step 1: Construct the feature locally
feature = Feature(
    source=DeltaTableSource(catalog_name="main", schema_name="store", table_name="transactions"),
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)

# Step 2: Register in Unity Catalog
fe = FeatureEngineeringClient()
registered_feature = fe.register_feature(
    feature=feature,
    catalog_name="main",
    schema_name="store",
)
create_feature()
FeatureEngineeringClient.create_feature() Valida, constrói e registra imediatamente um recurso no Unity Catalog em um único passo. Use isto quando você não precisar experimentar o recurso localmente primeiro.
FeatureEngineeringClient.create_feature(
    source: DataSource,                                    # Required: DeltaTableSource, StreamSource, RequestSource, or FeatureViewSource
    function: Union[AggregationFunction, ColumnSelection, CustomUDF], # Required for all features
    catalog_name: str,                                     # Required: The catalog name for the feature
    schema_name: str,                                      # Required: The schema name for the feature
    entity: Optional[List[str]] = None,                    # Required for DeltaTableSource and StreamSource
    timeseries_column: Optional[str] = None,               # Required for DeltaTableSource and StreamSource
    name: Optional[str] = None,                            # Optional: Feature name (auto-generated if omitted)
    description: Optional[str] = None,                     # Optional: Feature description
) -> Feature
Parâmetros:
source: A fonte de dados usada na computação de recurso (DeltaTableSource,StreamSource,RequestSourceouFeatureViewSource).function: umAggregationFunctionque agrupa um operador e uma janela de tempo,ColumnSelection("column_name")para recursos de passagem ouCustomUDFpara transformações linha a linha. Consulte Funções compatíveis para ver os tipos de origem compatíveis.catalog_name: O nome do catálogo do Unity Catalog para o recurso.schema_name: O nome do esquema do Unity Catalog para o recurso.entity: Lista de nomes de colunas que definem a agregação ou as chaves de busca (chaves primárias). Obrigatório paraDeltaTableSourceeStreamSource. Por exemplo,["user_id"]realiza agregações ou buscas por usuário. Omitir paraRequestSourceeFeatureViewSource.timeseries_column: A coluna timestamp usada para agregação de janela de tempo ou seleção de valor mais recente. Necessário paraDeltaTableSourceeStreamSource. Omitir paraRequestSourceeFeatureViewSource.name: Nome de recurso opcional. Se omitido, gerado automaticamente a partir da coluna de entrada, função e janela (por exemplo,amount_avg_rolling_7d).description: Descrição opcional do recurso.
Retorna: Uma instância de recurso validada
Gera: ValueError se alguma validação falhar
delete_feature()
Exclui um recurso do Unity Catalog pelo seu nome totalmente qualificado.
FeatureEngineeringClient.delete_feature(
    full_name: str,  # Required: '<catalog>.<schema>.<feature_name>'
) -> None
fe.delete_feature(full_name="main.store.amount_sum_rolling_7d")
Antes de excluir um recurso, remova ou atualize todos os modelos ou especificações de recurso que façam referência a ele. Não é possível excluir um recurso enquanto ele ainda tiver recursos materializados. Exclua os recursos materializados primeiro e, em seguida, exclua o recurso. Consulte Como excluir um recurso materializado.
Nomes gerados automaticamente
Quando name é omitido, um nome é gerado automaticamente. Os nomes gerados seguem o padrão: {column}_{function}_{window}. Por exemplo:
price_avg_rolling_1h(preço médio de 1 hora)transaction_count_rolling_30d_1d(Contagem de 30 dias de transação com atraso de 1 dia do timestamp do evento)
Funções suportadas
Funções de agregação
As funções de agregação são encapsuladas em um AggregationFunction junto com uma janela de tempo, conforme descrito em janelas de tempo. Cada função recebe um parâmetro input que especifica a coluna de origem a ser agregada.
Função | Descrição | Exemplo de caso de uso |
|---|---|---|
| Total de valores | Uso diário do aplicativo por usuário em minutos |
| Média de valores | Valor médio da transação |
| Número de registros | Número de logins por usuário |
| Valor mínimo | Menor frequência cardíaca registrada por um dispositivo wearable |
| Valor máximo | Maior valor de transação por sessão. |
| Desvio padrão populacional | Variabilidade diária do valor da transação entre todos os clientes |
| Desvio padrão de amostra | Variabilidade das taxas de cliques de campanhas de anúncios |
| Variância populacional | Dispersão das leituras do sensor para dispositivos IoT em uma fábrica. |
| Variância de amostra | Distribuição de avaliações de filmes em um grupo amostrado |
| Contagem única aproximada | Contagem distinta de itens comprados |
| Percentil aproximado | Latência de resposta p95 |
| Primeiro valor | Primeiro login Timestamp |
| Último valor | Valor de compra mais recente |
| Primeiros | Três primeiros produtos visualizados em uma sessão |
| Últimos | Três status de caso de suporte mais recentes |
| Primeiros | Três primeiras categorias de produto distintas visualizadas |
| Últimos | Três categorias de comerciante distintas mais recentes |
First, Last, FirstN, LastN, FirstDistinct e LastDistinct incluem valores nulos por default. Para ignorar nulos, adicione um filter_condition que exclua explicitamente colunas de entrada que sejam nulas.
FirstN, LastN, FirstDistinct e LastDistinct usam o timeseries_column do recurso para ordenar linhas de entrada e retornar uma matriz contendo até n valores. O parâmetro n deve ser um número inteiro positivo. FirstN e FirstDistinct selecionam valores do mais antigo para o mais recente. LastN e LastDistinct selecionam valores do mais recente para o mais antigo e, em seguida, retornam os valores selecionados na ordem de timestamp. FirstDistinct e LastDistinct removem valores duplicados ao selecionar valores nessa direção.
Por exemplo, se as linhas de origem de uma entidade forem ordenadas por event_time como ["A", "A", "B", "C", "B", "B"], as seguintes funções retornam:
Função | Resultado |
|---|---|
|
|
|
|
|
|
|
|
FirstN, LastN, FirstDistinct e LastDistinct requerem a versão 0.17.0 ou posterior do databricks-feature-engineering.
CustomUDF
CustomUDF aplica uma função definida pelo usuário (UDF) Python registrada no Unity Catalog a cada linha. Use-o para transformar entradas de solicitação ou combinar valores de recursos. Ele não agrega linhas ou define um intervalo temporal.
CustomUDF(
    function_name="main.ecommerce.log_amount_udf",
    input_bindings={"amount": "transaction_amount"},
)
input_bindings maps each UDF parameter name to an input. For RequestSource, the input is a source column name. For FeatureViewSource, it is an upstream recurso reference. Bind every UDF parameter, including parameters with defaults. Input types must match the UDF parameter types exactly, without implicit numeric casts. Use scalar input and return types.
Origem | Comportamento |
|---|---|
| Transforma colunas do DataFrame de treinamento ou da requisição de inferência. |
| Combina valores de recurso upstream. Veja FeatureViewSource. |
Os recursos CustomUDF com suporte do Delta não podem ser materializados ou disponibilizados online. Para transformar os valores de recurso baseados em tabela para treinamento e disponibilização, defina uma agregação baseada em Delta ou um recurso de seleção de coluna e faça referência a ele por meio de FeatureViewSource.
CustomUDF não é compatível com StreamSource. Para transformar a saída de um recurso de transmissão, faça referência a esse recurso por meio de FeatureViewSource.
CustomUDF with RequestSource requires databricks-feature-engineering version 0.17.0 or later.
Para usar um CustomUDF, você precisa do privilégio EXECUTE no UDF, do privilégio USE CATALOG no seu catálogo pai e do privilégio USE SCHEMA no seu esquema pai.
The following example uses NumPy to compute log(1 + amount), reducing the escala of large transaction amounts. Run it on serverless compute with custom UDF dependencies enabled. The main.ecommerce schema must exist.
spark.sql("""
CREATE OR REPLACE FUNCTION main.ecommerce.log_amount_udf(amount DOUBLE)
RETURNS DOUBLE
LANGUAGE PYTHON
ENVIRONMENT (
  dependencies = '["numpy==1.26.4"]',
  environment_version = '5'
)
AS $$
import numpy as np

if amount is None or not np.isfinite(amount) or amount < 0:
    return None
return float(np.log1p(amount))
$$
""")
Registrar um recurso que vincula a coluna de solicitação transaction_amount ao parâmetro UDF amount:
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    CustomUDF, FieldDefinition, RequestSource, ScalarDataType,
)

fe = FeatureEngineeringClient()

log_transaction_amount = fe.create_feature(
    source=RequestSource(
        schema=[
            FieldDefinition(name="transaction_amount", data_type=ScalarDataType.DOUBLE),
        ]
    ),
    function=CustomUDF(
        function_name="main.ecommerce.log_amount_udf",
        input_bindings={"amount": "transaction_amount"},
    ),
    catalog_name="main",
    schema_name="ecommerce",
    name="log_transaction_amount",
)
O ENVIRONMENT do UDF configura dependências para computação offline. Para o serving online, declare também os pacotes em create_feature_spec(extra_pip_requirements=...) ou log_model(extra_pip_requirements=...). Eles não são copiados do UDF automaticamente. Consulte dependências do Feature Serving e dependências do modelo.
CustomUDF recursos não podem ser materializados. UDFs baseadas em solicitação e em recursos são executadas sob demanda durante o treinamento e a disponibilização. Cada UDF em uma cadeia de dependência adiciona computação, portanto, mantenha funções e cadeias pequenas. As UDFs devem lidar com entradas ausentes, que podem ser None offline ou NaN online.
For guidance on handling missing values, see How to handle missing recurso values.
ColumnSelection (pass-through)
ColumnSelection seleciona uma única coluna de uma fonte sem aplicar nenhuma agregação. É encapsulado diretamente no parâmetro function (não dentro de AggregationFunction). O tipo de retorno é inferido do esquema de origem.
Função | Descrição | Exemplo de caso de uso |
|---|---|---|
| Último valor de uma coluna (sem agregação) | Categoria de fornecedor mais recente, pass-through de um campo de solicitação |
ColumnSelection supports the following fontes de dados:
DeltaTableSource: Retorna o valor mais recente por chave de entidade via um join pontual (sem agregação de janela de retrospectiva).StreamSource: Retorna o valor mais recente por chave de entidade da transmissão (sem agregação de janela de retrospectiva).RequestSource: Passa o valor fornecido no momento da inferência (ou extraído do DataFrame rotulado no momento do treinamento).
Para DeltaTableSource, os recursos ColumnSelection oferecem suporte a filter_condition e transformation_sql, aplicados antes da seleção do valor mais recente, da mesma forma que os recursos de agregação.
from databricks.feature_engineering.entities import (
    ColumnSelection, DeltaTableSource, Feature, FieldDefinition,
    RequestSource, ScalarDataType,
)

delta_source = DeltaTableSource(
    catalog_name="main", schema_name="feature_store", table_name="transactions",
)

request_source = RequestSource(
    schema=[
        FieldDefinition(name="session_duration", data_type=ScalarDataType.DOUBLE),
    ]
)

# ColumnSelection from a Delta table
latest_amount = Feature(
    source=delta_source,
    function=ColumnSelection("amount"),
    entity=["user_id"],
    timeseries_column="transaction_time",
    name="latest_transaction_amount",
)

# ColumnSelection from a RequestSource
session_feature = Feature(
    source=request_source,
    function=ColumnSelection("session_duration"),
    name="session_duration",
)
Exemplo: recursos de agregação e seleção de colunas
O exemplo a seguir mostra recursos definidos sobre a mesma fonte de dados.
from databricks.feature_engineering.entities import (
    AggregationFunction, Feature, Sum, Avg, ApproxCountDistinct,
    ColumnSelection, RollingWindow,
)
from datetime import timedelta

window = RollingWindow(window_duration=timedelta(days=7))

sum_feature = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(Sum(input="amount"), window),
)

avg_feature = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(Avg(input="amount"), window),
)

distinct_count = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(ApproxCountDistinct(input="product_id", relativeSD=0.01), window),
)

# Column selection (no aggregation, no time window)
latest_amount = Feature(
    source=source,
    function=ColumnSelection("amount"),
    entity=["user_id"],
    timeseries_column="event_time",
    name="latest_amount",
)
Recursos com condições de filtro
O parâmetro filter_condition permite filtrar linhas da tabela de origem antes de calcular agregações ou selecionar o valor da coluna mais recente. Isso funciona como uma cláusula SQL WHERE aplicada antes de agrupar e agregar os dados.
Para recursos de agregação, filter_condition filtra as linhas antes da agregação, como uma cláusula WHERE do SQL aplicada antes de GROUP BY. Isso não altera a granularidade, que é sempre definida por entity na definição do recurso.
Filtros são úteis ao trabalhar com grandes tabelas de origem que incluem um superconjunto de dados necessários para o compute de recursos, e minimizam a necessidade de criar views separadas sobre essas tabelas.
from databricks.feature_engineering.entities import AggregationFunction, Sum, Count, RollingWindow, DeltaTableSource
from datetime import timedelta

# Source with filter applied at the source level
high_value_transactions = DeltaTableSource(
    catalog_name="main",
    schema_name="ecommerce",
    table_name="transactions",
    filter_condition="amount > 100",  # Only transactions over $100
)

high_value_sales = Feature(
    source=high_value_transactions,
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=30))),
)

# Multiple conditions
completed_orders_source = DeltaTableSource(
    catalog_name="main",
    schema_name="ecommerce",
    table_name="orders",
    filter_condition="status = 'completed' AND payment_method = 'credit_card'",
)

completed_orders = Feature(
    source=completed_orders_source,
    entity=["user_id"],
    timeseries_column="order_time",
    function=AggregationFunction(Count(input="order_id"), RollingWindow(window_duration=timedelta(days=7))),
)

# Filter on a StreamSource
from databricks.feature_engineering.entities import StreamSource

purchase_stream = StreamSource(
    full_name="main.ecommerce.transactions_stream",
    filter_condition="value.event_type = 'purchase'",
)

purchase_total = Feature(
    source=purchase_stream,
    entity=["value.user_id"],
    timeseries_column="value.event_time",
    function=AggregationFunction(Sum(input="value.amount"), RollingWindow(window_duration=timedelta(hours=1))),
)
fonte de dados
DeltaTableSource
DeltaTableSource é um objeto Python efêmero usado para definir como os recursos são computados a partir de uma tabela de origem. Não cria uma nova tabela. Ele especifica a configuração para ler dados e agregar recursos.
DeltaTableSource(
    catalog_name: str,                              # Required: Catalog name
    schema_name: str,                               # Required: Schema name
    table_name: str,                                # Required: Table name
    filter_condition: Optional[str] = None,         # Optional: SQL WHERE clause to filter source data
    transformation_sql: Optional[str] = None,       # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,         # Required if transformation_sql is set: schema of the resulting DataFrame
    lateness: Optional[SourceLateness] = None,       # Optional: Expected source settling time
)
Parâmetros:
catalog_name,schema_name,table_name: Identifique a tabela Delta de origem no Unity Catalog.filter_condition: Uma cláusula SQLWHEREaplicada antes da agregação ou da seleção de colunas. Exemplo:"status = 'completed'".transformation_sql: Uma expressão SQLSELECTaplicada à tabela de origem. Use isto para renomear colunas, converter tipos ou compute colunas derivadas antes da agregação ou seleção de colunas. Se omitido, todas as colunas serão selecionadas (*). Exemplo:"user_id, CAST(amount AS DOUBLE) AS amount, event_time".dataframe_schema: o esquema do DataFrame resultante após as transformações, no formato JSON Spark StructType (dedf.schema.json()). Obrigatório setransformation_sqlfor fornecido. Isso informa ao sistema os nomes e tipos de coluna que resultam da sua transformação.lateness: um objetoSourceLatenessque descreve quanto tempo a origem normalmente leva para ficar completa no tempo do evento. Se omitida, a origem será considerada imediatamente concluída.
Quando filter_condition e transformation_sql estão definidos, a query resultante é: SELECT {transformation_sql} FROM {table} WHERE {filter_condition}.
SourceLateness.settling_delay é a maneira recomendada de simular durante o treinamento um atraso de ETL consistente que afeta a materialização online. O Databricks retrocede o tempo de avaliação de treinamento elegível por esta duração para que um exemplo de treinamento não use dados que ainda estariam em trânsito online. Durante a materialização, o Databricks aguarda pela mesma duração antes de publicar uma janela concluída e serve a última janela concluída durante o período intermediário.
For example, suppose a daily ETL job completes 8 hours after midnight in a local time zone where midnight corresponds to 07:00 UTC. Use um atraso de estabilização de 8 horas e um deslocamento de janela de 7 horas:
from datetime import timedelta
from databricks.feature_engineering.entities import (
    DeltaTableSource,
    SourceLateness,
    TumblingWindow,
)

source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    lateness=SourceLateness(settling_delay=timedelta(hours=8)),
)

window = TumblingWindow(
    window_duration=timedelta(days=1),
    offset=timedelta(hours=7),
)
O timeseries_column deve ser do tipo TimestampType ou TimestampNTZType. DateType não é compatível com séries temporais; converta a coluna para TimestampType primeiro (por exemplo, com transformation_sql).
Exemplo: Usando transformation_sql para transformações de coluna
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="raw_events",
    transformation_sql="user_id, CAST(price_cents AS DOUBLE) / 100 AS price, event_time",
    filter_condition="event_type = 'purchase'",
    dataframe_schema=spark.sql(
        "SELECT user_id, CAST(price_cents AS DOUBLE) / 100 AS price, event_time FROM main.analytics.raw_events LIMIT 0"
    ).schema.json(),
)
Exemplo: Derivando transformation_sql e dataframe_schema de um PySpark DataFrame
É possível escrever a transformação como uma query PySpark e, então, extrair o esquema do DataFrame resultante:
df = spark.sql(f"""
  SELECT user_id, CAST(amount AS DOUBLE) / 100 AS amount_dollars, event_time
  FROM main.analytics.events
  WHERE event_date >= date_sub(current_date(), 7)
  LIMIT 0
""")

# Use df.schema.json() as the dataframe_schema
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    transformation_sql="user_id, CAST(amount AS DOUBLE) / 100 AS amount_dollars, event_time",
    filter_condition="event_date >= date_sub(current_date(), 7)",
    dataframe_schema=df.schema.json(),
)
Expressões transformation_sql suportadas
As mesmas regras se aplicam a transformation_sql em DeltaTableSource e StreamSource.
transformation_sql suporta quaisquer expressões linha a linha; operações avaliadas independentemente para cada linha. Elas não alteram o número de linhas ou a correspondência um-para-um com a origem. As expressões linha a linha incluem renomeações de colunas, conversões, operações aritméticas e muito mais.
Operações que alteram a forma ou a contagem de linhas não são compatíveis, como agregações como SUM() ou COUNT(). Use AggregationFunction na definição do recurso em vez disso.
DeltaTableSource.from_sql()
Por conveniência, você pode criar um DeltaTableSource a partir de uma query SQL. O método analisa a query para extrair automaticamente o nome da tabela, transformation_sql e filter_condition.
DeltaTableSource.from_sql(
    sql: str,                           # Required: SQL SELECT query
    spark: SparkSession,                # Required: active SparkSession (for schema inference)
) -> DeltaTableSource
Apenas SELECT ... FROM ... [WHERE ...] queries simples são compatíveis. SQL complexo (JOINs, subqueries, CTEs, UNIONs) é rejeitado. Para queries complexas, construa DeltaTableSource diretamente com transformation_sql e filter_condition.
from databricks.feature_engineering.entities import (
    AggregationFunction,
    DeltaTableSource,
    Feature,
    Sum,
    TumblingWindow,
)

source = DeltaTableSource.from_sql(
    spark=spark,
    sql=f"SELECT customer_id, event_ts, amount * 2 AS doubled_amount, amount FROM {CATALOG}.{SCHEMA}.{TABLE}",
)

feature = Feature(
    source=source,
    function=AggregationFunction(Sum(input="doubled_amount"), time_window=TumblingWindow(window_duration=timedelta(days=7))),
    entity=["customer_id"], timeseries_column="event_ts",
)
Iterar com to_dataframe()
Use source.to_dataframe() para visualizar os dados que serão usados para o compute de recursos. Isso é útil para iterar em filter_condition e transformation_sql até que produzam os resultados esperados.
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    filter_condition="event_type = 'purchase'",
)

# Preview the filtered source data
source.to_dataframe().display()
Compreendendo as entidades
As colunas de entidade definem o nível de agregação para seus recursos. Elas são especificadas na definição de Feature, e não em DeltaTableSource. As entidades determinam:
- Como os dados são agrupados : Os recursos são agregados por combinação única de valores de entidade (semelhante a
GROUP BYem SQL) - A estrutura da key primária : Cada combinação de entidade exclusiva resulta em uma linha de recursos de compute
Exemplo: Recursos em nível de cliente.
O código a seguir agrega recursos no nível do cliente (uma linha por cliente):
from databricks.feature_engineering.entities import DeltaTableSource

source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="user_events",
)

Feature(
    source=source,
    entity=["user_id"],                # Features aggregated per user
    timeseries_column="event_time",    # Timestamp for time windows
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)
Exemplo: Recursos no nível do cliente-loja
Para agregar recursos em um nível mais detalhado (uma linha por combinação cliente-loja), use múltiplas colunas de entidade:
source = DeltaTableSource(
    catalog_name="main",
    schema_name="retail",
    table_name="transactions",
)

Feature(
    source=source,
    entity=["user_id", "store_id"],  # Features aggregated per user-store pair
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)
Quando precisar de recursos em diferentes níveis de agregação (por exemplo, nível de cliente e nível de cliente-loja), use valores de entity diferentes em suas definições de recursos. O mesmo DeltaTableSource pode ser compartilhado entre recursos com diferentes configurações de entidade.
StreamSource
StreamSource referencia uma Transmissão. A Transmissão contém conexão, autenticação, esquema e configuração de ingestão para a fonte de transmissão. Para Kafka, as referências de coluna nas definições de recurso devem ser prefixadas com value. ou key. para indicar qual parte da mensagem ler.
StreamSource(
    full_name: str,                       # Required: Three-part Stream name (catalog.schema.stream)
    filter_condition: Optional[str] = None,      # Optional: SQL WHERE clause applied before aggregation
    transformation_sql: Optional[str] = None,    # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,      # Required if transformation_sql is set: schema of the resulting DataFrame
    lateness: Optional[SourceLateness] = None,    # Optional: Expected source settling time
)
Parâmetros:
full_name: O nome completo de três partes de uma transmissão (por exemplo,"my_catalog.my_schema.my_stream").filter_condition(opcional): Uma cláusula SQLWHEREaplicada a dados de transmissão antes da agregação, usando referências de coluna com prefixo de ponto (por exemplo,"value.event_type = 'purchase'").transformation_sql(opcional): uma expressão SQLSELECTaplicada antes da agregação ou seleção de coluna, usando referências prefixadas por ponto para as structskeyevalue. Suporta as mesmas expressões linha a linha queDeltaTableSource. Se omitido, a origem usa todas as colunas (*).dataframe_schema: O esquema JSON SparkStructTypeda saída projetada. Obrigatório se você definirtransformation_sql.lateness: ASourceLatenessobject that describes how long the transmissão normally takes to become complete in event time. SeeSourceLateness.settling_delay.
from databricks.feature_engineering.entities import StreamSource

stream_source = StreamSource(
    full_name="my_catalog.my_schema.my_stream",
    filter_condition="value.event_type = 'purchase'",
)
Derive dataframe_schema executando a projeção na tabela de ingestão da transmissão, que expõe as estruturas key e value.
transformation_sql = (
    "value.amount * value.conversion_rate AS converted_amount, "
    "struct(value.user_id AS user_id, value.event_time AS time) AS event"
)

ingestion_table = "my_catalog.my_schema.events_ingestion"
dataframe_schema = spark.sql(
    f"SELECT {transformation_sql} FROM {ingestion_table} LIMIT 0"
).schema.json()

stream_source = StreamSource(
    full_name="my_catalog.my_schema.my_stream",
    transformation_sql=transformation_sql,
    dataframe_schema=dataframe_schema,
)
RequestSource
RequestSource define um esquema para dados que são fornecidos no momento da inferência na carga útil da solicitação, em vez de pesquisados em uma tabela pré-materializada. Durante o treinamento, estas colunas são extraídas do DataFrame rotulado passado para create_training_set. Durante o servindo modelo, o chamador deve incluí-los na carga útil da solicitação HTTP.
RequestSource pode ser usado com funções de Feature View do CustomUDF ou ColumnSelection. Ele não oferece suporte a funções de agregação ou janelas de tempo.
Definindo o esquema
Defina o esquema como uma lista de objetos FieldDefinition, cada um especificando um nome de coluna e um ScalarDataType:
from databricks.feature_engineering.entities import (
    FieldDefinition, RequestSource, ScalarDataType,
)

request_source = RequestSource(
    schema=[
        FieldDefinition(name="transaction_amount", data_type=ScalarDataType.DOUBLE),
        FieldDefinition(name="vendor_id", data_type=ScalarDataType.STRING),
        FieldDefinition(name="transaction_id", data_type=ScalarDataType.STRING),
        FieldDefinition(name="transaction_time", data_type=ScalarDataType.DATE),
    ]
)
Tipos de dados compatíveis
RequestSource suporta os tipos escalares definidos em ScalarDataType: INTEGER, FLOAT, BOOLEAN, STRING, DOUBLE, LONG, TIMESTAMP, DATE, SHORT. Tipos complexos como matrizes, mapas e structs não são compatíveis.
Como os dados da solicitação são hidratados
Contexto | Comportamento |
|---|---|
**Treinamento** | Colunas são extraídas do DataFrame rotulado. Os tipos são validados em relação ao esquema declarado. Incompatibilidades geram um erro (sem conversão implícita). |
**Serviço** (Endpoint de modelo) | As colunas são extraídas de |
Assinatura do modelo
Quando um modelo é registrado usando log_model com um conjunto de treinamento que inclui RequestSource recursos, as colunas RequestSource são adicionadas à assinatura do modelo MLflow como entradas obrigatórias. Isso significa que o esquema da API do Endpoint de serviço reflete quais campos os chamadores devem fornecer no momento da inferência.
FeatureViewSource
FeatureViewSource uses the outputs of other Feature Views as inputs to a CustomUDF. O encadeamento de recursos cria um gráfico acíclico direcionado (DAG). Por exemplo, um recurso de margem pode combinar agregados de receita e custo, e outro recurso pode transformar a margem.
Use a databricks-feature-engineering versão 0.18.0 ou posterior para FeatureViewSource.
Passe uma lista de objetos Feature para features, não strings de nome de recurso. Recupere recursos registrados com get_feature. Em input_bindings, use o full_name de cada recurso registrado. Para um recurso local não registrado, use seu name em vez disso.
O exemplo a seguir pressupõe dois recursos registrados, revenue_sum_7d e cost_sum_7d, que retornam valores DOUBLE por customer_id e usam event_time para computação pontual:
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import CustomUDF, FeatureViewSource

fe = FeatureEngineeringClient()
revenue = fe.get_feature(full_name="main.ecommerce.revenue_sum_7d")
cost = fe.get_feature(full_name="main.ecommerce.cost_sum_7d")

spark.sql("""
CREATE OR REPLACE FUNCTION main.ecommerce.margin_udf(revenue DOUBLE, cost DOUBLE)
RETURNS DOUBLE
LANGUAGE PYTHON
AS $$
import math

if revenue is None or cost is None:
    return None
if not math.isfinite(revenue) or not math.isfinite(cost) or revenue <= 0:
    return None
return (revenue - cost) / revenue
$$
""")

margin = fe.create_feature(
    source=FeatureViewSource(features=[revenue, cost]),
    function=CustomUDF(
        function_name="main.ecommerce.margin_udf",
        input_bindings={"revenue": revenue.full_name, "cost": cost.full_name},
    ),
    catalog_name="main",
    schema_name="ecommerce",
    name="margin",
)
Aplicam-se as seguintes restrições:
- Apenas
CustomUDFé suportado como a função. Os recursos upstream podem ser agregações, seleções de colunas ou outros recursosCustomUDF. - Omita
entityetimeseries_columnno recurso derivado. Cada recurso upstream retém sua própria entidade, Timestamp e definição de janela. - Um recurso tem uma fonte. Para combinar um valor de solicitação com um recurso apoiado por tabela, defina um recurso
RequestSourcee faça referência a ambos por meio deFeatureViewSource. - Todo recurso upstream declarado deve ser usado em
input_bindings. Ciclos não são permitidos. - Registre recursos upstream antes de registrar o recurso derivado. Gráficos locais e não registrados podem ser usados com
create_training_setpara experimentação. - Para treinamento ou disponibilização, você precisa do privilégio
READ FEATUREouMANAGEno recurso derivado e seus recursos upstream transitivos. Use nomes de recursos distintos em todo o gráfico para registro e disponibilização, mesmo em catálogos ou esquemas. - Um recurso pode fazer referência a até 20 recursos upstream diretos. Gráficos registrados oferecem suporte a uma profundidade máxima de cinco recursos ao longo de um caminho de dependência, incluindo o recurso base.
FeatureViewSourceos recursos não podem ser materializados ou avaliados comcompute_features. Usecreate_training_setpara avaliá-los offline. Para a disponibilização online, materialise os recursos upstream baseados em tabela suportados.
For dependency evaluation and output selection, see Ensinar com FeatureViewSource features. For deployment, see Serve derived recursos.
API de treinamento e inferência
create_training_set e score_batch compute valores de recurso corretos em determinado momento sob demanda a partir dos dados de origem. Para recursos que suportam a materialização offline, como agregações de janela deslizante em fontes de tabela delta, materializar os recursos primeiro em um armazenamento offline melhora o desempenho de ambas as operações. Quando recursos offline materializados estão disponíveis, as operações leem dados offline pré-computados em vez de recalcular os valores de recurso da fonte. Consulte Materializar Views de Recurso para materializar recursos em um armazenamento offline.
create_training_set()
Cria um dataset de treinamento com cálculo de recurso correto pontual. Para obter detalhes, consulte Ensinar modelos com Recurso Views.
FeatureEngineeringClient.create_training_set(
    df: DataFrame,                                # DataFrame with training data
    features: Optional[List[Feature]],            # List of Feature objects
    label: Union[str, List[str], None],           # Label column name(s)
    exclude_columns: Optional[List[str]] = None,  # Optional: columns to exclude
) -> TrainingSet
log_model()
Logs um modelo com metadados de recurso para acompanhamento de linhagem e consulta automática de recursos durante a inferência. Para obter detalhes, consulte Ensinar modelos com Recurso Views.
FeatureEngineeringClient.log_model(
    model,                                    # Trained model object
    artifact_path: str,                       # Path to store model artifact
    flavor: ModuleType,                       # MLflow flavor module (e.g., mlflow.sklearn)
    training_set: TrainingSet,                # TrainingSet used for training
    registered_model_name: Optional[str],     # Optional: register model in Unity Catalog
)
score_batch()
Executa inferência em lote offline com pesquisa automática de recursos. Utiliza os metadados de recursos armazenados com o modelo para calcular recursos corretos para um ponto no tempo, garantindo consistência com o treinamento.
FeatureEngineeringClient.score_batch(
    model_uri: str,                           # URI of logged model (e.g., "models:/catalog.schema.model/1")
    df: DataFrame,                            # DataFrame with entity keys and timestamps
) -> DataFrame
O DataFrame de entrada deve conter as colunas de entidade e séries temporais usadas durante o treinamento. Recursos são automaticamente computados a partir dos dados de origem.
fe = FeatureEngineeringClient()

# Batch scoring with automatic feature lookup
predictions = fe.score_batch(
    model_uri="models:/main.ecommerce.fraud_model/1",
    df=inference_df,
)
predictions.display()
Janelas de tempo
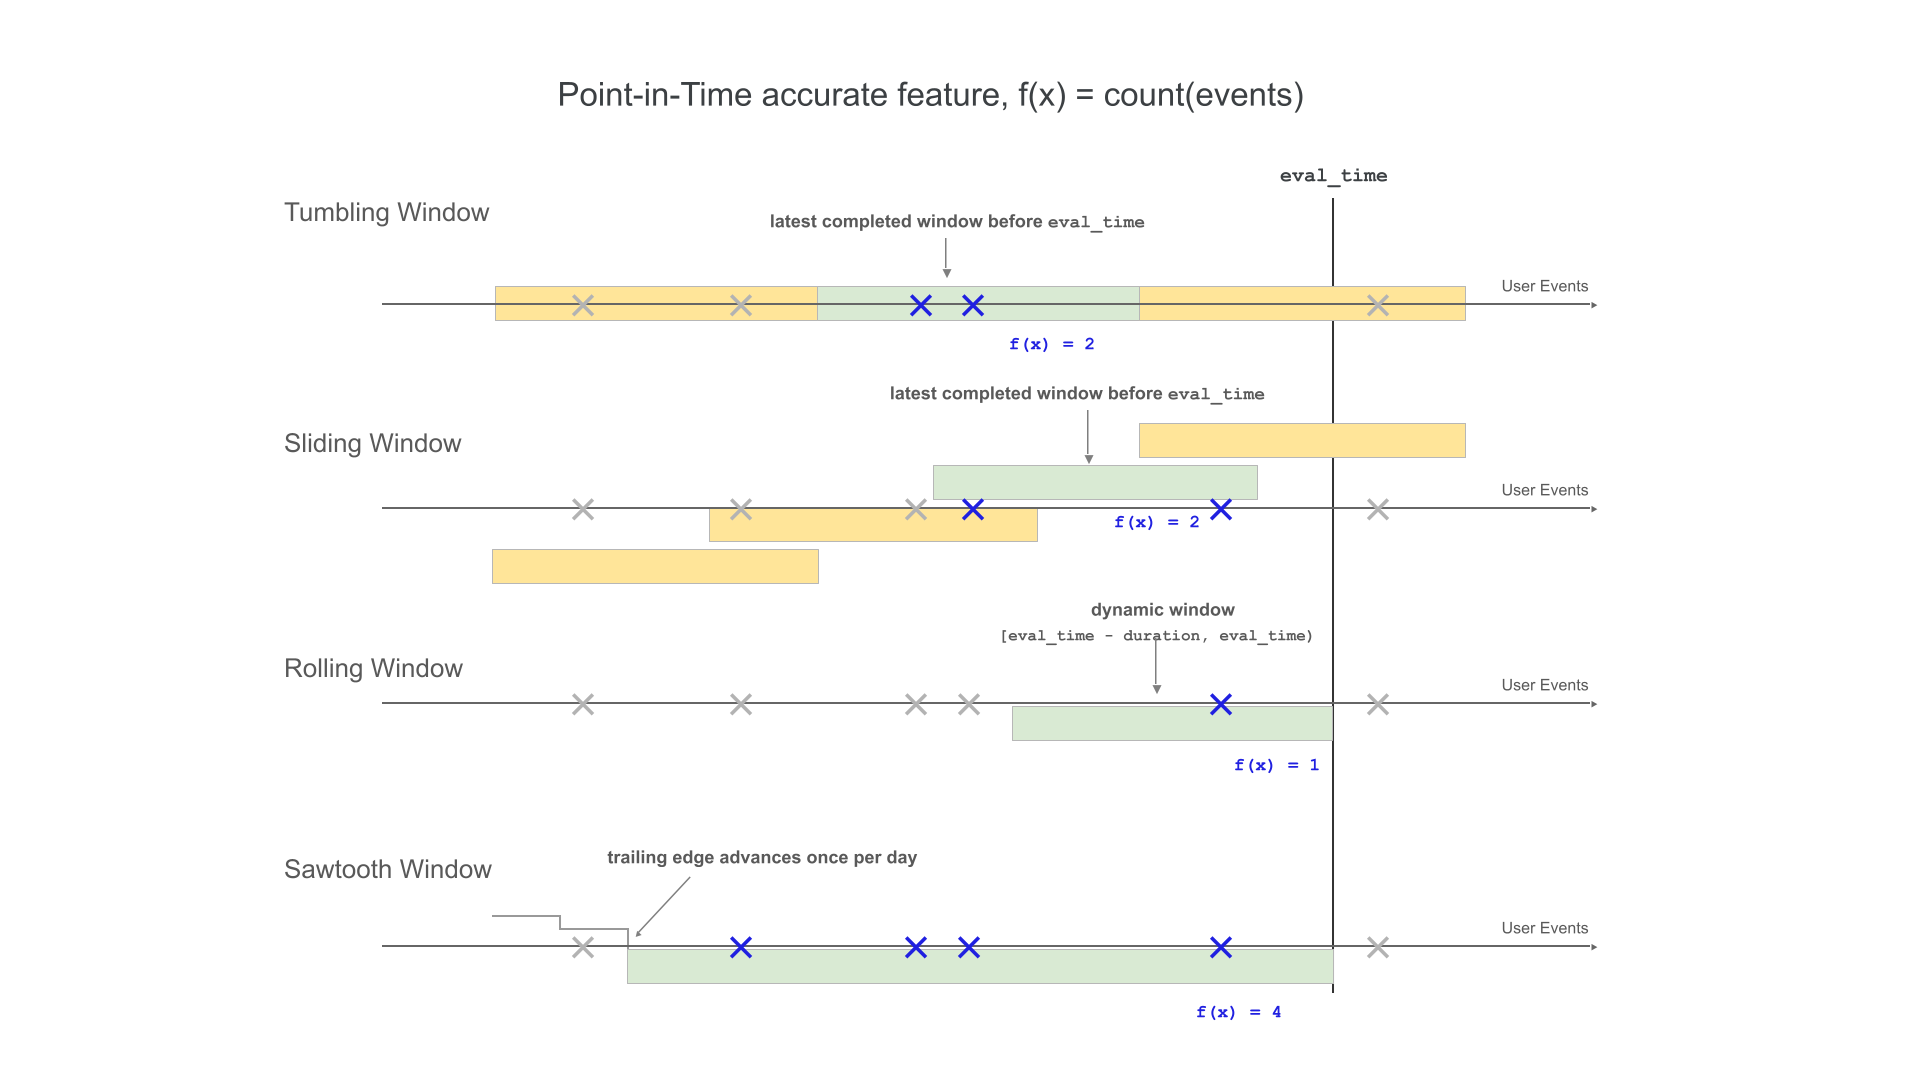
As Feature Views dão suporte a quatro tipos de janela para controlar o comportamento de retrospectiva para agregações baseadas em janela de tempo. Os tipos de janela disponíveis dependem da origem do recurso: recursos de origem de transmissão podem usar janelas móveis (rolling) e em dente de serra (sawtooth), e recursos de origem em lotes podem usar janelas móveis (rolling), em salto (tumbling) e deslizantes (sliding).
- Janelas contínuas retroagem a partir do tempo do evento. Duração e atraso são explicitamente definidos.
- Janelas em cascata são janelas de tempo fixas e não sobrepostas. Cada ponto de dados pertence a exatamente uma janela.
- As janelas deslizantes são janelas de tempo sobrepostas e contínuas com um intervalo de deslizamento configurável.
- As janelas sawtooth mantêm uma longa janela de retrospectiva atualizada sobre uma fonte de transmissão usando um caminho híbrido de lotes e transmissão. Consulte Janela sawtooth.
A ilustração a seguir mostra os tipos de janela tumbling, sliding, rolling e sawtooth.
Temporização da janela de tempo
Use delay para avaliar uma janela em um ponto analítico anterior no tempo. Por exemplo, uma janela de 30 dias com um atraso de 7 dias calcula um valor de 30 dias a partir de uma semana antes do horário de avaliação. delay é independente do horário de chegada da fonte. Para modelar o tempo que os dados de origem levam para chegar, configure SourceLateness.settling_delay em vez disso.
When both settings are present, they compose. O Databricks trata a janela como concluída após o atraso de estabilização da origem e a avalia usando o atraso analítico.
Use offset to change the alignment of fixed window boundaries. By default, tumbling windows and sliding windows are aligned to midnight UTC. For example, an offset of 22 hours aligns a daily boundary to 22:00 UTC. To approximate boundaries in a local time zone, configure a static offset relative to UTC. The offset does not adjust for daylight saving time, shift the evaluation time, or model late-arriving data.
A tabela a seguir resume o suporte a esses campos:
campo | Supported windows | Restrição |
|---|---|---|
| Rolling, tumbling, and sliding | Deve ser não negativo |
| Fixas e deslizantes | Deve ser não negativo e menor que o período* |
| Recursos (features) deslizantes, fixos e cumulativos | Deve ser não negativo |
| Rolling, tumbling, and sliding | Deve ser um |
*Período: Para uma janela fixa (tumbling window), o deslocamento deve ser menor que window_duration. Para uma janela deslizante (sliding window), ela deve ser menor que slide_duration.
Hora de início
Use start_time para definir o limite de horário do evento mais antigo em UTC no qual um recurso pode emitir uma saída. O limite é inclusivo. start_time controla as saídas. Isso não restringe as linhas de origem históricas que uma janela pode ler e não altera o alinhamento da janela. Se start_time estiver entre dois limites alinhados, a primeira saída de janela fixa elegível será o próximo limite.
Com start_time, janelas de duração fixa podem ser emitidas antes que a duração total de uma janela tenha decorrido na origem. Estes primeiros resultados usam qualquer história de origem disponível. Por exemplo, considere uma janela deslizante com um window_duration de um ano e um slide_duration de um dia, sobre uma origem cujos dados começam em 1º de janeiro de 2024:
- Sem
start_time, o recurso emite pela primeira vez em 1º de janeiro de 2025, assim que uma janela completa de um ano puder ser formada. - Com
start_timedefinido como 21 de agosto de 2024, o recurso é emitido pela primeira vez em 21 de agosto de 2024. Essa saída cobre apenas a história de origem disponível até o momento, a partir de 1º de janeiro de 2024. A janela atinge sua extensão completa de um ano em 1º de janeiro de 2025 e produz saídas completas a partir de então.
Como start_time não altera o alinhamento da janela, um valor entre dois limites alinhados não cria um novo limite. Para uma janela deslizante com limites diários à meia-noite UTC, um start_time de 06:00 UTC é emitido primeiro no próximo limite de meia-noite. Um start_time que cai exatamente em um limite é emitido nesse limite, porque o limite é inclusivo.
Se start_time não estiver definido, as janelas deslizantes (tumbling windows) e as janelas deslizantes de duração fixa emitem primeiro em um limite alinhado após a formação de uma janela completa. As janelas deslizantes de tempo de vida (lifetime sliding windows) e as janelas correntes (rolling windows) são emitidas assim que houver dados de origem elegíveis.
start_time é compatível com recursos de lote que usam DeltaTableSource com janelas rolantes, basculantes ou deslizantes. Não há compatibilidade com StreamSource ou SawtoothWindow.
Por exemplo:
from datetime import datetime, timedelta
from databricks.feature_engineering.entities import SlidingWindow

window = SlidingWindow(
    window_duration=timedelta(days=365),
    slide_duration=timedelta(days=1),
    start_time=datetime(2024, 8, 21),
)
Janela deslizante
RollingWindow era anteriormente denominado ContinuousWindow. Se estiver migrando de uma versão anterior do SDK, atualize suas importações de acordo.
Janelas deslizantes são agregados atualizados e em tempo real, tipicamente usados em dados de transmissão. Em pipelines de transmissão, a janela deslizante emite uma nova linha apenas quando o conteúdo da janela de comprimento fixo muda, como quando um evento entra ou sai. Quando um recurso de janela deslizante é usado em pipelines de treinamento, um cálculo preciso de recurso pontual é realizado nos dados de origem usando a duração de janela de comprimento fixo imediatamente anterior ao Timestamp de um evento específico. Isso ajuda a evitar distorções online-offline ou vazamento de dados. Recursos no tempo T agregam eventos de [T − duração, T).
class RollingWindow(TimeWindow):
    window_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
A tabela a seguir lista os parâmetros para uma janela contínua. Os horários de início e término da janela são baseados nestes parâmetros da seguinte forma:
- Hora de início:
evaluation_time - window_duration - delay(inclusive) - Hora de término:
evaluation_time - delay(exclusiva)
Parâmetro | Restrições |
|---|---|
| Deve ser ≥ 0. Desloca a janela analítica para trás em relação ao Timestamp de avaliação. Use |
| Deve ser > 0 |
| Limite de tempo do evento mais antigo em que o recurso pode emitir uma saída. |
from databricks.feature_engineering.entities import RollingWindow
from datetime import timedelta

# Look back 7 days from evaluation time
window = RollingWindow(window_duration=timedelta(days=7))
Defina uma janela contínua com atraso usando o código abaixo.
# Compute a 7-day value as of one day before the evaluation time
window = RollingWindow(
    window_duration=timedelta(days=7),
    delay=timedelta(days=1)
)
Exemplos de janela deslizante
-
window_duration=timedelta(days=7): Isso cria uma janela de retrospectiva de 7 dias terminando no tempo de avaliação atual. Para um evento às 14:00 no Dia 7, isto inclui todos os eventos das 14:00 do Dia 0 até (mas sem incluir) as 14:00 do Dia 7. -
window_duration=timedelta(hours=1), delay=timedelta(minutes=30): isso cria uma janela de retrospectiva de 1 hora que termina 30 minutos antes do tempo de avaliação. Para um evento às 15:00, isso inclui todos os eventos das 13:30 até (mas sem incluir) as 14:30.
Use Last para limitar a atualização de um valor mais recente
Combine Last com RollingWindow quando um valor mais recente for válido apenas por um tempo limitado. Em um momento de avaliação, o recurso retorna o valor da linha com o timestamp mais recente neste intervalo:
[evaluation_time - delay - window_duration, evaluation_time - delay)
Se a última linha no intervalo contiver um valor nulo, o recurso retornará null. Se você quiser excluir valores de entrada nulos, defina um filter_condition na origem.
Esta combinação difere de ColumnSelection. O ColumnSelection retorna o último valor observado não nulo sem expirá-lo com base na idade.
Para recursos de lote, esta combinação tem um modo especial de materialização exclusivo para online. Ele oferece suporte apenas a DeltaTableSource, Last, RollingWindow e TableTrigger. Consulte Materializar valores mais recentes delimitados por frescor.
Janela em cascata
Para recursos definidos usando janelas deslizantes, as agregações são calculadas em uma janela de comprimento fixo pré-determinada que avança por um intervalo de slide, produzindo janelas não sobrepostas que particionam totalmente o tempo. Como resultado, cada evento na origem contribui para exatamente uma janela. Recursos no tempo t agregam dados de janelas terminando em ou antes de t (exclusivo). Windows começam na época Unix.
class TumblingWindow(TimeWindow):
    window_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    offset: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
A tabela a seguir lista os parâmetros para uma janela em cascata.
Parâmetro | Restrições |
|---|---|
| Deve ser > 0 |
| Must be >= 0. Shifts the analytic window backward from the evaluation timestamp. |
| Deve ser ≥ 0 e inferior a |
| Limite de tempo do evento mais antigo em que o recurso pode emitir uma saída. |
from databricks.feature_engineering.entities import TumblingWindow
from datetime import timedelta

window = TumblingWindow(
    window_duration=timedelta(days=1),
    delay=timedelta(hours=2),
    offset=timedelta(hours=22),
)
Exemplo de janela de rolagem
window_duration=timedelta(days=5): Isso cria janelas de comprimento fixo predeterminadas de 5 dias cada. Exemplo: a Janela #1 abrange do Dia 0 ao Dia 4, a Janela #2 abrange do Dia 5 ao Dia 9, a Janela #3 abrange do Dia 10 ao Dia 14 e assim por diante. Especificamente, a Janela #1 inclui todos os eventos com timestamps que começam em00:00:00.00no Dia 0 até (mas não incluindo) quaisquer eventos com timestamp00:00:00.00no Dia 5. Cada evento pertence a exatamente uma janela.
Janela deslizante
Para recursos definidos usando janelas deslizantes, as agregações são calculadas em uma janela que avança por um intervalo de deslizamento. Uma janela deslizante pode ter uma duração fixa ou uma duração de tempo de vida. As janelas de duração fixa se sobrepõem, portanto, cada evento de origem pode contribuir para a agregação de recursos para várias janelas. Uma janela de tempo de vida inclui todos os eventos de origem antes do final da janela. Os recursos no momento t agregam dados de janelas que terminam em ou antes de t (exclusivo). Windows são alinhadas à era Unix.
class SlidingWindow(TimeWindow):
    window_duration: Optional[datetime.timedelta]
    slide_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    offset: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
A tabela a seguir lista os parâmetros para uma janela deslizante.
Parâmetro | Restrições |
|---|---|
| Deve ser positivo para uma janela de duração fixa. Defina como |
| Deve ser positivo. Para uma janela de duração fixa, ela também deve ser inferior a |
| Must be >= 0. Shifts the analytic window backward from the evaluation timestamp. |
| Deve ser ≥ 0 e inferior a |
| Limite de tempo do evento mais antigo em que o recurso pode emitir uma saída. |
from databricks.feature_engineering.entities import SlidingWindow
from datetime import timedelta

window = SlidingWindow(
    window_duration=timedelta(days=7),
    slide_duration=timedelta(days=1),
    delay=timedelta(hours=2),
    offset=timedelta(hours=22),
)
Exemplo de janela deslizante
window_duration=timedelta(days=5), slide_duration=timedelta(days=1): Isso cria janelas sobrepostas de 5 dias que avançam em 1 dia a cada vez. Exemplo: A janela nº 1 abrange do Dia 0 ao Dia 4, a janela nº 2 abrange do Dia 1 ao Dia 5, a janela nº 3 abrange do Dia 2 ao Dia 6, e assim por diante. Cada janela inclui eventos de00:00:00.00no dia de início até (mas sem incluir)00:00:00.00no dia de término. Como as janelas se sobrepõem, um único evento pode pertencer a várias janelas (neste exemplo, cada evento pertence a até 5 janelas diferentes).
Janela de tempo de vida
Defina window_duration=None para criar uma janela de tempo de vida. Em cada limite de deslizamento, o recurso agrega todos os eventos de origem para a entidade com Timestamp anteriores a esse limite. Por exemplo, um deslizamento de um dia produz um valor cumulativo uma vez por dia.
Janelas de tempo de vida são suportadas apenas por SlidingWindow. RollingWindow e TumblingWindow requerem um window_duration finito.
As janelas de tempo de vida exigem uma versão do cliente databricks-feature-engineering que seja compatível com window_duration=None e com a ativação do workspace. Versões anteriores do cliente não são compatíveis com esta sintaxe.
from datetime import timedelta
from databricks.feature_engineering.entities import (
    AggregationFunction,
    DeltaTableSource,
    Feature,
    SlidingWindow,
    Sum,
)

lifetime_spend = Feature(
    source=DeltaTableSource(
        catalog_name="main",
        schema_name="store",
        table_name="transactions",
    ),
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(
        Sum(input="amount"),
        SlidingWindow(
            window_duration=None,
            slide_duration=timedelta(days=1),
        ),
    ),
    name="lifetime_spend",
)
Janela em dente de serra
Beta
SawtoothWindow está em Beta.
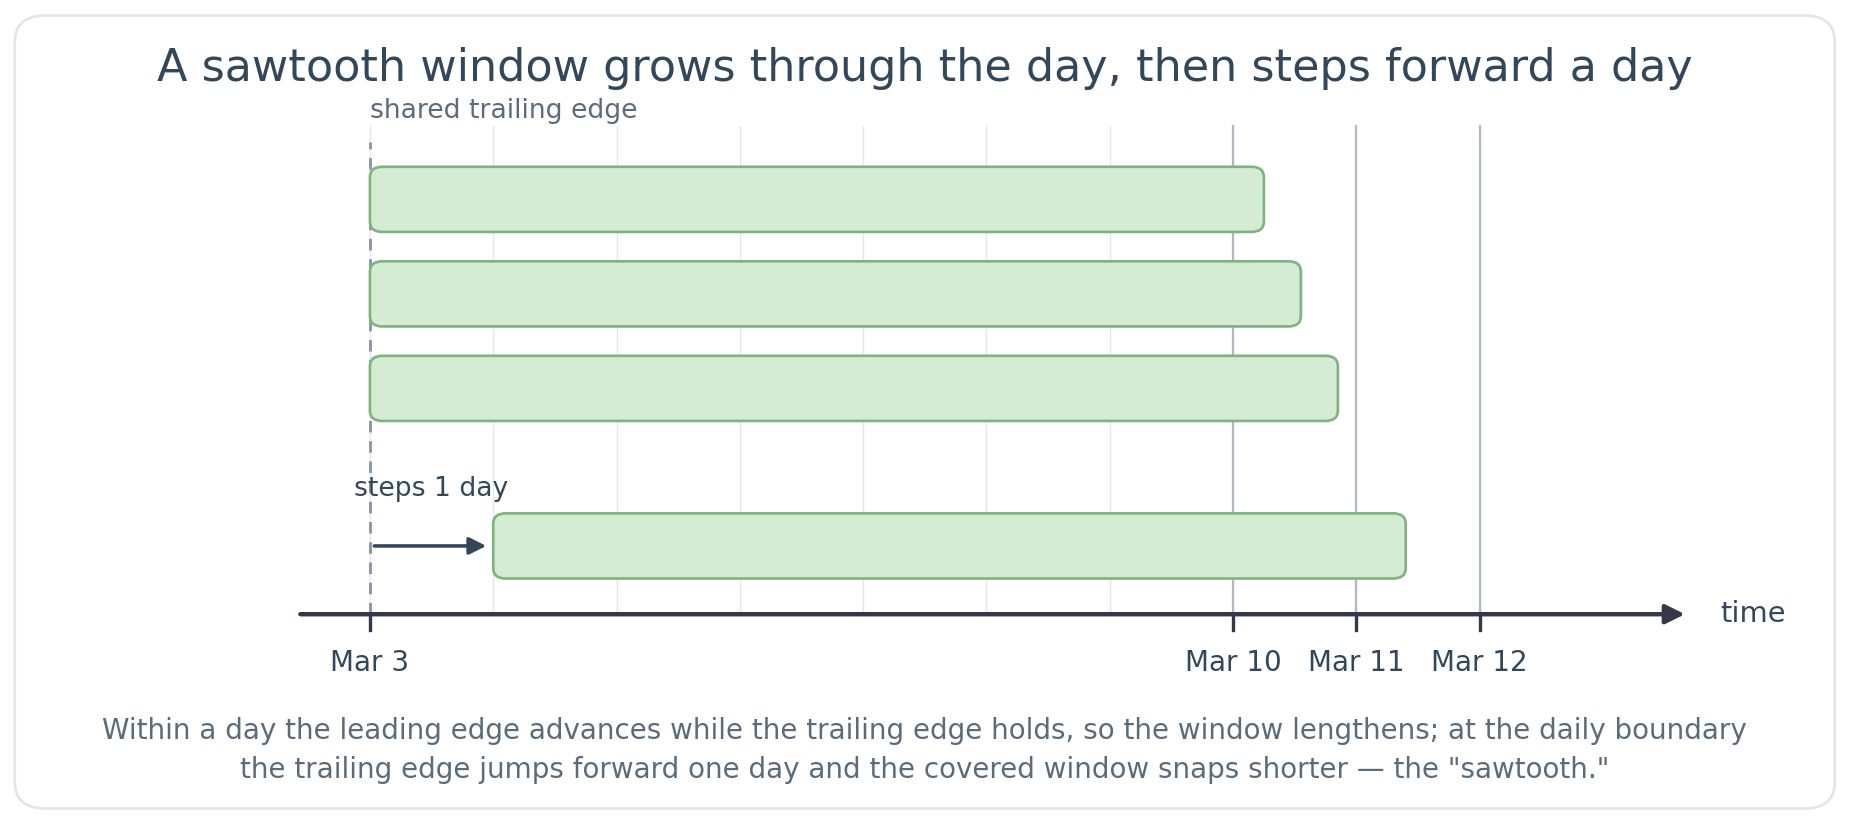
Uma janela sawtooth é uma agregação que oferece suporte a atualizações altamente recentes para eventos recentes, juntamente com a compactação diária de dados históricos. Sua borda final (mais antiga) avança em etapas diárias fixas, enquanto a borda inicial (recente) permanece atualizada com os eventos mais recentes, de modo que o comprimento efetivo da janela "serra" ao longo de cada dia. A maior parte da janela é atendida a partir de dados na tabela de ingestão da transmissão, e apenas os dois dias mais recentes vêm da transmissão ao vivo. Este é um compromisso que realiza o compute de forma eficiente de janelas de longa duração (escalando para anos) enquanto permanece responsivo a atualizações recentes.
As janelas sawtooth são materializadas em um caminho híbrido de lotes e transmissão. Um pipeline de lotes mantém a maior parte da janela, enquanto um pipeline de transmissão mantém os dados mais recentes atualizados em tempo real. Os dois são mesclados (merge) na leitura, portanto, para o modelo ou consumidor de serviço, trata-se de um único recurso.
Como a porção histórica da janela é computada pelo pipeline de lotes, um recurso em dente de serra está pronto para servir pouco depois que a materialização começa, mesmo quando a janela abrange meses ou anos. Uma janela deslizante só é concluída após o decurso de sua duração total de janela. O window_duration mínimo deve ser superior a dois dias (o limite inferior aplicado). A Databricks recomenda uma janela em dente de serra para durações superiores a 7 dias. Para janelas superiores a dois dias e de até sete dias, escolha entre a precisão de comprimento fixo de uma janela deslizante e a prontidão de produção mais rápida de uma janela em dente de serra.
Um recurso de dente de serra depende do histórico já presente. A tabela de ingestão da transmissão deve conter dados que cubram pelo menos a duração total da janela, ou a janela calculada estará incompleta. Antes de se passarem 2 dias completos, o recurso reflete apenas os dados materializados até o momento. Não é recomendado disponibilizar o recurso em produção até que se passem 2 dias completos. Uma agregação em uma janela vazia retorna 0 para Sum e Count, e nulo para Avg, Min, Max, First, Last, VarPop, VarSamp, StddevPop e StddevSamp.
Para saber se um recurso dente de serra está pronto, abra a recurso view no Explorador de Catálogos. Na seção de recursos materializados, o preenchimento retroativo em lote é concluído assim que o tempo da última materialização do recurso avança e seu status indica sucesso. A parte de transmissão é materializada por um pipeline declarativo do Lakeflow. Após a Feature View passar pela validação, o recurso materializado é vinculado a esse pipeline, onde você pode monitorar o status da sua execução.
As janelas sawtooth exigem um(a) StreamSource e são materializadas com StreamingMode.
class SawtoothWindow(TimeWindow):
    window_duration: datetime.timedelta
As bordas de uma janela sawtooth movem-se de forma diferente das de uma janela deslizante: a borda inicial rastreia o evento mais recente, enquanto a borda final avança uma vez por dia, em vez de continuamente. Todos os dias, em um corte fixo às 18:00 UTC, a borda final avança para o limite da meia-noite UTC daquele dia. Como resultado, a janela efetiva é ligeiramente maior que window_duration e cresce ao longo do dia antes de retornar um dia no próximo corte. O treinamento e a disponibilização usam o mesmo corte de 18:00 UTC, portanto, o treinamento offline e a disponibilização online permanecem consistentes.
Parâmetro | Restrições |
|---|---|
| Deve ser maior que dois dias. Uma duração que não seja um número inteiro de dias (por exemplo, |
As janelas em dente de serra oferecem suporte às funções de agregação Sum, Avg, Count, Min, Max, First, Last, VarPop, VarSamp, StddevPop e StddevSamp.
Exemplo de janela dente de serra
O exemplo a seguir mostra uma contagem de 7 dias das transações de um usuário. A borda inicial rastreia o evento atual, enquanto a borda final avança um dia de cada vez. Para eventos em 10 de março, a janela retrocede até cerca de 3 de março. À medida que 10 de março avança, a borda inicial continua avançando enquanto a borda final permanece, de modo que o intervalo coberto aumenta. Então, no início de 11 de março, a borda final avança para cerca de 4 de março. A janela efetiva é sempre um pouco maior do que sete dias. Os dois dias mais recentes são servidos a partir da transmissão ao vivo, e os dias anteriores são servidos a partir da tabela de ingestão da transmissão.
from databricks.feature_engineering.entities import SawtoothWindow
from datetime import timedelta

# 7-day window kept continuously fresh with streaming data
window = SawtoothWindow(window_duration=timedelta(days=7))
Limitações da janela dente de serra
- O parâmetro
delaynão é compatível. SourceLateness.settling_delaynão é suportado.- Funções de agregação diferentes de
Sum,Avg,Count,Min,Max,First,Last,VarPop,VarSamp,StddevPopeStddevSampnão são suportadas (por exemplo,ApproxCountDistinct,ApproxPercentile,FirstN,LastN,FirstDistincteLastDistinct). - Janelas dente de serra requerem um
StreamSource. UmDeltaTableSourcenão é compatível.
Trigger de materialização
Triggers controlam quando um pipeline de materialização é executado. O tipo de trigger depende do tipo de recurso.
CronSchedule
Use CronSchedule para recursos de agregação em lotes. By default, Databricks derives a schedule from the aggregation window. Um programar derivado contabiliza o período da janela, a janela delay e offset, e a origem settling_delay para que uma execução não publique uma janela antes de se esperar que seus dados de origem estejam completos. Programações derivadas dão suporte a janelas fixas e deslizantes.
To request a derived schedule, omit the cron expression. CronSchedule() and the explicit CronSchedule(mode=CronScheduleMode.DERIVED) form are equivalent:
from databricks.feature_engineering.entities import (
    CronSchedule,
    CronScheduleMode,
)

trigger = CronSchedule(mode=CronScheduleMode.DERIVED)
Do not set quartz_cron_expression with CronScheduleMode.DERIVED. When you retrieve the materialized recurso, the returned schedule can contain the cron expression that Databricks computed.
Para controlar o programar diretamente, forneça uma expressão cron do Quartz. CronScheduleMode.MANUAL é inferido quando você fornece uma expressão:
from databricks.feature_engineering.entities import CronSchedule

trigger = CronSchedule(
    quartz_cron_expression="0 0 * * * ?",  # Hourly
    timezone_id="UTC",
)
TableTrigger
Use TableTrigger para recursos ColumnSelection ou recursos de agregação (AggregationFunction) suportados por um DeltaTableSource. O pipeline é executado sempre que a tabela Delta upstream recebe um novo commit.
Para recursos de agregação, o pipeline é limitado para que não seja executado a cada commit. O pipeline é executado no máximo uma vez por metade do comprimento da janela do recurso, mas nunca com frequência superior a cada 5 minutos. Por exemplo, um recurso com uma janela de tombamento de 1 hora é executado no máximo uma vez a cada 30 minutos, ou um recurso com uma janela de 8 horas é executado no máximo uma vez a cada 4 horas. O limite mínimo de 5 minutos se aplica quando metade da janela é menor que isso, portanto, janelas de 10 minutos ou menos são executadas no máximo uma vez a cada 5 minutos. Recursos de agregação cuja janela é inferior a 5 minutos não podem usar TableTrigger; use um trigger de transmissão em vez disso.
from databricks.feature_engineering.entities import TableTrigger

trigger = TableTrigger()
StreamingMode
Use StreamingMode para recursos apoiados por um StreamSource. O pipeline é executado como um pipeline de transmissão contínua.
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    StreamSource, Feature, AggregationFunction, Sum,
    RollingWindow, OnlineStoreConfig, StreamingMode,
)
from datetime import timedelta

fe = FeatureEngineeringClient()

stream_source = StreamSource(full_name="my_catalog.my_schema.my_stream")

streaming_feature = fe.create_feature(
    source=stream_source,
    entity=["value.user_id"],
    timeseries_column="value.event_time",
    function=AggregationFunction(
        operator=Sum(input="value.amount"),
        time_window=RollingWindow(window_duration=timedelta(hours=1)),
    ),
    catalog_name="my_catalog",
    schema_name="my_schema",
    name="user_purchase_sum",
)

fe.materialize_features(
    features=[streaming_feature],
    online_config=OnlineStoreConfig(
        catalog_name="my_catalog",
        schema_name="my_schema",
        table_name_prefix="streaming_features_serving",
        online_store_name="feature_store_online",
    ),
    trigger=StreamingMode(),
)
Escolhendo um Trigger
Cada recurso usa um trigger; as opções por tipo de recurso são:
Tipo de recurso | Trigger | Quando é executado |
|---|---|---|
Agregação ( |
| Em um programar derivado ou manual |
Agregação ( |
| Em cada commit da tabela de origem |
|
| Em cada commit da tabela de origem |
Recursos de |
| Transmissão contínua |
Não é possível materializar recursos que exigem tipos de trigger diferentes em uma única chamada materialize_features. Faça chamadas separadas em vez disso.