Implantar um endpoint de servindo modelo otimizado para throughput (Triton)
Beta
Esse recurso está em Beta. Os administradores do workspace podem controlar o acesso a esse recurso na página Previews . Consulte Gerenciar prévias do Databricks.
Model Serving personalizado pode fazer a execução do seu Endpoint de GPU por trás do back-end do NVIDIA Triton Inference Server. O Triton agrupa as solicitações recebidas em lotes antes que elas cheguem ao seu modelo, o que aumenta o throughput em modelos vinculados a GPU sob concorrência. Esta página mostra quando o Triton ajuda, como ativá-lo em um endpoint de disponibilização de GPU e como confirmar que ele está ativo.
Quando usar o Triton
O Triton consolida solicitações concorrentes em lotes na GPU, portanto, ele ajuda mais quando a GPU é o seu gargalo. Bons candidatos são cargas de trabalho de GPU pesadas e em lotes sob tráfego em tempo real e de alta simultaneidade, onde os ganhos de throughput podem ser substanciais:
- BERT and other transformer inference
- Modelos de incorporação
- Classificação de imagens
- Detecção de objetos
O Triton ajuda menos quando a GPU não é o gargalo, como no caso de modelos pequenos ou de um modelo de visão que decodifica e redimensiona imagens na CPU. Nesse caso, a GPU fica parado aguardando o pré-processamento da CPU, portanto, agrupar em lotes (batching) antes dela apenas adiciona um salto. Mover o pré-processamento para a GPU é o que faz esse tipo de modelo se beneficiar.
O processamento em lotes troca uma pequena quantidade de latência por solicitação por um throughput maior, e o ganho depende da concorrência. Se o tráfego for baixo, os lotes permanecerão pequenos e o benefício será limitado. Antes de lançar amplamente, comece com um endpoint e meça o throughput e a latência sob concorrência realista.
Requisitos
Esse recurso requer que:
- A pré-visualização está ativada no seu workspace. Um administrador do workspace ativa a pré-visualização na página Pré-visualizações . Consulte Gerenciar prévias do Databricks. Nada abaixo funciona até que isso seja feito.
- Disponibilização de GPU. A entidade atendida deve usar um tipo de carga de trabalho de GPU (
GPU_SMALL,GPU_MEDIUM,GPU_LARGEe assim por diante). O Triton é uma operação nula (no-op) para Endpoint de CPU. - Um modelo elegível para lotes. O modelo deve ser compatível com lotes: a contagem de entradas corresponde à contagem de saídas (N entradas produzem N saídas) e as solicitações não têm dependências entre solicitações. O modelo também deve processar um lote inteiro em uma única chamada. Em um
pyfunc, passe o lote de uma só vez (por exemplo,model(**batched_inputs)) em vez de fazer um loop pelas entradas, uma de cada vez — um loop por item não obtém nenhum benefício de processamento em lote. - Um modelo sobre o caminho de implantação expressa. Registro o modelo com
env_pack="databricks_model_serving"para que seus pesos e ambiente sejam preparados como artefatos implantáveis. Um modelo que recorre ao caminho de construção de contêiner não consegue obter o backend Triton. Faça o registro no Serverless GPU Compute v4, v5 ou v6, tanto na versão Standard quanto na AI. Consulte Implantações do Express para obter endpoints servindo modelo.
O passo 1: faça o registro do seu modelo para implantação expressa
Faça Logs e registro o modelo com env_pack="databricks_model_serving". Execute isso a partir de um runtime de Serverless GPU. O registro em logs a partir de um runtime sem GPU inclui o pacote de dependências de CPU, e o endpoint de GPU falha ao começar.
import mlflow

mlflow.set_registry_uri("databricks-uc")

with mlflow.start_run():
    model_info = mlflow.pyfunc.log_model(
        artifact_path="model",
        python_model=MyModel(),
        # An input example enables automatic tuning of batching parameters in PuPr.
        input_example=example,
    )

# env_pack puts the model on the express deployment path (required for Triton).
mlflow.register_model(
    model_info.model_uri,
    "<catalog>.<schema>.<model>",
    env_pack="databricks_model_serving",
)
O passo 2: Ativar a otimização de throughput e criar o endpoint
Ative o processamento em lotes de solicitações ao criar o endpoint. Isso serve para o modelo no Triton, e o Databricks cria um perfil do modelo e aplica configurações de lotes otimizadas.
O processamento em lote está disponível somente quando todas as seguintes condições forem verdadeiras:
- A entidade atendida usa um tipo de carga de trabalho de GPU, não de CPU.
- O modelo servido não tem um ponto de entrada personalizado.
- A versão do modelo é elegível para implantação expressa (SOD). Consulte o passo 1.
- A pré-visualização está ativada para o seu workspace. Consulte Requisitos.
Crie o endpoint como um endpoint de GPU normal a partir da interface de usuário do Serving:
- No formulário Create serving endpoint , selecione uma versão de modelo elegível para implantação expressa e um tipo de carga de trabalho de GPU.
- Selecione Otimizado para throughput . Esta caixa de seleção aparece somente quando as condições anteriores são atendidas.
- Conclua a configuração do endpoint e selecione Criar .
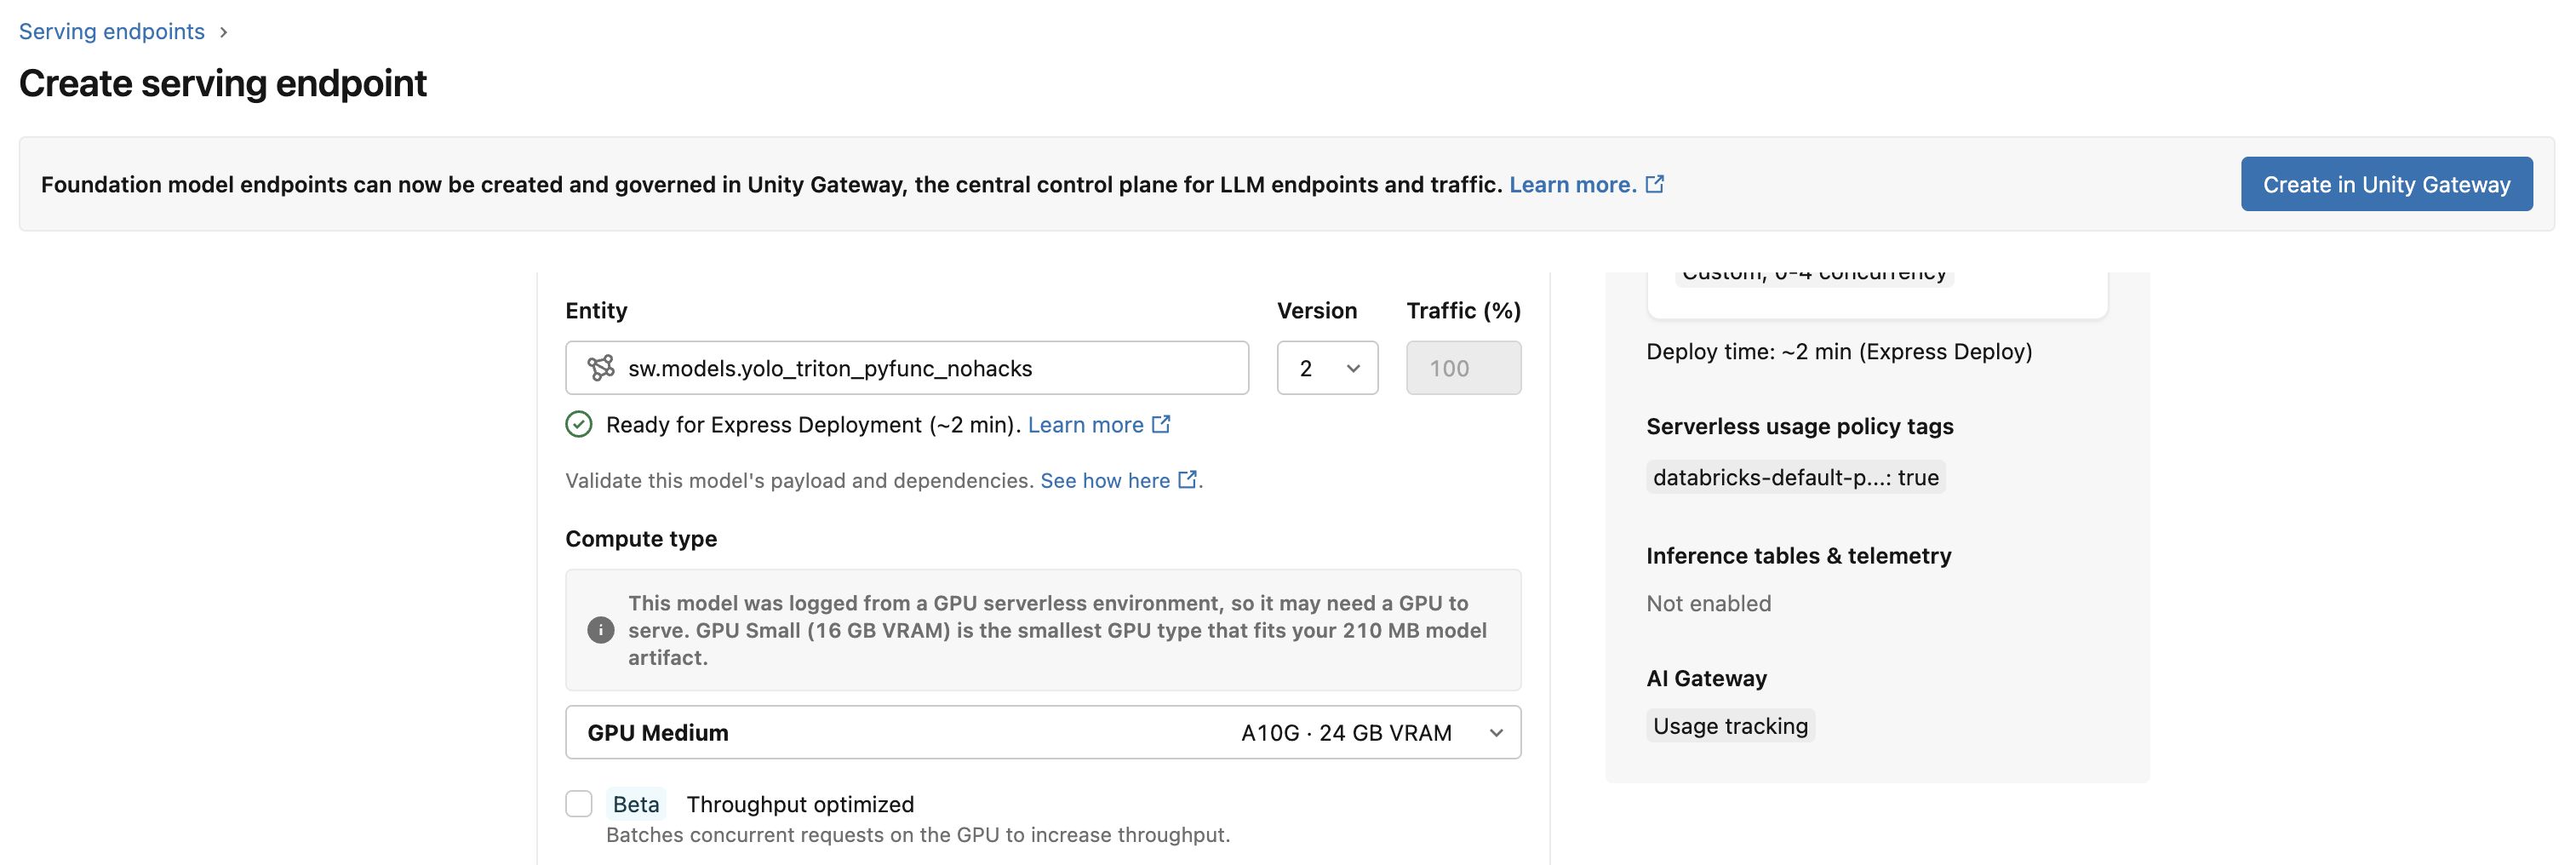
Para alterar a configuração posteriormente, edite o endpoint e selecione ou desmarque a opção "Otimizado para throughput" . A decisão de agrupamento é reavaliada a cada implantação: o Triton é incluído ou removido na próxima implantação e não é aplicado retroativamente a uma implantação já em execução.
O passo 3: query o endpoint
Envie um pequeno lote para confirmar se o endpoint está funcionando. A forma de entrada deve corresponder à que o seu modelo espera.
import numpy as np
import requests

host = "https://<workspace-host>"
endpoint = "my-detector"

batch = np.zeros((2, 3, 224, 224), dtype=np.float32)  # example input shape

resp = requests.post(
    f"{host}/serving-endpoints/{endpoint}/invocations",
    headers={
        "Authorization": f"Bearer {DATABRICKS_TOKEN}",
        "Content-Type": "application/json",
    },
    json={"inputs": batch.tolist()},
)
resp.raise_for_status()
predictions = np.array(resp.json()["predictions"])
O passo 4: confirmar que o Triton está ativo
Apenas um status READY não prova que o back-end do Triton está conectado. No momento, não há nenhum campo de API ou selo de IU dedicado para isso, e um endpoint READY parece idêntico em ambos os casos. Confirme com um dos seguintes:
- Logs do serviço. Verifique os logs do serviço do endpoint para encontrar as linhas de Startup do Triton (o banner do Triton Inference Server e as mensagens de carregamento do modelo). A presença deles significa que o backend está anexado. A seguir, um exemplo de log:
[ts/g7zw9] I0911 22:42:18.894428 1 cuda_memory_manager.cc:107] "CUDA memory pool is created on device 0 with size 67108864"
[ts/g7zw9] I0911 22:42:18.916439 1 model_lifecycle.cc:473] "loading: model:1"
[ts/g7zw9] I0911 22:42:23.775240 1 python_be.cc:2289] "TRITONBACKEND_ModelInstanceInitialize: model_0_0 (GPU device 0)"
[ts/g7zw9] I0911 22:43:22.356197 1 model_lifecycle.cc:849] "successfully loaded 'model'"
[ts/g7zw9] I0911 22:43:22.357208 1 server.cc:681]
[ts/g7zw9] +-------+---------+--------+
[ts/g7zw9] | Model | Version | Status |
[ts/g7zw9] +-------+---------+--------+
[ts/g7zw9] | model | 1       | READY  |
[ts/g7zw9] +-------+---------+--------+
[ts/g7zw9] I0911 22:43:22.387088 1 grpc_server.cc:2562] "Started GRPCInferenceService at 127.0.0.1:8001"
[ts/g7zw9] I0911 22:43:22.387651 1 http_server.cc:4809] "Started HTTPService at 127.0.0.1:8002"
[ts/g7zw9] I0911 22:43:22.430569 1 http_server.cc:358] "Started Metrics Service at 0.0.0.0:8003"
- Entre em contato com sua equipe de account do Databricks para confirmar o back-end anexado ao seu endpoint. Se não tiverem feito isso, eles poderão informar o motivo. As causas comuns são abordadas em Solução de problemas.
Em seguida, faça o benchmark sob concorrência realista. O ganho de throughput do Triton aparece sob carga, e o envio em lotes adiciona alguma latência por solicitação, portanto, meça ambos antes de implementar.
(Opcional) Ajustar o processamento em lotes
Os defaults de lotes são ajustáveis por deployment. Para ajustá-los para seu endpoint, entre em contato com sua equipe de account do Databricks.
Solução de problemas
Problema | Causa e correção |
|---|---|
| A otimização de throughput não está ativada ou a visualização está desativada. Confirme se a pré-visualização está ativada e se Throughput está habilitado (o passo 2), então reimplemente. |
O deploy retornou sem um back-end Triton | O modelo não está no caminho de implantação expressa. Faça o registro novamente com |
Nenhum ganho de throughput em comparação com um endpoint que não seja Triton | O modelo não está limitado pela GPU (GPU parado ou pré-processamento limitado pela CPU). Isso é esperado; para modelos de visão, a decodificação e o redimensionamento da imagem são movidos para a GPU. |
Triton trava com entradas grandes. |
|
O endpoint provisiona capacidade excedente até a concorrência máxima durante o tráfego em estado estável | O autoscale é atualmente agressivo e pode realizar o provisionamento para a concorrência máxima antecipadamente. Entre em contato com sua equipe de account da Databricks para ajustar o autoscaling de forma mais conservadora. |
Entre em contato com a equipe da sua account da Databricks para enviar comentários ou dúvidas.