Avalie e melhore
Início rápido do agente de código
Usando um agente de programação? Cole este prompt:
Read the documentation at https://docs.databricks.com/aws/en/mlflow3/genai/eval-monitor and set up evaluation for my agent using scorers and an evaluation dataset.
Opcionalmente, instale mlflow/skills para uma integração mais profunda com o MLflow.
A avaliação mede se o seu agente é realmente bom — a resposta está correta, fundamentada, segura e completa? O MLflow pontua seus rastreios com pontuadores : juízes de LLM e verificações baseadas em código que anexam uma avaliação de qualidade a cada rastreio. Comece pontuando alguns rastreios na interface do usuário e, em seguida, mova os mesmos pontuadores para um loop mlflow.genai.evaluate() repetível à medida que seu aplicativo amadurece.
Visão geral rápida: pontuar rastreamentos na interface do usuário
Avalie os rastreamentos que você já tem, sem código:
-
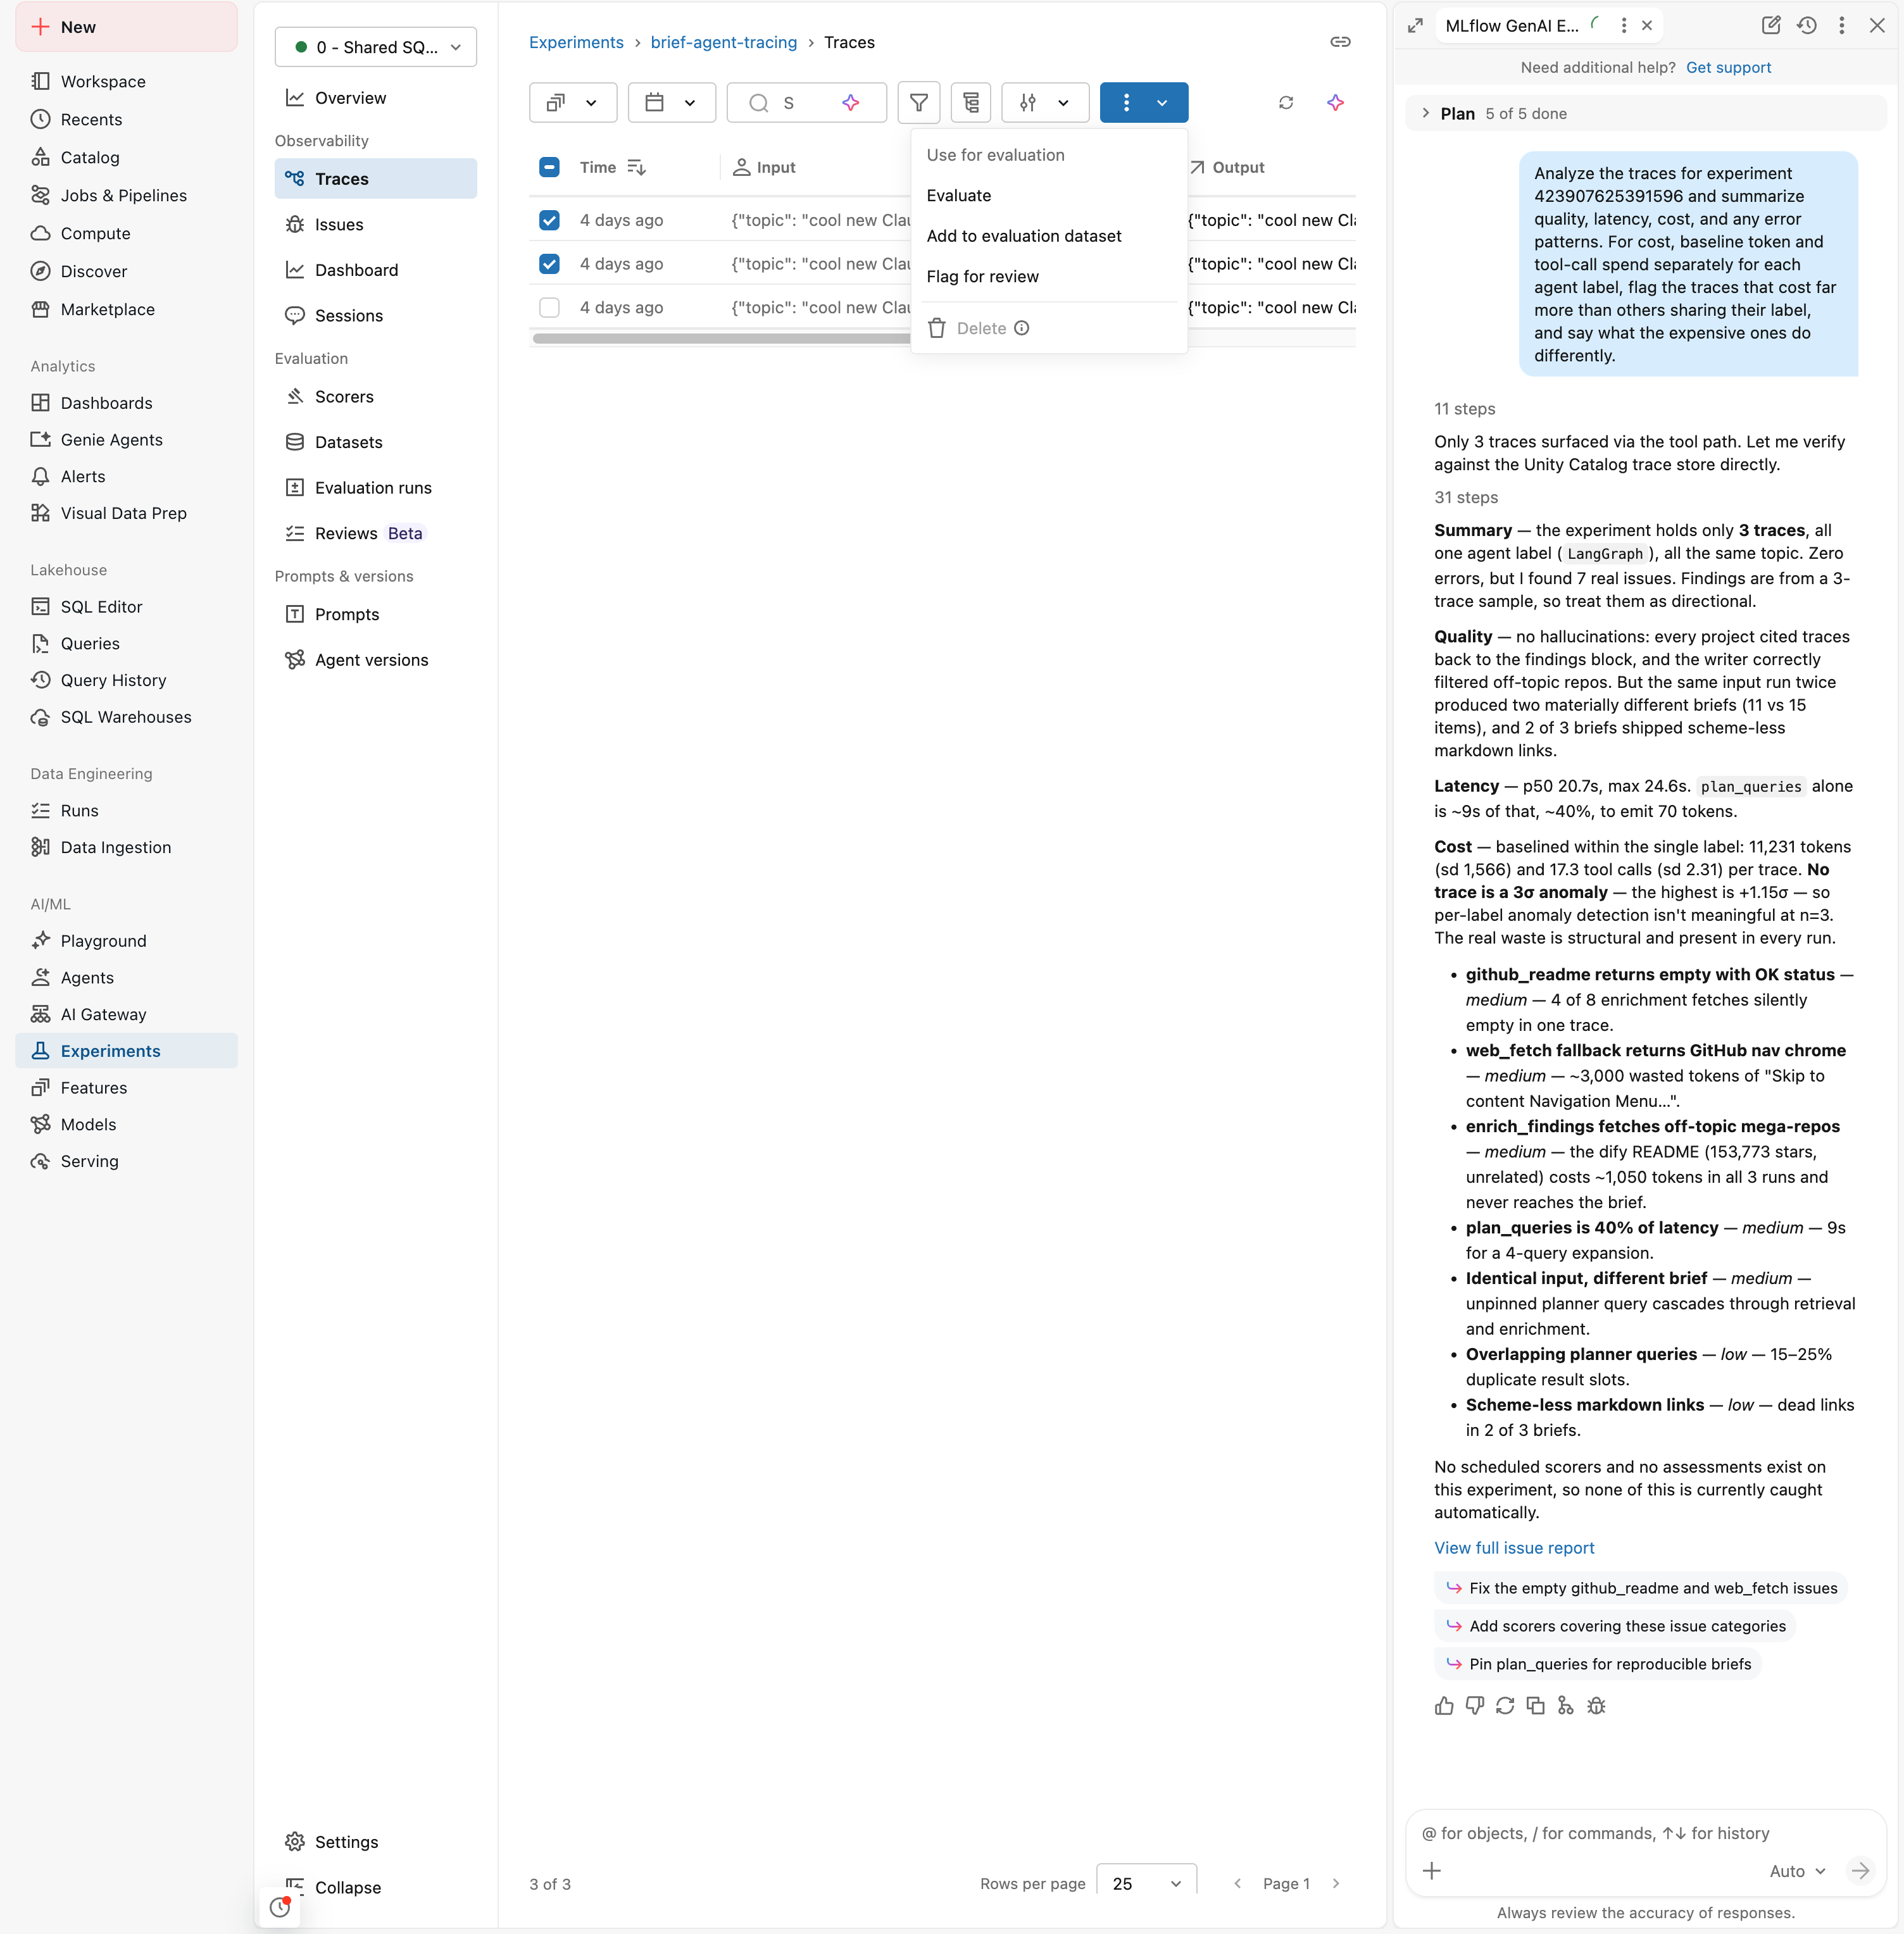
Na Traces tab, selecione alguns rastreamentos usando as caixas de seleção de linha.
-
Clique em Actions e escolha Evaluate .
-
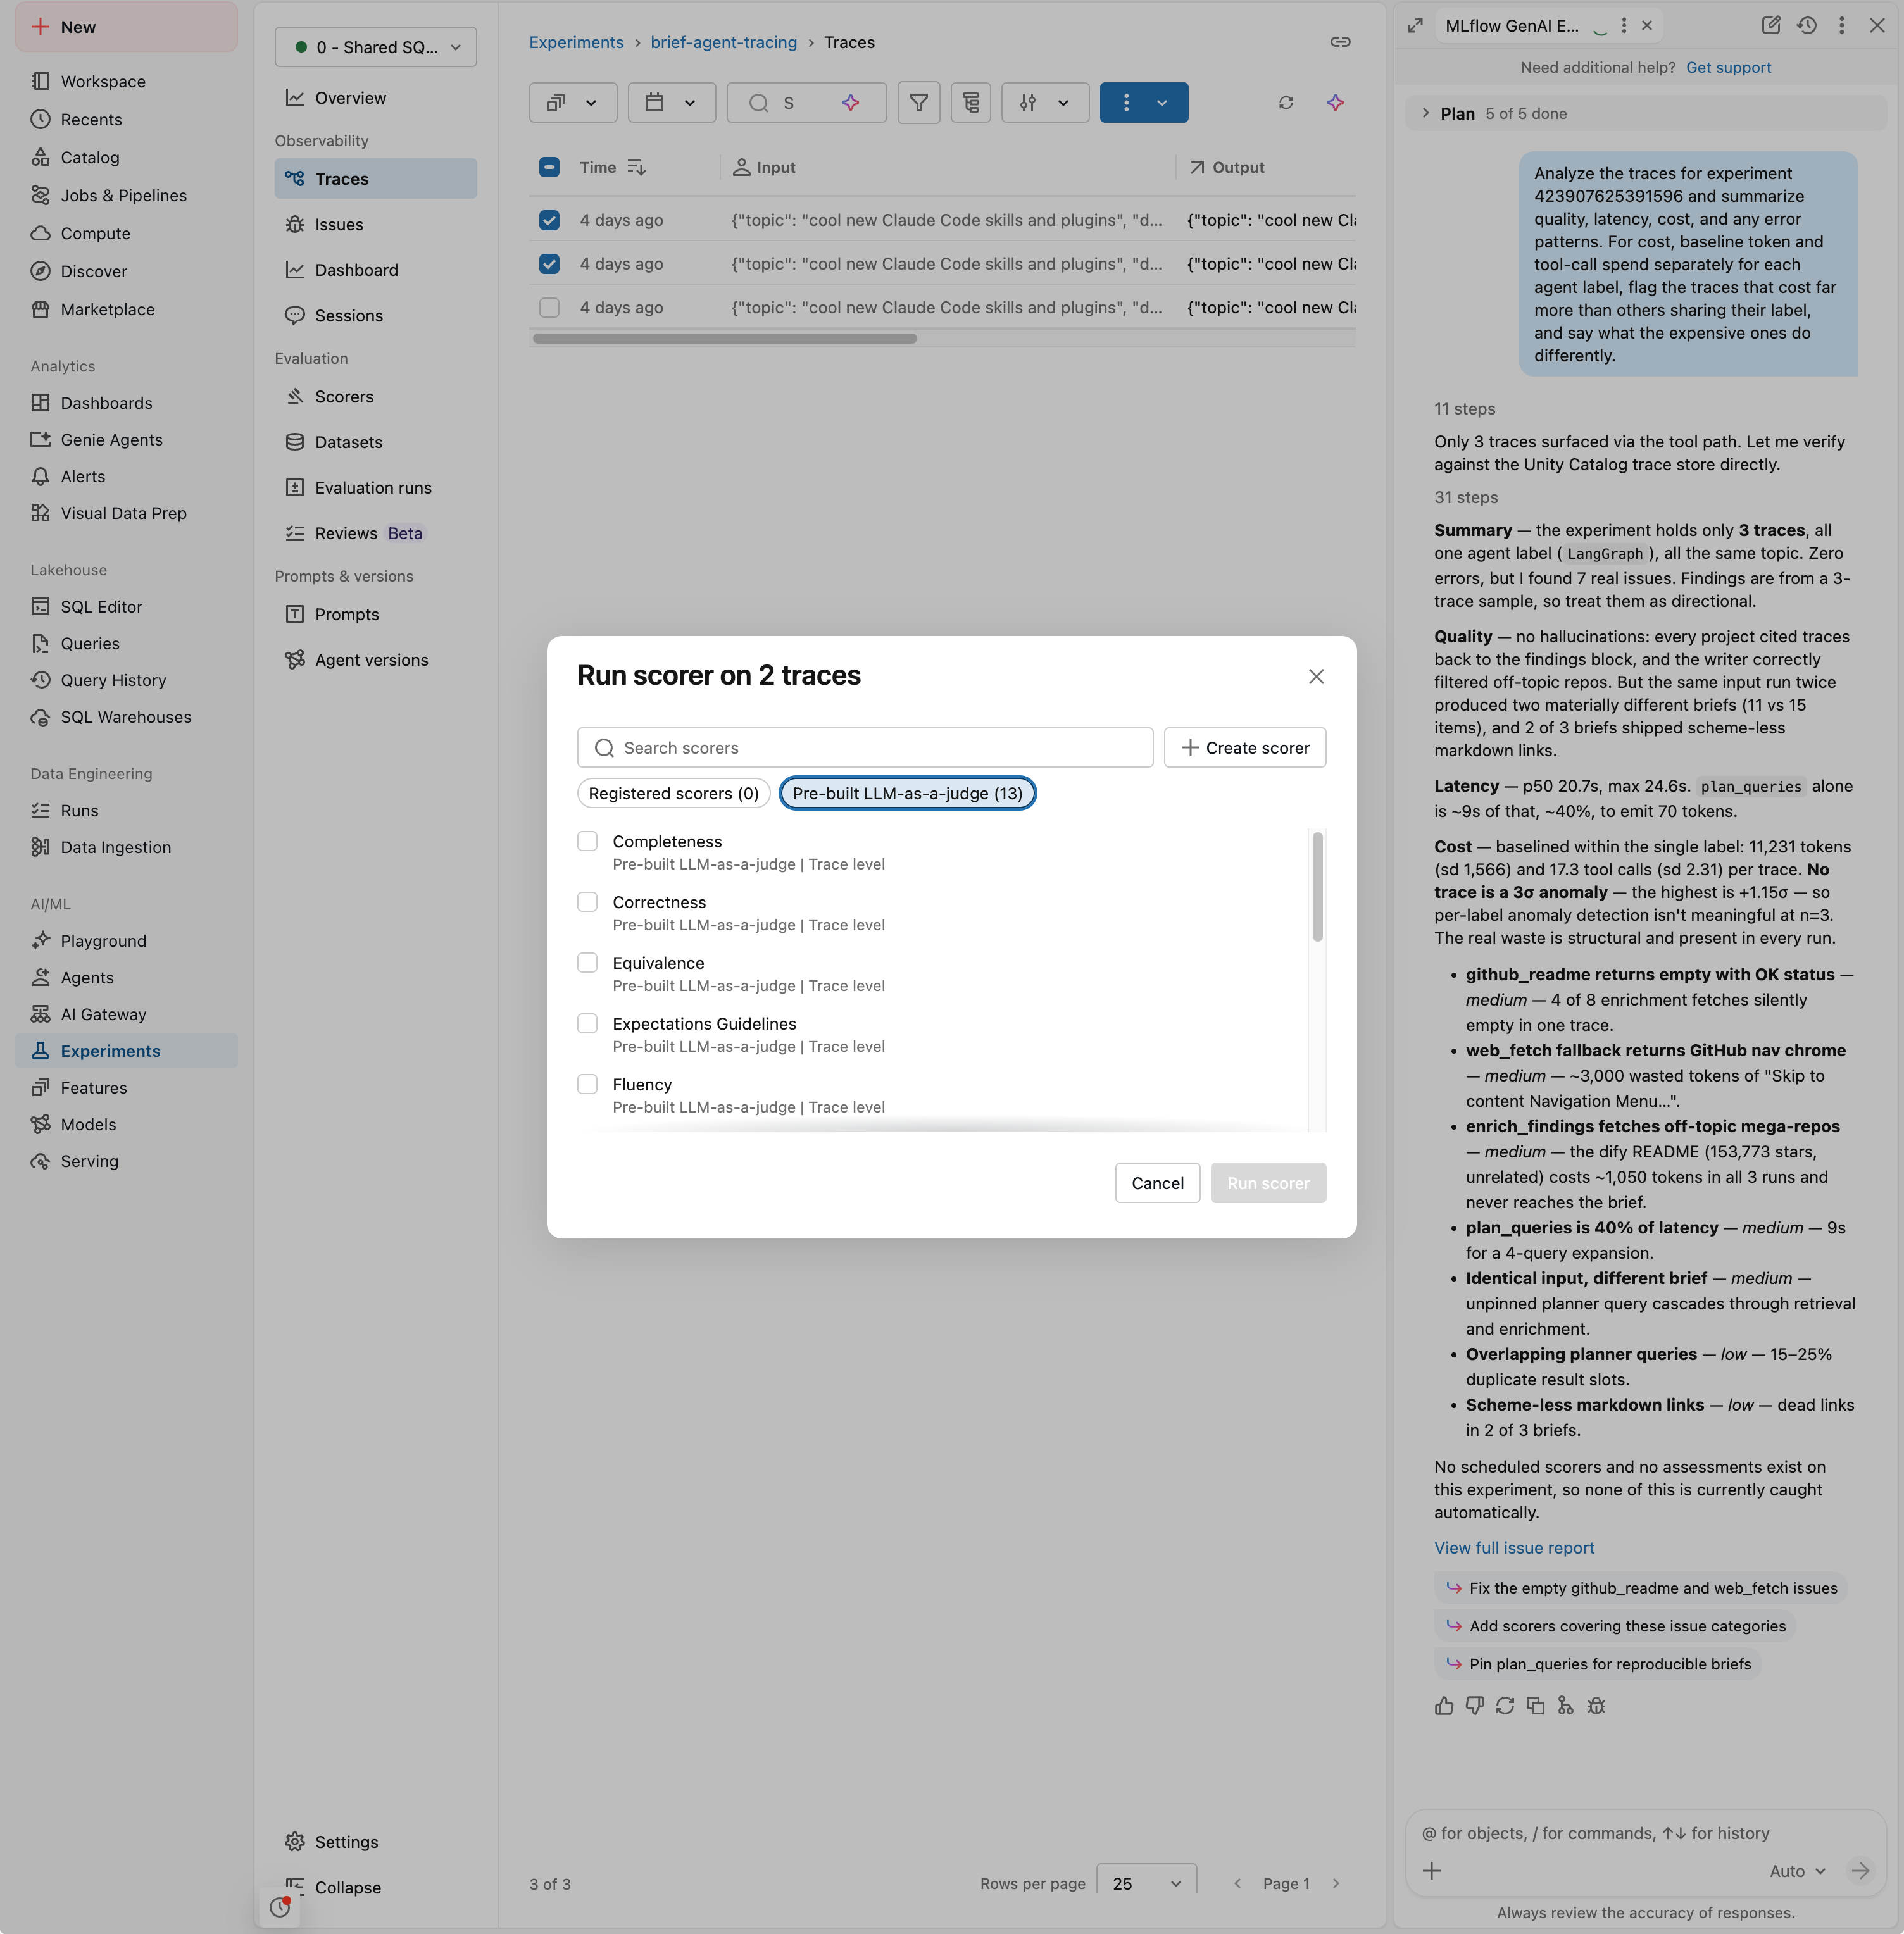
Na caixa de diálogo Run scorer , escolha um ou mais avaliadores: escolha entre os avaliadores de LLM como juiz pré-construídos (como Correção, Completude e Fluência), reutilize um de seus Avaliadores registrados ou clique em Create scorer .
-
Clique em Executar avaliador . O MLflow executa os avaliadores nos rastreamentos selecionados, anexa cada resultado ao seu rastreamento como feedback e registra a execução na aba Evaluation runs .
Esta é a mesma pontuação que impulsiona a avaliação programática — os juízes que você escolhe aqui são os juízes de LLM integrados, e os resultados são gravados como rastreios com feedback de pontuação no seu experimento.
Próximas etapas
- Tutorial: evaluate and improve an agent — Execução
mlflow.genai.evaluate()em um dataset de avaliação para pontuar uma versão inteira de um aplicativo de uma só vez e comparar versões. - Scorers e juízes de LLM — Os juízes integrados, o que cada um mede e quando usá-los.
- Configurar monitoramento de produção — Execute esses mesmos avaliadores automaticamente em uma amostra de tráfego de produção.