Instantâneo
Um Snapshot é uma captura pontual da branch raiz de um projeto, incluindo o esquema e todos os dados. Lakebase cria Snapshot instantaneamente com impacto mínimo no desempenho. Utilize-os para backup ou ponto de restauração.
Você pode criar, restaurar e gerenciar snapshots no Lakebase App, ou trabalhar com eles programaticamente usando a API de snapshots do Python SDK, Java SDK, Databricks CLI ou curl. O Terraform pode restaurar a partir de um snapshot criando um branch. Quando uma operação estiver disponível de mais de uma maneira, as instruções serão exibidas juntas como tabs.
A partir de 1º de junho de 2026, o armazenamento de snapshot será faturável para o Lakebase. Consulte Custos de armazenamento de Snapshot.
Quando usar o Snapshot
Os snapshots são úteis para backups regulares ou antes de fazer alterações de esquema ou outras operações potencialmente destrutivas. Eles oferecem uma maneira rápida de criar pontos de restauração a partir dos quais você pode restaurar o sistema, se necessário.
Criar instantâneo manualmente
Um snapshot captura o estado da sua branch em um determinado momento. Você pode criar snapshots manualmente apenas em branches raiz. O número de capturas de instantâneos manuais é limitado a 10 por projeto (consulte Limites do projeto). Você pode restaurar esses snapshots a partir de qualquer branch do seu projeto.
Criar um instantâneo
Os snapshots são criados instantaneamente e são úteis antes de fazer alterações significativas no seu esquema ou nos dados.
- UI
- Python SDK
- Java SDK
- CLI
- curl
Vá para o seu projeto no Lakebase App e selecione Backup & Restore na navegação de Branch. Clique em Criar snapshot para capturar o estado atual dos seus dados.

create_snapshot retorna uma operação de longa duração. Chame .wait() para bloquear até que o snapshot esteja disponível. O resultado é o Snapshot. source_branch é obrigatório, assim como uma expiração: defina exatamente um entre ttl, expire_time ou no_expiry. Opcionalmente, pin um ponto no tempo com source_branch_lsn ou source_branch_time.
from databricks.sdk import WorkspaceClient
from databricks.sdk.service.postgres import Snapshot, SnapshotSpec, Duration

w = WorkspaceClient()

snapshot = Snapshot(
    spec=SnapshotSpec(
        source_branch="projects/my-project/branches/main",
        ttl=Duration(seconds=604800),  # 7 days
    )
)

result = w.postgres.create_snapshot(
    parent="projects/my-project",
    snapshot=snapshot,
    snapshot_id="my-snapshot",
).wait()

print(f"Snapshot created: {result.name}")
import com.databricks.sdk.WorkspaceClient;
import com.databricks.sdk.service.postgres.*;
import com.google.protobuf.Duration;

WorkspaceClient w = new WorkspaceClient();

SnapshotSpec spec = new SnapshotSpec()
    .setSourceBranch("projects/my-project/branches/main")
    .setTtl(Duration.newBuilder().setSeconds(604800L).build());  // 7 days

Snapshot snapshot = new Snapshot().setSpec(spec);

Snapshot result = w.postgres().createSnapshot(
    new CreateSnapshotRequest()
        .setParent("projects/my-project")
        .setSnapshot(snapshot)
        .setSnapshotId("my-snapshot")
).waitForCompletion();

System.out.println("Snapshot created: " + result.getName());
The snapshot_id is a positional argument after the project. The spec maps to the --json body:
databricks postgres create-snapshot projects/my-project my-snapshot \
  --json '{
    "spec": {
      "source_branch": "projects/my-project/branches/main",
      "ttl": "604800s"
    }
  }'
A criação de um snapshot é uma operação de longa duração. A solicitação retorna uma operação que você consulta até que seja concluída. A operação concluída é descompactada para o Snapshot recurso. Na prática, o snapshot torna-se AVAILABLE prontamente.
A especificação do snapshot exige um source_branch. Configure o ponto no tempo e a expiração da seguinte maneira:
- Ponto no tempo (opcional): defina
source_branch_lsnousource_branch_time(mutuamente exclusivos). Omitam ambos para capturar um snapshot da cabeça atual da branch. - Expiração (obrigatório): defina exatamente um de
expire_time(um Timestamp RFC 3339 que deve estar no futuro),ttl(uma duração em segundos, como"604800s") ouno_expiry: true.
The snapshot_id is required, is chosen by you, and cannot be changed after creation.
-
Send the create request. The
snapshot_idgoes in the query string, and the spec maps to the request body:Bashcurl -X POST "$WORKSPACE/api/2.0/postgres/projects/my-project/snapshots?snapshot_id=my-snapshot" \
-H "Authorization: Bearer ${DATABRICKS_TOKEN}" \
-H "Content-Type: application/json" \
-d '{
"spec": {
"source_branch": "projects/my-project/branches/main",
"source_branch_lsn": "16/B374D848",
"ttl": "604800s"
}
}'A resposta é uma operação de longa duração:
JSON{
"name": "projects/my-project/operations/<operation-id>",
"done": false
} -
Monitore a operação até que
donesejatrue:Bashcurl "$WORKSPACE/api/2.0/postgres/projects/my-project/operations/<operation-id>" \
-H "Authorization: Bearer ${DATABRICKS_TOKEN}" | jqQuando concluído, o
responseda operação é descompactado para oSnapshot:JSON{
"name": "projects/my-project/operations/<operation-id>",
"done": true,
"response": {
"@type": "type.googleapis.com/databricks.postgres.v1.Snapshot",
"name": "projects/my-project/snapshots/my-snapshot",
"status": {
"full_size_bytes": "10485760",
"diff_size_bytes": "524288"
}
}
}Os campos de tamanho são valores
int64serializados como strings. -
Confirme se o snapshot está disponível obtendo-o diretamente.
Para obter mais informações sobre operações de longa duração, consulte operações de longa duração.
Crie um programador de backup
Programar a criação automática de snapshots para execução em intervalos regulares (diários, semanais ou mensais) para garantir backups consistentes sem intervenção manual. Os programas de backup são configurados por branch e aplicam-se apenas às branches raiz. O limite para capturas instantâneas manuais (consulte Limites do projeto) não se aplica a capturas instantâneas agendadas.
Each root branch has a single backup schedule that holds a list of cadences. You read the schedule and replace its cadences in place. There is no separate create or delete operation, and setting an empty list disables automated snapshots. Configure the programação in the Lakebase App, or programmatically with the backup programação API from the Python SDK, Java SDK, Databricks CLI, Terraform, Databricks Ativos Bundles, or curl.
Programmatic access to backup schedules is in Beta and available to all Lakebase workspaces.
- UI
- Python SDK
- Java SDK
- CLI
- Terraform
- Databricks Asset Bundles
- curl
Para criar ou modificar um programa de backup:
-
Na página Backup e Restauração do seu projeto, clique em Editar programa para abrir a caixa de diálogo de configuração do programa de backup.
-
Selecione uma frequência de programação dentre as seguintes opções:
- Sem programar – Desativa o Snapshot automático (default)
- Diário – Cria um instantâneo todos os dias em um horário específico.
- Semanal – Cria um instantâneo em um dia específico da semana.
- Mensal – Cria um instantâneo em um dia específico do mês.

-
Configure os detalhes do programa com base na frequência selecionada. Especifique com que frequência deseja criar instantâneos e por quanto tempo mantê-los.
Após a configuração, os snapshots criados pelo programa aparecem na página Backup e Restauração com uma etiqueta indicando que foram criados automaticamente.
Leia a programação com get_snapshot_schedule e defina suas cadências com update_snapshot_schedule. update_snapshot_schedule usa o nome do recurso do programar como seu argumento name e substitui todo o conjunto de cadências. Para definir uma cadência semanal que mantenha cada snapshot por 7 dias, execute o seguinte:
from databricks.sdk import WorkspaceClient
from databricks.sdk.service.postgres import (
    SnapshotSchedule,
    ScheduleCadence,
    WeeklySchedule,
    DayOfWeek,
    Duration,
    FieldMask,
)

w = WorkspaceClient()

schedule = SnapshotSchedule(
    name="projects/my-project/branches/main/snapshot-schedule",
    schedule=[
        ScheduleCadence(
            weekly_schedule=WeeklySchedule(day_of_week=DayOfWeek.MONDAY, hour=3),
            retention=Duration(seconds=604800),  # 7 days
        )
    ],
)

w.postgres.update_snapshot_schedule(
    name="projects/my-project/branches/main/snapshot-schedule",
    snapshot_schedule=schedule,
    update_mask=FieldMask(field_mask=["schedule"]),
)

print("Schedule updated.")
Para ler o agendamento atual, execute o seguinte:
schedule = w.postgres.get_snapshot_schedule(
    name="projects/my-project/branches/main/snapshot-schedule"
)

for cadence in schedule.schedule:
    print(cadence)
Para definir uma cadência semanal que mantenha cada snapshot por 7 dias, execute o seguinte:
import com.databricks.sdk.WorkspaceClient;
import com.databricks.sdk.service.postgres.*;
import com.google.protobuf.Duration;
import java.util.List;

WorkspaceClient w = new WorkspaceClient();

ScheduleCadence cadence = new ScheduleCadence()
    .setWeeklySchedule(new WeeklySchedule().setDayOfWeek(DayOfWeek.MONDAY).setHour(3))
    .setRetention(Duration.newBuilder().setSeconds(604800L).build());  // 7 days

SnapshotSchedule schedule = new SnapshotSchedule()
    .setName("projects/my-project/branches/main/snapshot-schedule")
    .setSchedule(List.of(cadence));

SnapshotSchedule result = w.postgres().updateSnapshotSchedule(
    new UpdateSnapshotScheduleRequest()
        .setName("projects/my-project/branches/main/snapshot-schedule")
        .setSnapshotSchedule(schedule)
        .setUpdateMask("schedule")
).waitForCompletion();

System.out.println("Schedule updated: " + result.getName());
Requer o Databricks CLI 1.16.0 e acima. Leia o cronograma com get-snapshot-schedule e defina-o com update-snapshot-schedule. O segundo argumento é a máscara de atualização, que deve ser schedule. A definição do programar substitui todo o conjunto de cadências e é uma operação de longa execução, portanto, o comando aguarda a conclusão, a menos que você passe --no-wait.
Para ler o agendamento atual, execute o seguinte:
databricks postgres get-snapshot-schedule \
  projects/my-project/branches/main/snapshot-schedule
Para definir uma cadência semanal que mantenha cada snapshot por 7 dias, execute o seguinte:
databricks postgres update-snapshot-schedule \
  projects/my-project/branches/main/snapshot-schedule \
  schedule \
  --json '{
    "schedule": [
      { "weekly_schedule": { "day_of_week": "MONDAY", "hour": 3 }, "retention": "604800s" }
    ]
  }'
Para desativar os snapshots automatizados, defina uma programação vazia:
databricks postgres update-snapshot-schedule \
  projects/my-project/branches/main/snapshot-schedule \
  schedule \
  --json '{ "schedule": [] }'
Gerenciar o programar com um recurso databricks_postgres_snapshot_schedule. Defina parent como o nome do recurso de branch; o name do próprio programar é derivado dele. O atributo schedule é uma lista de cadências, e a aplicação do recurso substitui o conjunto de cadências do branch:
resource "databricks_postgres_snapshot_schedule" "this" {
  parent = "projects/my-project/branches/main"

  schedule = [{
    weekly_schedule = {
      day_of_week = "MONDAY"
      hour        = 3
    }
    retention = "604800s" # 7 days
  }]
}
Defina o programar sob a key postgres_snapshot_schedules na configuração do seu pacote. Defina branch como o nome do recurso de branch. A implantação do pacote substitui o conjunto de cadências do branch:
resources:
  postgres_snapshot_schedules:
    main_schedule:
      branch: projects/my-project/branches/main
      schedule:
        - weekly_schedule:
            day_of_week: MONDAY
            hour: 3
          retention: 604800s # 7 days
Leia o agendamento com GET e defina-o com PATCH. A atualização substitui todo o conjunto de cadências; portanto, inclua todas as cadências que deseja manter e passe update_mask=schedule.
Para ler o agendamento atual, execute o seguinte:
curl "$WORKSPACE/api/2.0/postgres/projects/my-project/branches/main/snapshot-schedule" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" | jq
Atualizar a programar é uma operação de longa duração. Para definir uma periodicidade semanal que mantenha cada Snapshot por 7 dias, execute o seguinte:
curl -X PATCH "$WORKSPACE/api/2.0/postgres/projects/my-project/branches/main/snapshot-schedule?update_mask=schedule" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" \
  -H "Content-Type: application/json" \
  -d '{
    "schedule": [
      { "weekly_schedule": { "day_of_week": "MONDAY", "hour": 3 }, "retention": "604800s" }
    ]
  }'
Consulte a operação retornada até que done seja true. Consulte Operações de longa duração. O response da operação concluída é descompactado para o SnapshotSchedule.
Para desativar os snapshots automatizados, defina uma programação vazia:
curl -X PATCH "$WORKSPACE/api/2.0/postgres/projects/my-project/branches/main/snapshot-schedule?update_mask=schedule" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" \
  -H "Content-Type: application/json" \
  -d '{ "snapshot_schedule": { "schedule": [] } }'
Referência de cadência e retenção
Cada cadência em um agendamento é exatamente uma das seguintes recorrências, considerada em uma hora cheia em UTC. Minutos e segundos não são aceitos.
- Diariamente : defina
hour(0–23). - Semanal : defina
day_of_week(MONDAYaSUNDAY) ehour(0–23). - Monthly : defina
day(1–31, limitado ao último dia de meses mais curtos) ehour(0–23).
Cada cadência também define uma duração retention, após a qual seus snapshots expiram:
- A retenção deve ser de pelo menos 1 hora e, no máximo, 35 dias.
- A retenção se aplica quando um Snapshot é obtido e não é retroativa. Os Snapshots existentes mantêm sua expiração original. Somente os Snapshots obtidos após a alteração usam a nova retenção.
- If more than one cadence is due in the same window, Lakebase creates a single snapshot and keeps it for the longest retention among the matching cadences.
A leitura e a atualização do schedule exigem a permissão CAN_USE no projeto.
RetençãoSnapshot
Os instantâneos são excluídos automaticamente após o término do período de retenção. Você pode ajustar as configurações de retenção a qualquer momento editando o programa. Ter em mente:
- Períodos de retenção mais curtos ajudam a controlar a quantidade de snapshots agendados que são retidos.
- O instantâneo excluído não pode ser recuperado.
- Os snapshots manuais não são afetados pelas configurações de retenção do programa de backup.
Obter e listar snapshots
Visualize seus snapshots na página Backup & Restore no aplicativo Lakebase ou recupere-os de forma programática com a API.
List snapshots
- UI
- Python SDK
- Java SDK
- CLI
- curl
Na página Backup & Restore no aplicativo Lakebase, seus snapshots são listados por data, mostrando a data e o tamanho de cada snapshot. Os snapshots agendados aparecem na mesma lista com um rótulo indicando que foram criados automaticamente.
from databricks.sdk import WorkspaceClient

w = WorkspaceClient()

for snapshot in w.postgres.list_snapshots(parent="projects/my-project"):
    print(f"Snapshot: {snapshot.name}")
import com.databricks.sdk.WorkspaceClient;
import com.databricks.sdk.service.postgres.Snapshot;

WorkspaceClient w = new WorkspaceClient();

for (Snapshot snapshot : w.postgres().listSnapshots("projects/my-project")) {
    System.out.println("Snapshot: " + snapshot.getName());
}
databricks postgres list-snapshots projects/my-project --output json | jq
Lista os snapshots em um projeto. Use page_size e page_token para navegar pelas páginas de resultados. Um next_page_token vazio indica a última página:
curl "$WORKSPACE/api/2.0/postgres/projects/my-project/snapshots?page_size=20" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" | jq
{
  "snapshots": [{ "name": "projects/my-project/snapshots/my-snapshot" }],
  "next_page_token": ""
}
Obter um único snapshot
Obter os detalhes de um snapshot pelo seu ID. Ao contrário de create e delete, get retorna o recurso Snapshot diretamente (não é uma operação de longa duração). Nas leituras, a expiração é relatada como expire_time ou no_expiry.
- Python SDK
- Java SDK
- CLI
- curl
from databricks.sdk import WorkspaceClient

w = WorkspaceClient()

snapshot = w.postgres.get_snapshot(name="projects/my-project/snapshots/my-snapshot")

print(f"Snapshot: {snapshot.name}")
print(f"Source branch: {snapshot.status.source_branch}")
print(f"Full size: {snapshot.status.full_size_bytes} bytes")
import com.databricks.sdk.WorkspaceClient;
import com.databricks.sdk.service.postgres.Snapshot;

WorkspaceClient w = new WorkspaceClient();

Snapshot snapshot = w.postgres().getSnapshot("projects/my-project/snapshots/my-snapshot");

System.out.println("Snapshot: " + snapshot.getName());
System.out.println("Full size: " + snapshot.getStatus().getFullSizeBytes() + " bytes");
databricks postgres get-snapshot projects/my-project/snapshots/my-snapshot --output json | jq
curl "$WORKSPACE/api/2.0/postgres/projects/my-project/snapshots/my-snapshot" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" | jq
Restaurar a partir de um instantâneo
Para usar um snapshot, restaure-o criando um novo branch a partir dele. Não há restauração no local: o branch atual permanece inalterado e um novo branch raiz é criado com os dados do snapshot.
- UI
- Python SDK
- Java SDK
- CLI
- Terraform
- curl
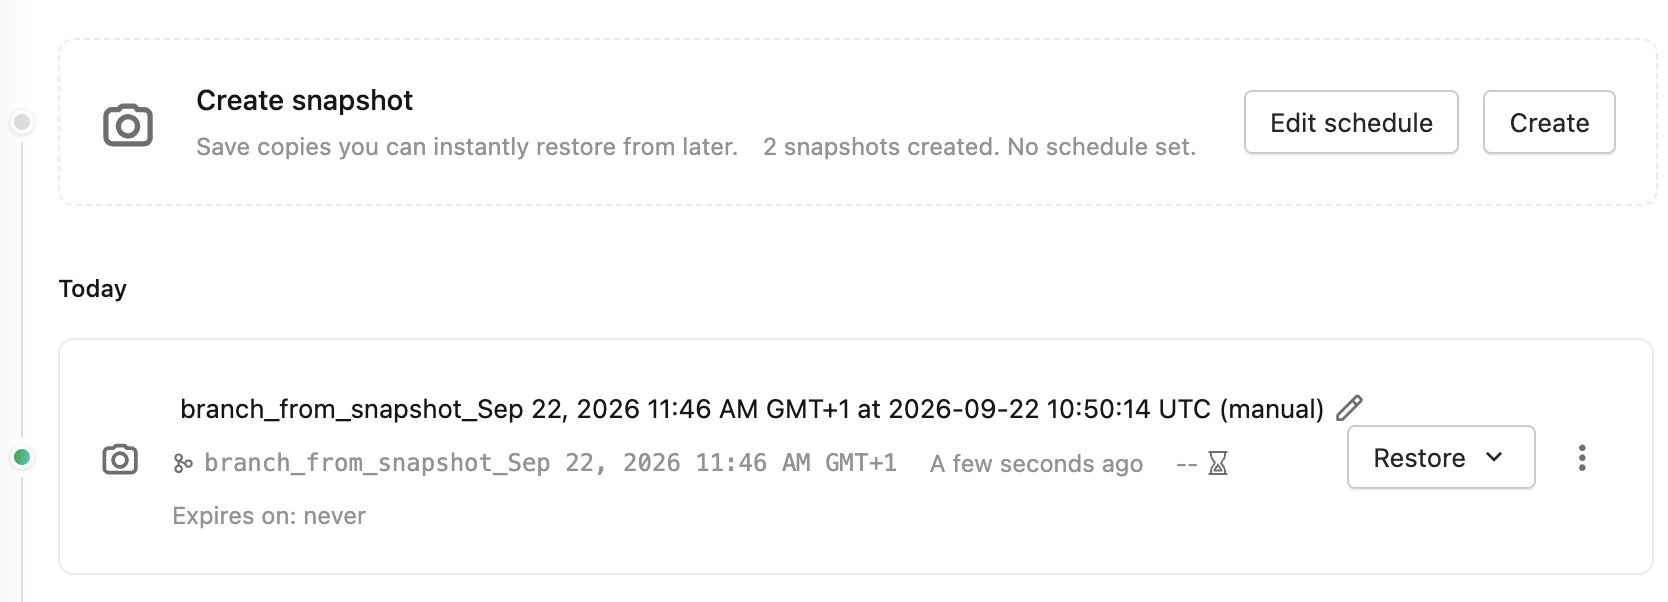
Na página **Backup e Restauração** no aplicativo Lakebase, os Snapshots são listados por data. Localize o Snapshot que você quer restaurar e clique em **Restaurar**. Uma caixa de diálogo de confirmação é exibida, explicando o que acontecerá: a restauração ocorre instantaneamente, seu branch atual permanece inalterado, e um novo branch será criado com um nome como branch_from_snapshot_, seguido pela data e hora do Snapshot. Confirme que deseja realizar a operação clicando em Restaurar . Um **novo branch raiz** é criado com os dados do snapshot. Seu branch atual permanece inalterado.
Após a conclusão da restauração, você verá uma mensagem de sucesso e a página de visão geral da nova ramificação. A seção intitulada "Conectar-se à nova ramificação para visualizar os dados restaurados" explica que você pode se conectar a partir do seu aplicativo ou cliente para verificar os dados restaurados.

Clique em Obter detalhes da conexão para abrir uma caixa de diálogo com as informações de conexão da nova ramificação: ramificação, compute, banco de dados, função e uma cadeia de conexão que você pode copiar. O compute da ramificação pode aparecer como "Pendente" enquanto estiver em andamento. Uma vez ativo, você pode usar as strings de conexão para se conectar.
Outras coisas que você pode fazer com seu novo galho:
- Visualize os dados. Utilize os detalhes de conexão da nova filial para verificar os dados e confirmar a restauração antes de alterar a configuração do seu aplicativo. Consulte Conectar-se ao seu banco de dados.
- Renomeie a filial. Dê um nome mais claro à ramificação, utilizando a visão geral de ramificações ou a lista de ramificações. Consulte Atualizar configurações de ramificação.
- Definir como default. Se você estiver satisfeito com os dados restaurados, poderá tornar esta ramificação a ramificação default do projeto. Consulte Definir como default.
- Direcione sua aplicação para a nova ramificação. Após se certificar de que os dados estão corretos, atualize as configurações de conexão do seu aplicativo para usar os detalhes de conexão desta filial.
- Remover ou manter o ramo anterior. Você pode excluir a ramificação que estava usando anteriormente, caso não precise mais dela, ou mantê-la como backup. Consulte Excluir uma ramificação.
Você pode gerenciar a nova ramificação e todas as ramificações do projeto na página Ramificações do projeto, onde a ramificação restaurada aparece como uma ramificação raiz ao lado das suas outras ramificações.
Não há nenhuma operação de restauração independente. Crie um branch com source_snapshot definido como o nome de recurso do snapshot. Isso roteia a criação do branch pelo caminho de restauração, produzindo um novo branch raiz com os dados do snapshot. source_snapshot é mutuamente exclusivo com source_branch, source_branch_lsn e source_branch_time, e o branch ainda requer uma expiração (no_expiry, ttl ou expire_time). Definir replace_existing: true junto com source_snapshot faz um upsert em um branch de destino existente, uma restauração idempotente.
from databricks.sdk import WorkspaceClient
from databricks.sdk.service.postgres import Branch, BranchSpec

w = WorkspaceClient()

branch = Branch(
    spec=BranchSpec(
        source_snapshot="projects/my-project/snapshots/my-snapshot",
        no_expiry=True,
    )
)

result = w.postgres.create_branch(
    parent="projects/my-project",
    branch=branch,
    branch_id="restored-branch",
).wait()

print(f"Branch created: {result.name}")
import com.databricks.sdk.WorkspaceClient;
import com.databricks.sdk.service.postgres.*;

WorkspaceClient w = new WorkspaceClient();

BranchSpec spec = new BranchSpec()
    .setSourceSnapshot("projects/my-project/snapshots/my-snapshot")
    .setNoExpiry(true);

Branch branch = new Branch().setSpec(spec);

Branch result = w.postgres().createBranch(
    new CreateBranchRequest()
        .setParent("projects/my-project")
        .setBranch(branch)
        .setBranchId("restored-branch")
).waitForCompletion();

System.out.println("Branch created: " + result.getName());
databricks postgres create-branch projects/my-project restored-branch \
  --json '{
    "spec": {
      "source_snapshot": "projects/my-project/snapshots/my-snapshot",
      "no_expiry": true
    }
  }'
Restore from a snapshot by declaring a databricks_postgres_branch with source_snapshot set in its spec. O suporte do Terraform para Snapshot é limitado a esse caminho de restauração — não há nenhum recurso do Terraform para criar, listar ou excluir Snapshot.
resource "databricks_postgres_branch" "restored" {
  branch_id = "restored-branch"
  parent    = "projects/my-project"
  spec = {
    source_snapshot = "projects/my-project/snapshots/my-snapshot"
    no_expiry       = true
  }
}
Não há nenhuma operação de restauração independente. Para restaurar um snapshot, crie um novo branch e defina source_snapshot na especificação do branch com o nome de recurso do snapshot. Isso encaminha a criação do branch pelo caminho de restauração, produzindo um novo branch raiz que contém os dados do snapshot. Seus branches existentes permanecem inalterados.
source_snapshot é mutuamente exclusivo com source_branch, source_branch_lsn e source_branch_time. Definir replace_existing: true junto com source_snapshot atualiza (upsert) um branch de destino existente, uma restauração idempotente. O snapshot referenciado deve ser AVAILABLE e pertencer ao mesmo projeto do novo branch.
-
Crie o branch a partir do snapshot. O
branch_idvai na query string:Bashcurl -X POST "$WORKSPACE/api/2.0/postgres/projects/my-project/branches?branch_id=restored-branch" \
-H "Authorization: Bearer ${DATABRICKS_TOKEN}" \
-H "Content-Type: application/json" \
-d '{
"spec": {
"source_snapshot": "projects/my-project/snapshots/my-snapshot",
"no_expiry": true
}
}' -
Poll the returned operation until
doneistrue. The completed operation unpacks to the newBranch. -
Conecte-se ao novo branch para verificar os dados restaurados antes de apontar seu aplicativo para ele. Consulte Criar um branch e Conectar-se ao seu banco de dados.
Excluir um snapshot
Snapshots excluídos não podem ser recuperados.
- UI
- Python SDK
- Java SDK
- CLI
- curl
Na página Backup & Restore no Lakebase App, localize o snapshot na lista, abra seu menu kebab  e selecione Delete snapshot .
A exclusão de um snapshot é uma operação de longa duração. Chame .wait() para bloquear até que seja concluído.
from databricks.sdk import WorkspaceClient

w = WorkspaceClient()

w.postgres.delete_snapshot(name="projects/my-project/snapshots/my-snapshot").wait()

print("Snapshot deleted")
import com.databricks.sdk.WorkspaceClient;

WorkspaceClient w = new WorkspaceClient();

w.postgres().deleteSnapshot("projects/my-project/snapshots/my-snapshot")
    .waitForCompletion();

System.out.println("Snapshot deleted");
databricks postgres delete-snapshot projects/my-project/snapshots/my-snapshot
A exclusão de um snapshot é uma operação de longa duração. A solicitação retorna uma operação. A resposta da operação concluída está vazia.
curl -X DELETE "$WORKSPACE/api/2.0/postgres/projects/my-project/snapshots/my-snapshot" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" | jq
Consulte a operação retornada até que done seja true.
Custos de armazenamento de Snapshot
A partir de 1º de junho de 2026, o armazenamento de snapshot será faturável para o Lakebase.
A cobrança é baseada no tipo de snapshot:
- Os Snapshots manuais são cobrados como Snapshots completos.
- Snapshots agendados são cobrados como Snapshots completos para o primeiro Snapshot em um agendamento, depois como armazenamento incremental (delta) para os Snapshots agendados subsequentes.
O tamanho de cada snapshot é exibido na página **Backup e Restauração**. Para obter detalhes de preços, consulte a página de preços da Lakebase.
Limitações
A API de snapshots tem as seguintes limitações:
- Os snapshots são imutáveis. Não há nenhuma operação de atualização. A Branch de origem, o seletor de ponto no tempo e a expiração são fixos na criação e não podem ser alterados.
- Sem restauração in-place. Você restaura um snapshot apenas criando um novo branch a partir dele.
- Mesmo projeto, Snapshot disponível. O Snapshot de origem deve estar no estado
AVAILABLEe pertencer ao mesmo projeto da nova Branch. - Campos de restauração mutuamente exclusivos. Na solicitação de criação de branch,
source_snapshotnão pode ser combinado comsource_branch, um LSN de branch ou um timestamp de branch. Ele pode ser combinado comreplace_existingpara atualizar (upsert) um branch de destino existente. - Terraform. O provedor oferece suporte à restauração a partir de um snapshot apenas, por meio do argumento
source_snapshotemdatabricks_postgres_branch. Não há nenhum recurso do Terraform para criar, listar ou excluir snapshots. - Disponibilidade em Beta. A API de snapshots está em Beta e disponível para todos os workspaces do Lakebase.
Relacionado
- Branches — Como o branching funciona no Lakebase
- Guia da API Lakebase — Autenticação, nomenclatura de recursos e operações de longa duração