Execução adaptável de consultas
A execução adaptativa de consultas (AQE) é a reotimização de consultas que ocorre durante a execução da consulta.
Antes que uma query esteja em execução, o otimizador escolhe um plano de query com base em estimativas do tamanho dos dados. Essas estimativas podem estar erradas se as estatísticas da tabela estiverem ausentes ou obsoletas, se os dados estiverem distorcidos ou para os passos posteriores em uma query complexa. Um plano criado com base em estimativas incorretas pode usar uma estratégia de join lenta, criar muitas tarefas pequenas após uma aleatoriedade ou criar algumas tarefas muito grandes que seguram todo o estágio. O AQE corrige esses problemas reotimizando o plano enquanto a query está em execução, com base no tamanho real dos dados.
No final de cada exchange de shuffle ou broadcast, o Databricks tem estatísticas precisas para os dados produzidos até agora. O AQE usa essas estatísticas para escolher uma estratégia física melhor, escolher um número e tamanho ideais de partições pós-shuffle ou aplicar otimizações que, de outra forma, exigiriam dicas de query, como o tratamento de join distorcido.
O AQE é ativado por default. Você não precisa alterar suas consultas para se beneficiar disso. Verifique se o AQE alterou um plano de query ao solucionar problemas de uma query lenta. Ajuste as configurações de AQE apenas quando os default não atenderem à sua carga de trabalho. Consulte Planos de query e Configuração.
Capacidades
O AQE tem quatro recursos principais:
- Altera dinamicamente a classificação merge join para broadcast hash join.
- Coalesce dinamicamente as partições (combine partições pequenas em partições de tamanho razoável) após a troca aleatória. Tarefas muito pequenas têm taxas de transferência de E/S piores e tendem a sofrer mais com o overhead de programação e o overhead de configuração da tarefa. A combinação de pequenas tarefas economiza recurso e melhora o agrupamento Taxa de transferência.
- Lida dinamicamente com a inclinação na classificação merge join e embaralha o hash join dividindo (e replicando, se necessário) a tarefa inclinada em uma tarefa de tamanho aproximadamente igual.
- Detecta e propaga dinamicamente relações vazias, que são partes de uma query que não retornam linhas.
query suportadas
O AQE se aplica a queries que atendem a ambas as condições:
- A query não é uma query de transmissão.
- A query contém pelo menos um exchange (geralmente de um join, aggregate ou window), pelo menos uma subconsulta ou ambos.
O AQE reotimiza cada query compatível, mas o resultado pode ser o mesmo plano que o otimizador compilou antes da execução da query. Para verificar se o AQE alterou o plano de uma query, veja Planos de query.
Planos de consulta
Queries com aplicação de AQE contêm um ou mais nós AdaptiveSparkPlan, geralmente como o nó raiz de cada query principal ou sub-query. Cada nó AdaptiveSparkPlan tem um sinalizador isFinalPlan . O sinalizador é false antes e durante a execução da query, e muda para true quando a query termina.
Para view um plano query, use a Spark UI, DataFrame.explain() ou SQL EXPLAIN. Cada uma mostra informações diferentes sobre como o AQE altera o plano.
Spark UI
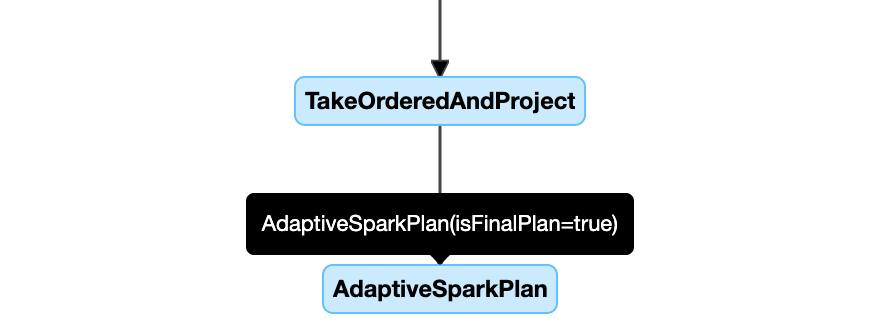
O diagrama do plano de query na Spark UI mostra o plano mais atual e é atualizado conforme a query é executada. Nós que já tiveram execução e têm métricas não mudam. Os nós que ainda não foram execução podem mudar à medida que o AQE reotimiza o plano.
Este exemplo mostra um diagrama do plano de query:
DataFrame.explain()
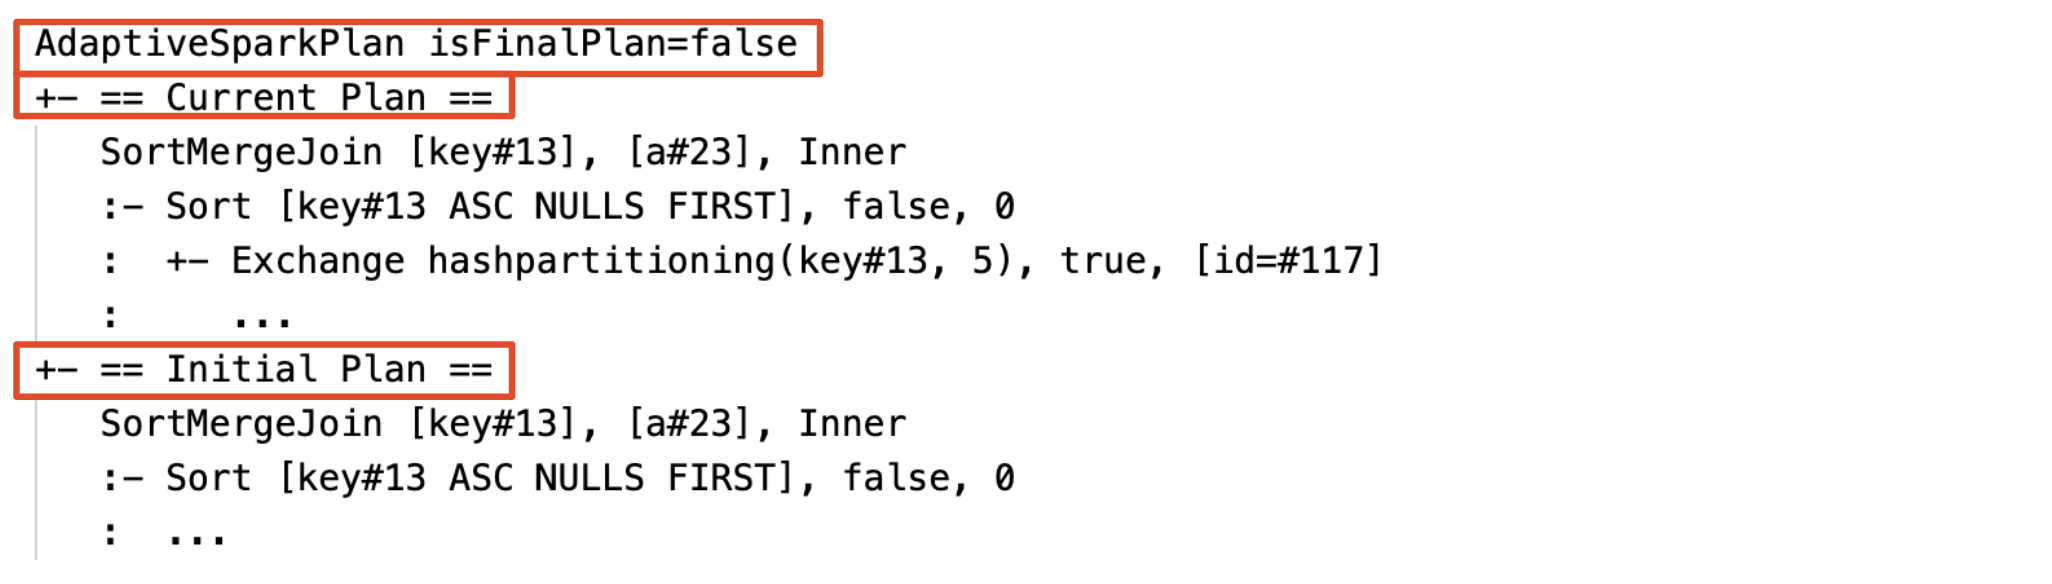
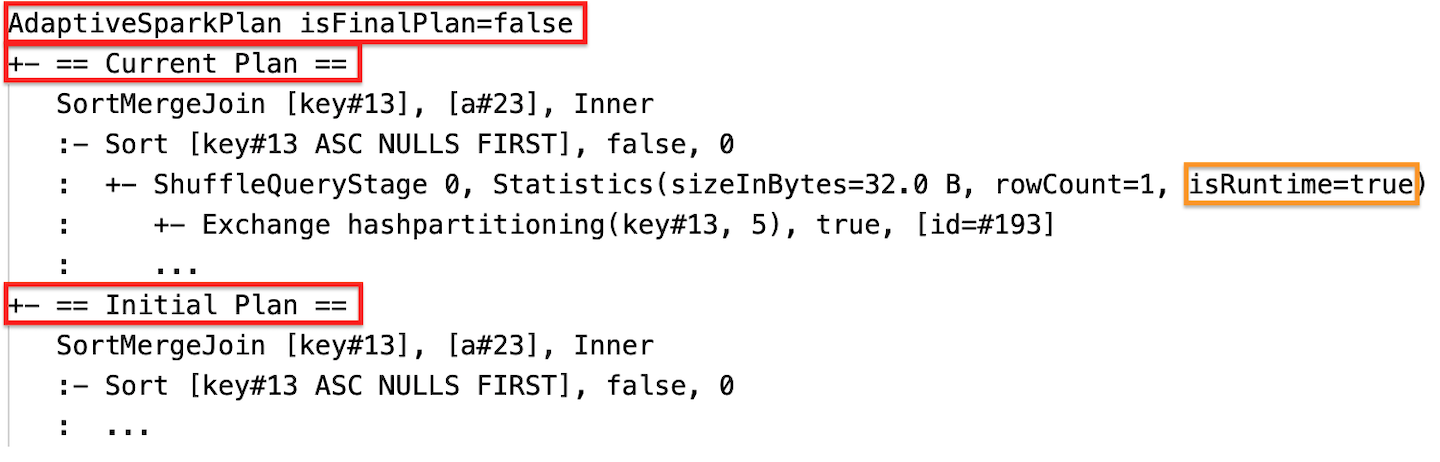
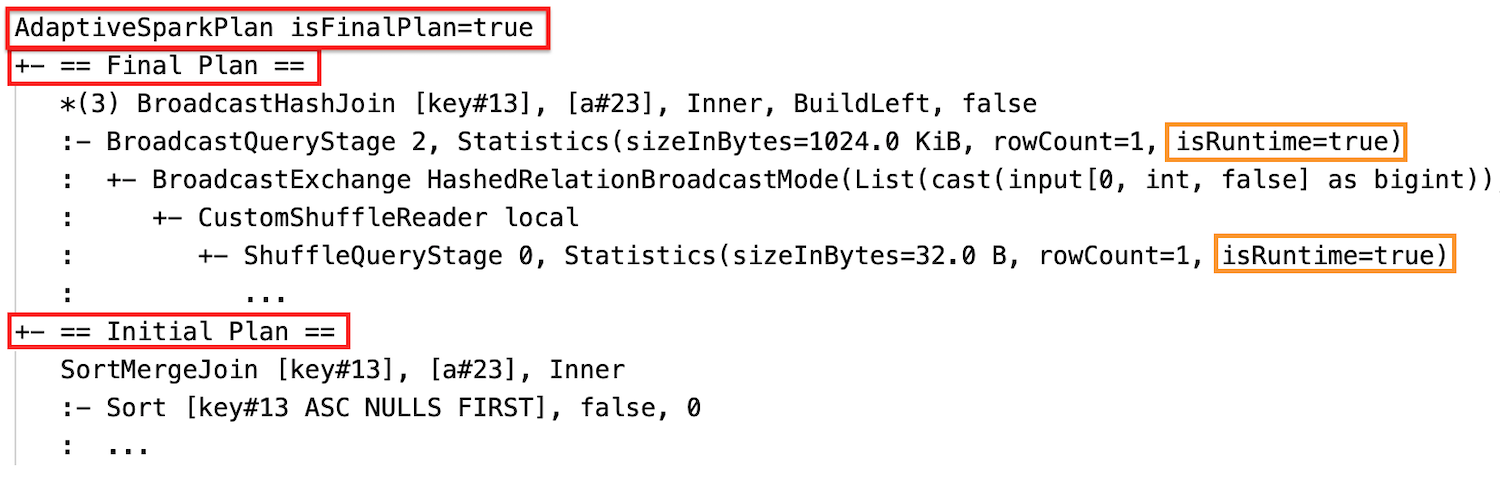
DataFrame.explain() mostra dois planos em cada nó AdaptiveSparkPlan: o plano inicial, antes de o AQE aplicar qualquer otimização, e o plano atual. O plano atual muda à medida que a query entra em execução e torna-se o plano final quando a query é concluída.
A saída inclui estatísticas de dados para cada estágio de shuffle e broadcast. As estatísticas dependem se o estágio foi execução:
- Antes e durante a execução do estágio,
isRuntimeéfalsee as estatísticas são estimativas de tempo de compilação. Por exemplo,Statistics(sizeInBytes=1024.0 KiB, rowCount=4, isRuntime=false). - Após a execução da etapa,
isRuntimeétruee as estatísticas são medições de runtime. Por exemplo,Statistics(sizeInBytes=658.1 KiB, rowCount=2.81E+4, isRuntime=true).
Estas capturas de tela mostram a saída de DataFrame.explain() antes, durante e após a execução:
-
Antes da execução
-
Durante a execução
-
Depois da execução
SQL EXPLAIN
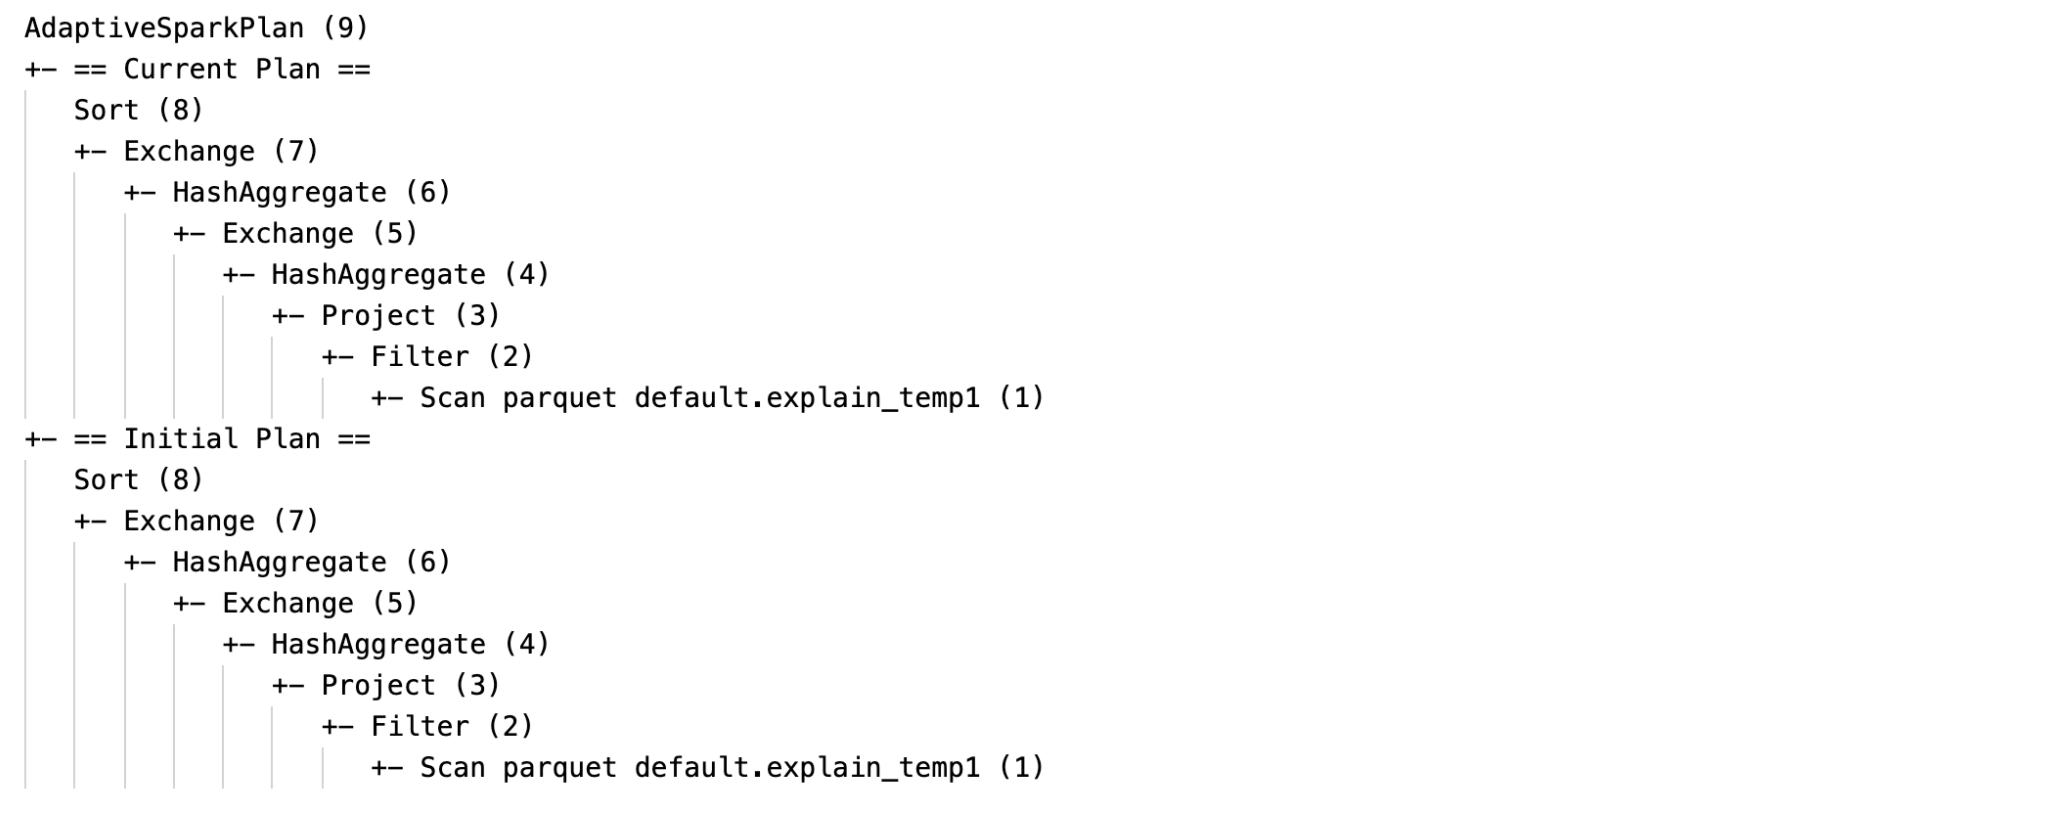
SQL EXPLAIN não realiza a execução da query, então o AQE não pode reotimizá-la. A saída mostra apenas o plano inicial, que pode ser diferente do plano que o AQE faz execução.
Este exemplo mostra a saída do SQL EXPLAIN:
Identificar otimizações aplicadas em um plano de query
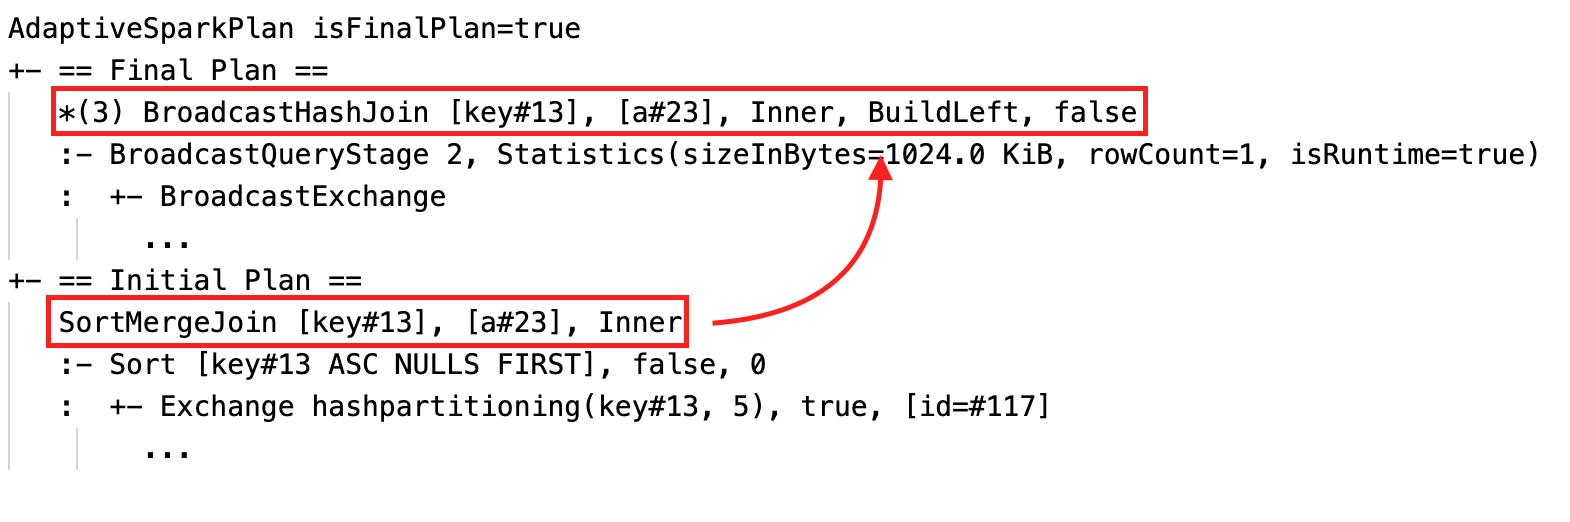
Quando o AQE aplica uma otimização, o plano de query muda. Para identificar quais otimizações entraram em vigor, compare o plano atual ou final com o plano inicial. Cada otimização altera o plano de uma forma específica:
-
Alteração da estratégia de join. O plano atual ou final tem um nó de join físico diferente do plano inicial.
-
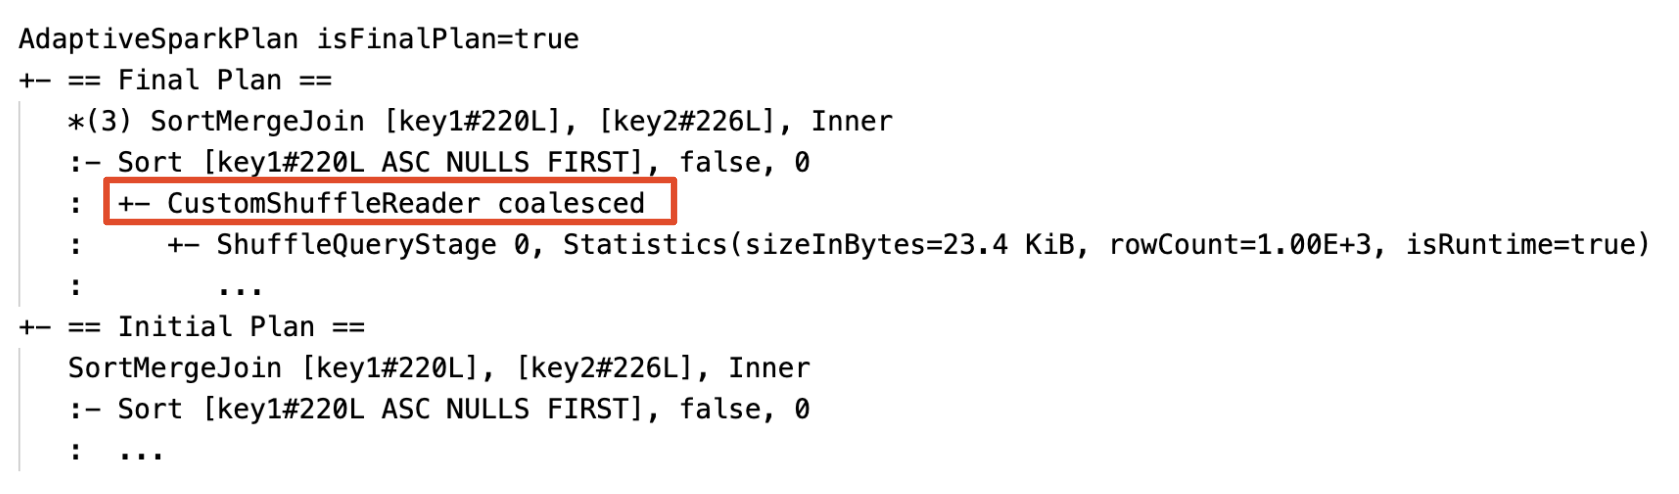
Coalescência de partição. O plano contém um nó
CustomShuffleReadercom a propriedadeCoalesced.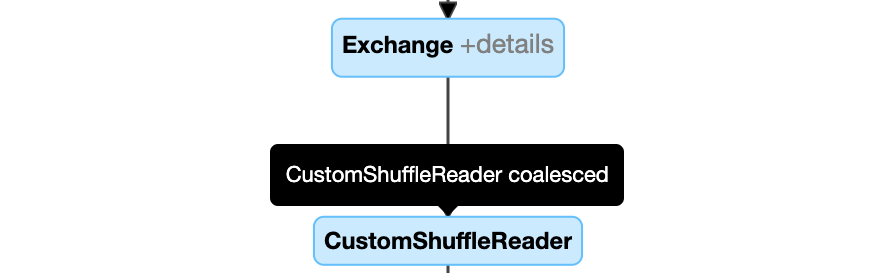
-
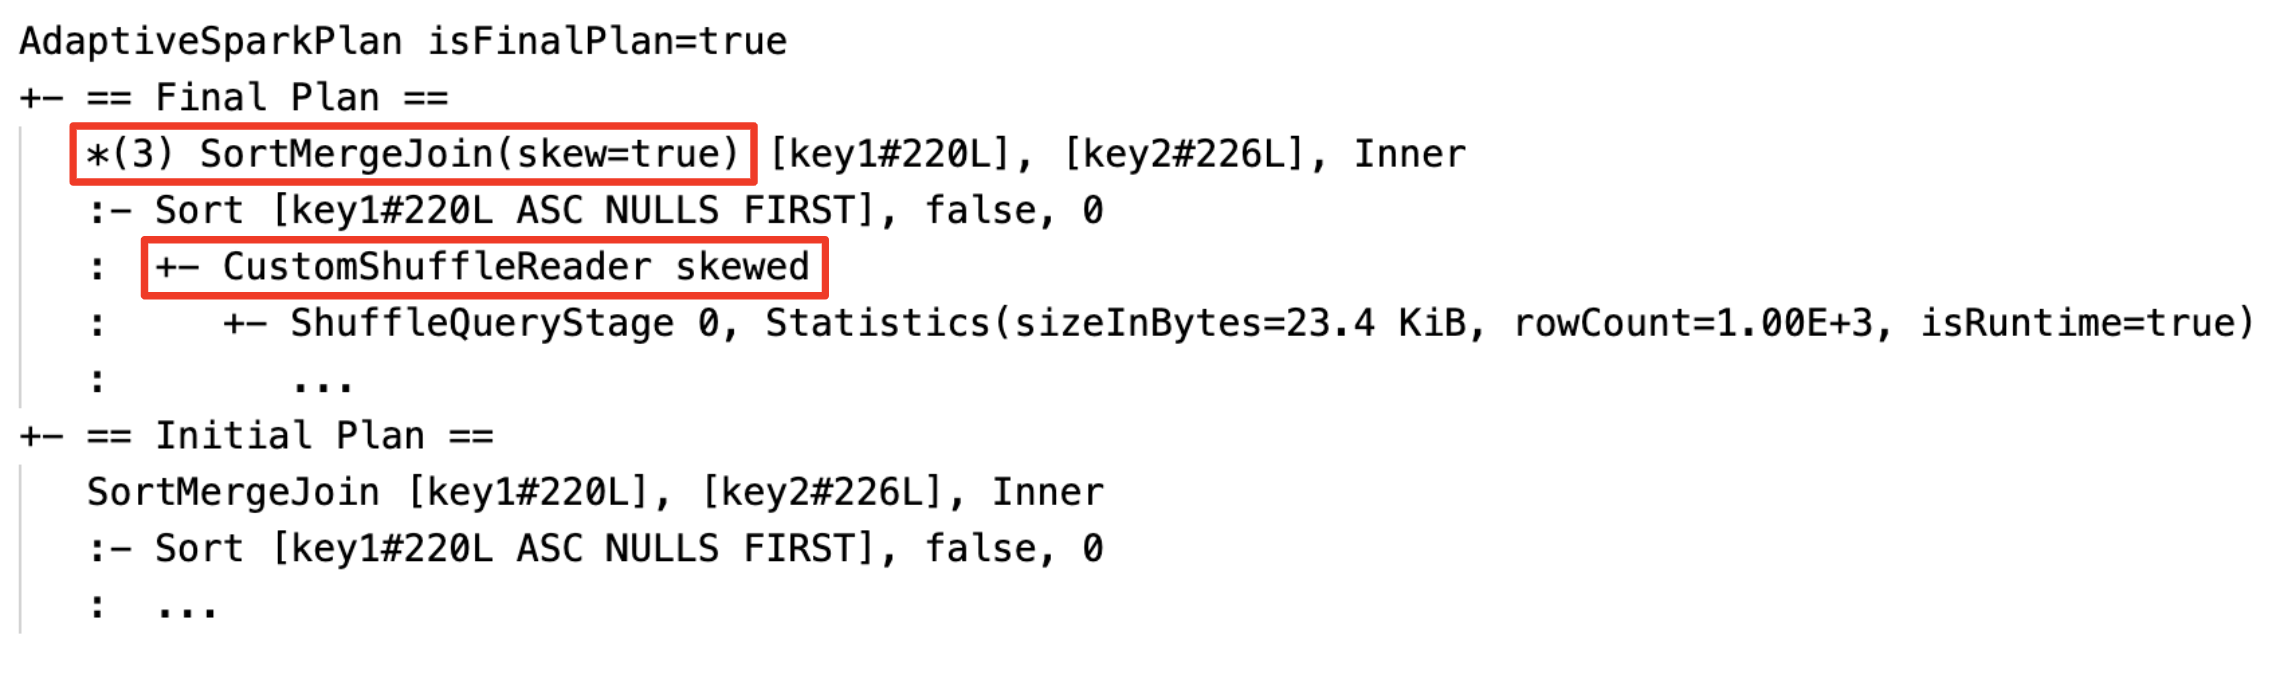
Tratamento de join de inclinação. O plano contém um nó
SortMergeJoincom o campoisSkewdefinido comotrue.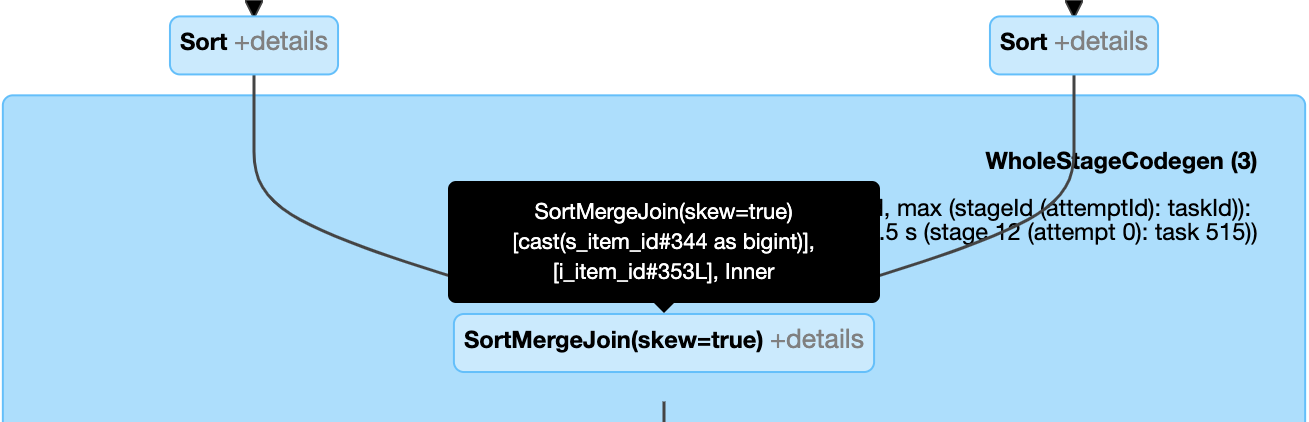
-
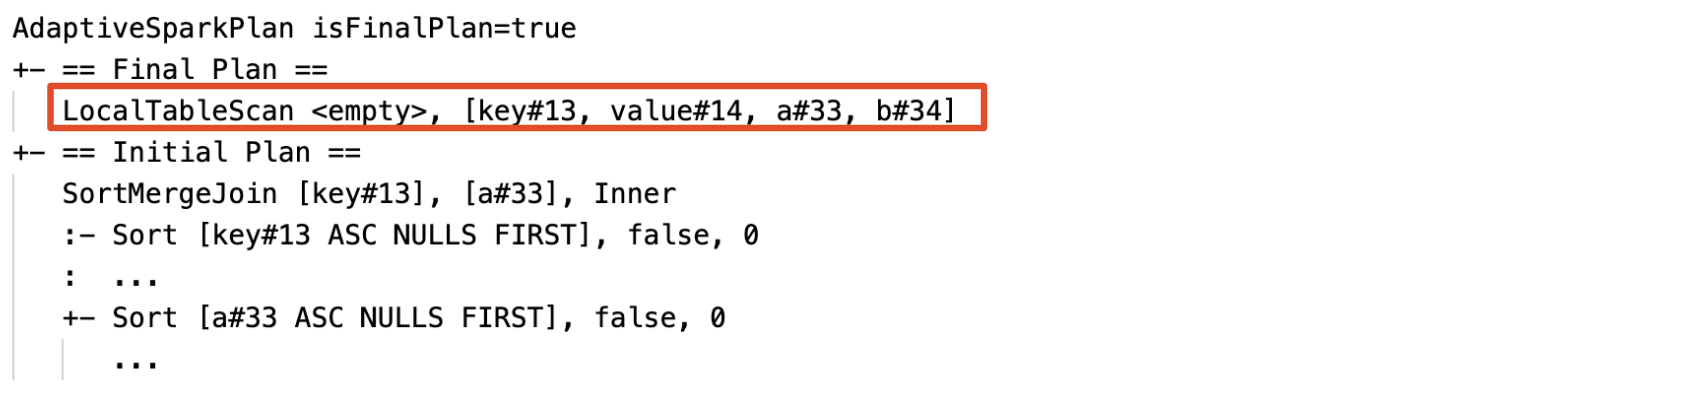
Propagação de relação vazia. Um nó
LocalTableScancom um campo de relação vazio substitui parte ou todo o plano.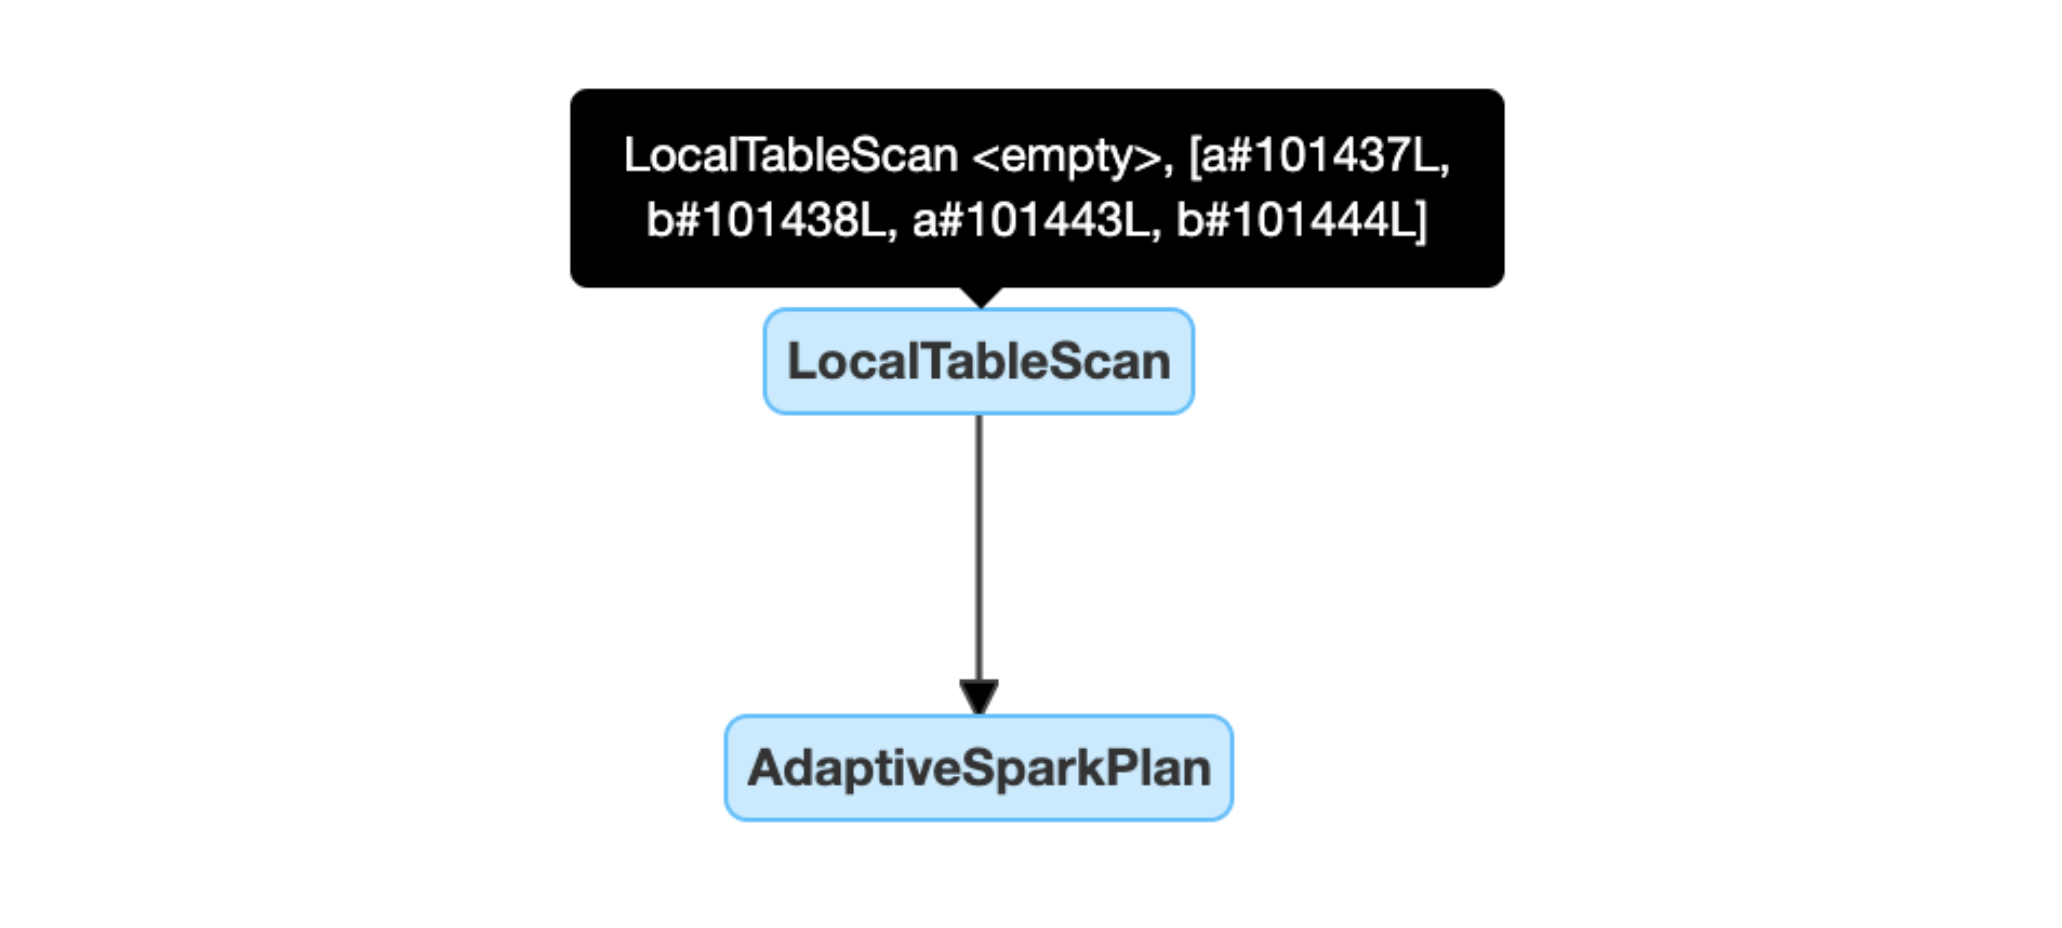
Configuração
Essas propriedades de configuração do Apache Spark controlam o AQE. A maioria das cargas de trabalho não precisa alterar os default.
Ativar AQE e ajustar otimizações individuais
Use estas propriedades para ativar ou desativar o AQE e para ajustar o embaralhamento otimizado automaticamente, a alternância de join de broadcast e a propagação de relação vazia:
Propriedade | Tipo | Padrão | Descrição |
|---|---|---|---|
|
|
| Ativa ou desativa a execução de query adaptável. |
|
|
| O número default de partições a usar quando se embaralham dados para joins ou agregações. Defina-o como Para Structured Streaming, você não pode alterar esse valor entre reinicializações de query a partir da mesma localização de ponto de verificação. |
|
|
| O limite de tamanho para alternar um sort merge join para um broadcast hash join em Runtime. |
|
|
| Ativa ou desativa a propagação de relação vazia dinâmica. |
Coalesça partições dinamicamente
Propriedade | Tipo | Padrão | Descrição |
|---|---|---|---|
|
|
| Ativa ou desativa a coalescência de partição. |
|
|
| O tamanho de destino após a coalescência. Partições coalescidas estão próximas desse tamanho, mas não são maiores. |
|
|
| O tamanho mínimo das partições após a coalescência. As partições coalescidas não são menores que este tamanho. |
|
| Duas vezes o número de núcleos do cluster | O número mínimo de partições após a coalescência. Não defina esta propriedade, pois defini-la sobrescreve |
Manipular dinamicamente a distorção join
Propriedade | Tipo | Padrão | Descrição |
|---|---|---|---|
|
|
| Ativa ou desativa o tratamento de join de inclinação. |
|
|
| O multiplicador para o tamanho da partição mediana que uma partição deve exceder para ser considerada distorcida. |
|
|
| O tamanho mínimo que uma partição deve exceder para ser considerada distorcida. |
O AQE trata uma partição como distorcida somente quando ambas as condições são verdadeiras: (partition size > skewedPartitionFactor * median partition size) e (partition size > skewedPartitionThresholdInBytes).
Perguntas frequentes (FAQ)
Por que a AQE não transmitiu uma pequena tabela join?
Se a tabela for menor que spark.databricks.adaptive.autoBroadcastJoinThreshold mas o AQE não transmiti-la, verifique estas causas:
- O tipo de join não suporta broadcast. Alguns tipos de join não podem fazer broadcast de um lado. Por exemplo, o AQE não pode fazer broadcast do lado esquerdo de um
LEFT OUTER JOIN. - A tabela tem muitas partições vazias. A maioria das tarefas no sort merge join termina rapidamente, ou o tratamento de skew join otimiza o join. O AQE não altera um sort merge join para um join de hash de broadcast se a porcentagem de partições não vazias for menor que
spark.sql.adaptive.nonEmptyPartitionRatioForBroadcastJoin.
Ainda devo usar uma dica de join de transmissão com o AQE ativado?
Sim, se você conhece bem sua query. Um broadcast join que o otimizador planeja antes de a query ser executada geralmente tem um desempenho melhor do que um que o AQE planeja em runtime. O AQE pode não mudar para um broadcast join até depois de embaralhar ambos os lados do join, que é quando ele aprende os tamanhos reais da tabela.
O AQE respeita as dicas de query da mesma forma que a otimização estática e ainda aplica as otimizações dinâmicas que as dicas não afetam.
Devo usar a dica de skew join ou o tratamento de skew join do AQE?
Use o tratamento de join de inclinação do AQE. É automático e geralmente tem melhor desempenho do que a dica join de inclinação.
Por que o AQE não reordenou meus joins?
O AQE não reordena joins durante o Runtime. Para melhorar a ordem de join, colete estatísticas da tabela para que o otimizador baseado em custo possa escolher um plano melhor. Consulte Otimizador baseado em custos.
Por que o AQE não detectou minha distorção de dados?
O AQE trata uma partição como inclinada apenas quando ambas as condições são verdadeiras:
- A partição é maior que
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes(default256MB). - A partição é maior que
spark.sql.adaptive.skewJoin.skewedPartitionFactor(default5) vezes o tamanho mediano da partição.
O AQE também lida com a inclinação apenas em join baseados em embaralhamento, que são join de sort merge e join de shuffle hash. Ele nunca otimiza a inclinação em junções de transmissão. Para joins baseados em embaralhamento, o tipo de join determina qual lado o AQE pode otimizar:
Tipo de join | Otimizado para skew no lado esquerdo | Otimizado para skew no lado direito |
|---|---|---|
| Sim | Sim |
| Sim | Sim |
| Sim | Não |
| Não | Sim |
| Sim | Não |
| Sim | Não |
| Não | Não |
Legado
O Spark 1.6 apresentou um recurso chamado execução adaptável, mas o AQE no Spark 3.0 é um recurso diferente. A execução adaptável do Spark 1.6 apenas coalesce partições dinamicamente. O AQE é uma estrutura que planeja e replaneja queries com base em estatísticas de runtime e é compatível com todas as otimizações nesta página.