Trabalho falho ou executor removido
Jobs com falha e executores removidos custam tempo. Quando um executor é removido, o Spark executa novamente suas tarefas não concluídas. Quando um job do Spark falha, a query ou tarefa que realiza a execução do job também falha. Use esta página para descobrir por que os jobs falham ou os executores são removidos e para decidir se o comportamento é esperado ou um problema a ser corrigido.
Use esta página quando a linha do tempo dos jobs mostrar jobs com falha ou executores removidos, por exemplo:
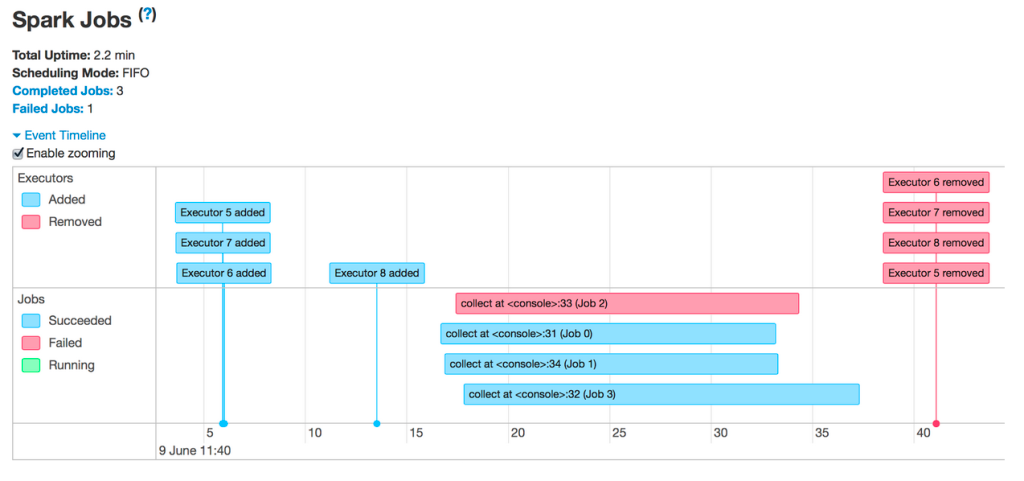
Se a linha do tempo não mostrar jobs com falha ou executores removidos, revise a linha do tempo de jobs para outros padrões e use as outras páginas neste guia para diagnosticar o problema. Consulte Diagnosticar problemas de custo e desempenho usando a Spark UI.
Os motivos mais comuns para a remoção do executor são:
- autoscale : Nesse caso, isso é esperado e não é um erro. Consulte Ativar escala automática.
- Perdas de instância Spot : O provedor de cloud está reivindicando suas VMs. Veja Perda de instâncias Spot.
- Executores ficando sem memória : Consulte Problemas de memória do Spark.
Trabalho fracassado
Se você encontrar algum job com falha, clique nele para abrir sua página. Em seguida, role para baixo para ver o estágio que falhou e o motivo da falha:
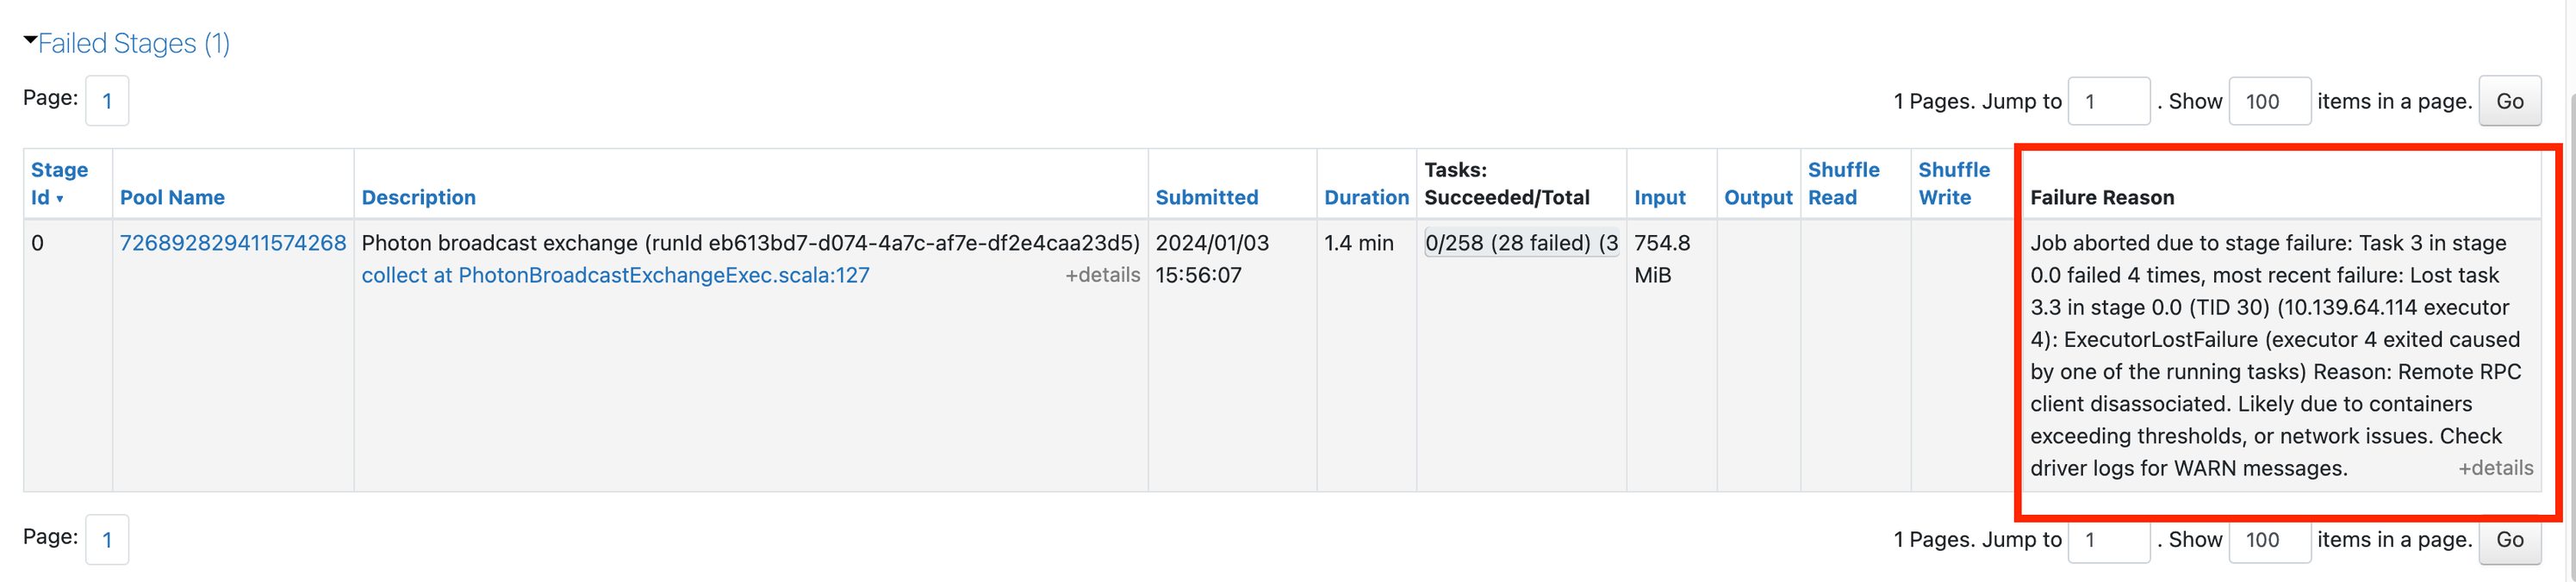
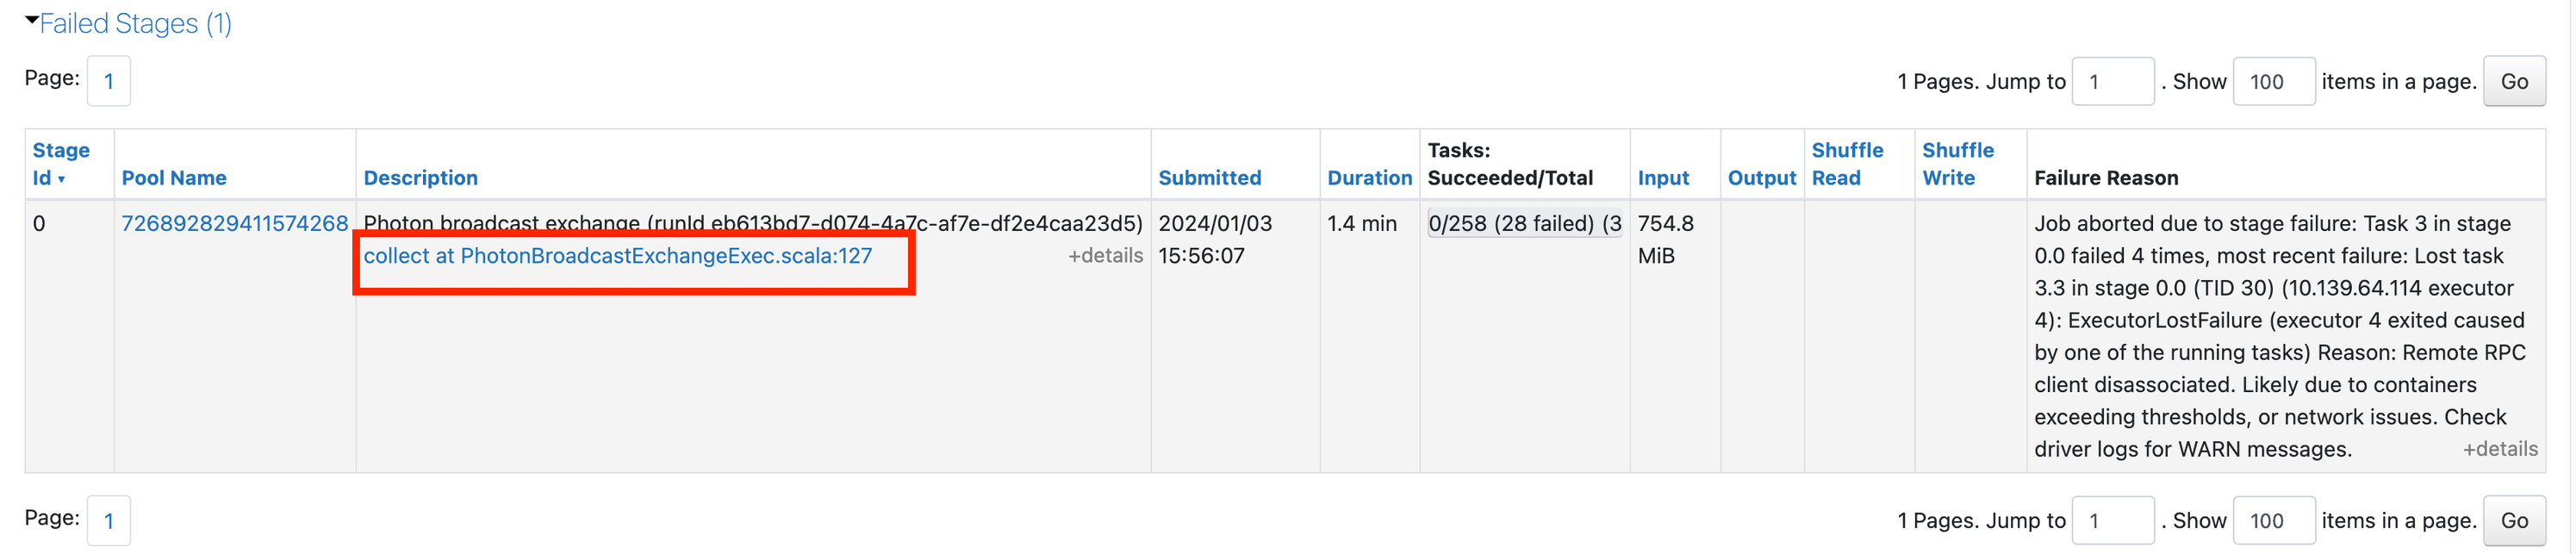
Você pode obter um erro genérico. Clique no link na descrição para ver mais detalhes:
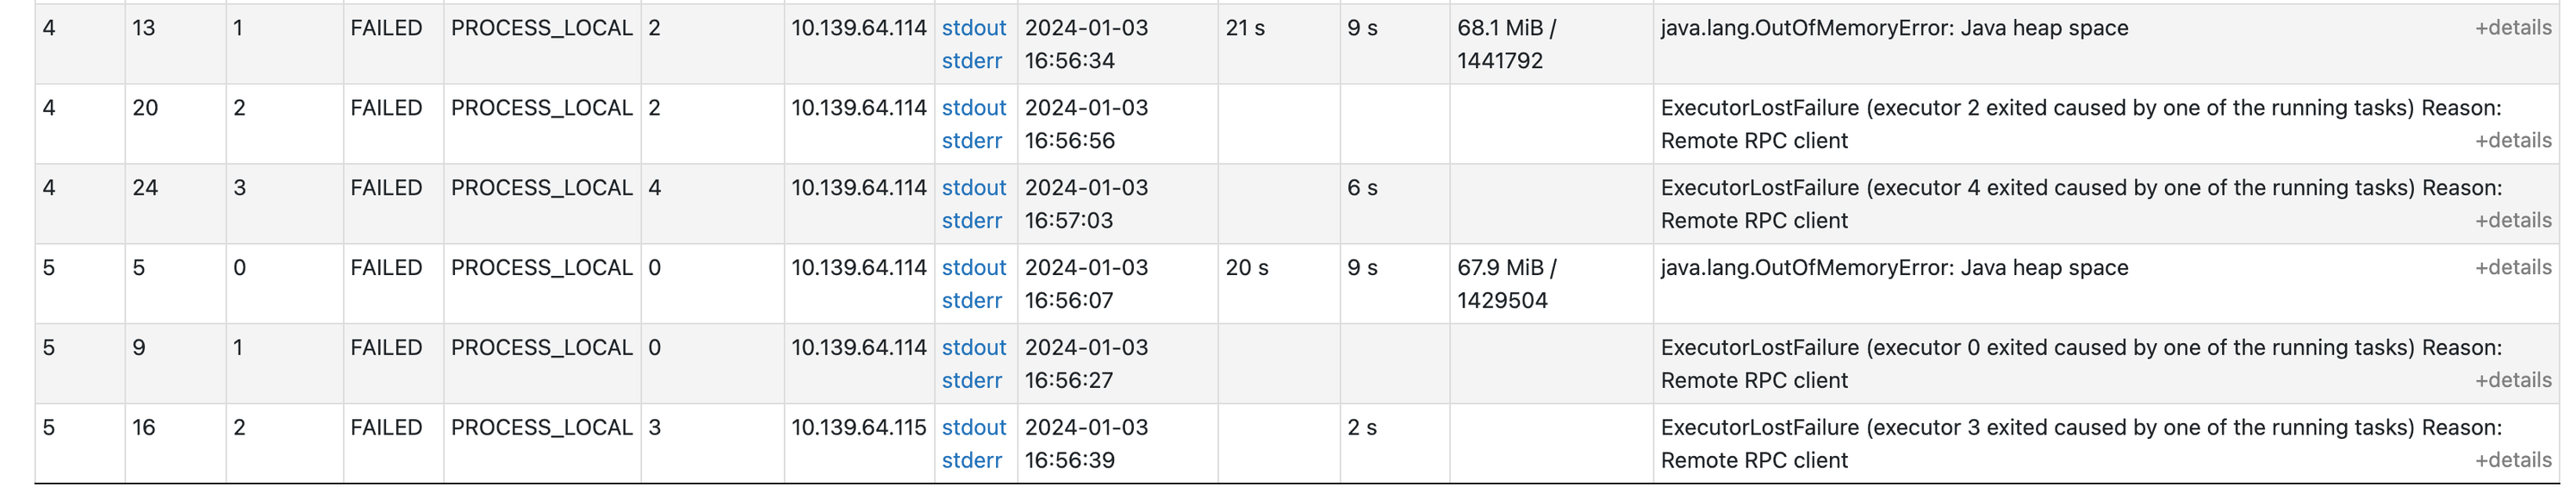
Se você rolar a página para baixo, verá por que cada tarefa falhou. Nesse caso, um problema de memória parece ser a causa:
Executor falho
Para descobrir por que seus executores estão falhando, verifique primeiro o Logs de eventos do compute para ver se há uma explicação para as falhas do executor. Por exemplo, se você estiver usando instâncias spot, o provedor de cloud pode estar recuperando-as.
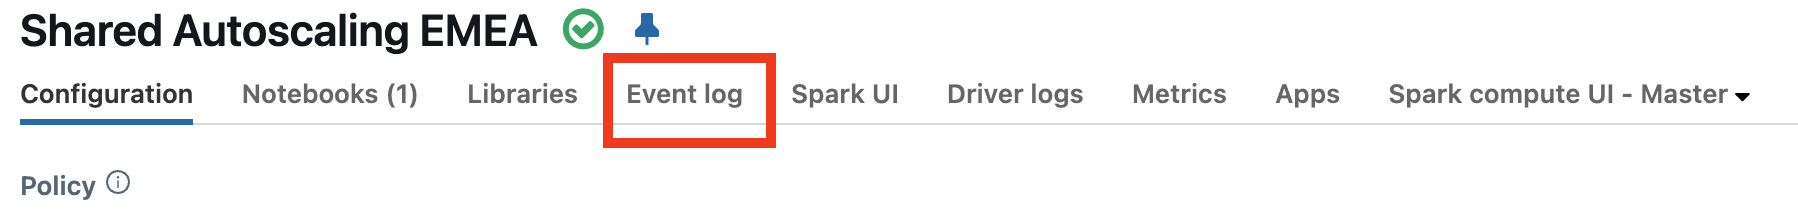
Procure eventos que expliquem a perda de executores. Por exemplo, você pode ver mensagens indicando que o cluster está sendo redimensionado ou que as instâncias spot estão sendo perdidas.
- Se você estiver usando instâncias spot, consulte Perder instâncias spot.
- Se seu compute foi redimensionado com autoscale, isso é esperado e não é um erro. Consulte Ativar autoscale.
Se você não vir nenhuma informação no log de eventos, retorne ao Spark UI e clique na tab executores :
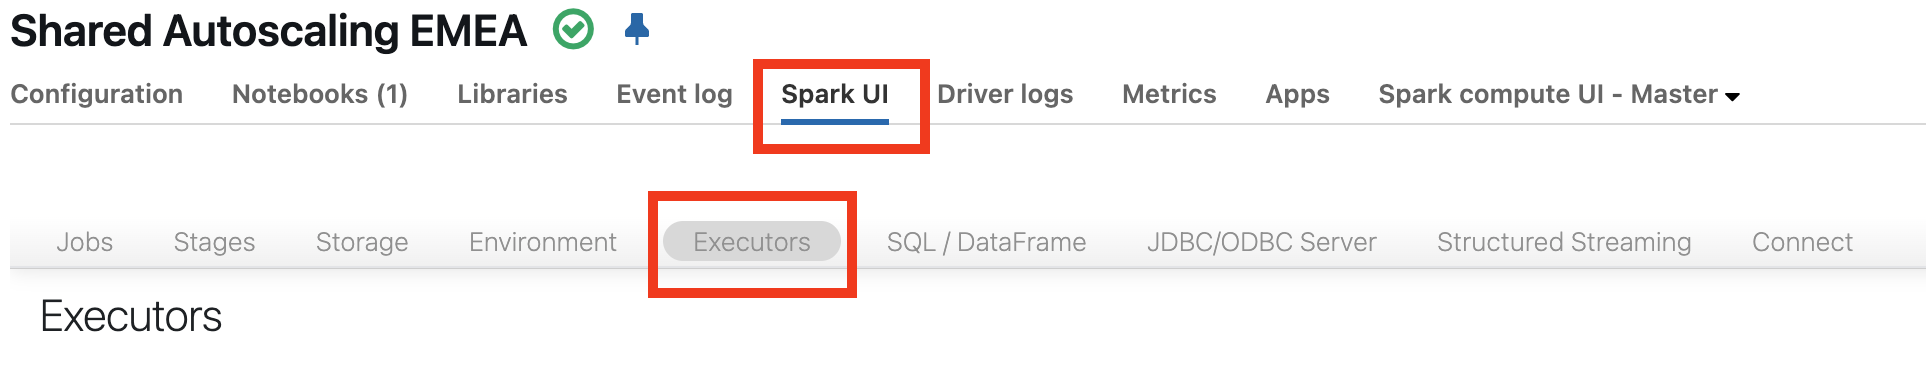
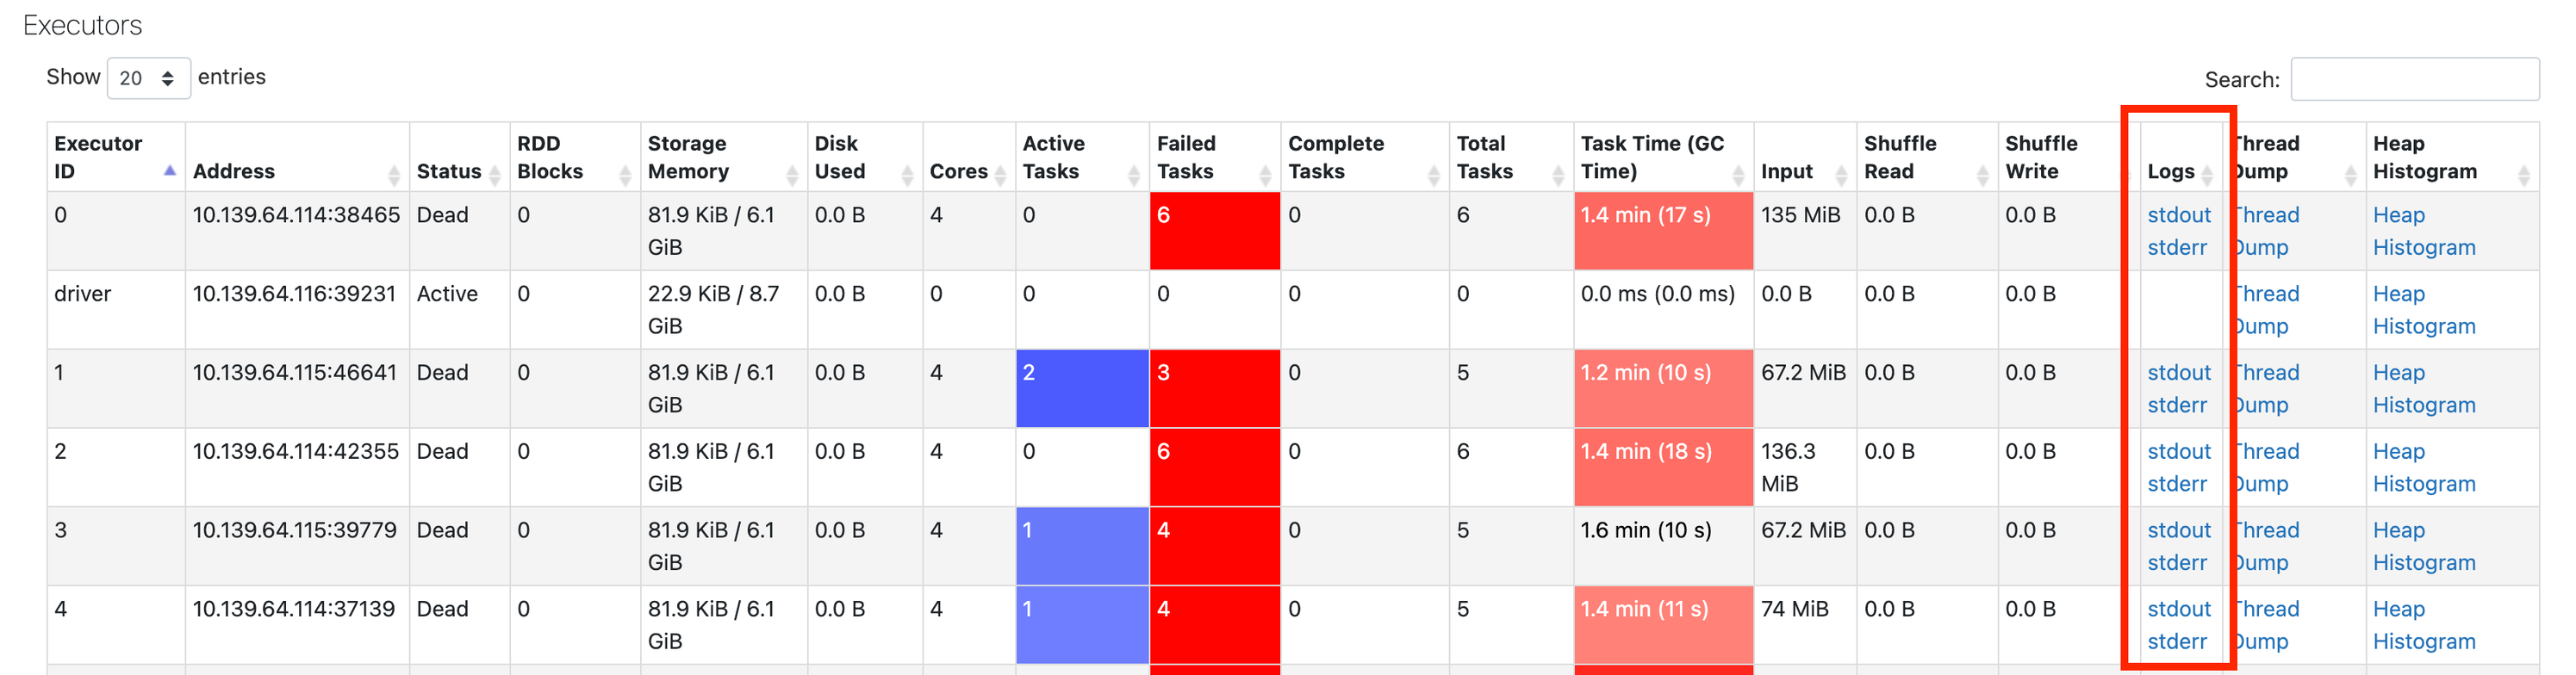
Aqui o senhor pode obter o logs do executor que falhou:
Próxima etapa
Se você chegou até aqui, a explicação mais provável é um problema de memória. A próxima etapa é investigar os problemas de memória. Consulte Problemas de memória do Spark.