Spark estágio I/O alto
Um estágio pode estar lento porque processa mais dados do que o cluster pode ler, gravar ou rearranjar no tempo disponível. Para corrigir um estágio limitado por E/S:
- Reduza a quantidade de dados que a fase processa.
- Acelere a forma como o estágio lê e grava dados.
- Adicionar capacidade de compute.
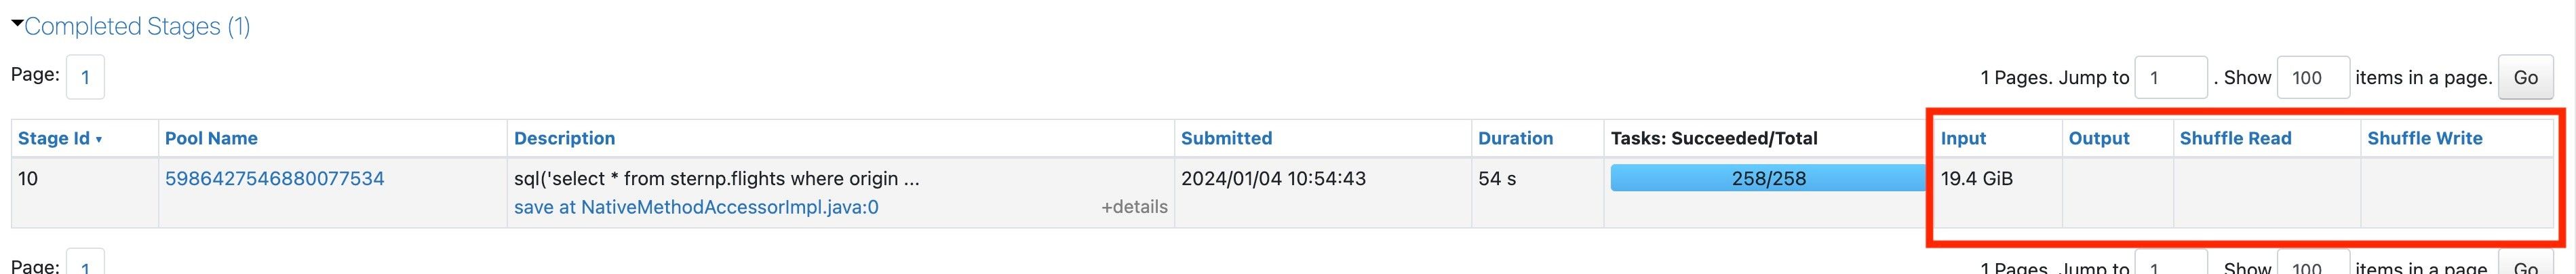
Use esta página depois de descartar inclinação e spill no estágio mais longo. As colunas de I/O do estágio mostram se o estágio está limitado a I/O e, se estiver, se o gargalo é de entrada, saída ou embaralhamento.
Revise as colunas de I/O para o estágio mais longo:
O que é alta E/S?
Cada núcleo de CPU pode ler e escrever cerca de 3 MB por segundo. Para verificar se o E/S de um estágio está alto, compare seu throughput por núcleo com essa taxa:
- Encontre o valor mais alto nas colunas de E/S do estágio.
- Divida esse valor pelo número total de núcleos de CPU em todos os workers.
- Divida o resultado pela duração do estágio em segundos.
Se o resultado for cerca de 3 MB por segundo, o estágio pode ser limitado por E/S.
Alta entrada
Se a coluna de entrada for grande, o estágio gasta muito tempo lendo dados. Para descobrir qual tabela ou arquivos o estágio lê, consulte Identificar uma leitura cara no SQL DAG. Depois, tente estas abordagens para acelerar as leituras:
- Armazene os dados em tabelas Delta.
- Use cluster líquido para melhorar a pular dados.
- Habilite o Photon, o que pode acelerar as leituras, especialmente para tabelas amplas.
- Torne a query mais seletiva para que ela leia menos dados.
- Reconsidere a disposição dos dados para que pular dados seja mais eficaz.
- Se o estágio ler os mesmos dados várias vezes, use o cache em disco.
- Se o estágio fizer a execução de um join, verifique se a remoção dinâmica de arquivos se aplica.
- Aumente o tamanho do cluster ou use compute serverless.
Alto rendimento
Se a coluna de saída for grande, o estágio levará muito tempo para gravar os dados. Experimente estas abordagens:
-
Reduza regravações. Para verificar se o estágio reescreve dados, consulte Determinar se o Spark está reescrevendo muitos arquivos. Se o estágio reescrever muitos dados:
- Se a gravação for um merge, otimize o merge.
- Use vetores de exclusão para marcar as linhas existentes como removidas ou alteradas sem reescrever o arquivo Parquet.
-
Habilite Photon, que pode acelerar as gravações.
-
Aumente o tamanho do cluster ou use compute serverless.
Embaralhamento alto
Se a coluna Leitura aleatória ou Gravação aleatória for grande, o estágio gastará muito tempo embaralhando dados entre executores para joins ou agregações. Para reduzir o tempo de embaralhamento, o Databricks recomenda definir spark.sql.shuffle.partitions como auto para que o Spark defina o número de partições de embaralhamento com base no plano da query e no tamanho dos dados de entrada. Consulte configuração do AQE.
Sem E/S alta
Se nenhuma das colunas de E/S for grande, o estágio será lento por outro motivo. Para encontrar a causa, consulte Estágio Spark lento com pouca E/S.