Identificar uma leitura cara na DAG SQL
Quando um estágio passa a maior parte do tempo lendo dados, descubra qual tabela ou arquivos ele lê antes de otimizar a leitura. A página de estágio mostra quantos dados um estágio lê, mas não de onde eles vêm. O SQL DAG conecta o estágio à varredura que lê os dados.
Use esta página quando o estágio mais longo tiver alta entrada. Se a entrada do estágio não for alta, verifique sua saída e shuffle em E/S alta de estágio do Spark e use as outras páginas neste guia para diagnosticar o problema. Consulte Diagnosticar problemas de custo e desempenho usando o Spark UI.
Chegando ao DAG
Para encontrar o scan que lê os dados:
-
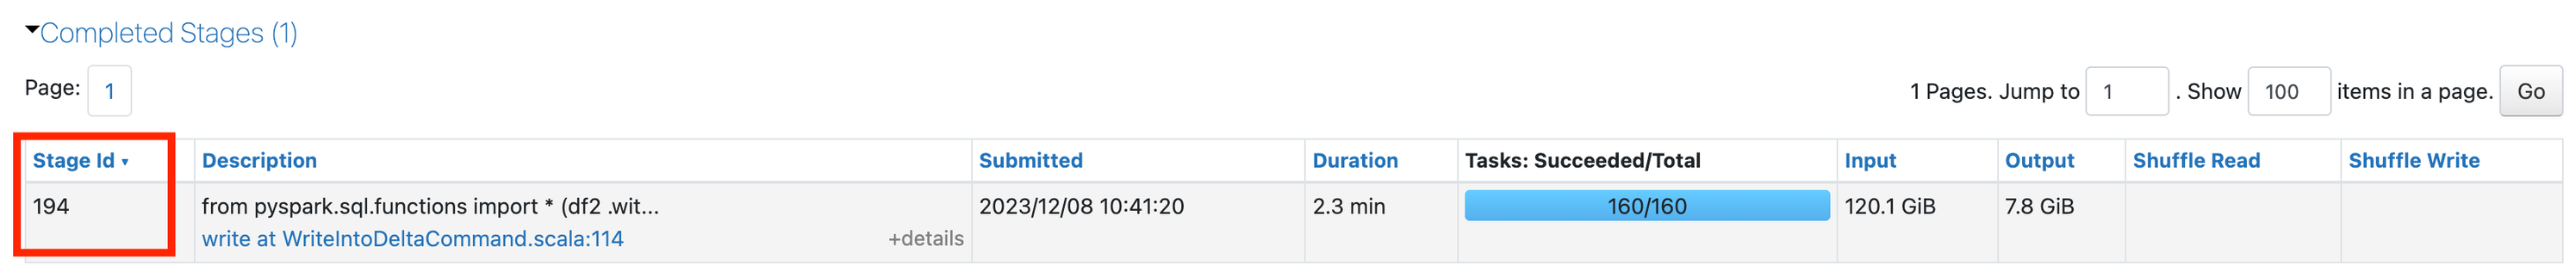
Na página do job, observe o ID do estágio que executa a leitura. Neste exemplo, o ID do estágio é 194:
-
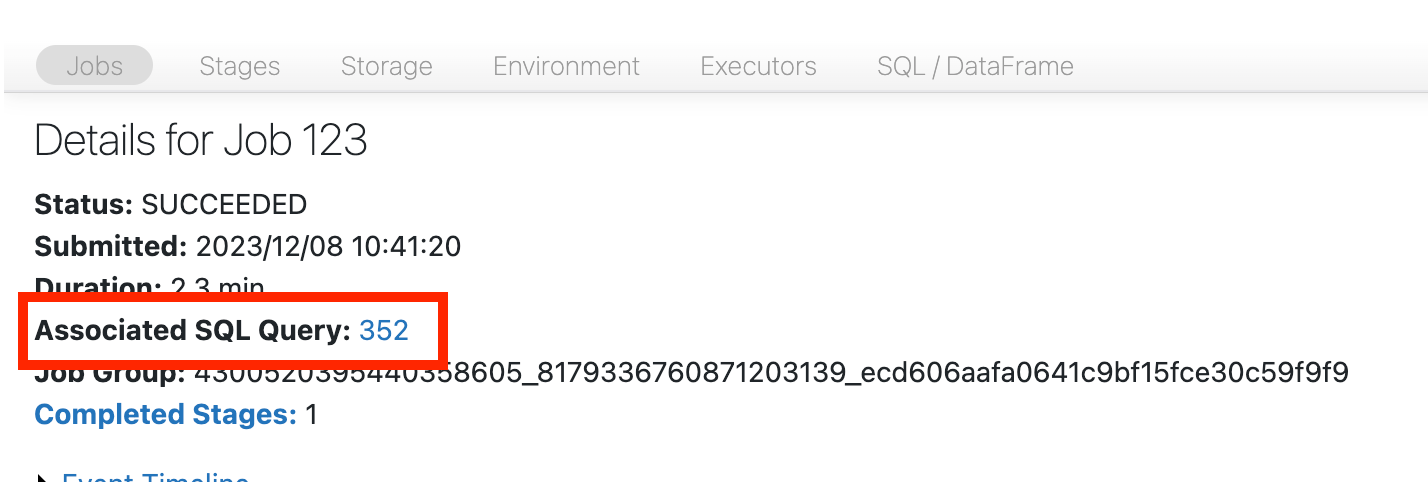
Role até o topo da página do job e clique em Associated SQL Query :
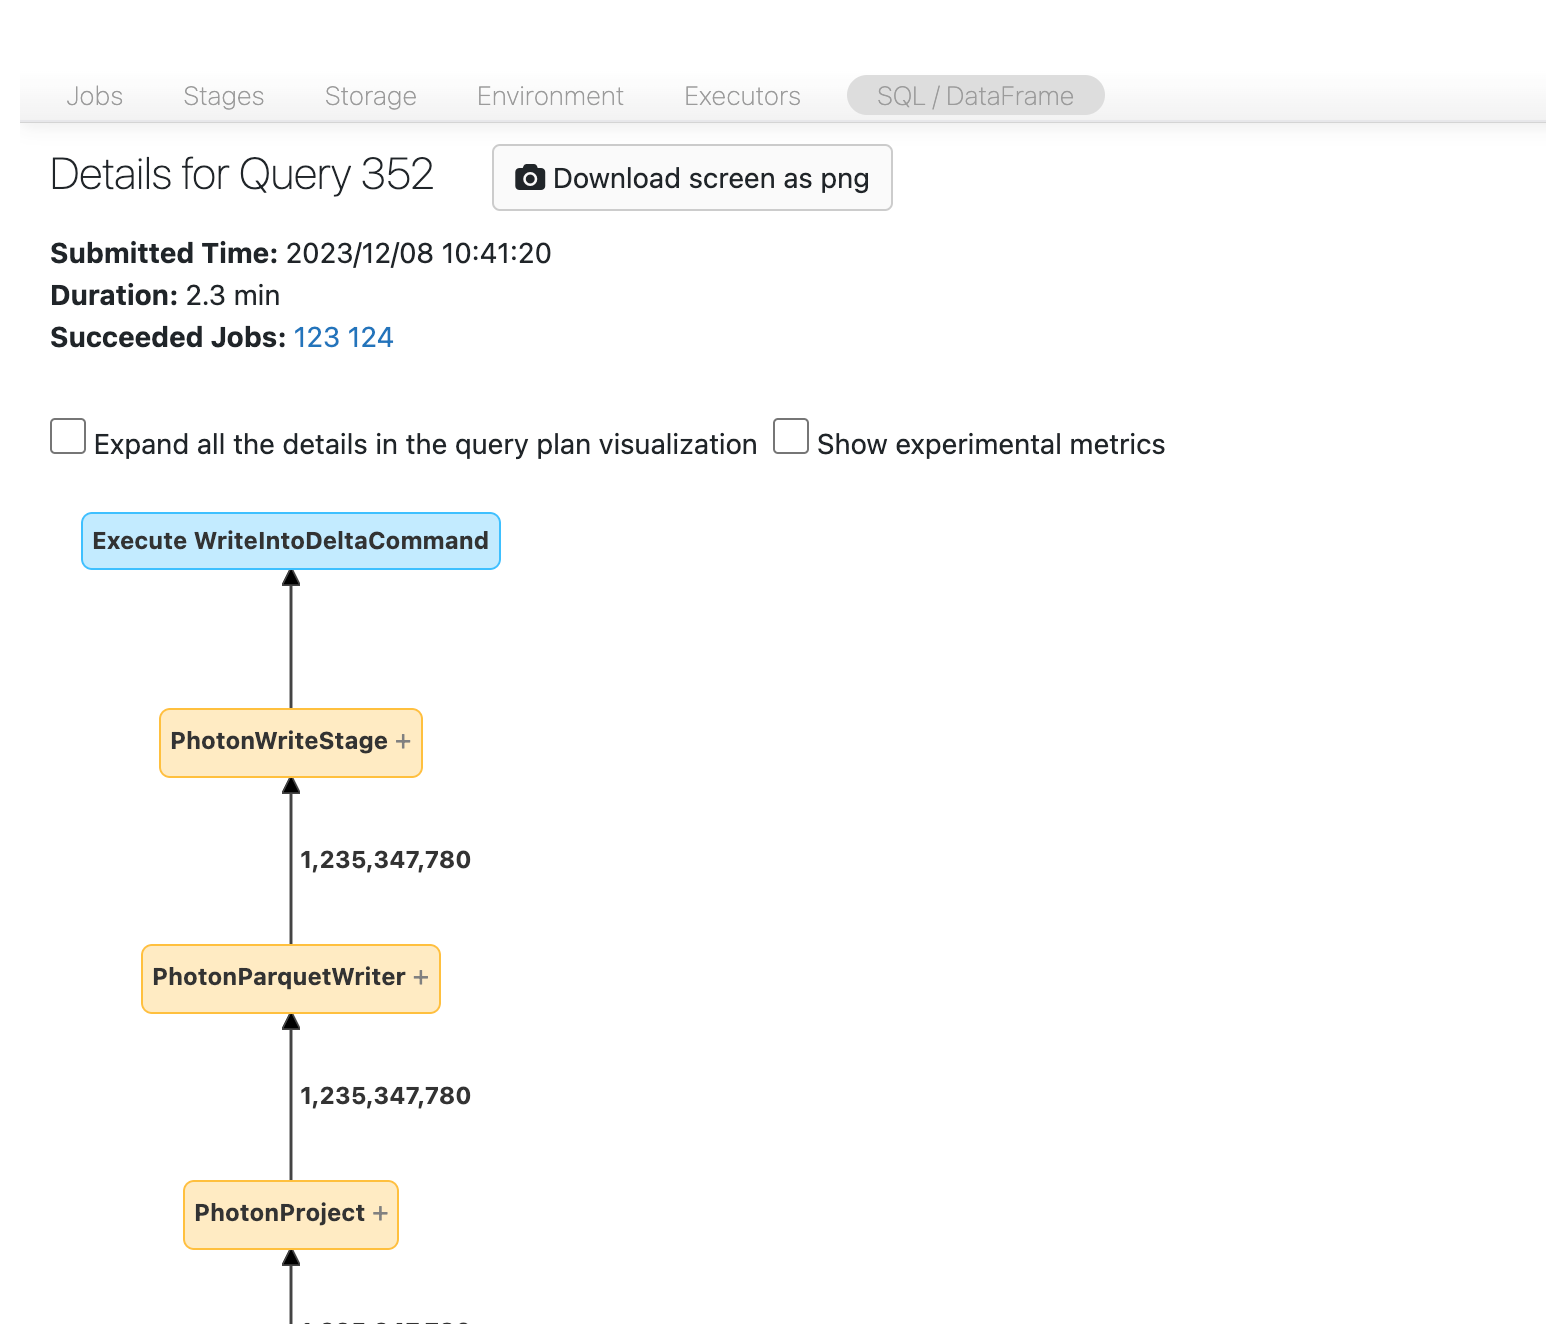
O SQL DAG aparece. Se não, role para encontrá-lo:
-
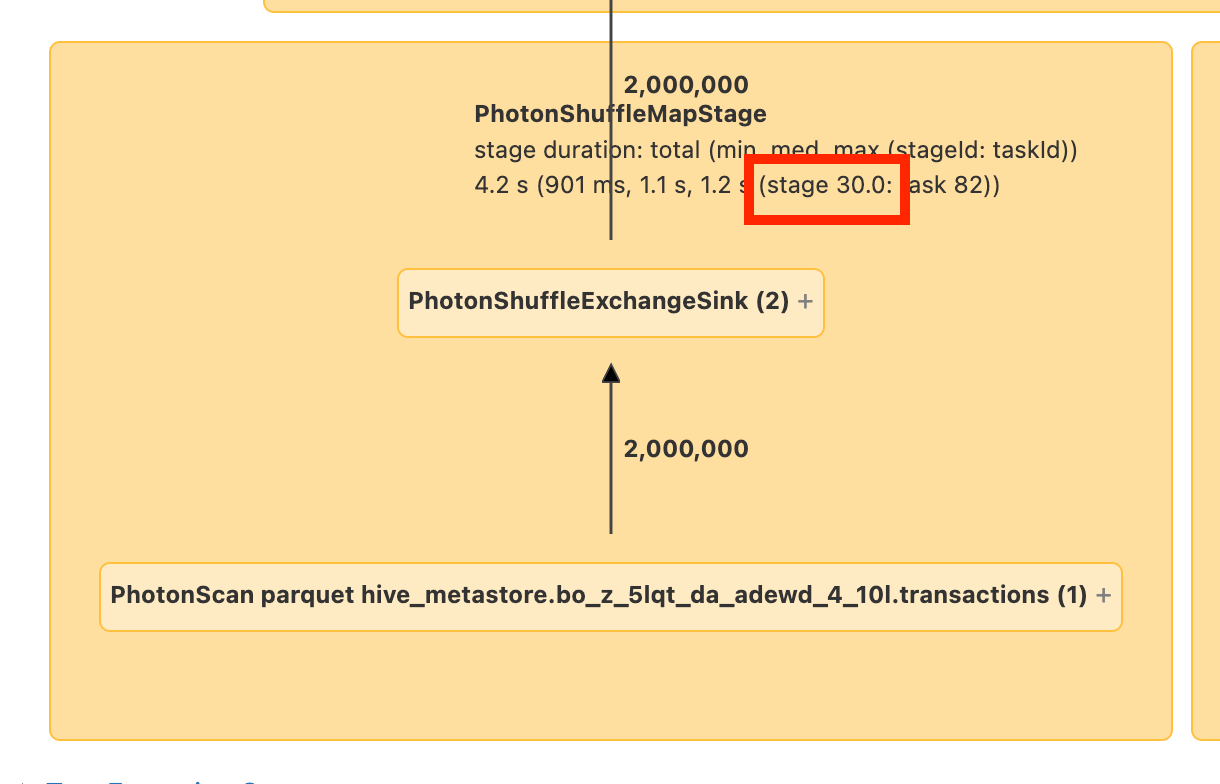
Encontre o estágio no DAG. Se o DAG não deixar a fonte de dados clara, procure o nó com o rótulo do ID do estágio que você anotou:
-
Localize o nó Scan para esse estágio. Neste exemplo, o estágio lê uma tabela denominada
transactions: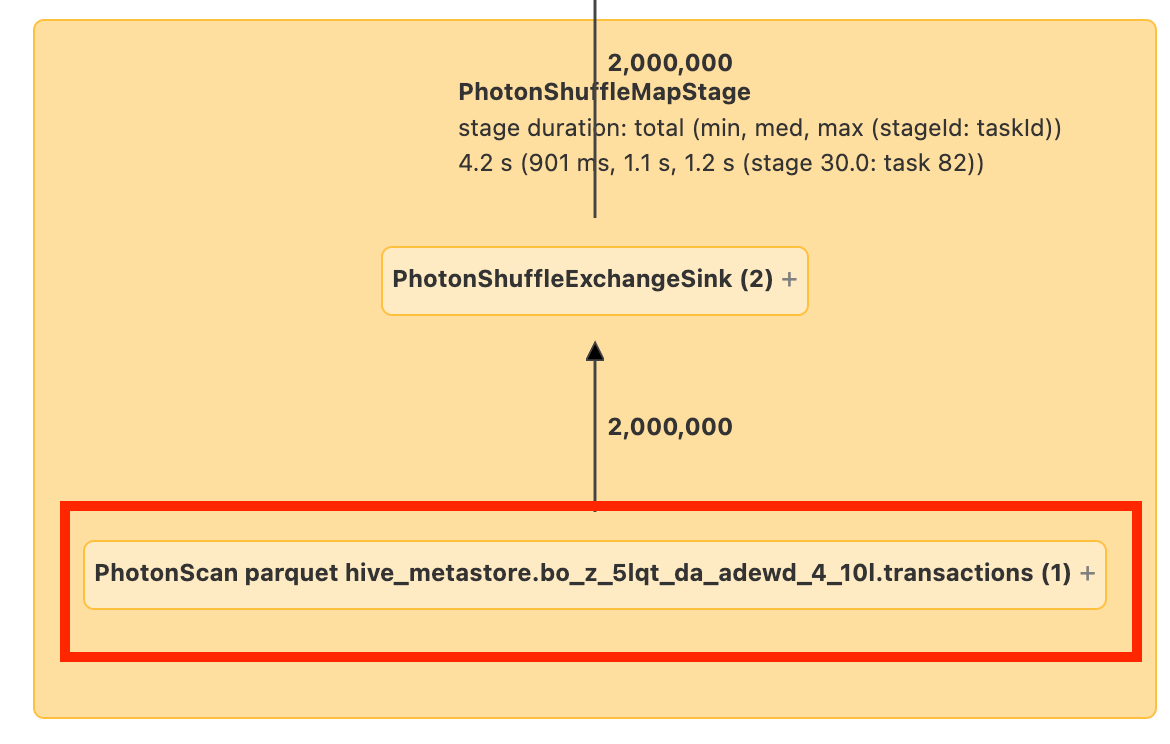
Para ver a localização dos dados que o nó lê, clique ou passe o mouse sobre o nó.
Próximo o passo
Depois de identificar os dados que o estágio lê, escolha uma abordagem para reduzir ou acelerar a leitura. Consulte Alta entrada.