Classification
Vous pouvez utiliser la Classification pour classer vos documents dans des catégories prédéfinies avec l'IA.
Exemples de classification :
- Classer les transcriptions d'appels clients par intention
- Classification des documents par type de contenu
- Classification des avis sur les produits par sentiment
La classification est disponible via l’ interface utilisateur d’Agent Bricks, en SQL, avec l’ API REST et avec l’ API asynchrone ( bêta).
Créer un agent de classification dans l'interface utilisateur
Exigences
Accédez à  **Agents** dans le volet de navigation de gauche de votre workspace. Cliquez sur Créer un agent , et sélectionnez Classification de texte .
Étape 1. Sélectionnez vos données source
Utilisez Classification pour classer vos documents.
-
Sélectionnez vos données source. Vous pouvez sélectionner un volume avec des documents ou une table avec des données textuelles.
-
Cliquez sur Créer l'agent .
Étape 2. Configurer les étiquettes de classification
Une fois que la Classification a traité vos données, configurez et affinez vos étiquettes de classification.
Pour ajouter manuellement des étiquettes de classification :
- Cliquez sur **+ Ajouter une étiquette** pour ajouter une étiquette de classification.
- Saisissez le nom de l'étiquette et une description facultative, puis cliquez sur Ajouter une étiquette .
- Répétez de 1 à 2 pour chaque étiquette que vous souhaitez ajouter.
- (Facultatif) Activez **Plusieurs étiquettes** si vous souhaitez que l'agent retourne plus d'une étiquette.
Pour importer des étiquettes à partir d'une table :
- Cliquez sur Importer depuis une table .
- Sélectionnez la table et cliquez sur Suivant .
- Sélectionnez la colonne d’étiquette, la colonne de description et le SQL Warehouse.
- Cliquez sur Aperçu pour voir les étiquettes importées.
- Si vous êtes satisfait des étiquettes, cliquez sur Importer et remplacer les étiquettes .
Vous devez avoir défini au moins deux étiquettes pour exécuter la classification. Une fois que vous avez terminé d'ajouter vos étiquettes, cliquez sur Enregistrer et exécuter la classification .
Pour configurer des options supplémentaires, cliquez sur le bouton bascule des options  à côté de Enregistrer et exécuter la classification , puis activez une ou plusieurs des options suivantes :
- Scores de confiance : Affiche les niveaux de confiance pour les étiquettes prédites.
- Justifications : affiche la justification des étiquettes prédites.
La classification classe jusqu'à 5 documents et lignes et affiche les résultats. Vous pouvez en ajouter d'autres également.
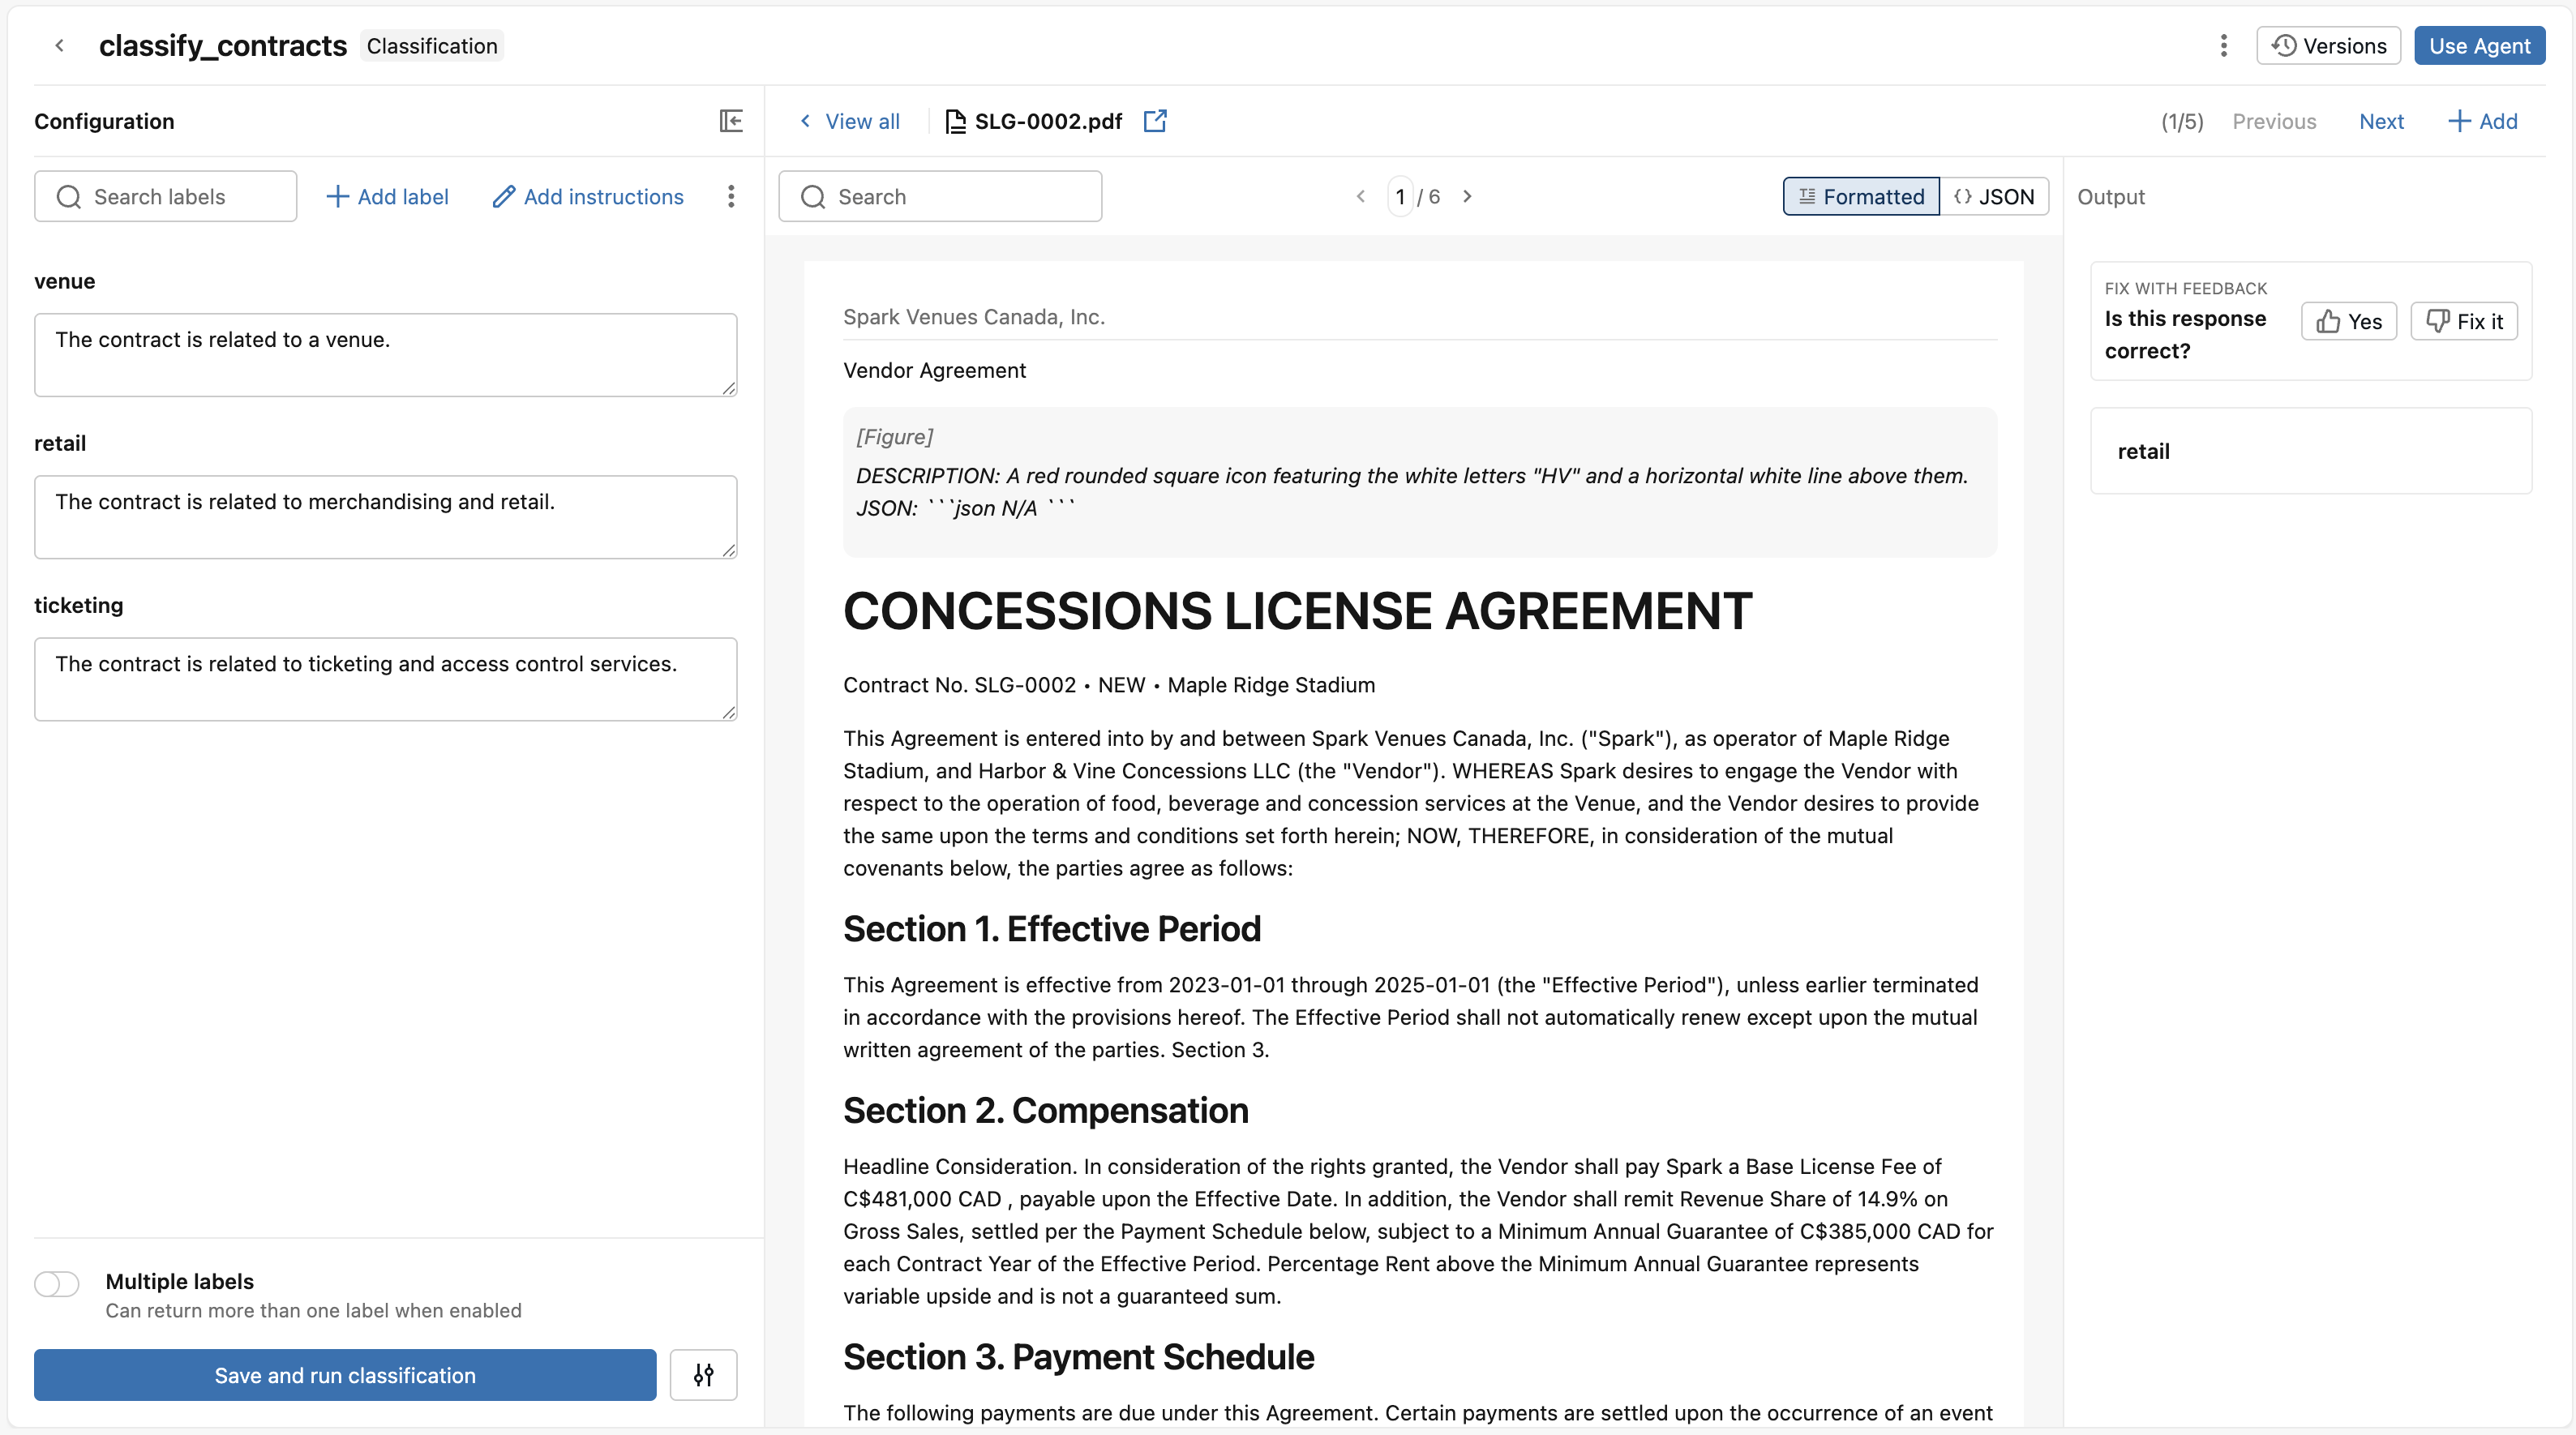
Étape 3. Examiner et améliorer les réponses de classification
Examinez les réponses de classification et donnez votre avis pour améliorer l'agent.
-
Examinez le document et la réponse de classification :
- Si la réponse est correcte, donnez un pouce levé.
- Si la réponse est incorrecte, donnez-lui un pouce vers le bas. Aidez Classification à corriger la réponse en sélectionnant l'étiquette correcte. Cliquez sur Enregistrer .
-
Pour améliorer les réponses de l'agent, ajustez les descriptions des étiquettes de classification.
-
Comparez les versions pour optimiser les performances de l'agent. Cliquez sur Versions . À côté d'une version précédente, cliquez sur Comparer pour comparer les descriptions des étiquettes de classification d'une version précédente avec la version actuelle. Cliquez sur Restaurer pour restaurer une version précédente.
Étape 4. Utilisez l'agent de classification
Si vous êtes satisfait des réponses, start à utiliser l'agent pour la classification à grande échelle.
Cliquez sur Utiliser l'Agent en haut à droite. Vous pouvez choisir l'une des options suivantes :
- **Exécuter en SQL** pour utiliser l'agent afin de classer votre volume ou votre table entière. Cela ouvre une requête SQL qui utilise
ai_classifyà l’aide des étiquettes de classification que vous avez définies. Pour plus d'informations sur l'utilisation deai_classifydans les queries SQL, consultez la fonctionai_classify. - Créez un LakeFlow Pipelines qui s’exécute à intervalles planifiés pour appeler votre agent sur de nouvelles données. Cela crée un pipeline Lakeflow qui met à jour une table de streaming avec vos données classifiées. Vous pouvez configurer le calendrier du pipeline afin qu'il s'exécute lors de l'arrivée de nouvelles données. Pour plus d'informations sur les pipelines Lakeflow, voir Spark Declarative Pipelines sur Lakeflow.
Classer les documents en SQL
Appelez ai_classify en SQL pour classer les documents à l'échelle de la montée en charge :
SELECT ai_classify(
  'My password is leaked.',
  '["urgent", "not_urgent"]',
  MAP('version', '2.1')
);
Consultez la référence SQL ai_classify.
Classify documents with the REST API
Utilisez l’API REST pour classer les documents provenant d’applications, de services et de workflows d’automatisation. Consultez les documents de l’API REST pour référence.
La limite de débit par default pour les requêtes de l’API REST ai_classify est de 1 200 requêtes par minute et par workspace. Contactez l’équipe de votre compte Databricks pour demander une limite plus élevée.
L'exemple suivant permet de classer un message du service client :
curl -X POST "$DATABRICKS_HOST/api/2.0/ai-functions/ai-classify" \
     -H "Authorization: Bearer $DATABRICKS_TOKEN" \
     -H "Content-Type: application/json" \
     -d '{
  "content": "My password is leaked.",
  "labels": ["urgent", "not_urgent"],
  "options": {
    "instructions": "Classify the support request by urgency."
  }
}'
Classifier des documents avec l'API asynchrone (Bêta)
Pour le traitement par batch, Databricks recommande les tâches de fonction IA dans Lakeflow Jobs. Pour classifier des enregistrements dans un job, utilisez une tâche ai_classify, qui effectue les opérations suivantes :
- Exécute le traitement en arrière-plan et écrit les résultats dans une table Unity Catalog, de sorte que vous ne soumettez pas de batchs, ne vérifiez pas leur statut et ne download pas de fichiers de sortie.
- Traite uniquement les lignes nouvelles ou modifiées depuis la précédente exécution.
- Affiche la progression de chaque exécution, ainsi que le nombre d’entrées traitées avec succès et en échec.
Utilisez plutôt l’API asynchrone AI Functions (bêta) si vous souhaitez intégrer le traitement dans une application existante ou un orchestrateur externe, et gérer vous-même les soumissions et les résultats.
Bêta
Cette fonctionnalité est en bêta. Pour l’utiliser, un administrateur de Workspace doit activer AI Functions Asynchronous API depuis la page Previews . Consultez Gérer les aperçus Databricks.
Pour les champs de demande et de réponse, et pour les demandes d’annulation et de liste de batchs, consultez la référence de l’API asynchrone.
Fichier d'entrée
Le fichier d'entrée d'un batch ai_classify est un fichier JSONL dans un volume Unity Catalog, avec une requête sur chaque ligne. Chaque ligne est un objet JSON contenant exactement les champs suivants :
Champ | Description |
|---|---|
| Chaîne qui identifie la demande. Chaque ligne du fichier de sortie comporte le |
| Le texte à classifier, sous la forme |
Le fichier d’entrée suivant comporte deux demandes :
{"custom_id": "ticket-001", "body": {"text": "My password is leaked."}}
{"custom_id": "ticket-002", "body": {"text": "How do I change my billing address?"}}
Le fichier d’entrée ne contient que le texte et l’ID de chaque enregistrement. Vous définissez les autres paramètres de ai_classify dans params lorsque vous créez le batch, et ils s’appliquent à chaque requête :
labels(obligatoire) : les labels pour classifier les enregistrements, sous forme de liste de labels ou d’objet associant chaque label à sa description.options: Les options de la fonction, telles queinstructionsetmultilabel.
Pour savoir à quoi sert chaque parameter, consultez la référence de l’API REST AI Classify. Dans params.options, écrivez le nom de chaque option en camelCase, par exemple enableRationales plutôt que enable_rationales.
Lorsque vous créez un batch, l’API vérifie d’abord l’ensemble du fichier d’entrée et params. Si le fichier d’entrée ou params enfreint l’une des règles suivantes, la demande échoue avec un code HTTP 400 et aucun batch n’est créé :
-
Le fichier est codé en UTF-8 et chaque ligne est un objet JSON avec exactement les champs
custom_idetbody. Le fichier ne contient aucune ligne vide. -
Chaque
custom_idest une chaîne non vide, et aucune ligne n’a le mêmecustom_id. -
Chaque
bodypossède exactement une clé,text.- Si une valeur
textn’est pas une chaîne, le batch est tout de même créé et la requête échoue avec le type d’erreurinvalid_request.
- Si une valeur
-
Le fichier contient entre 1 et 50 000 lignes et pèse au maximum 200 Mio.
- Pour traiter plus d’enregistrements, divisez-les en plusieurs fichiers d’entrée et créez un batch pour chaque fichier.
-
paramsdispose delabelset d’aucun parameter queai_classifyne prend pas en charge.
Pour un problème sur une ligne du fichier d’entrée, le message d’erreur donne le numéro de la ligne et la règle, par exemple Batch input line 3 custom_id must be unique. Si vous ne pouvez pas lire le fichier d’entrée ou écrire sur output_ref, la requête échoue avec HTTP 403.
L’API copie le fichier d’entrée lorsqu’elle crée le batch ; les modifications que vous apportez au fichier par la suite n’affectent donc pas le batch.
Exécuter un batch
Pour classer des enregistrements avec l’API asynchrone :
-
Créez le fichier d’entrée et faites-en l’upload vers un volume Unity Catalog, par exemple avec l’ API Files.
-
Créez un batch qui exécute
ai_classifysur le fichier d'entrée. Définissezinput_refsur le chemin du fichier d’entrée,paramssur les paramètres pour chaque demande etoutput_refsur un répertoire de volume ou un nouveau chemin de fichier pour le fichier de sortie:Bashcurl -X POST "$DATABRICKS_HOST/api/2.0/ai-functions/batches" \-H "Authorization: Bearer $DATABRICKS_TOKEN" \-H "Content-Type: application/json" \-d '{"endpoint": "ai_classify","input_ref": "/Volumes/my_catalog/my_schema/my_volume/requests.jsonl","params": {"labels": ["urgent", "not_urgent"],"options": {"instructions": "Classify the support request by urgency."}},"output_ref": "/Volumes/my_catalog/my_schema/my_volume/output/"}'La réponse contient le batch
name. Utilisez-le à la place de<batch-name>lors des étapes suivantes. Par default, un Workspace peut avoir jusqu’à 20 batchs inachevés à la fois, pour tous les utilisateurs. Si la limite est atteinte, la demande échoue avec HTTP 409. Recréez le batch après qu’un autre batch soit terminé ou annulé. -
Vérifiez le statut du batch. Le batch est terminé lorsque
statusestCOMPLETED,CANCELLED, ouFAILED:Bashcurl -X GET "$DATABRICKS_HOST/api/2.0/ai-functions/batches/<batch-name>" \-H "Authorization: Bearer $DATABRICKS_TOKEN"Lorsque le fichier de sortie est prêt,
output_refdans la réponse contient son chemin. -
download le fichier de sortie avec l’ API Files:
Bashcurl -X GET "$DATABRICKS_HOST/api/2.0/fs/files/Volumes/my_catalog/my_schema/my_volume/output/<batch-name>_output.jsonl" \-H "Authorization: Bearer $DATABRICKS_TOKEN" \-o output.jsonl
Fichier de sortie
L’API asynchrone écrit le fichier de sortie d’un batch ai_classify à l’emplacement dans output_ref:
- Si
output_refse termine par/ou désigne un répertoire existant, l’API écrit le fichier de sortie à l’emplacement<batch-name>_output.jsonldans ce répertoire. Plusieurs batchs peuvent partager un même répertoire de sortie. - Sinon,
output_refcorrespond au chemin du fichier de sortie. Le fichier ne doit pas exister lorsque vous créez le batch.
Le fichier de sortie possède une ligne pour chaque ligne du fichier d'entrée. Les lignes sont dans le même ordre que le fichier d'entrée. Chaque ligne possède le custom_id de sa requête et l'un des champs suivants :
response: le résultat de la demande. Il contient les mêmes champs que la réponse de l’API REST AI Classify.error: letypeet lemessagede l’erreur, si la requête a échoué. Si le batch a été annulé avant l’exécution de la requête, le type estcancelled.
L'exemple suivant montre une ligne pour une requête qui a réussi et une ligne pour une requête qui a échoué :
{"custom_id": "ticket-001", "response": {...}}
{"custom_id": "ticket-002", "error": {"type": "request_failed", "message": "..."}}
Limitations
Voir les limitations