Suivre l'utilisation des modèles
Cette page décrit comment surveiller l’utilisation des services Unity Gateway à l’aide de la table système de suivi de l’utilisation.
La table de suivi des utilisations consigne les détails des requêtes et des réponses pour les services de modèles, les services de fournisseur de modèles et les services MCP. Pour les requêtes de modèle, il enregistre des métriques telles que l’utilisation des jetons et la latence. Pour les requêtes MCP, il enregistre les métadonnées d’appel et de service. Utilisez le tableau pour surveiller les utilisateurs, suivre les coûts et analyser l’utilisation et la performance du service.
Le suivi de l'utilisation capture également les requêtes ai_query vers les services de modèles fournis par Databricks.
Les administrateurs de compte et de workspace peuvent consulter un aperçu consolidé de l'utilisation de l'IA sur la page AI du Centre de gouvernance.
Exigences
- Un workspace Databricks dans une région prise en charge par Unity Gateway.
- Unity Catalog activé pour votre workspace. Consultez Activer un workspace pour Unity Catalog.
Tarifs
Le suivi de l’utilisation est une fonctionnalité facturable de Unity Gateway. Databricks facture l’utilisation qu’il consigne dans la table system.ai_gateway.usage. Voir les tarifs de Unity Gateway.
Query la table d'utilisation
Unity Gateway Logs les données d’utilisation dans la table système system.ai_gateway.usage. Vous pouvez visualiser la table dans l'interface utilisateur, ou query la table depuis Databricks SQL ou un Notebook.
Les rôles d'administrateur de compte et de métastore sont tous deux requis pour afficher ou effectuer une query sur la table system.ai_gateway.usage par default. Les administrateurs peuvent gérer l'accès aux tables système pour contrôler les autorisations des utilisateurs, des groupes et des Service Principal.
Pour visualiser la table dans l'interface utilisateur, cliquez sur le link de la table de suivi d'utilisation sur la page du service de modèle pour ouvrir la table dans Catalog Explorer.
Pour interroger la table à partir de Databricks SQL ou d'un Notebook :
SELECT * FROM system.ai_gateway.usage;
Genie Code (mode Agent) peut le faire pour vous. Essayez cet exemple de prompt :
Query the system.ai_gateway.usage table to analyze AI Gateway usage showing request count and total tokens, grouped by endpoint name for the last 7 days.
Tableau de bord d'utilisation intégré
Certains workspaces n’affichent pas encore le menu déroulant Govern . Dans ces workspaces, utilisez plutôt les boutons autonomes Create Dashboard , View Dashboard et Update sur la page Unity Gateway.
Créer un tableau de bord d'utilisation intégré
Les administrateurs de compte peuvent créer un tableau de bord d’utilisation Unity Gateway intégré pour surveiller l’utilisation, suivre les coûts et obtenir des insight sur les performances et la consommation des services de modèles. Depuis la page Unity Gateway, cliquez sur Gouverner en haut à droite, puis cliquez sur Créer un tableau de bord d’utilisation . Le warehouse qui exécute les queries du tableau de bord est sélectionné automatiquement.
La création de tableaux de bord est réservée aux administrateurs de compte car elle nécessite les autorisations SELECT sur la table system.ai_gateway.usage. Les données du tableau de bord sont soumises aux politiques de rétention de la table usage. Voir Quelles tables système sont disponibles ?
Lorsqu’une version plus récente du tableau de bord d’utilisation intégré est disponible, les administrateurs de compte peuvent cliquer sur Mettre à jour sur la ligne de version du tableau de bord dans le menu déroulant Gouverner sur la page Unity Gateway.
Vous pouvez utiliser les options de configuration de tableau de bord suivantes pour gérer le tableau de bord :
- Portée : sélectionnez si vous souhaitez limiter le tableau de bord au compte ou au workspace.
- Autorisations : choisissez si les queries s'exécutent en utilisant les permissions du propriétaire du tableau de bord ou les permissions de chaque spectateur. Voir Qu'est-ce que les permissions de partage de données ?.
- Mises à jour automatiques : lorsque vous activez cette option, le tableau de bord se met à jour automatiquement dès qu’une version plus récente est disponible et qu’un administrateur de compte visite la page Unity Gateway.
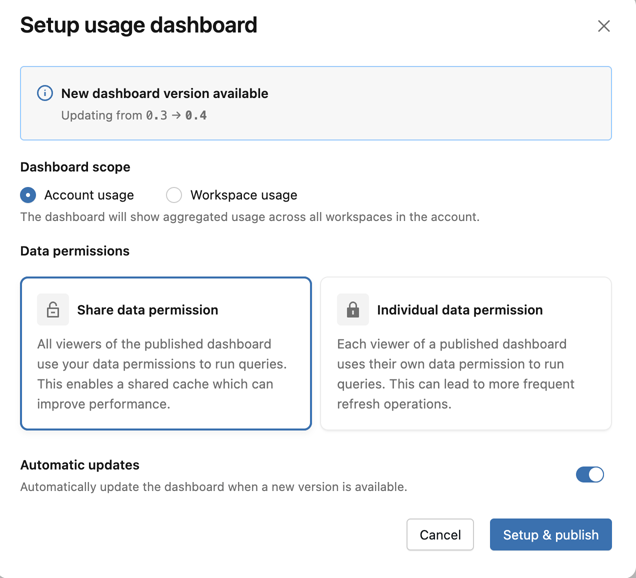
Lorsque le tableau de bord est mis à jour vers la version 0.3 ou supérieure, un calendrier est automatiquement créé pour refresh le tableau de bord toutes les 6 heures. Si nécessaire, ce calendrier peut être désactivé dans le tableau de bord Lakeview. Voir Créer un calendrier.
Afficher le tableau de bord d'utilisation
Pour visualiser le tableau de bord, cliquez sur Govern en haut à droite de la page Unity Gateway, puis cliquez sur Usage Dashboard . Le tableau de bord s'ouvre dans un nouveau tab. Le tableau de bord intégré offre une visibilité complète sur l'utilisation, les performances et le coût du service de modèle Unity Gateway. Il inclut plusieurs pages de suivi des requêtes, de la consommation de jetons, des mesures de latence, des taux d'erreur, de la ventilation des coûts, du trafic des serveurs MCP externes et de l'activité des agents de codage.

Le tableau de bord fournit des analytiques inter-Workspace par default. Toutes les pages du tableau de bord peuvent être filtrées par plage de dates et par ID de Workspace.
- Overview tab : affiche des indicateurs d’utilisation de haut niveau, notamment le volume quotidien de requêtes, les tendances d’utilisation des jetons au fil du temps, les principaux utilisateurs par consommation de jetons et le nombre total d’utilisateurs uniques. Utilisez cette tab pour obtenir un aperçu rapide de l’activité globale de Unity Gateway et identifier les utilisateurs et les modèles les plus actifs.
- Performance tab : suit les indicateurs de performance clés, notamment les centiles de latence (P50, P90, P95, P99), le temps jusqu’au premier octet, les taux d’erreur et la répartition des codes d’état HTTP. Utilisez cet tab pour surveiller l’état de santé du service de modèle et identifier les goulets d’étranglement en matière de performances ou les problèmes de fiabilité.
- Tab Usage : Affiche les répartitions détaillées de la consommation par service de modèle, Workspace et demandeur. Ce tab montre les schémas d'utilisation des jetons, les distributions des requêtes et les taux d'accès au cache.
- Cost Observability tab : affiche la répartition des coûts par service de modèle, modèle cible, utilisateur, tags de service et tags de requête. Cet tab inclut également le coût estimé pour les modèles externes. Voir Analyser le coût de Unity Gateway.
- **Tab des serveurs MCP externes** : Affiche le volume des requêtes, les taux d'erreur, les utilisateurs et les connexions, ainsi que les tendances d'utilisation quotidiennes pour le trafic des serveurs MCP externes.
- Coding Agents tab : Tracks activity from integrated coding agents including Claude Code, Codex CLI, Cursor, and Gemini CLI. This tab shows metrics like active days, coding sessions, commits, and lines of code added or removed to monitor developer tool usage. See Coding agent dashboard for more details.
Schéma de la table d'utilisation
La table system.ai_gateway.usage a le schéma suivant :
Nom de colonne | Type | Description | Exemple |
|---|---|---|---|
| CHAÎNE | L'ID du compte. |
|
| CHAÎNE | L'ID du workspace. |
|
| CHAÎNE | Un identifiant unique pour la requête. |
|
| CHAÎNE | Un identifiant unique pour chaque appel d'inférence individuel. Plusieurs invocations peuvent partager le même |
|
| INTEGER | La version du schéma de l'enregistrement d'utilisation. |
|
| CHAÎNE | Type de service ayant généré l’enregistrement d’utilisation. Les valeurs sont |
|
| CHAÎNE | ID du service de modèle, du service MCP ou du service de fournisseur de modèle. |
|
| CHAÎNE | Le nom pleinement qualifié Unity Catalog du service. |
|
| Carte | Tags de ressources appliqués à l’élément sécurisable Unity Catalog lors de la création ou de la mise à jour. Ils s’appliquent à toutes les requêtes adressées au service et sont utiles pour classer l’utilisation par équipe, centre de coûts ou projet. |
|
| CHAÎNE | L'ID unique du service de modèle Unity Gateway. |
|
| CHAÎNE | Le nom du service de modèle Unity Gateway. |
|
| Carte | Tags configurés sur le service de modèle au moment de la création ou de la mise à jour. Ils s'appliquent à toutes les requêtes adressées au modèle de service et sont utiles pour catégoriser les services par équipe, centre de coûts ou projet. |
|
| Structure | Métadonnées du service de modèle incluant |
|
| Horodatage | Le Timestamp lorsque la requête a été reçue. |
|
| LONG | La latence totale en millisecondes. |
|
| LONG | Le temps de premier octet en millisecondes. |
|
| CHAÎNE | Le type de destination (par exemple, modèle externe ou modèle de fondation). |
|
| CHAÎNE | Le nom du modèle ou du fournisseur de destination. |
|
| CHAÎNE | L'ID unique de la destination. |
|
| CHAÎNE | Le modèle spécifique utilisé pour la requête. |
|
| CHAÎNE | L'ID de l'utilisateur ou du Service Principal qui a effectué la demande. |
|
| CHAÎNE | Le type de demandeur (utilisateur, Service Principal ou groupe d'utilisateurs). |
|
| CHAÎNE | L'adresse IP du demandeur. |
|
| CHAÎNE | L’URL de la requête. |
|
| CHAÎNE | L’agent utilisateur du demandeur. |
|
| CHAÎNE | Le type d'appel API (par exemple, chat, complétions ou embeddings). |
|
| Carte | Tags fournis par l’utilisateur envoyés avec les requêtes individuelles à l’aide de l’en-tête HTTP |
|
| Structure | Informations sur l'origine de la requête, le niveau de service indiqué par le fournisseur du modèle et l'utilisation éventuelle d'un abonnement Claude. |
|
| LONG | Le nombre de jetons d'entrée. |
|
| LONG | Le nombre de jetons de sortie. |
|
| LONG | Le nombre total de jetons (entrée + sortie). |
|
| Structure | Répartition détaillée de l'utilisation des jetons et des outils, y compris |
|
| CHAÎNE | Le type de contenu de la réponse. |
|
| INT | Le code de statut HTTP de la réponse. |
|
| Structure | Détails de routage pour les tentatives de fallback. Contient un tableau |
|
| Structure | Détails d’une requête adressée à un service MCP, incluant l’outil invoqué, le type de serveur et l’opération JSON-RPC. Renseigné pour |
|
| Structure | Contexte de la session et du client, incluant les ID de session et de sous-agent, le nom et la version de l’agent de codage, l’interface client, l’effort de raisonnement et la méthode de routage intelligent. Utilisez ces champs pour regrouper les requêtes associées et analyser l’usage par agent ou par session. |
|
| CHAÎNE | Type d’identifiant Databricks utilisé pour authentifier la requête : un jeton d’accès personnel ( |
|
Schémas de colonnes imbriquées
Les tables suivantes décrivent les champs des colonnes STRUCT imbriquées. La disponibilité des champs dépend du service, du modèle et du client utilisés pour la requête.
Métadonnées d’invocation et de jeton
Chemin d’accès au champ | Type | Description |
|---|---|---|
| CHAÎNE | L’application, le service ou l’API qui a initié la demande. Utilisez ce champ pour attribuer l’utilisation à son information d’origine. Les valeurs incluent |
| CHAÎNE | Le niveau de service indiqué par le fournisseur de modèle dans la réponse d'inférence, tel que |
| BOOLEAN | Indique si la requête a été transmise à Anthropic à l’aide de l’abonnement Claude de l’appelant. |
| LONG | Le nombre de jetons lus à partir du cache de prompt. |
| LONG | Le nombre de jetons écrits dans le cache de prompt. |
| LONG | Nombre de jetons de raisonnement dans la sortie. |
| LONG | Le nombre de jetons d’entrée écrits dans le cache de prompt avec une durée de vie de 5 minutes. |
| LONG | Le nombre de jetons d’entrée écrits dans le cache de prompt avec une durée de vie d’une heure. |
| LONG | Le nombre d’appels d’outils de recherche de fichiers effectués dans le cadre de la requête. |
| LONG | Le nombre de query de recherche web facturables effectuées dans le cadre de la requête. |
Métadonnées du service MCP
Ces champs sont renseignés dans mcp_metadata pour MCP_SERVICE lignes.
Chemin d’accès au champ | Type | Description |
|---|---|---|
| CHAÎNE | Le nom de l'outil invoqué par une requête MCP |
| CHAÎNE | La catégorie de serveur MCP gérant la requête, telle que |
| CHAÎNE | L’opération JSON-RPC demandée par le client, telle que |
Métadonnées de session
Les champs session_metadata aident à corréler les requêtes au sein d’une session et à distinguer les agents de codage, les interfaces client et les paramètres de requête. Chaque champ est renseigné lorsque l’information correspondante est disponible auprès du client ou de la demande.
Chemin d’accès au champ | Type | Description |
|---|---|---|
| CHAÎNE | L'ID de session fourni par le client. Utilisez-le pour regrouper les requêtes effectuées au cours de la même conversation ou de la même session d'agent de codage. |
| CHAÎNE | L’ID de sous-agent fourni par le client. Utilisez-le avec |
| CHAÎNE | Le nom normalisé de l’agent de codage qui a envoyé la demande, tel que |
| CHAÎNE | La version déclarée de l’agent de code. Utilisez-le avec |
| CHAÎNE | L’interface client à partir de laquelle l’agent de codage a envoyé la requête, telle qu’une interface en ligne de commande, un IDE ou une application de bureau. |
| CHAÎNE | L’effort de raisonnement spécifié dans la requête, tel que |
| CHAÎNE | Le nom de la recette de routage intelligent sélectionnée par le client. Utilisez-le pour regrouper l’utilisation par recette de routage. |
Requêtes de tags pour le suivi de l'utilisation
Les tags de requête sont des paires clé-valeur personnalisées que l'appelant attache aux requêtes individuelles. Utilisez les tags de requête pour attribuer l'utilisation par projet, équipe, environnement, utilisateur final ou toute autre dimension pertinente pour votre organisation. Les tags de requête sont enregistrés dans la table system.ai_gateway.usage et peuvent être utilisés pour filtrer, agréger et analyser les données d'utilisation.
Pour étiqueter les requêtes individuelles, incluez l'en-tête HTTP Databricks-Ai-Gateway-Request-Tags avec un objet JSON mappant les clés de chaîne aux valeurs de chaîne. Les étiquettes de requête sont enregistrées dans la colonne request_tags de la table d'utilisation et dans les tables d'inférence.
Pour des exemples montrant comment définir des étiquettes de requête avec l’API REST, le SDK OpenAI et le SDK Anthropic, consultez Étiquetage des requêtes.
Par exemple, vous pouvez agréger l'utilisation par projet à l'aide de balises de requête :
SELECT
  request_tags['project'] AS project,
  COUNT(*) AS request_count,
  SUM(total_tokens) AS total_tokens
FROM system.ai_gateway.usage
WHERE request_tags['project'] IS NOT NULL
GROUP BY request_tags['project']
ORDER BY total_tokens DESC;
Limitations
- Unity Gateway ne suit pas l'utilisation des jetons pour les réponses non-streaming et non-embedding supérieures à 1 MiB.