Monter en charge le throughput de l'Endpoint de recherche IA avec un QPS élevé
Par default, les endpoints standard prennent en charge de 20 à 200 QPS selon la taille de l'index. Les applications en temps réel telles que les barres de recherche, les systèmes de recommandation et la correspondance d'entités nécessitent souvent de 100 à plus de 1 000 QPS. Sur les Endpoint standard uniquement, vous pouvez définir un QPS cible. Databricks provisionne l'infrastructure pour correspondre au mieux à ce niveau de throughput (meilleur effort, non garanti).
La définition d'un QPS cible provisionne une capacité supplémentaire, ce qui augmente le coût de l'endpoint. Vous êtes facturé pour cette capacité supplémentaire, indépendamment du trafic réel de query. La mise à l'échelle du throughput est un effort optimal et n'est pas garantie.
Utiliser QPS élevé lorsque :
- Votre application nécessite plus de 50 QPS de throughput soutenu.
- Vous recevez des erreurs 429 (Too Many Requests) sous une charge normale.
- La latence se dégrade à mesure que le trafic augmente, même lorsque l'utilisation moyenne semble faible.
Exigences
-
Le QPS élevé est disponible uniquement pour les Endpoints standard. Les endpoints optimisés pour le stockage ne sont pas pris en charge.
-
Utilisez l'authentification OAuth du Service Principal et l'URL d'index pour les charges de travail de production à QPS élevé. Les jetons d'accès personnels (PAT) et l'URL de query du Workspace sont appropriés pour le prototypage, mais ils n'utilisent pas la route de query optimisée et sont plafonnés à quelques dizaines de QPS.
-
Si le Workspace dispose d'un objet de paramètres d'accès privé attaché, aucun index du Workspace ne peut utiliser la route de query optimisée, quels que soient le type d'index ou les paramètres de l'objet.
- Les Workspace qui utilisent Private Service Connect pour la connectivité front-end ou back-end disposent d'un objet de paramètres d'accès privé.
- Dans cette configuration, les query utilisent l'URL de query du Workspace, limitée à quelques dizaines de QPS ; l'Endpoint ne peut donc pas atteindre un QPS cible plus élevé.
- Pour les charges de travail à QPS élevé, utilisez un workspace auquel aucun objet de paramètres d'accès privé n'est attaché. Si vous ne pouvez pas utiliser un workspace différent, contactez l'équipe de votre compte Databricks.
-
Les index Delta Sync qui utilisent des modèles d’intégration gérés ne peuvent pas utiliser la route de query optimisée si le Workspace a la fonctionnalité de liste d'accès IP activée.
- Dans cette configuration, les requêtes adressées à l'index utilisent l'URL de query du Workspace, qui est limitée à quelques dizaines de QPS, de sorte que l'Endpoint ne peut pas atteindre un QPS cible plus élevé. Cela s'applique à toutes les query adressées à l'index, y compris celles qui passent
query_vector. - Dans un workspace sans objet de paramètres d'accès privé, utilisez des intégrations autogérées pour atteindre votre QPS cible : un index Delta Sync avec une colonne vectorielle d'intégration ou un index d'accès vectoriel direct. Voir les options pour fournir des intégrations.
- Dans cette configuration, les requêtes adressées à l'index utilisent l'URL de query du Workspace, qui est limitée à quelques dizaines de QPS, de sorte que l'Endpoint ne peut pas atteindre un QPS cible plus élevé. Cela s'applique à toutes les query adressées à l'index, y compris celles qui passent
Configurer le QPS cible
Définissez un QPS cible lors de la création d'un nouvel endpoint ou de la mise à jour d'un endpoint existant. La capacité supplémentaire nécessaire pour correspondre au mieux au throughput cible est provisionnée automatiquement. La mise à l'échelle du throughput est fait au mieux et n'est pas garantie : le QPS réel dépend de la taille de votre index, de la dimensionnalité des vecteurs, de la complexité des query et de l'utilisation des filtres.
- Databricks UI
- Python SDK
- REST API
Lorsque vous créez un nouvel endpoint :
-
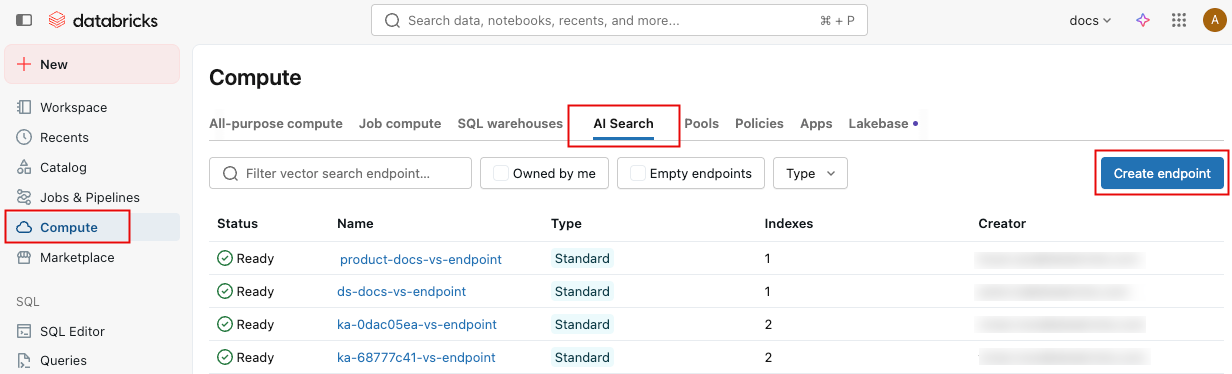
Dans la barre latérale gauche, cliquez sur Compute .
-
Cliquez sur l'onglet Recherche IA et cliquez sur Créer un Endpoint .
-
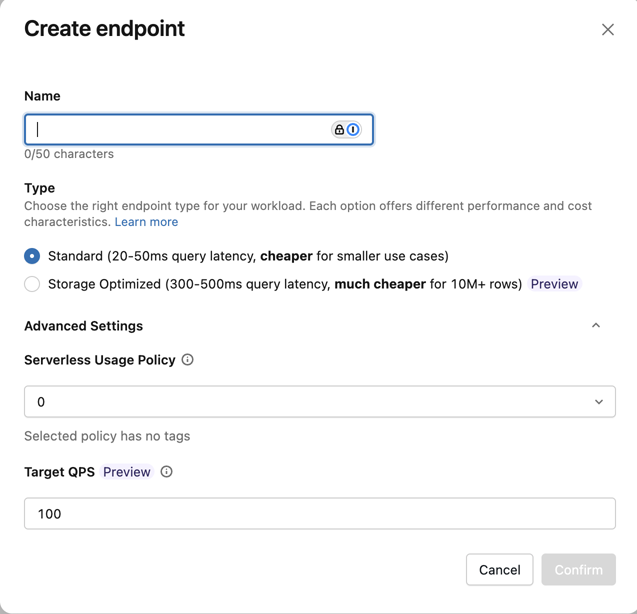
Sous Paramètres avancés , saisissez la valeur QPS cible .
Lors de la mise à jour d'un Endpoint existant :
-
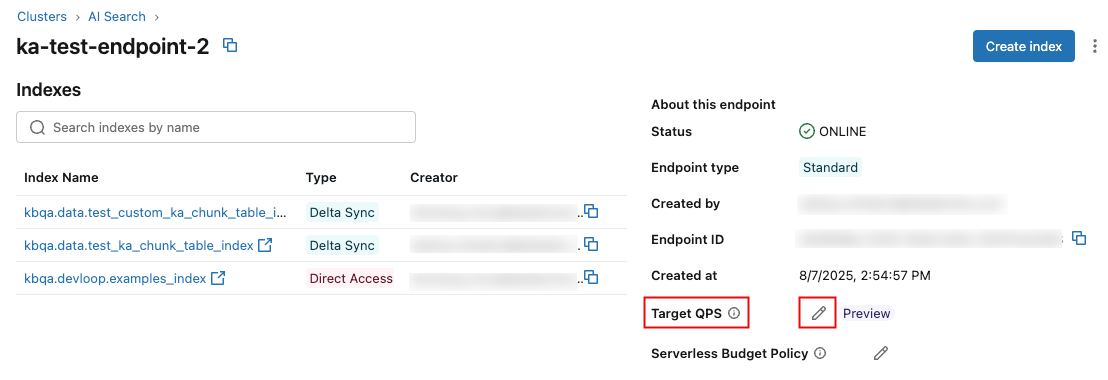
Accédez à la page de détails du Endpoint.
-
Dans le panneau de droite, cliquez sur l'icône en forme de crayon
 à côté de QPS cible .
-
Saisissez la nouvelle valeur et cliquez sur Enregistrer .

from databricks.ai_search.client import AISearchClient

client = AISearchClient()

# Create a new endpoint with target QPS
endpoint = client.create_endpoint(
    name="my-high-qps-endpoint",
    endpoint_type="STANDARD",
    target_qps=500,
)

# Update an existing endpoint's target QPS
response = client.update_endpoint(name="my-endpoint", target_qps=500)

# Check scaling status
scaling_info = response.get("endpoint", {}).get("scaling_info", {})
print(f"Requested target QPS: {scaling_info.get('requested_target_qps')}")
print(f"State: {scaling_info.get('state')}")
# State is "SCALING_CHANGE_IN_PROGRESS" while capacity is being provisioned,
# then transitions to "SCALING_CHANGE_APPLIED"
Créer un Endpoint avec un QPS cible :
POST /api/2.0/vector-search/endpoints
{
  "name": "my-high-qps-endpoint",
  "endpoint_type": "STANDARD",
  "target_qps": 500
}
Mettre à jour le QPS cible sur un endpoint existant :
PATCH /api/2.0/vector-search/endpoints/<ENDPOINT_NAME>
{
  "target_qps": 500
}
Vérifier l'état de la mise à l'échelle :
GET /api/2.0/vector-search/endpoints/<ENDPOINT_NAME>
Le champ de réponse scaling_info affiche le requested_target_qps et la mise à l'échelle state. L'état est SCALING_CHANGE_IN_PROGRESS pendant que la capacité est en cours de provisionnement, puis passe à SCALING_CHANGE_APPLIED.
Configurer un service principal
Les query à haut QPS ont besoin d'un jeton OAuth avec authorization_details pour l'index. Utilisez un service principal pour la production. Pour configurer le service principal :
-
Ajoutez un service principal et attribuez-le au workspace contenant l'index.
-
Créer un secret OAuth pour le service principal :
- Suivez les étapes de Créer un secret OAuth.
- Sous Scopes , sélectionnez all APIs . Le SDK Python demande le périmètre
all-apis, et un jeton ne peut pas dépasser les périmètres de son secret. Par conséquent, un secret limité à des périmètres plus restreints ne peut pas obtenir de jeton pour le SDK. L’exemple REST demande aussiall-apis. Ce périmètre rend le secret global. Utilisez donc un service principal dédié qui ne possède que les droits indiqués sur cette page. - Stockez l’identifiant du client et le secret dans un Secret Scope plutôt que dans le code de votre application.
-
Accorder au service principal les privilèges Unity Catalog suivants :
- USE CATALOG sur le catalogue contenant l'index.
- USE SCHEMA sur le schéma qui contient l’index.
- SELECT sur l'index.
- SELECT et MODIFY sur l'index, si le Service Principal upsert ou supprime des données dans un index vectoriel d'accès direct.
Si le service principal possède l’index, il n’a pas besoin de SELECT ou de MODIFY, mais il a toujours besoin de USE CATALOG et de USE SCHEMA.
-
Pour un index qui utilise un modèle d’intégration géré par Databricks, accordez des autorisations sur l’endpoint de déploiement de modèles d’intégration et, si l’index définit
model_endpoint_name_for_query, sur cet endpoint également. L’autorisation requise dépend du type d’endpoint :- Endpoint des APIs du modèle de fondation avec paiement par jeton , tels que
databricks-gte-large-en: aucun accord n'est nécessaire, sauf si votre compte restreint les modèles de fondation avec des autorisations Unity Catalog. Dans ce cas, accordez EXECUTE sur le modèle. - throughput provisionnement et Endpoint de service personnalisés : Accordez Peut effectuer des query pour effectuer des query avec
query_text. Accordez au moins Peut afficher même si vous effectuez des query uniquement avecquery_vectoret utilisez le SDK Python, carget_index()lit ces Endpoint de service et échoue sans autorisation.
- Endpoint des APIs du modèle de fondation avec paiement par jeton , tels que
L’interrogation d’un index ne nécessite aucune autorisation sur l’endpoint de recherche IA lui-même.
Le service principal s’authentifie avec l’autorisation OAuth machine à machine (M2M). Le jeton OAuth doit inclure authorization_details qui autorisent ReadVectorIndex sur l’index, ou WriteVectorIndex pour les upserts et les suppressions.
Si l’endpoint de déploiement de modèles d’intégration ou l’endpoint model_endpoint_name_for_query est optimisé pour l’itinéraire, le jeton doit également avoir une entrée workspace_permission qui autorise query_inference_endpoint sur chacun d’eux. Pour vérifier si un endpoint de service est optimisé pour l’itinéraire, consultez le champ route_optimized renvoyé par GET /api/2.0/serving-endpoints/<name>.
- Python SDK : Transmettez l’identifiant et le secret du client à
AISearchClient, comme indiqué dans query l’URL d’index. Le SDK demande un jeton avec leauthorization_detailsrequis et ajoute automatiquement les entrées de l'endpoint de service. Pour un endpointmodel_endpoint_name_for_queryoptimisé pour l’itinéraire, cela nécessitedatabricks-ai-search0.79 et supérieur. - API REST : demandez vous-même le jeton. Consultez l’exemple de Service Principal dans le tab API REST de Comment query un index de recherche IA.
Pour les tests, vous pouvez également utiliser un jeton obtenu par l’intermédiaire de l’échange de jetons de notebook. Utilisez un service principal pour la production. Pour effectuer une query sur un index Delta Sync qui utilise un modèle d’embedding géré par Databricks avec query_text, utilisez un jeton de service principal, car l’endpoint de traitement du modèle d’embedding pourrait rejeter un jeton de l’échange de jetons de notebook avec une erreur 403.
Les modifications de privilèges ne s’appliquent qu’aux jetons nouvellement émis. La révocation d’un privilège n’invalide pas un jeton déjà émis. Ce jeton reste valide jusqu’à sa date d’expiration, soit une durée maximale de une heure. Avec le SDK Python, appelez à nouveau get_index() après avoir modifié les privilèges ou la configuration de l’endpoint d’intégration. Les appelants REST doivent demander un nouveau jeton.
query l'URL de l'index
Une fois que l’état de montée en charge de l’endpoint est SCALING_CHANGE_APPLIED, envoyez des requêtes à l’URL de l’index à l’aide d’un jeton OAuth avec authorization_details pour l’index, par exemple un jeton de service principal. Cette URL est requise pour utiliser la capacité de query supplémentaire provisionnée par target_qps.
Pour les applications Python, appelez get_index() une fois et réutilisez l'objet index retourné. Le SDK Python envoie des requêtes à l'URL de l'index.
from databricks.ai_search.client import AISearchClient

client = AISearchClient(
    service_principal_client_id="...",
    service_principal_client_secret="...",
    workspace_url="https://<workspace-url>",
)

index = client.get_index(endpoint_name="my-high-qps-endpoint", index_name="catalog.schema.index")

# Reuse this index object for every query.
index.similarity_search(query_vector=[...], columns=["id", "text"], num_results=10)
Pour les applications REST ou non-Python, commencez par obtenir l'URL de l'index, puis envoyez les demandes de query à cette URL. Le jeton doit être un jeton OAuth avec authorization_details pour l'index. Utilisez un service principal pour la production.
export WORKSPACE_URL=https://<workspace-url>
export INDEX_NAME=catalog.schema.index
export TOKEN=<oauth-token>

export INDEX_URL=$(curl -X GET \
  -H "Authorization: Bearer $TOKEN" \
  "$WORKSPACE_URL/api/2.0/vector-search/indexes/$INDEX_NAME" \
  | jq -r '.status.index_url')

case "$INDEX_URL" in
  http://*|https://*) ;;
  *) INDEX_URL="https://$INDEX_URL" ;;
esac

curl -X POST \
  -H "Authorization: Bearer $TOKEN" \
  -H "Content-Type: application/json" \
  "$INDEX_URL/query" \
  --data '{"num_results": 10, "query_vector": [...], "columns": ["id", "text"]}'
N'utilisez pas l'URL de query du workspace, telle que /api/2.0/vector-search/indexes/<index_name>/query, pour le trafic de production à QPS élevé. Cette URL n'utilise pas la route de query optimisée et peut renvoyer des erreurs 429 avant que l'endpoint n'atteigne le QPS cible configuré.
Comment la mise à l'échelle s'applique
Après avoir défini un QPS cible, la capacité requise est approvisionnée automatiquement. Le nouveau niveau de throughput s'applique une fois le provisionnement terminé ; vous n'avez pas besoin de synchroniser les index pour trigger le changement.
Toute tentative de mise à jour du QPS cible pendant une opération de mise à l'échelle renvoie une erreur RESOURCE_CONFLICT. Attendez que l'opération actuelle se termine avant de réessayer.
Dépanner les erreurs 429
Pour les charges de travail à QPS élevé, utilisez ces vérifications pour trouver le goulot d'étranglement :
- Si vous utilisez un PAT ou l’URL de query de Workspace, passez à l’ authentification OAuth du Service Principal et à l’URL d’index.
- Si
scaling_info.stateestSCALING_CHANGE_IN_PROGRESS, attendez que l'état passe àSCALING_CHANGE_APPLIED. - Si votre application envoie des querys vectorielles avec
query_vector, le modèle d’intégration ne se trouve pas dans le chemin de query. Si les erreurs 429 persistent après la fin de la montée en charge, réduisez la concurrence des requêtes ou définissez untarget_qpsplus élevé. - Si votre application envoie des queries textuelles à un index Delta Sync avec des modèles d’intégration gérés par Databricks, le modèle d’intégration pourrait être le goulot d’étranglement. Utilisez un modèle d’intégration plus petit, tel que
databricks-qwen3-embedding-0-6b, au lieu dedatabricks-gte-large-en, ou utilisez un Endpoint d’API de modèle de fondation à throughput provisionné ou un autre Endpoint de Model Serving dédié pour les intégrations.
Limitations
- Pas de mise à l'échelle automatique : Vous devez définir le QPS cible manuellement en fonction du trafic attendu. Si le trafic dépasse le niveau provisionné, des erreurs 429 se produisent. Consultez Planifier les pics de query.
- Endpoint standards uniquement : les Endpoint optimisés pour le stockage ne prennent pas en charge
target_qps. - Route optimisée requise : Le QPS cible configuré s'applique au trafic qui utilise l'authentification OAuth du Service Principal et l'URL d'index. Le trafic PAT et le trafic d'URL de query du Workspace sont plafonnés à quelques dizaines de QPS.
- **Les modèles d'intégration gérés peuvent ajouter une deuxième limite** : Pour les index Delta Sync qui utilisent un modèle d'intégration géré pour les query de texte, le throughput des query dépend également de l'Endpoint de déploiement du modèle d'intégration. Augmentez la capacité de service des modèles, utilisez le throughput provisionné ou utilisez des incorporations autogérées pour un throughput de query prévisible.