Gérer les dépendances à l’aide d’environnements
Bêta
Cette fonctionnalité est en version bêta. Les administrateurs de compte peuvent contrôler l'accès à cette fonctionnalité depuis la page Previews de la console de compte à l'aide du bouton bascule Environments for Standard Compute . Consultez Gérer les aperçus Databricks.
Sur une ressource de compute classique qui utilise le mode de dépendance Environnements , vous gérez les dépendances au niveau de la charge de travail à l’aide d’ environnements de base au lieu d’installer des bibliothèques limitées au compute.
Les paramètres d'environnement restent isolés des modifications au niveau du compute, afin que les charges de travail ne soient pas interrompues lorsque le compute change sous-jacent. Et comme Databricks met en cache les environnements de base, les dépendances ne sont pas résolues et installées au Startup ; le compute démarre donc plus rapidement et évite les échecs liés à la résolution des packages, à la disponibilité du repository ou à la fiabilité du réseau.
Dans un notebook rattaché à une ressource de compute classique qui utilise le mode de dépendance Environments , sélectionnez un environnement de base et ajoutez des dépendances depuis le volet latéral Environment du notebook. Pour les tâches de job, configurez les dépendances avec une spécification d'environnement de job.
Exigences
Le paramètre de mode de dépendance est uniquement disponible sur le compute qui répond aux exigences suivantes :
- Databricks Runtime 19 (bêta) ou version ultérieure
- Mode d’accès standard
- All-purpose compute ou classic Job compute
Pour plus de détails sur le support, consultez les Limitations.
Définir le mode de dépendance
To create a classic compute resource that uses the Environments dependency mode :
-
Dans la barre latérale du Workspace, cliquez sur
 Compute , puis ouvrez la tab Calcul multifonction.
-
Cliquez sur Créer un compute .
-
Sous Performances , sélectionnez 19 Beta ou une version ultérieure dans le menu déroulant de version de Databricks Runtime.
-
Développez la section Advanced , puis cliquez sur Dependencies .
-
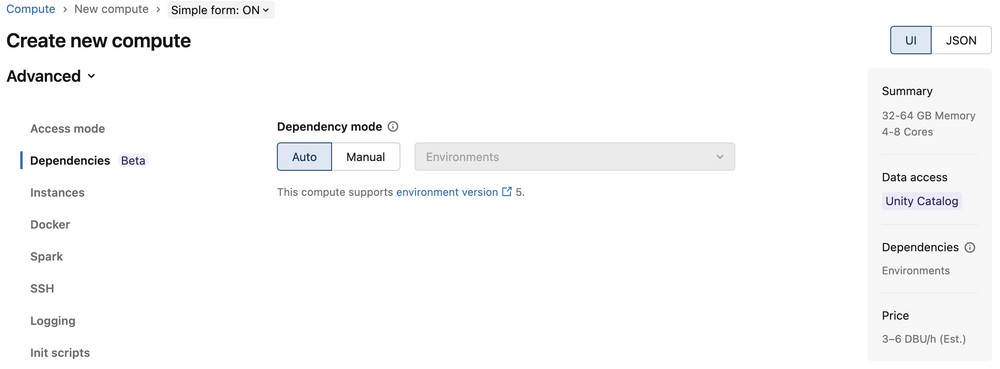
Pour Dependency mode , laissez Auto sélectionné pour permettre à Databricks de résoudre le mode, ou cliquez sur Manual et sélectionnez Environments pour le définir vous-même. Voir Dependency mode options.
-
Configurez le reste du compute, puis cliquez sur Créer .
Une fois le compute en cours d’exécution, attachez un notebook et configurez son environnement comme décrit dans Utiliser des environnements dans un notebook.
Options de mode de dépendance
Le contrôle Dependency mode dispose de deux paramètres qui déterminent la manière dont le mode est choisi :
- Auto : Databricks résout le mode en fonction de la configuration du compute. Auto se résout en Environments , sauf si le compute spécifie Docker, des variables d'environnement Spark ou des scripts d'initialisation, auquel cas il se résout en Cluster libraries .
- Manuel : vous sélectionnez vous-même Environnements ou Bibliothèques de clusters .
Lorsque vous sélectionnez Manuel , choisissez le mode qui répond à vos besoins :
- Environments : gérez les dépendances au niveau de la charge de travail à l’aide d’environnements de base. Les bibliothèques de clusters, Docker, les variables d’environnement Spark et les scripts d’initialisation sont désactivés. Utilisez ce mode pour isoler les dépendances de chaque charge de travail.
- Bibliothèques de clusters : le comportement classique. Installez les dépendances sur le compute à l’aide des bibliothèques de clusters, des scripts d’initialisation ou de Docker. Utilisez ce mode si votre charge de travail nécessite l’un de ces paramètres.
Mettre à jour un compute existant
Si vous modifiez les paramètres d'un compute existant, le passage au mode Environnements est bloqué si le compute présente des paramètres incompatibles, tels que des scripts d'initialisation, des bibliothèques de clusters ou Docker. Si vous supprimez d'abord les paramètres incompatibles, vous pourrez ensuite modifier le mode de dépendance.
Si vous passez du mode Environnements au mode Bibliothèques de clusters , les notebooks attachés conservent leurs sélections d'environnement, mais celles-ci deviennent inactives. Si vous repassez le compute en mode Environnements , ces sélections redeviennent actives.
Utiliser des environnements dans un notebook
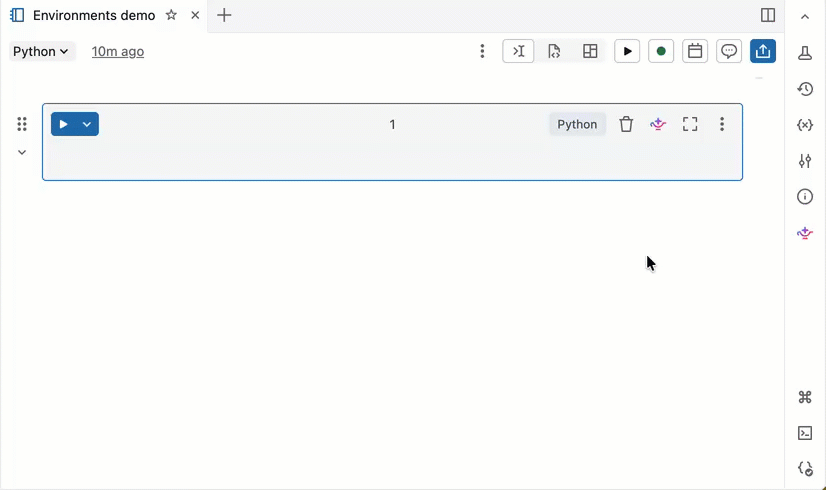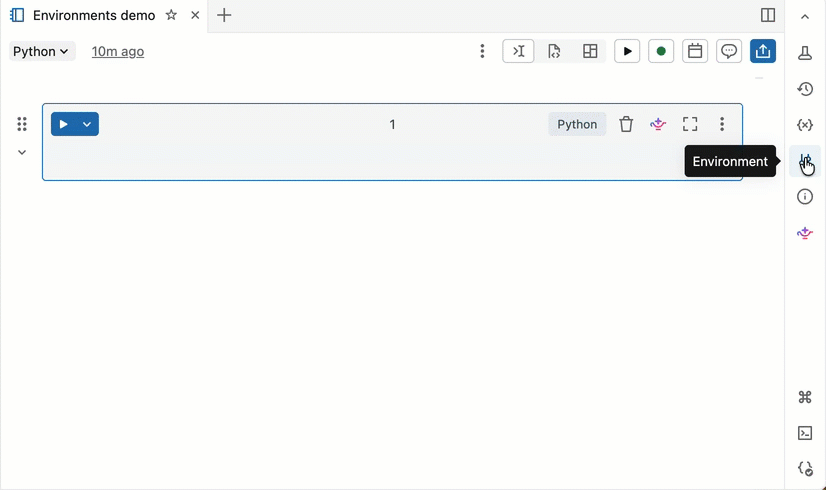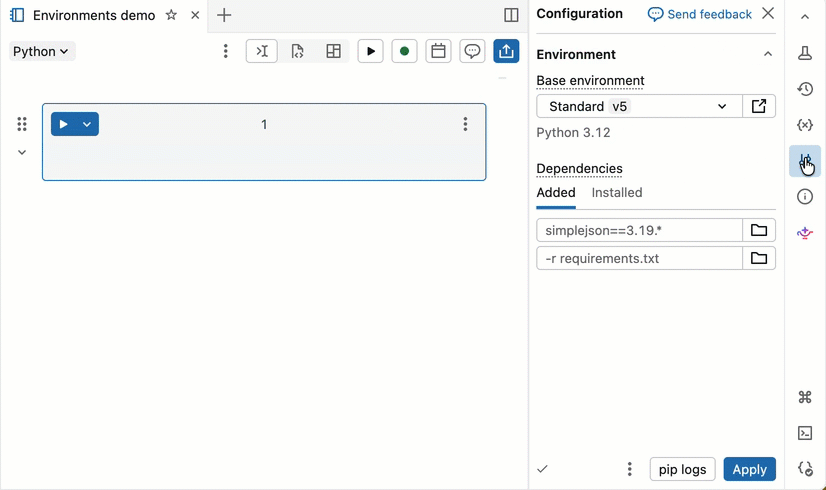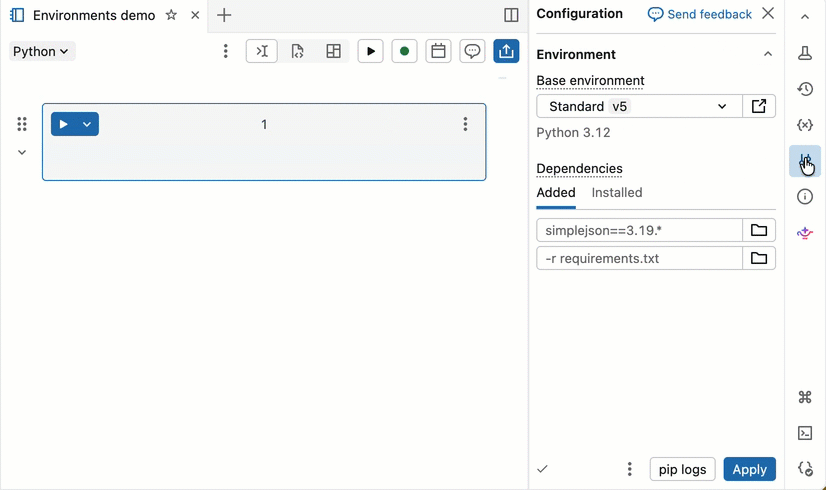
Pour utiliser des environnements dans un notebook, associez le notebook à une ressource de compute classique qui utilise le mode de dépendance Environnements . Après avoir associé le notebook, configurez les dépendances du notebook à partir du volet latéral Environnement  .
Sélectionnez un environnement de base
Un environnement de base détermine les bibliothèques préinstallées et la version de l'environnement disponibles pour votre notebook. Le sélecteur Environnement de base dans le volet latéral Environnement est l'endroit où vous choisissez votre environnement. Databricks recommande d'utiliser la dernière version pour bénéficier des fonctionnalités de notebook les plus récentes. Pour voir les détails sur chaque version d'environnement, consultez les versions de l'environnement.
Le sélecteur Environnement de base inclut les options suivantes :
-
Standard : l’environnement de base default avec les bibliothèques fournies par Databricks.
-
ML : un environnement de base avec les packages Python et système de Databricks Runtime for Machine Learning préinstallés.
-
Plus : se développe pour afficher des options supplémentaires :
- Versions précédentes des environnements Standard et ML.
- Personnalisé : spécifiez un environnement personnalisé à l’aide d’un fichier YAML.
-
Workspace environments : liste tous les environnements de base compatibles configurés pour votre Workspace par les administrateurs du Workspace.
Ajouter des dépendances au Notebook
Databricks met en cache l'environnement virtuel de votre notebook, de sorte que les dépendances ne se réinstallent pas à chaque fois que vous rouvrez un notebook ou que vous reprenez après une période d'inactivité.
Pour installer une dépendance individuellement :
-
Dans la section Dépendances , saisissez le chemin de la dépendance dans le champ, puis cliquez sur +Ajouter une dépendance . Vous pouvez spécifier une dépendance dans n’importe quel format valide dans un fichier requirements.txt. Les fichiers Python wheel ou les projets Python (par exemple, le répertoire contenant un
pyproject.tomlou unsetup.py) peuvent être situés dans des fichiers de Workspace ou des volumes Unity Catalog.- Si vous utilisez un fichier de Workspace, le chemin doit être absolu et start par
/Workspace/. - Si vous utilisez un fichier dans un volume Unity Catalog, le chemin d’accès doit être au format suivant :
/Volumes/<catalog>/<schema>/<volume>/<path>.whl.
- Si vous utilisez un fichier de Workspace, le chemin doit être absolu et start par
-
Cliquez sur Appliquer pour installer les dépendances et redémarrer le processus Python.
N’installez pas PySpark ou toute bibliothèque installant PySpark en tant que dépendance sur vos Notebooks. Cela arrêtera votre session et entraînera une erreur. Si cela se produit, supprimez la bibliothèque et effectuez un Reset de votre environnement.
Pour afficher les dépendances installées, cliquez sur l’onglet Installé dans le volet latéral Environnement . Ouvrez les logs d’installation pip pour l’environnement du notebook en cliquant sur pip logs en bas du volet.
Utiliser des environnements dans un job
Pour les tâches de job exécutées sur une ressource de compute classique qui utilise le mode de dépendance Environments , configurez les dépendances avec une spécification d’environnement de job. Un environnement de job spécifie un environnement de base et toutes les dépendances supplémentaires auxquelles une ou plusieurs tâches peuvent faire référence.
Pour configurer un environnement pour une tâche de job, procédez comme suit :
- Créer ou modifier une tâche dans un job.
- Sous Compute , sélectionnez une ressource de compute classique existante qui utilise le mode de dépendance Environments , ou ajoutez un compute de jobs classiques.
- Si vous ajoutez un compute de jobs classiques, développez Advanced .
- Click Dependencies .
- For Dependency mode , select Manual and Environments , or keep Auto if it resolves to Environments .
- Sous Environment and Libraries dans la configuration de la tâche, configurez un environnement pour cette dernière. Consultez Configurer l’environnement pour les tâches de job pour connaître les options disponibles pour chaque type de tâche.
Les tâches exécutées sur une ressource de compute classique qui utilise le mode de dépendance Environments ne prennent pas en charge le paramètre de tâche Dependent libraries . Ajoutez plutôt des dépendances à l’environnement.
Limitations
Le mode de dépendance Environments prend en charge les charges de travail Python et les dépenses dans les notebooks interactifs et les tâches de job. Les limitations suivantes s'appliquent :
- Les tâches Spark JAR ne sont pas prises en charge sur une Ressource compute classique qui utilise le mode de dépendance Environments .
- L'exécution du code
%scalaa échoué. - Toutes les limitations du mode d’accès standard s’appliquent, y compris l’absence de prise en charge de R. Voir Configuration requise et limitations du compute standard.
Paramètres incompatibles
Lorsque le mode de dépendance Environnements est activé, les paramètres de compute suivants sont désactivés :
- Docker (Databricks Container Services)
- Variables d'environnement Spark
- Scripts d'initialisation
- Bibliothèques de clusters