Matérialisation des dataset dans les tableaux de bord AI/BI
Bêta
Cette fonctionnalité est en version Bêta. Pour l'utiliser, un administrateur du workspace doit activer AI/BI Dashboard Materialization depuis la page Previews . Consultez Gérer les aperçus Databricks.
Les tableaux de bord AI/BI reposent sur des jeux de données étendus au tableau de bord. Par default, chaque dataset est évalué en temps réel. Ainsi, chaque fois qu'un tableau de bord se charge ou qu'un utilisateur interagît avec celui-ci, les requêtes, les jointures et les analyses de source sous-jacentes s'exécutent de nouveau sur votre SQL Warehouse. Pour les tableaux de bord basés sur des requêtes source coûteuses ou de nombreuses jointures, réexécuter ces queries à chaque interaction s'avère lent et onéreux.
La matérialisation des datasets précalcule et stocke les résultats associés à un dataset, de sorte que le gros du travail est effectué une seule fois selon une planification plutôt que lors de chaque chargement ou interaction du tableau de bord. Les interactions s'affichent ensuite à partir des résultats stockés, ce qui rend les tableaux de bord publiés plus rapides.
La matérialisation utilise la Technologie de matérialisation des vues de métriques Unity Catalog. Consultez Matérialisation pour les vues métriques.
Éléments matérialisés
La matérialisation précalcule et stocke les données des dataset. Le contenu stocké diffère selon les deux types de dataset :
- Pour les datasets SQL, le résultat complet de la query est précalculé et stocké.
- Pour les vues de métriques locales, le modèle de données au niveau des lignes (données sources, jointures et champs de filtre) est stocké, tandis que les mesures continuent d’être calculées au moment de la query par rapport à la base précalculée.
Avantages
La matérialisation des datasets offre les avantages suivants :
- Des tableaux de bord plus rapides sans remodelage. Les jointures complexes et les analyses de sources s'exécutent une seule fois selon une planification plutôt qu'à chaque chargement, ce qui supprime l'attente des utilisateurs lorsqu'un tableau de bord re-query de grandes tables.
- Réduction des coûts du warehouse en lecture. Le précalcul du modèle de données de base évite de répéter la même query lourde pour chaque utilisateur et chaque chargement de page, ce qui réduit l'utilisation redondante du warehouse.
- Aucun frais opérationnel. Databricks crée, stocke et refresh les données matérialisées pour vous. Il n'y a aucun pipeline, schéma ou stockage à gérer.
Coûts
La matérialisation des datasets entraîne des coûts de stockage et de compute :
- Stockage. Vous payez pour le stockage des données matérialisées. Les frais dépendent du stockage sous-jacent utilisé. Pour obtenir un aperçu du stockage dans Unity Catalog, consultez la page Connect to cloud object storage using Unity Catalog.
- compute. La création initiale et les refresh s'exécutent sur des LakeFlow Pipelines Serverless et génèrent des frais de compute. Voir les tarifs des Lakeflow pipelines.
Évaluez ces coûts par rapport aux économies réalisées en évitant les analyses et jointures de sources répétées. Choisissez un calendrier de refresh qui concilie la fraîcheur des données et les coûts du compute.
Quand utiliser la matérialisation
La matérialisation n'est pas toujours le bon levier pour les performances. L'avantage réside dans le remplacement des recalculs complets et répétés d'un dataset (analyse et jointure) par des lectures sur une table précalculée. Matérialisez un dataset lorsque l'un ou plusieurs des cas suivants s'appliquent :
- Tableaux de bord hautement interactifs. Le tableau de bord comporte de nombreux filtres, un filtrage croisé ou des explorations de données. Sans la matérialisation, chaque interaction réexécute la query du dataset. Par conséquent, le pré-compute de ces datasets s’avère très utile au cours d’une session.
- Datasets coûteux. Le dataset repose sur des jointures multi-tables, des vues lourdes ou des expressions de table commune (CTE), des fonctions de fenêtrage ou des unions entre de nombreuses tables.
- Filtres sélectifs sur les grandes tables. Le dataset sélectionne un petit sous-ensemble, tel qu'une région ou les 7 derniers jours sur des milliards de lignes. La matérialisation ne stocke que le petit sous-ensemble.
- Tolérance pour l’actualisation programmée. Les données n’ont besoin d’être actualisées qu’en fonction de la planification de refresh du tableau de bord (toutes les heures ou tous les jours, par exemple), plutôt qu’en temps réel.
Pour les petits datasets ou les tableaux de bord rarement chargés, la live query est souvent suffisamment rapide et la matérialisation n’en vaut peut-être pas la peine. La matérialisation étant facultative par publication et par dataset, vous pouvez l’appliquer uniquement là où elle s’avère utile.
Configuration requise
- Accès à un AI/BI dashboard.
- Le tableau de bord est publié avec l’option Share data permissions . La matérialisation n’est pas prise en charge pour les tableaux de bord publiés avec des autorisations de données individuelles. Consultez What are shared data permissions?.
- Le compute serverless est activé dans le workspace. La création initiale et les actualisations s’exécutent sur les LakeFlow Pipelines serverless. Consultez Set up serverless SQL warehouses.
- Autorisation CAN USE sur un SQL Warehouse exécutant Databricks Runtime 17.3 et versions ultérieures.
Activer la matérialisation des dataset
Les datasets sont sélectionnés pour la matérialisation par default, mais la matérialisation est désactivée pour le tableau de bord tant que vous n'activez pas l'option Materialize datasets lors de la publication.
Choisissez les datasets à matérialiser
Sous le tab Data, cliquez sur l’icône de matérialisation située à côté d’un dataset pour l’inclure ou l’exclure.
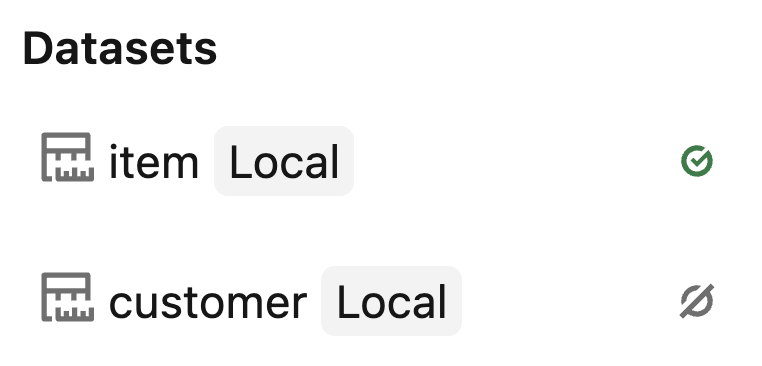
Lorsque vous excluez un dataset de la matérialisation, les requêtes adressées à ce dataset renvoient des résultats en temps réel, tandis que les requêtes adressées aux datasets matérialisés reflètent la dernière exécution de matérialisation. Lorsque tous les datasets utilisent le même calendrier de matérialisation, les widgets présentent une fraîcheur de données cohérente.
Publier avec matérialisation
- Cliquez sur Publier dans le brouillon de tableau de bord.
- Sélectionnez Share data permissions dans la boîte de dialogue de publication.
- Activez l’option Matérialiser les datasets pour matérialiser les datasets sélectionnés sous l’onglet tab .
- Cliquez sur Publier .
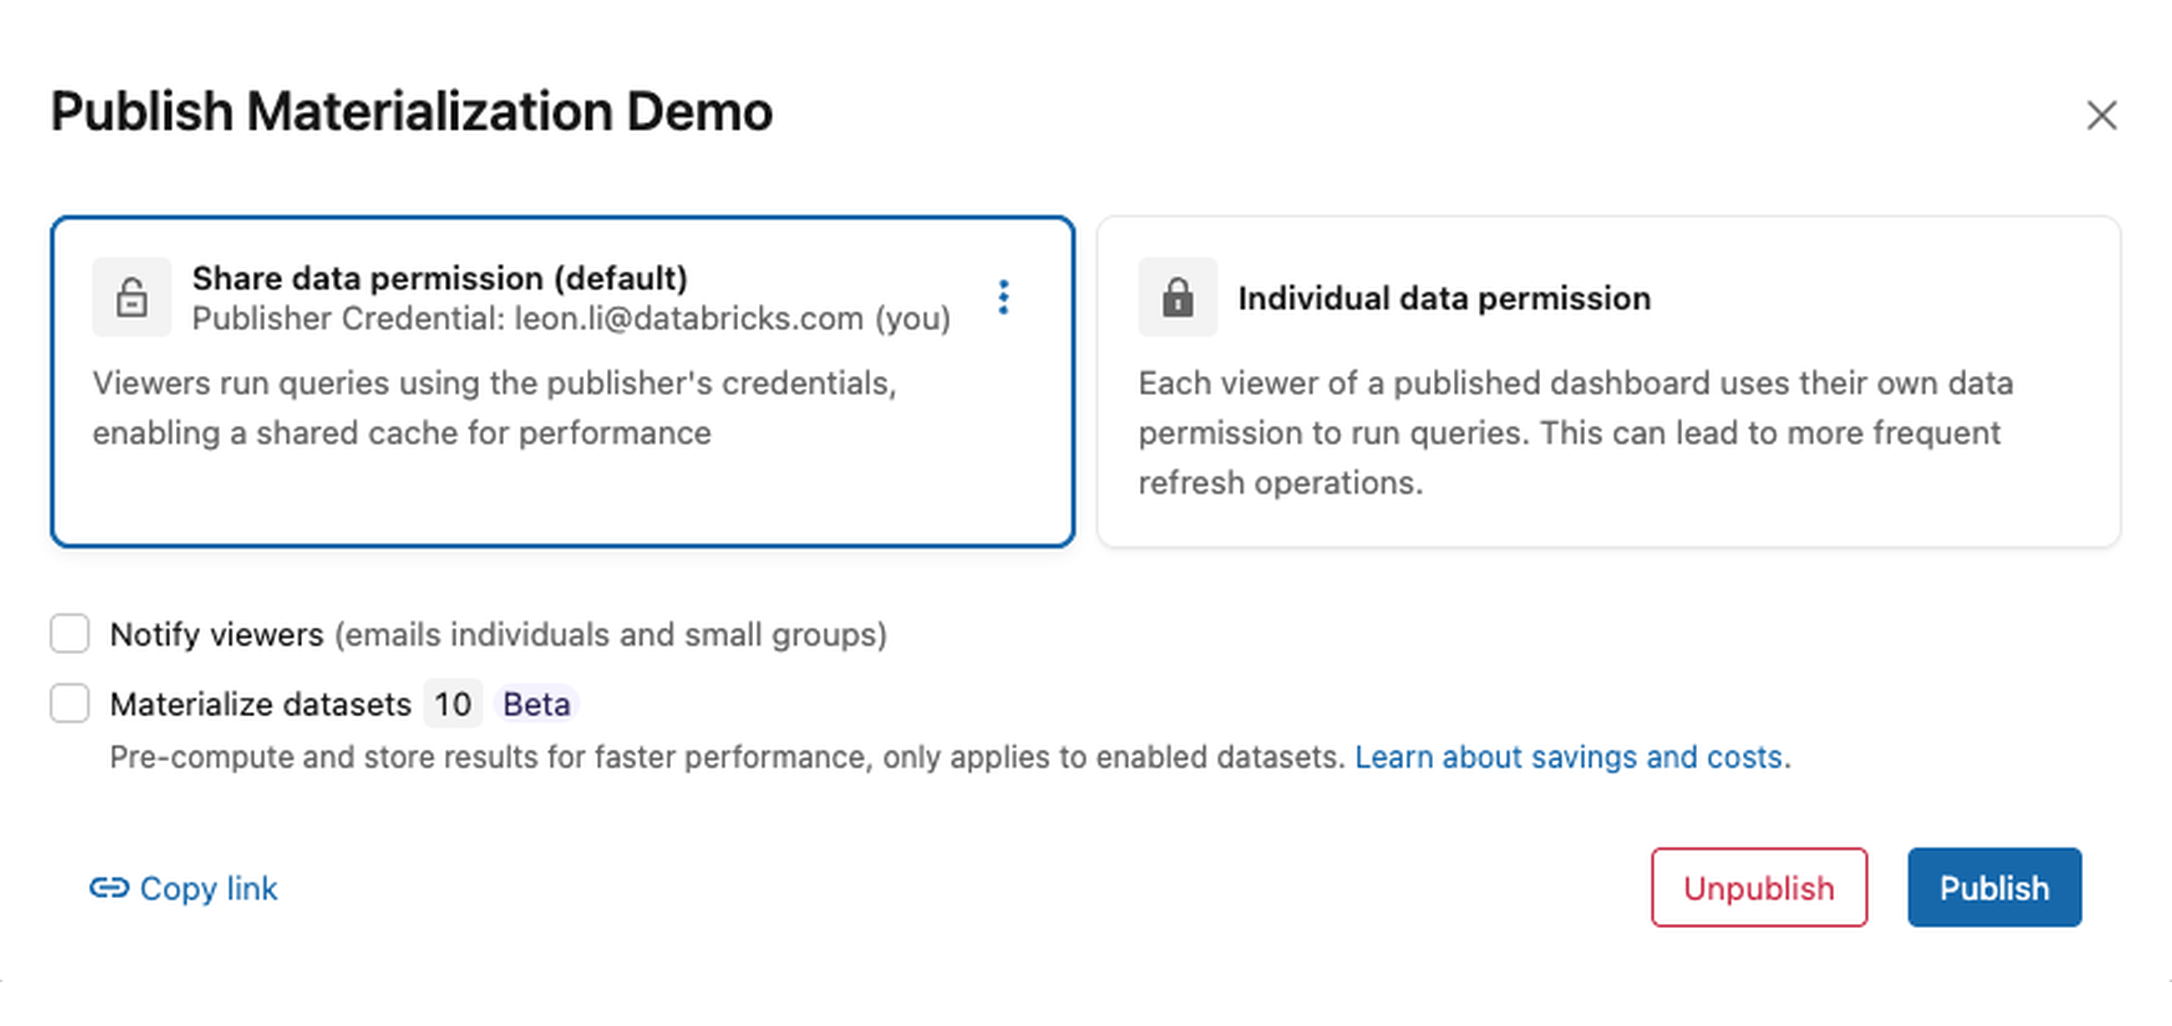
Activez l'option Materialize datasets à chaque publication.
Définir un calendrier de refresh
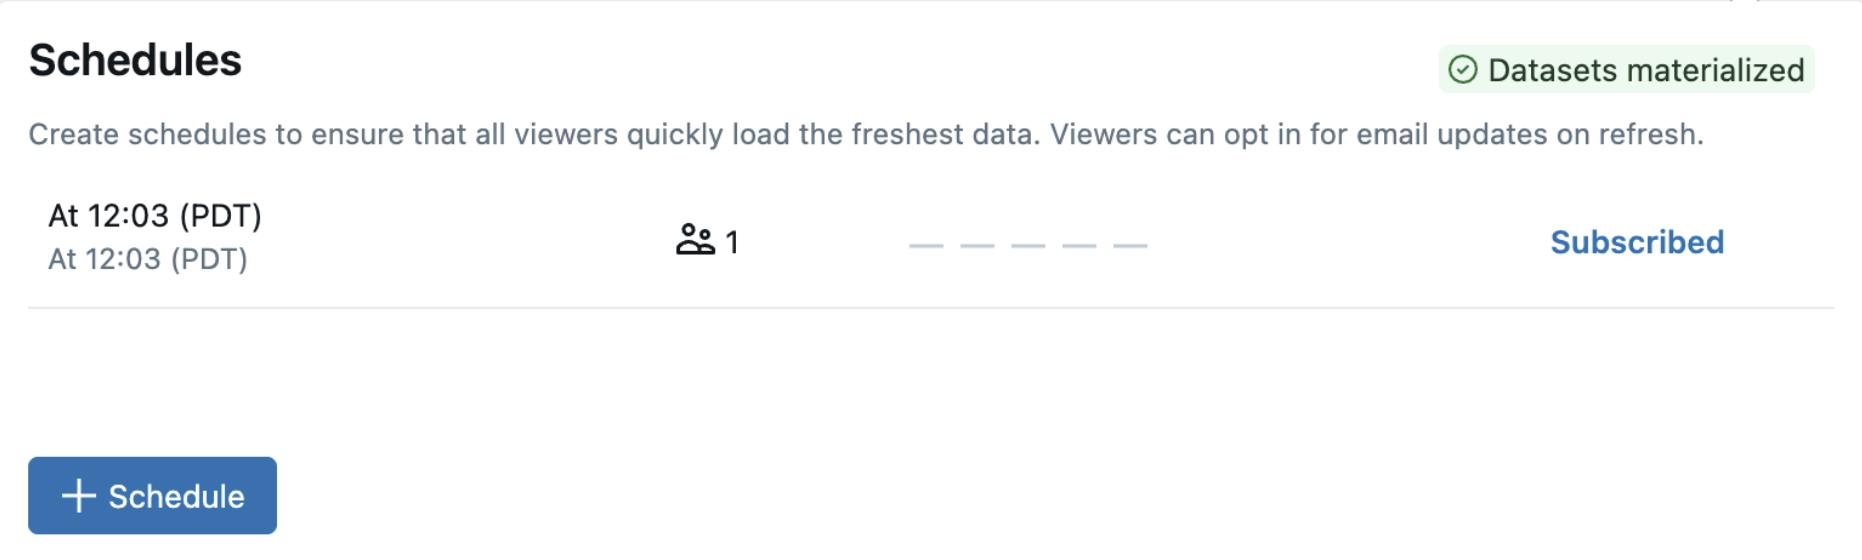
Les données matérialisées font l’objet d’un refresh selon la planification de refresh du tableau de bord. Utilisez le calendrier du tableau de bord pour ajuster la fréquence de refresh.
Si le tableau de bord ne comporte aucun calendrier, la publication avec la matérialisation activée ajoute un calendrier de refresh quotidien. Les plannings existants sont conservés. Sans calendrier actif, les données matérialisées ne refresh pas automatiquement après la création.
Afficher l’état de la matérialisation
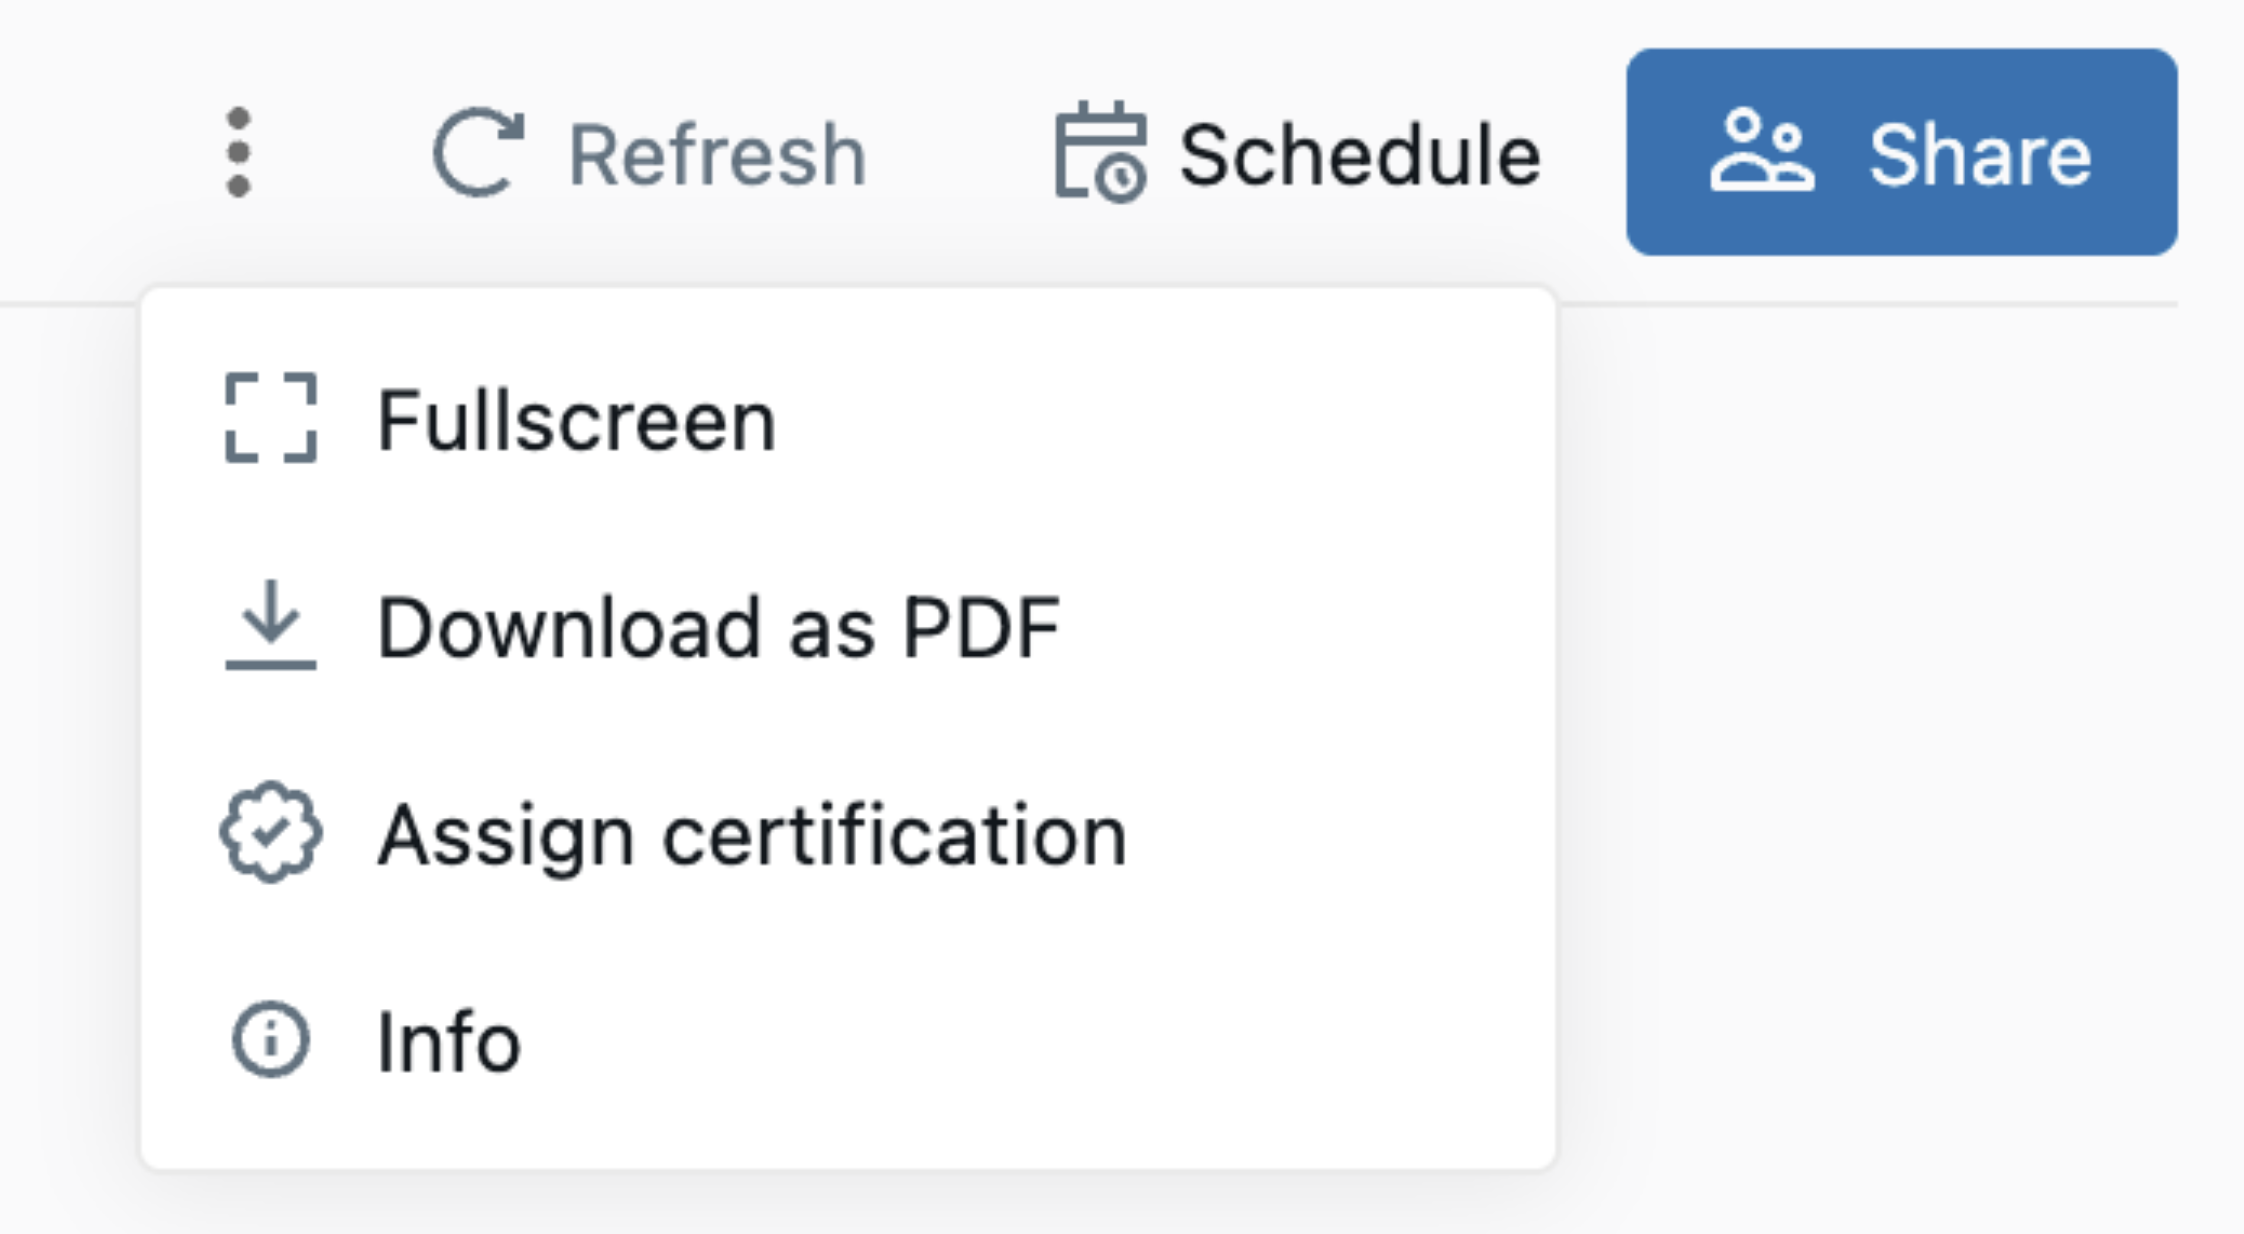
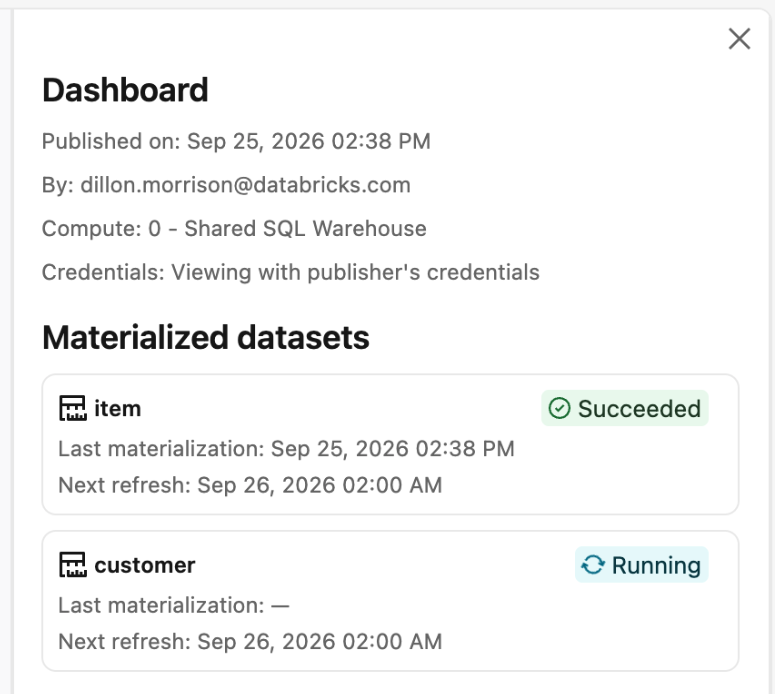
Dans le tableau de bord publié, ouvrez le menu  et sélectionnez Info . La barre latérale indique le statut et les informations de refresh de chaque jeu de données matérialisé.
Réutilisation et nettoyage
Databricks gère le cycle de vie de vos données matérialisées :
- Réutilisation entre les révisions. Si un tableau de bord est republié par le même utilisateur et qu’un dataset est inchangé, la matérialisation existante sera réutilisée, ce qui évitera de gaspiller du compute.
- Nettoyage automatique. Databricks supprime les matérialisations qu’un tableau de bord publié ne référencie plus, par exemple après la modification d’une définition ou l’annulation d’une publication.
La republication n’entraîne pas nécessairement le refresh des données matérialisées.
Limitations
La matérialisation des datasets présente les limitations suivantes :
- Tableaux de bord publiés uniquement. La matérialisation s'applique aux tableaux de bord publiés. Les brouillons continuent de query les données en direct.
- Aucun dataset paramétré. Les datasets qui définissent des parameter ne peuvent pas être matérialisés. Si vous activez la matérialisation pour un dataset comportant des parameter, Databricks indique qu’il a échoué au lieu de le matérialiser.
- Le refresh suit uniquement le calendrier du tableau de bord. Il n'y a pas de calendrier de refresh distinct par dataset. La matérialisation s'actualise selon la cadence de refresh planifiée de votre tableau de bord.
- Serverless obligatoire. La création initiale et les refreshes s’exécutent sur des LakeFlow Pipelines serverless, de sorte que le Workspace doit disposer d’un compute serverless activé.
- Les données protégées ne sont pas servies à partir des matérialisations. La matérialisation ne peut pas être créée pour les données sources protégées par la sécurité au niveau des lignes, les masques de colonnes ou les politiques de contrôle d'accès basé sur les attributs (ABAC). Si la sécurité au niveau des lignes est ajoutée à une table source après la création de la matérialisation, les requêtes ultérieures sur la vue métrique contournent la matérialisation et s'exécutent sur les données sources.
- Autorisations de partage de données requises. Vous pouvez activer la matérialisation uniquement lorsque vous publiez avec des autorisations de partage de données. Vous ne pouvez pas l’activer lorsque vous publiez avec des autorisations de données individuelles.
Questions fréquemment posées
Les questions suivantes portent sur le comportement de matérialisation des datasets, les refresh et les autorisations.
La matérialisation modifie-t-elle mes mesures ou mes résultats ?
La matérialisation préserve la logique de query du dataset, mais ses données reflètent le dernier refresh réussi. Pour les vues métriques locales, les mesures sont calculées au moment de la query par rapport aux données matérialisées. Découvrez ce qui est matérialisé.
Que se passe-t-il si une matérialisation n’est pas prête ou n’est pas disponible ?
Si une matérialisation n’est pas prête ou n’est pas disponible au moment de la query, celle-ci renvoie une erreur au lieu d’interroger des données en direct. Attendez que la matérialisation soit terminée, puis relancez la query.
Où les données matérialisées sont-elles stockées ?
Databricks stocke les données matérialisées dans un espace de stockage interne géré, associé à votre tableau de bord publié. Vous n’avez rien à publier dans Unity Catalog, et aucun schéma ni espace de stockage à gérer. L’accès continue de suivre les autorisations de votre tableau de bord et des données sous-jacentes.
À quelle fréquence les données matérialisées sont-elles refresh ?
Les données matérialisées s’actualisent selon le calendrier de refresh du tableau de bord. Voir Définir un calendrier de refresh.
Quel compute la matérialisation utilise-t-elle ?
La création initiale et les refresh s’exécutent tous deux sur des Lakeflow Pipelines Serverless gérés par Databricks. C’est pourquoi le compute serverless doit être activé dans le workspace.
La matérialisation affecte-t-elle les autorisations ?
Non. La matérialisation n’accorde pas d’accès supplémentaire aux données. L’accès respecte toujours la configuration de partage du tableau de bord et les autorisations utilisées pour le publier.
Que se passe-t-il lorsque je republie ?
Les matérialisations existantes peuvent être réutilisées lorsqu’un même utilisateur republie un dataset inchangé. Voir Réutilisation et nettoyage. Activez l’option Materialize datasets à chaque publication.