Servir des tables de fonctionnalités
Feature tables can be served in two ways:
- Model serving : déployez un modèle qui a été entraîné sur des tables de caractéristiques. Le même endpoint est utilisé à la fois pour la recherche de caractéristiques et pour l’inférence du modèle. L’Endpoint recherche ou compute automatiquement les valeurs des caractéristiques en utilisant la traçabilité enregistrée lors de l’enregistrement du modèle. Utilisez ceci pour servir les prédictions du modèle.
- Feature Serving : déployez un
FeatureSpecqui référence directement des tables de fonctionnalités, sans modèle. L’endpoint renvoie les sorties de fonctionnalités demandées. À utiliser lorsqu’une application a besoin de valeurs de fonctionnalités plutôt que de prédictions de modèle. Si vous utilisez finalement des fonctionnalités pour l’inférence de modèle, Databricks vous recommande d’utiliser directement le service de modèle.
Les deux approches prennent en charge les fonctionnalités précalculées et à la demande.
Exigences
- Databricks Runtime 14.2 ML ou version ultérieure.
- Pour utiliser l'API Python, Feature Serving nécessite
databricks-feature-engineeringversion 0.1.2 ou supérieur, qui est intégré à Databricks Runtime 14.2 ML. Pour les versions antérieures de Databricks Runtime ML, installez manuellement la version requise à l’aide de%pip install databricks-feature-engineering>=0.1.2. Si vous utilisez un notebook Databricks, vous devez ensuite redémarrer le noyau Python en exécutant cette commande dans une nouvelle cellule :dbutils.library.restartPython(). - Pour utiliser le SDK Databricks, Feature Serving nécessite
databricks-sdkversion 0.18.0 ou une version ultérieure. Pour installer manuellement la version requise, utilisez%pip install databricks-sdk>=0.18.0. Si vous utilisez un notebook Databricks, vous devez ensuite redémarrer le noyau Python en exécutant cette commande dans une nouvelle cellule :dbutils.library.restartPython().
Databricks Feature Serving offre une interface utilisateur et plusieurs options programmatiques pour créer, mettre à jour, interroger et supprimer des endpoints. Cet article comprend des instructions pour chacune des options suivantes :
- Interface utilisateur Databricks
- API REST
- API Python
- Databricks SDK
Pour utiliser l’API REST ou le SDK MLflow Deployments, vous devez disposer d’un jeton d’API Databricks.
Authentification pour Feature Serving
Pour en savoir plus sur l'authentification, consultez Autoriser l'accès aux ressources Databricks.
Créer un FeatureSpec
Un FeatureSpec est un ensemble de fonctionnalités et de fonctions défini par l'utilisateur. Vous pouvez combiner des fonctionnalités et des fonctions dans un FeatureSpec. FeatureSpecs sont stockés et gérés par Unity Catalog et apparaissent dans l’Explorateur de catalogues.
Les tables spécifiées dans un FeatureSpec doivent être publiées dans un magasin de fonctionnalités en ligne ou dans un magasin en ligne tiers. Consultez les magasins de fonctionnalités en ligne Databricks.
Vous devez utiliser le package databricks-feature-engineering pour créer un FeatureSpec.
Tout d'abord, définissez la fonction :
from unitycatalog.ai.core.databricks import DatabricksFunctionClient

client = DatabricksFunctionClient()

CATALOG = "main"
SCHEMA = "default"

def difference(num_1: float, num_2: float) -> float:
  """
  A function that accepts two floating point numbers, subtracts the second one
  from the first, and returns the result as a float.

  Args:
      num_1 (float): The first number.
      num_2 (float): The second number.

  Returns:
      float: The resulting difference of the two input numbers.
  """
  return num_1 - num_2

client.create_python_function(
  func=difference,
  catalog=CATALOG,
  schema=SCHEMA,
  replace=True
)
Ensuite, vous pouvez utiliser la fonction dans un FeatureSpec:
from databricks.feature_engineering import (
  FeatureFunction,
  FeatureLookup,
  FeatureEngineeringClient,
)

fe = FeatureEngineeringClient()

features = [
  # Lookup column `average_yearly_spend` and `country` from a table in UC by the input `user_id`.
  FeatureLookup(
    table_name="main.default.customer_profile",
    lookup_key="user_id",
    feature_names=["average_yearly_spend", "country"]
  ),
  # Calculate a new feature called `spending_gap` - the difference between `ytd_spend` and `average_yearly_spend`.
  FeatureFunction(
    udf_name="main.default.difference",
    output_name="spending_gap",
    # Bind the function parameter with input from other features or from request.
    # The function calculates num_1 - num_2.
    input_bindings={"num_1": "ytd_spend", "num_2": "average_yearly_spend"},
  ),
]

# Create a `FeatureSpec` with the features defined above.
# The `FeatureSpec` can be accessed in Unity Catalog as a function.
fe.create_feature_spec(
  name="main.default.customer_features",
  features=features,
)
Spécifier les valeurs default
Pour spécifier les valeurs default des fonctionnalités, utilisez le paramètre default_values dans le FeatureLookup. Voir l'exemple suivant :
feature_lookups = [
    FeatureLookup(
        table_name="ml.recommender_system.customer_features",
        feature_names=[
            "membership_tier",
            "age",
            "page_views_count_30days",
        ],
        lookup_key="customer_id",
        default_values={
          "age": 18,
          "membership_tier": "bronze"
        },
    ),
]
Si les colonnes de features sont renommées en utilisant le parameter rename_outputs, default_values doit utiliser les noms de features renommées.
FeatureLookup(
  table_name = 'main.default.table',
  feature_names = ['materialized_feature_value'],
  lookup_key = 'id',
  rename_outputs={"materialized_feature_value": "feature_value"},
  default_values={
    "feature_value": 0
  }
)
Ajouter des dépendances Python
Si une fonction définie par l’utilisateur (UDF) importe des packages Python, déclarez-les lorsque vous créez FeatureSpec. Le paramètre extra_pip_requirements nécessite databricks-feature-engineering version 0,17,0 ou supérieure. Feature Serving installe automatiquement les packages MLflow et databricks-feature-lookup.
Par exemple, si une UDF dans votre spécification de fonctionnalité importe NumPy, ajoutez l'exigence à la spécification :
fe.create_feature_spec(
    name="main.default.customer_features_with_dependencies",
    features=features,
    extra_pip_requirements=["numpy==1.26.4"],
)
Utilisez main.default.customer_features_with_dependencies comme nom de spécification lorsque vous créez l’endpoint.
Chaque entrée de extra_pip_requirements doit être une chaîne de exigences PyPI, telle que numpy==1.26.4, ou un chemin d'accès vers un fichier .whl dans un volume Unity Catalog. Par exemple, utilisez /Volumes/main/libraries/wheels/custom_features-1.0.0-py3-none-any.whl pour une roue que vous avez upload. Le créateur de l'Endpoint doit disposer de READ VOLUME sur le volume ainsi que de USE CATALOG et USE SCHEMA sur son catalogue et son schéma parents.
Pour les packages provenant d'un repository privé, configurez le dépôt de packages par default du Workspace. N'incluez pas d'options de commande pip, telles que --index-url, dans extra_pip_requirements.
Les dépendances dans la clause ENVIRONMENT d'une UDF Unity Catalog s'appliquent à l'exécution SQL hors ligne. Feature Serving ne les copie pas automatiquement. Déclarez chaque package requis par les UDF, y compris les UDF dans les fonctionnalités amont, dans les exigences de la spécification de fonctionnalité.
Si le déploiement de l'endpoint échoue, inspectez les logs de build pour détecter les erreurs d'installation de package, les conflits de version ou les échecs d'accès aux wheel. Consultez Monitor model quality and endpoint health.
Pour un exemple avec CustomUDF et FeatureViewSource, consultez Servir des fonctionnalités CustomUDF et leurs dépendances. Pour les dépendances du service de modèle, consultez Dépendances UDF personnalisées.
Créer un endpoint
Le FeatureSpec définit l'Endpoint. Pour plus d'informations, consultez Créer des endpoints de déploiement de modèles personnalisés, la documentation de l'API Python, ou la documentation du SDK Databricks pour plus de détails.
Pour les charges de travail sensibles à la latence ou nécessitant un nombre élevé de requêtes par seconde, Model Serving offre l'optimisation du routage sur les endpoints de Model Serving personnalisés, consultez Optimisation du routage sur les endpoints de service.
- Databricks SDK - Python
- Python API
- REST API
from databricks.sdk import WorkspaceClient
from databricks.sdk.service.serving import EndpointCoreConfigInput, ServedEntityInput

workspace = WorkspaceClient()

# Create endpoint
workspace.serving_endpoints.create(
  name="my-serving-endpoint",
  config = EndpointCoreConfigInput(
    served_entities=[
    ServedEntityInput(
        entity_name="main.default.customer_features",
        scale_to_zero_enabled=True,
        workload_size="Small"
      )
    ]
  )
)
from databricks.feature_engineering.entities.feature_serving_endpoint import (
  ServedEntity,
  EndpointCoreConfig,
)

fe.create_feature_serving_endpoint(
  name="customer-features",
    config=EndpointCoreConfig(
    served_entities=ServedEntity(
      feature_spec_name="main.default.customer_features",
             workload_size="Small",
             scale_to_zero_enabled=True,
             instance_profile_arn=None,
    )
  )
)
curl -X POST -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints \
    -H 'Content-Type: application/json' \
    -d '"name": "customer-features",
   "config": {
       "served_entities": [
           {
               "entity_name": "main.default.customer_features",
               "workload_size": "Small",
               "scale_to_zero_enabled": true
           }
       ]
   }'
Pour voir l’endpoint, cliquez sur Serving dans la barre latérale gauche de l’interface utilisateur de Databricks. Lorsque l'état est Ready , l'Endpoint est prêt à répondre aux queries. Pour en savoir plus sur Model Serving, consultez Model Serving.
Obtenir un Endpoint
Vous pouvez utiliser le Databricks SDK ou l'API Python pour obtenir les métadonnées et le statut d'un Endpoint.
- Databricks SDK - Python
- Python API
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

endpoint = workspace.serving_endpoints.get(name="customer-features")
# print(endpoint)
endpoint = fe.get_feature_serving_endpoint(name="customer-features")
# print(endpoint)
Obtenir le schéma d'un Endpoint
Vous pouvez utiliser le SDK Databricks ou l'API REST pour obtenir le schéma d'un Endpoint. Pour plus d'informations sur le schéma de l'endpoint, consultez Obtenir un schéma d'endpoint de diffusion de modèle.
- Databricks SDK - Python
- REST API
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

# Create endpoint
endpoint = workspace.serving_endpoints.get_open_api(name="customer-features")
ACCESS_TOKEN=<token>
ENDPOINT_NAME=<endpoint name>

curl "https://example.databricks.com/api/2.0/serving-endpoints/$ENDPOINT_NAME/openapi" -H "Authorization: Bearer $ACCESS_TOKEN" -H "Content-Type: application/json"
Query un Endpoint
Vous pouvez utiliser l'API REST, le SDK de déploiement MLflow ou l'interface utilisateur de Serving pour interroger un endpoint.
Le code suivant montre comment configurer les identifiants et créer le client lors de l'utilisation du SDK de déploiement MLflow.
  # Set up credentials
  export DATABRICKS_HOST=...
  export DATABRICKS_TOKEN=...
  # Set up the client
  import mlflow.deployments

  client = mlflow.deployments.get_deploy_client("databricks")
Comme bonne pratique de sécurité, lorsque vous vous authentifiez avec des outils, systèmes, scripts et applications automatisés, Databricks vous recommande d'utiliser des jetons d'accès personnels appartenant aux Service Principal plutôt qu'aux utilisateurs de Workspace. Pour créer des jetons pour les Service Principals, consultez Gérer les jetons pour un Service Principal.
Interroger un Endpoint à l'aide des APIs
Cette section comprend des exemples d'interrogation d'un Endpoint à l'aide de l'API REST ou du SDK de déploiements MLflow.
- MLflow Deployments SDK
- REST API
L'exemple suivant utilise predict() l'API du SDK MLflow Deployments. Cette API est Expérimentale et la définition de l'API peut changer.
import mlflow.deployments

client = mlflow.deployments.get_deploy_client("databricks")
response = client.predict(
    endpoint="test-feature-endpoint",
    inputs={
        "dataframe_records": [
            {"user_id": 1, "ytd_spend": 598},
            {"user_id": 2, "ytd_spend": 280},
        ]
    },
)
curl -X POST -u token:$DATABRICKS_API_TOKEN $ENDPOINT_INVOCATION_URL \
  -H 'Content-Type: application/json' \
  -d '{"dataframe_records": [
          {"user_id": 1, "ytd_spend": 598},
          {"user_id": 2, "ytd_spend": 280}
      ]}'
Interroger un Endpoint à l'aide de l'interface utilisateur
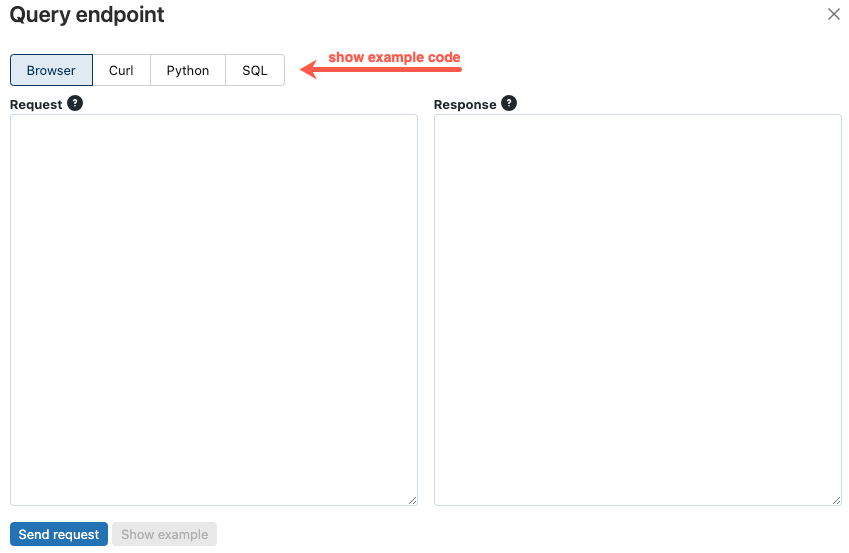
Vous pouvez interroger un endpoint de service directement depuis l’interface utilisateur de mise en service. L’interface utilisateur comprend des exemples de code généré que vous pouvez utiliser pour interroger l’endpoint.
-
Dans la barre latérale gauche du workspace Databricks, cliquez sur **Serving**.
-
Cliquez sur l'Endpoint que vous souhaitez query.
-
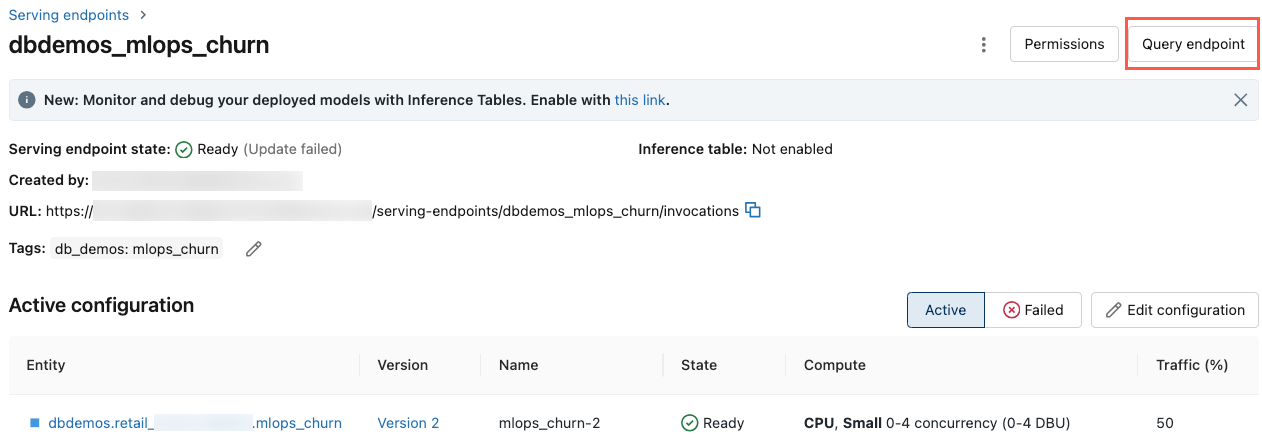
Dans le coin supérieur droit de l'écran, cliquez sur Endpoint de requête .
-
Dans le champ Requête , saisissez le corps de la requête au format JSON.
-
Cliquez sur Envoyer la demande .
// Example of a request body.
{
  "dataframe_records": [
    { "user_id": 1, "ytd_spend": 598 },
    { "user_id": 2, "ytd_spend": 280 }
  ]
}
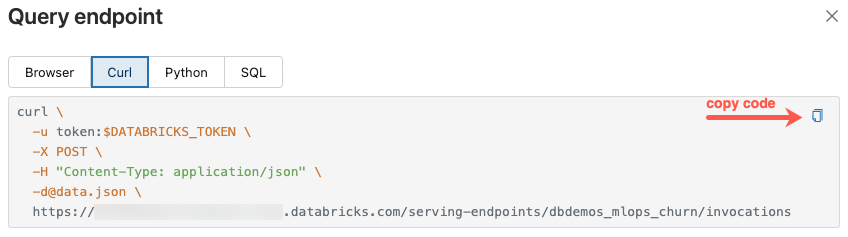
La boîte de dialogue Query endpoint inclut du code d'exemple généré en curl, Python et SQL. Cliquez sur les tab pour afficher et copier le code d'exemple.
Pour copier le code, cliquez sur l'icône de copie en haut à droite de la zone de texte.
Mettre à jour un Endpoint
Pour modifier la configuration d'un Endpoint Feature Serving (tel que le changement du FeatureSpec ou de la taille de la charge de travail), utilisez toujours les APIs de mise à jour décrites dans cette section. Ne supprimez pas et ne recréez pas l'endpoint pour appliquer les modifications. La suppression d'un Endpoint en production entraîne un temps d'arrêt immédiat et interrompt toutes les applications qui le query.
Vous pouvez mettre à jour un Endpoint à l'aide de l'API REST, du Databricks SDK ou de l'interface utilisateur de Serving.
Mettre à jour un Endpoint à l'aide des APIs
- Databricks SDK - Python
- REST API
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

workspace.serving_endpoints.update_config(
  name="my-serving-endpoint",
  served_entities=[
    ServedEntityInput(
      entity_name="main.default.customer_features",
      scale_to_zero_enabled=True,
      workload_size="Small"
    )
  ]
)
curl -X PUT -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints/<endpoint_name>/config \
  -H 'Content-Type: application/json' \
  -d '"served_entities": [
        {
            "name": "customer-features",
            "entity_name": "main.default.customer_features_new",
            "workload_size": "Small",
            "scale_to_zero_enabled": True
        }
    ]'
Mettre à jour un endpoint à l'aide de l'UI
Suivez ces étapes pour utiliser l'interface utilisateur de Serving :
- Dans la barre latérale gauche du workspace Databricks, cliquez sur **Serving**.
- Dans le tableau, cliquez sur le nom de l'Endpoint que vous souhaitez mettre à jour. L'écran de l'Endpoint apparaît.
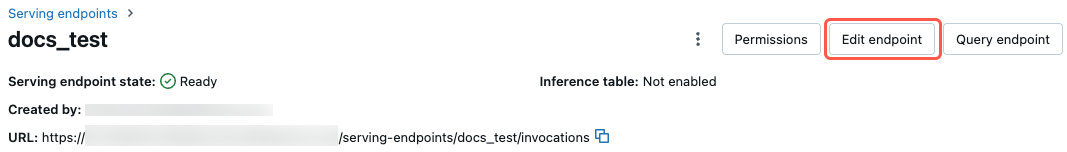
- Dans le coin supérieur droit de l’écran, cliquez sur Modifier l’endpoint .
- Dans la boîte de dialogue **Modifier l'endpoint de déploiement**, modifiez les paramètres de l'endpoint selon les besoins.
- Cliquez sur Mettre à jour pour enregistrer vos modifications.
Mettre à jour les dépendances d'un Endpoint Feature Serving en ligne
Un endpoint de Feature Serving résout ses dépendances lors de sa première création et déploiement : les privilèges dont son Service Principal a besoin pour lire la table en ligne (USE CATALOG, USE SCHEMA et SELECT), et EXECUTE sur la UDF Unity Catalog décrite dans son FeatureSpec. L'endpoint fixe ces autorisations au moment de la génération et ne les résout pas à nouveau lors d'un redéploiement ou d'un redémarrage simple. Si vous recréez la table en ligne ou la UDF, l'endpoint perd son autorisation dessus. Si vous mettez à jour la UDF sur place, l'endpoint continue d'exécuter la version originale. Les recherches de features peuvent échouer, ou utiliser silencieusement l'ancienne logique de UDF, même si l'endpoint continue d'afficher Prêt .
Pour les tables en ligne et les UDF à la demande, Databricks recommande une migration avec version : créez une nouvelle version de la dépendance, créez un nouvel endpoint basé dessus et migrez le trafic vers le nouvel endpoint. Cela vous aide à éviter les temps d'arrêt et les modes de défaillance décrits dans cette section.
Recréer une table en ligne
Ne supprimez pas et ne recréez pas une table en ligne sur place sous un endpoint de Feature Serving en direct.
Lorsque vous créez un endpoint, Model Serving accorde au Service Principal de l’endpoint USE CATALOG sur le catalogue de la table en ligne, USE SCHEMA sur son schéma et SELECT sur la table en ligne. La suppression et la recréation de la table, même avec le même nom, crée un nouvel élément sécurisable dans Unity Catalog. La concession SELECT n’est donc pas reportée. Le Service Principal perd l’accès à la table, la génération du jeton OAuth échoue et la connexion au magasin en ligne utilise l’authentification par mot de passe, ce qui échoue également. Les recherches de fonctionnalités échouent alors avec des erreurs telles que KeyError: 'OAUTH_TOKEN' ou password authentication failed.
Ces échecs sont faciles à manquer : l’endpoint signale toujours Prêt et le pipeline de synchronisation affiche toujours des exécutions réussies, alors que les recherches échouent. La modification du mode de synchronisation d'une table en ligne (par exemple, entre CONTINUOUS et SNAPSHOT) ne peut pas être effectuée sur place et nécessite de recréer la table, ce qui peut également déclencher ce problème.
Un endpoint ne lit pas une table en ligne spécifique. Il recherche les fonctionnalités dans la table de fonctionnalités hors ligne nommée dans son FeatureSpec, et lorsqu'une table de fonctionnalités est publiée sur plus d'une table en ligne, le endpoint utilise la plus ancienne. La publication de la même table de fonctionnalités sur une deuxième table en ligne ne déplace pas un endpoint vers la nouvelle table en ligne. Voir Limites du magasin de fonctionnalités en ligne.
Pour minimiser les temps d'arrêt, versionnez la table de fonctionnalités hors ligne ainsi que la table en ligne :
- Créez une nouvelle table de fonctionnalités hors connexion et incluez la version dans son nom (par exemple,
customer_features_v2). - Publiez la nouvelle table de fonctionnalités sur une nouvelle table en ligne. Voir Publier une table de fonctionnalités.
- Créez une nouvelle
FeatureSpecqui utilise la nouvelle table de fonctionnalités et créez un nouvel endpoint Feature Serving qui la dessert. - Migrer le trafic vers le nouvel endpoint. Une fois que l'ancien endpoint ne reçoit plus de trafic, supprimez-le ainsi que sa table en ligne.
Mettre à jour une UDF à la demande
Ne modifiez pas une UDF Unity Catalog utilisée par un FeatureSpec sur place.
Une UDF à la demande de FeatureSpec est intégrée au endpoint de service au moment du déploiement. Une simple refresh ou un redéploiement réutilise la même UDF dans cette image de service. Une mise à jour sur place de l’UDF sous le même nom ne prend pas effet. Si vous supprimez et recréez l’UDF, le endpoint perd aussi EXECUTE sur celle-ci, donc les recherches qui utilisent l’UDF échouent.
FeatureSpecs et UDF n’ont pas de champ de version, donc version par nom : créez une nouvelle UDF et une nouvelle FeatureSpec, créez un nouvel endpoint qui utilise la nouvelle FeatureSpec et migrez le trafic vers celui-ci. Voir Créer un FeatureSpec.
Voir Calcul de fonctionnalités à la demande.
Récupérer un endpoint après une modification sur place
Si vous avez déjà modifié une dépendance sur place, reconstruisez l'endpoint pour qu'il résolve à nouveau ses dépendances. Créez un nouveau FeatureSpec (ou, pour un endpoint de Model Serving, enregistrez une nouvelle version de modèle) et mettez à jour l’endpoint pour le servir. Le changement de ce que l'endpoint sert reconstruit l'endpoint, ce qui provisionne un nouveau Service Principal et réexécute la configuration des permissions. Aucune de ces méthodes ne reconstruit l'endpoint de manière fiable : l'arrêter et le démarrer, un simple redéploiement ou la modification d'une variable d'environnement.
Supprimer un endpoint
Cette action est irréversible. La suppression d'un endpoint Feature Serving entraîne une indisponibilité immédiate pour toute application l'interrogeant. Si vous souhaitez modifier la configuration de l'endpoint, utilisez Mettre à jour un endpoint au lieu de supprimer et recréer l'endpoint.
Vous pouvez supprimer un Endpoint en utilisant l'API REST, le SDK Databricks, l'API Python ou l'interface utilisateur de Serving.
Supprimer un endpoint à l'aide d'APIs
- Databricks SDK - Python
- Python API
- REST API
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

workspace.serving_endpoints.delete(name="customer-features")
fe.delete_feature_serving_endpoint(name="customer-features")
curl -X DELETE -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints/<endpoint_name>
Supprimer un endpoint via l'interface utilisateur
Suivez ces étapes pour supprimer un Endpoint à l'aide de l'interface utilisateur de service :
- Dans la barre latérale gauche du workspace Databricks, cliquez sur **Serving**.
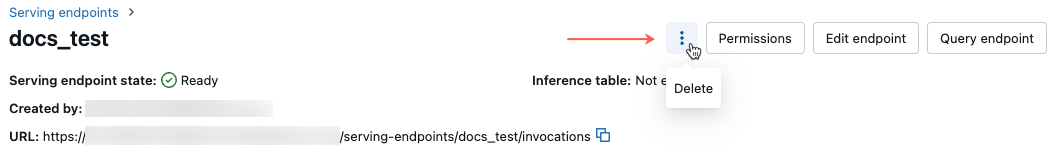
- Dans le tableau, cliquez sur le nom de l’Endpoint que vous souhaitez supprimer. L'écran de l'Endpoint apparaît.
- Dans le coin supérieur droit de l'écran, cliquez sur le menu kebab
 et sélectionnez Supprimer .
Surveiller l'état de santé d'un Endpoint
Pour plus d'informations sur les Logs et les métriques disponibles pour les Endpoint Feature Serving, consultez Surveiller la qualité du modèle et la santé des Endpoint.
Contrôle d'accès
Pour plus d'informations sur les autorisations sur les Endpoint Feature Serving, voir Gérer les autorisations sur un Endpoint de déploiement de modèle.
Exemple de Notebook
Ce Notebook illustre comment utiliser le SDK Databricks pour créer un Endpoint Feature Serving à l'aide du Magasin de fonctionnalités en ligne Databricks.