Référence de l'API Feature Views
Aperçu
Cette fonctionnalité est en Aperçu public. Les administrateurs du Workspace peuvent contrôler l'accès à cette fonctionnalité à partir de la page Previews . Consultez Gérer les aperçus Databricks.
Contrôle d'accès
Les fonctionnalités sont des objets Unity Catalog gouvernables. L’accès à une fonctionnalité est contrôlé par les privilèges CREATE FEATURE, READ FEATURE et MANAGE Unity Catalog. Pour une description complète, consultez la référence des privilèges de Unity Catalog.
CREATE FEATURE: requis pour créer une fonctionnalité dans un schéma.create_featureetregister_featurenécessitentCREATE FEATUREsur le schéma parent. Conformément au principe du moindre privilège, accordezCREATE FEATUREau niveau du schéma ; vous pouvez également l'accorder sur un catalogue pour permettre la création de fonctionnalités dans n'importe quel schéma de ce catalogue.READ FEATURE: Required to read feature metadata.get_feature,create_training_set, andlist_materialized_featuresrequireREAD FEATUREon the feature. This privilege does not grant access to feature data in source or materialized output tables. To read that data for training or serving, you must also haveSELECTon the applicable tables.READ FEATUREgranted on a schema or catalog applies to all current and future features it contains.MANAGE: requis pour gérer le cycle de vie et les attributions d’une fonctionnalité. La suppression d’une fonctionnalité avecdelete_featureet la matérialisation d’une fonctionnalité avecmaterialize_featuresnécessitentMANAGEsur la fonctionnalité. La suppression d’une fonctionnalité matérialisée avecdelete_materialized_featuren’est pas régie parMANAGE: seul le créateur de la fonctionnalité matérialisée peut la supprimer.
Toutes les opérations de fonctionnalités nécessitent également USE CATALOG sur le catalogue parent et USE SCHEMA sur le schéma parent. Pour savoir comment MANAGE et READ FEATURE s'appliquent à la matérialisation, consultez Autorisations.
API Feature View
Feature constructeur et register_feature()
L’approche recommandée consiste à construire un objet Feature localement et à utiliser register_feature pour le rendre persistant dans Unity Catalog. Ce workflow en deux étapes vous permet d'expérimenter les fonctionnalités (y compris create_training_set) avant de les enregistrer.
Feature(
    source: DataSource,                                    # Required: DeltaTableSource, StreamSource, RequestSource, or FeatureViewSource
    function: Union[AggregationFunction, ColumnSelection, CustomUDF], # Required for all features
    entity: Optional[List[str]] = None,                    # Required for DeltaTableSource and StreamSource
    timeseries_column: Optional[str] = None,               # Required for DeltaTableSource and StreamSource
    name: Optional[str] = None,                            # Optional: Feature name (auto-generated if omitted)
    description: Optional[str] = None,                     # Optional: Feature description
)
FeatureEngineeringClient.register_feature() enregistre un Feature construit localement dans Unity Catalog.
FeatureEngineeringClient.register_feature(
    feature: Feature,       # Required: A Feature instance (not already registered)
    catalog_name: str,      # Required: UC catalog name
    schema_name: str,       # Required: UC schema name
) -> Feature
from databricks.feature_engineering.entities import Feature, DeltaTableSource, AggregationFunction, Sum, RollingWindow
from datetime import timedelta

# Step 1: Construct the feature locally
feature = Feature(
    source=DeltaTableSource(catalog_name="main", schema_name="store", table_name="transactions"),
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)

# Step 2: Register in Unity Catalog
fe = FeatureEngineeringClient()
registered_feature = fe.register_feature(
    feature=feature,
    catalog_name="main",
    schema_name="store",
)
create_feature()
FeatureEngineeringClient.create_feature() valide, construit et enregistre immédiatement une fonctionnalité dans Unity Catalog en une seule étape. Utilisez ceci lorsque vous n'avez pas besoin d'expérimenter la fonctionnalité localement en premier.
FeatureEngineeringClient.create_feature(
    source: DataSource,                                    # Required: DeltaTableSource, StreamSource, RequestSource, or FeatureViewSource
    function: Union[AggregationFunction, ColumnSelection, CustomUDF], # Required for all features
    catalog_name: str,                                     # Required: The catalog name for the feature
    schema_name: str,                                      # Required: The schema name for the feature
    entity: Optional[List[str]] = None,                    # Required for DeltaTableSource and StreamSource
    timeseries_column: Optional[str] = None,               # Required for DeltaTableSource and StreamSource
    name: Optional[str] = None,                            # Optional: Feature name (auto-generated if omitted)
    description: Optional[str] = None,                     # Optional: Feature description
) -> Feature
Paramètres :
source: source de données utilisée lors du calcul des fonctionnalités (DeltaTableSource,StreamSource,RequestSourceouFeatureViewSource).function:AggregationFunctionqui regroupe un opérateur et une fenêtre temporelle,ColumnSelection("column_name")pour les caractéristiques de transmission (pass-through) ouCustomUDFpour les transformations ligne par ligne. Consultez Supported functions pour connaître les types de source compatibles.catalog_name: le nom du catalogue Unity Catalog pour la fonctionnalité.schema_name: Le nom de schéma Unity Catalog pour la fonctionnalité.entity: Liste des noms de colonnes qui définissent les clés d’agrégation ou de recherche (clés primaires). Requis pourDeltaTableSourceetStreamSource. Par exemple,["user_id"]agrège ou effectue des recherches par utilisateur. À omettre pourRequestSourceetFeatureViewSource.timeseries_column: colonne de timestamp utilisée pour l'agrégation par fenêtre temporelle ou la sélection de la valeur la plus récente. Requis pourDeltaTableSourceetStreamSource. À omettre pourRequestSourceetFeatureViewSource.name: Nom de fonctionnalité facultatif. S'il est omis, il est généré automatiquement à partir de la colonne d'entrée, de la fonction et de la fenêtre (par exemple,amount_avg_rolling_7d).description: Description facultative de la fonctionnalité.
Renvoie : Une instance de Feature validée
**Génère :** ValueError si une validation échoue
delete_feature()
Supprime une fonctionnalité de Unity Catalog par son nom entièrement qualifié.
FeatureEngineeringClient.delete_feature(
    full_name: str,  # Required: '<catalog>.<schema>.<feature_name>'
) -> None
fe.delete_feature(full_name="main.store.amount_sum_rolling_7d")
Avant de supprimer une fonctionnalité, supprimez ou mettez à jour tous les modèles ou spécifications de fonctionnalités qui y font référence. Une fonctionnalité ne peut pas être supprimée tant qu’elle comporte encore des fonctionnalités matérialisées. Supprimez d’abord les fonctionnalités matérialisées, puis supprimez la fonctionnalité. Consultez la page How to delete a materialized feature.
Noms générés automatiquement
Lorsque name est omis, un nom est automatiquement généré. Les noms générés suivent le modèle : {column}_{function}_{window}. Par exemple :
price_avg_rolling_1h(Prix moyen sur 1 heure)transaction_count_rolling_30d_1d(Nombre de transactions sur 30 jours avec un délai de 1 jour à partir du timestamp de l'événement)
Fonctions prises en charge
Fonctions d'agrégation
Les fonctions d’agrégation sont encapsulées dans un AggregationFunction avec une fenêtre temporelle, comme décrit dans les fenêtres temporelles. Chaque fonction prend un paramètre input spécifiant la colonne source à agréger.
Fonction | Description | Exemple de cas d'usage |
|---|---|---|
| Total des valeurs | Utilisation quotidienne de l'application par utilisateur en minutes. |
| Moyenne des valeurs | Montant moyen des transactions |
| Nombre d'enregistrements | Nombre de connexions par utilisateur. |
| Valeur minimale | Fréquence cardiaque la plus basse enregistrée par un appareil portable |
| Valeur maximale | Montant maximal des transactions par session |
| Écart-type de la population | Variabilité quotidienne du montant des transactions pour tous les clients |
| Écart-type échantillon | Variabilité des taux de clics des campagnes publicitaires |
| Variance de la population | Répartition des relevés de capteurs pour les appareils IoT dans une usine |
| Variance d'échantillon | Répartition des évaluations de films sur un groupe échantillonné |
| Nombre approximatif unique | Nombre distinct d'articles achetés |
| Percentile approximatif | latence de réponse p95 |
| Première valeur | Première Timestamp de connexion |
| Dernière valeur | Montant du dernier achat |
| Premières | Trois premiers produits consultés au cours d'une session |
| Dernières | Trois statuts de ticket de support les plus récents |
| Premières | Trois premières catégories de produit distinctes consultées |
| Dernières | Trois catégories de marchands distinctes les plus récentes |
First, Last, FirstN, LastN, FirstDistinct et LastDistinct incluent les valeurs nulles par default. Pour ignorer les valeurs nulles, ajoutez un filter_condition qui exclut explicitement les colonnes d'entrée qui sont nulles.
FirstN, LastN, FirstDistinct et LastDistinct utilisent le timeseries_column de la fonctionnalité pour ordonner les lignes d'entrée et renvoyer un tableau contenant jusqu'à n valeurs. Le paramètre n doit être un nombre entier positif. FirstN et FirstDistinct sélectionnent les valeurs de la plus ancienne à la plus récente. LastN et LastDistinct sélectionnent les valeurs de la plus récente à la plus ancienne, puis renvoient les valeurs sélectionnées dans l'ordre du Timestamp. FirstDistinct et LastDistinct suppriment les valeurs dupliquées lors de la sélection des valeurs dans cette direction.
Par exemple, si les lignes sources d'une entité sont ordonnées par event_time comme ["A", "A", "B", "C", "B", "B"], les fonctions suivantes renvoient :
Fonction | Résultat |
|---|---|
|
|
|
|
|
|
|
|
FirstN, LastN, FirstDistinct et LastDistinct nécessitent la version databricks-feature-engineering 0.17.0 ou ultérieure.
CustomUDF
CustomUDF applique une fonction personnalisée (UDF) Python Unity Catalog enregistrée à chaque ligne. Utilisez-le pour transformer les entrées de requêtes ou combiner des valeurs de variables. Il n'agrège pas de lignes et ne définit pas de fenêtre temporelle.
CustomUDF(
    function_name="main.ecommerce.log_amount_udf",
    input_bindings={"amount": "transaction_amount"},
)
input_bindings associe chaque nom de parameter de UDF à une entrée. Pour RequestSource, l'entrée est un nom de colonne source. Pour FeatureViewSource, il s'agit d'une référence de fonctionnalité en amont. Associez chaque parameter de UDF, y compris les parameters avec des default. Les types d'entrée doivent correspondre exactement aux types de parameter de UDF, sans conversion numérique implicite. Utilisez des types d'entrée et de renvoi scalaires.
Source | Comportement |
|---|---|
| Transforme les colonnes du DataFrame d'entraînement ou de la requête d'inférence. |
| Combine les valeurs de fonctionnalités en amont. Voir FeatureViewSource. |
Les fonctionnalités CustomUDF s'appuyant sur Delta ne peuvent pas être matérialisées ou servies en ligne. Pour transformer des valeurs de fonctionnalités s'appuyant sur des tables pour l'entraînement et le service, définissez une agrégation s'appuyant sur Delta ou une sélection de colonnes de fonctionnalités et référencez-la via FeatureViewSource.
CustomUDF n’est pas pris en charge avec StreamSource. Pour transformer la sortie d’une caractéristique de streaming, faites référence à cette caractéristique via FeatureViewSource.
CustomUDF avec RequestSource requiert databricks-feature-engineering version 0.17.0 ou ultérieure.
Pour utiliser une CustomUDF, vous avez besoin du privilège EXECUTE sur l'UDF, du privilège USE CATALOG sur son catalogue parent et du privilège USE SCHEMA sur son schéma parent.
L’exemple suivant utilise NumPy pour calculer log(1 + amount), réduisant la monter en charge des montants de transactions importants. Exécutez-le sur le compute serverless avec les dépendances de UDF personnalisées activées. Le schéma main.ecommerce doit exister.
spark.sql("""
CREATE OR REPLACE FUNCTION main.ecommerce.log_amount_udf(amount DOUBLE)
RETURNS DOUBLE
LANGUAGE PYTHON
ENVIRONMENT (
  dependencies = '["numpy==1.26.4"]',
  environment_version = '5'
)
AS $$
import numpy as np

if amount is None or not np.isfinite(amount) or amount < 0:
    return None
return float(np.log1p(amount))
$$
""")
Enregistrez une feature qui lie la colonne de requête transaction_amount au parameter de l’UDF amount:
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    CustomUDF, FieldDefinition, RequestSource, ScalarDataType,
)

fe = FeatureEngineeringClient()

log_transaction_amount = fe.create_feature(
    source=RequestSource(
        schema=[
            FieldDefinition(name="transaction_amount", data_type=ScalarDataType.DOUBLE),
        ]
    ),
    function=CustomUDF(
        function_name="main.ecommerce.log_amount_udf",
        input_bindings={"amount": "transaction_amount"},
    ),
    catalog_name="main",
    schema_name="ecommerce",
    name="log_transaction_amount",
)
La configuration ENVIRONMENT de l'UDF configure les dépendances pour le calcul hors ligne. For online serving, also declare the packages in create_feature_spec(extra_pip_requirements=...) or log_model(extra_pip_requirements=...). Elles ne sont pas copiées automatiquement à partir de l'UDF. See Feature Serving dependencies and model dependencies.
CustomUDF les features ne peuvent pas être matérialisées. Les UDF adossées à une requête et adossées à une feature s’exécutent à la demande pendant l’entraînement et le service. Chaque UDF d'une chaîne de dépendance ajoute du calcul, veillez donc à ce que les fonctions et les chaînes restent de petite taille. Les UDF doivent gérer les entrées manquantes, qui peuvent être None hors ligne ou NaN en ligne.
Pour obtenir des conseils sur la gestion des valeurs manquantes, consultez On-demand feature computation.
ColumnSelection (transmission)
ColumnSelection sélectionne une seule colonne d'une source sans appliquer d'agrégation. Il est directement inclus dans le paramètre function (et non dans AggregationFunction). Le type de retour est inféré du schéma source.
Fonction | Description | Exemple de cas d'usage |
|---|---|---|
| Dernière valeur d'une colonne (pas d'agrégation) | Catégorie de fournisseur la plus récente, transmission directe d'un champ de requête |
ColumnSelection prend en charge les sources de données suivantes :
DeltaTableSource: Renvoie la dernière valeur par clé d'entité via une jointure à un instant T (pas d'agrégation de fenêtre de recherche).StreamSource: renvoie la dernière valeur par clé d'entité à partir du Stream (aucune agrégation de fenêtre rétrospective).RequestSource** ** : Transmet la valeur fournie au moment de l'inférence (ou extraite du DataFrame étiqueté au moment de l'entraînement).
Pour un DeltaTableSource, les fonctionnalités ColumnSelection prennent en charge filter_condition et transformation_sql, avant la sélection de la valeur la plus récente, comme les fonctionnalités d’agrégation.
from databricks.feature_engineering.entities import (
    ColumnSelection, DeltaTableSource, Feature, FieldDefinition,
    RequestSource, ScalarDataType,
)

delta_source = DeltaTableSource(
    catalog_name="main", schema_name="feature_store", table_name="transactions",
)

request_source = RequestSource(
    schema=[
        FieldDefinition(name="session_duration", data_type=ScalarDataType.DOUBLE),
    ]
)

# ColumnSelection from a Delta table
latest_amount = Feature(
    source=delta_source,
    function=ColumnSelection("amount"),
    entity=["user_id"],
    timeseries_column="transaction_time",
    name="latest_transaction_amount",
)

# ColumnSelection from a RequestSource
session_feature = Feature(
    source=request_source,
    function=ColumnSelection("session_duration"),
    name="session_duration",
)
Exemple : fonctionnalités de sélection d'agrégation et de colonne
L'exemple suivant montre les fonctionnalités définies sur la même source de données.
from databricks.feature_engineering.entities import (
    AggregationFunction, Feature, Sum, Avg, ApproxCountDistinct,
    ColumnSelection, RollingWindow,
)
from datetime import timedelta

window = RollingWindow(window_duration=timedelta(days=7))

sum_feature = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(Sum(input="amount"), window),
)

avg_feature = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(Avg(input="amount"), window),
)

distinct_count = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(ApproxCountDistinct(input="product_id", relativeSD=0.01), window),
)

# Column selection (no aggregation, no time window)
latest_amount = Feature(
    source=source,
    function=ColumnSelection("amount"),
    entity=["user_id"],
    timeseries_column="event_time",
    name="latest_amount",
)
Fonctionnalités avec conditions de filtre
Le parameter filter_condition vous permet de filtrer les lignes de la table source avant de calculer les agrégations ou de sélectionner la valeur de la dernière colonne. Cette fonction agit comme une clause SQL WHERE appliquée avant le regroupement et l'agrégation des données.
Pour les fonctionnalités d'agrégation, filter_condition filtre les lignes avant l'agrégation, tout comme une clause SQL WHERE appliquée avant GROUP BY. Il ne modifie pas la granularité, qui est toujours définie par entity sur la définition de la fonctionnalité.
Les filtres sont utiles lorsque l’on travaille avec de grandes tables source qui incluent un sur-ensemble de données nécessaires au calcul de fonctionnalités, et minimisent le besoin de créer des vues séparées sur ces tables.
from databricks.feature_engineering.entities import AggregationFunction, Sum, Count, RollingWindow, DeltaTableSource
from datetime import timedelta

# Source with filter applied at the source level
high_value_transactions = DeltaTableSource(
    catalog_name="main",
    schema_name="ecommerce",
    table_name="transactions",
    filter_condition="amount > 100",  # Only transactions over $100
)

high_value_sales = Feature(
    source=high_value_transactions,
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=30))),
)

# Multiple conditions
completed_orders_source = DeltaTableSource(
    catalog_name="main",
    schema_name="ecommerce",
    table_name="orders",
    filter_condition="status = 'completed' AND payment_method = 'credit_card'",
)

completed_orders = Feature(
    source=completed_orders_source,
    entity=["user_id"],
    timeseries_column="order_time",
    function=AggregationFunction(Count(input="order_id"), RollingWindow(window_duration=timedelta(days=7))),
)

# Filter on a StreamSource
from databricks.feature_engineering.entities import StreamSource

purchase_stream = StreamSource(
    full_name="main.ecommerce.transactions_stream",
    filter_condition="value.event_type = 'purchase'",
)

purchase_total = Feature(
    source=purchase_stream,
    entity=["value.user_id"],
    timeseries_column="value.event_time",
    function=AggregationFunction(Sum(input="value.amount"), RollingWindow(window_duration=timedelta(hours=1))),
)
source de données, origine de données
DeltaTableSource
DeltaTableSource est un objet Python éphémère utilisé pour définir comment les fonctionnalités sont calculées à partir d'une table source. Il ne crée pas de nouvelle table. Il spécifie la configuration pour la lecture des données et l'agrégation des fonctionnalités.
DeltaTableSource(
    catalog_name: str,                              # Required: Catalog name
    schema_name: str,                               # Required: Schema name
    table_name: str,                                # Required: Table name
    filter_condition: Optional[str] = None,         # Optional: SQL WHERE clause to filter source data
    transformation_sql: Optional[str] = None,       # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,         # Required if transformation_sql is set: schema of the resulting DataFrame
    lateness: Optional[SourceLateness] = None,       # Optional: Expected source settling time
)
Paramètres :
catalog_name,schema_name,table_name: Identifiez la table Delta source dans Unity Catalog.filter_condition: une clause SQLWHEREappliquée avant l’agrégation ou la sélection de colonnes. Exemple :"status = 'completed'".transformation_sql: Une expression SQLSELECTappliquée à la table source. Utilisez ceci pour renommer des colonnes, convertir des types ou compute des colonnes dérivées avant l'agrégation ou la sélection des colonnes. Si omis, toutes les colonnes sont sélectionnées (*). Exemple :"user_id, CAST(amount AS DOUBLE) AS amount, event_time".dataframe_schema: Le schéma du DataFrame résultant après transformations, au format JSON Spark StructType (issu dedf.schema.json()). Obligatoire sitransformation_sqlest fourni. Ceci indique au système les noms et les types de colonnes qui résultent de votre transformation.lateness: objetSourceLatenessqui décrit le temps généralement requis par la source pour être complète en temps d’événement. S’il est omis, la source est considérée comme immédiatement complète.
Lorsque filter_condition et transformation_sql sont définis, la query résultante est : SELECT {transformation_sql} FROM {table} WHERE {filter_condition}.
SourceLateness.settling_delay est la méthode recommandée pour simuler pendant l’entraînement un délai ETL cohérent qui affecte la matérialisation en ligne. Databricks recule le temps d’évaluation de l’entraînement éligible de cette durée afin qu’un exemple d’entraînement n’utilise pas de données qui seraient encore en transit en ligne. Pendant la matérialisation, Databricks attend la même durée avant de publier une fenêtre terminée et sert la dernière fenêtre terminée pendant la période intermédiaire.
Par exemple, supposons qu’un job ETL quotidien se termine 8 heures après minuit dans un fuseau horaire local où minuit correspond à 07:00 UTC. Utilisez un délai de stabilisation de 8 heures et un décalage de fenêtre de 7 heures :
from datetime import timedelta
from databricks.feature_engineering.entities import (
    DeltaTableSource,
    SourceLateness,
    TumblingWindow,
)

source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    lateness=SourceLateness(settling_delay=timedelta(hours=8)),
)

window = TumblingWindow(
    window_duration=timedelta(days=1),
    offset=timedelta(hours=7),
)
Le paramètre timeseries_column doit être de type TimestampType ou TimestampNTZType. DateType n'est pas pris en charge pour les séries temporelles ; convertissez d'abord la colonne en TimestampType (par exemple, avec transformation_sql).
Exemple : utilisation de transformation_sql pour les transformations de colonnes
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="raw_events",
    transformation_sql="user_id, CAST(price_cents AS DOUBLE) / 100 AS price, event_time",
    filter_condition="event_type = 'purchase'",
    dataframe_schema=spark.sql(
        "SELECT user_id, CAST(price_cents AS DOUBLE) / 100 AS price, event_time FROM main.analytics.raw_events LIMIT 0"
    ).schema.json(),
)
Exemple : Dérivation de transformation_sql et dataframe_schema à partir d'un DataFrame PySpark
Vous pouvez écrire votre transformation sous forme de query PySpark, puis extraire le schéma du DataFrame résultant :
df = spark.sql(f"""
  SELECT user_id, CAST(amount AS DOUBLE) / 100 AS amount_dollars, event_time
  FROM main.analytics.events
  WHERE event_date >= date_sub(current_date(), 7)
  LIMIT 0
""")

# Use df.schema.json() as the dataframe_schema
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    transformation_sql="user_id, CAST(amount AS DOUBLE) / 100 AS amount_dollars, event_time",
    filter_condition="event_date >= date_sub(current_date(), 7)",
    dataframe_schema=df.schema.json(),
)
Expressions transformation_sql prises en charge
Les mêmes règles s'appliquent à transformation_sql sur DeltaTableSource et StreamSource.
transformation_sql prend en charge toutes les expressions ligne par ligne ; les opérations sont évaluées indépendamment pour chaque ligne. Ils ne modifient pas le nombre de lignes ni la correspondance un-à-un avec la source. Les expressions ligne par ligne incluent les renommages de colonnes, les casts, les opérations arithmétiques, et plus encore.
Les Opérations qui modifient la forme ou le nombre de lignes ne sont pas prises en charge, comme les agrégations telles que SUM() ou COUNT(). Utilisez AggregationFunction sur la définition de fonctionnalité à la place.
DeltaTableSource.from_sql()
Par commodité, vous pouvez créer DeltaTableSource à partir d’une requête SQL. La méthode analyse la query pour extraire automatiquement le nom de la table, transformation_sql et filter_condition.
DeltaTableSource.from_sql(
    sql: str,                           # Required: SQL SELECT query
    spark: SparkSession,                # Required: active SparkSession (for schema inference)
) -> DeltaTableSource
Seules les SELECT ... FROM ... [WHERE ...] query simples sont prises en charge. Le SQL complexe (JOINs, sous-requêtes, CTEs, UNIONs) est rejeté. Pour les requêtes complexes, construisez DeltaTableSource directement avec transformation_sql et filter_condition.
from databricks.feature_engineering.entities import (
    AggregationFunction,
    DeltaTableSource,
    Feature,
    Sum,
    TumblingWindow,
)

source = DeltaTableSource.from_sql(
    spark=spark,
    sql=f"SELECT customer_id, event_ts, amount * 2 AS doubled_amount, amount FROM {CATALOG}.{SCHEMA}.{TABLE}",
)

feature = Feature(
    source=source,
    function=AggregationFunction(Sum(input="doubled_amount"), time_window=TumblingWindow(window_duration=timedelta(days=7))),
    entity=["customer_id"], timeseries_column="event_ts",
)
Itérer avec to_dataframe()
Utilisez source.to_dataframe() pour prévisualiser les données qui seront utilisées pour le calcul de fonctionnalités. C'est utile pour itérer sur filter_condition et transformation_sql jusqu'à ce qu'ils produisent les résultats attendus.
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    filter_condition="event_type = 'purchase'",
)

# Preview the filtered source data
source.to_dataframe().display()
Comprendre les entités
Les colonnes d'entité définissent le niveau d'agrégation de vos fonctionnalités. Ils sont spécifiés sur la définition Feature, et non sur DeltaTableSource. Les entités déterminent :
- Comment les données sont regroupées : les fonctionnalités sont agrégées par combinaison unique de valeurs d'entité (similaire à
GROUP BYdans SQL) - La structure de la clé primaire : chaque combinaison d'entités unique donne une ligne de fonctionnalités calculées
Exemple : fonctionnalités au niveau du client
Le code suivant agrège les fonctionnalités au niveau du client (une ligne par client) :
from databricks.feature_engineering.entities import DeltaTableSource

source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="user_events",
)

Feature(
    source=source,
    entity=["user_id"],                # Features aggregated per user
    timeseries_column="event_time",    # Timestamp for time windows
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)
Exemple : Fonctionnalités au niveau des clients et des magasins
Pour agréger les fonctionnalités à un niveau plus détaillé (une ligne par combinaison client-magasin), utilisez plusieurs colonnes d'entité :
source = DeltaTableSource(
    catalog_name="main",
    schema_name="retail",
    table_name="transactions",
)

Feature(
    source=source,
    entity=["user_id", "store_id"],  # Features aggregated per user-store pair
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)
Lorsque vous avez besoin de fonctionnalités à différents niveaux d'agrégation (par exemple, au niveau du clients et au niveau du magasin du clients), utilisez différentes valeurs entity dans vos définitions de fonctionnalités. Le même DeltaTableSource peut être partagé entre des fonctionnalités avec différentes configurations d'entités.
StreamSource
StreamSource fait référence à un Stream. Le Stream contient la configuration de connexion, d'authentification, de schéma et d'ingestion pour la source de streaming. Pour Kafka, les références de colonne dans les définitions de fonctionnalités doivent être préfixées par value. ou key. pour indiquer quelle partie du message lire.
StreamSource(
    full_name: str,                       # Required: Three-part Stream name (catalog.schema.stream)
    filter_condition: Optional[str] = None,      # Optional: SQL WHERE clause applied before aggregation
    transformation_sql: Optional[str] = None,    # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,      # Required if transformation_sql is set: schema of the resulting DataFrame
    lateness: Optional[SourceLateness] = None,    # Optional: Expected source settling time
)
Paramètres :
full_name: le nom complet en trois parties d'un Stream (par exemple,"my_catalog.my_schema.my_stream").filter_condition(facultatif) : Une clause SQLWHEREappliquée aux données de stream avant l'agrégation, en utilisant des références de colonne précédées d'un point (par exemple,"value.event_type = 'purchase'").transformation_sql(facultatif) : une expression SQLSELECTappliquée avant l'agrégation ou la sélection de colonnes, en utilisant des références préfixées par un point vers les structureskeyetvalue. Prend en charge les mêmes expressions par ligne queDeltaTableSource. Si cette option est omise, la source utilise toutes les colonnes (*).dataframe_schema: Le schéma JSON SparkStructTypede la sortie projetée. Requis si vous définisseztransformation_sql.lateness: objetSourceLatenessqui décrit le temps généralement requis par le stream pour être complet en temps d’événement. Veuillez consulterSourceLateness.settling_delay.
from databricks.feature_engineering.entities import StreamSource

stream_source = StreamSource(
    full_name="my_catalog.my_schema.my_stream",
    filter_condition="value.event_type = 'purchase'",
)
Dérivez dataframe_schema en exécutant la projection sur la table d'ingestion du Stream, qui expose les structures key et value.
transformation_sql = (
    "value.amount * value.conversion_rate AS converted_amount, "
    "struct(value.user_id AS user_id, value.event_time AS time) AS event"
)

ingestion_table = "my_catalog.my_schema.events_ingestion"
dataframe_schema = spark.sql(
    f"SELECT {transformation_sql} FROM {ingestion_table} LIMIT 0"
).schema.json()

stream_source = StreamSource(
    full_name="my_catalog.my_schema.my_stream",
    transformation_sql=transformation_sql,
    dataframe_schema=dataframe_schema,
)
RequestSource
RequestSource définit un schéma pour les données qui sont fournies au moment de l'inférence dans la charge utile de la requête plutôt que recherchées à partir d'une table pré-matérialisée. Pendant l'entraînement, ces colonnes sont extraites du DataFrame étiqueté transmis à create_training_set. Lors du service de modèles, l'appelant doit les inclure dans la charge utile de la requête HTTP.
RequestSource peut être utilisé avec les fonctions de vue des caractéristiques CustomUDF ou ColumnSelection. Il ne prend pas en charge les fonctions d'agrégation ni les fenêtres temporelles.
Définition du schéma
Définissez le schéma comme une liste d'objets FieldDefinition, chacun spécifiant un nom de colonne et un ScalarDataType:
from databricks.feature_engineering.entities import (
    FieldDefinition, RequestSource, ScalarDataType,
)

request_source = RequestSource(
    schema=[
        FieldDefinition(name="transaction_amount", data_type=ScalarDataType.DOUBLE),
        FieldDefinition(name="vendor_id", data_type=ScalarDataType.STRING),
        FieldDefinition(name="transaction_id", data_type=ScalarDataType.STRING),
        FieldDefinition(name="transaction_time", data_type=ScalarDataType.DATE),
    ]
)
Types de données pris en charge
RequestSource prend en charge les types scalaires définis dans ScalarDataType: INTEGER, FLOAT, BOOLEAN, STRING, DOUBLE, LONG, TIMESTAMP, DATE, SHORT. Les types complexes tels que les tableaux, les cartes et les structures ne sont pas pris en charge.
Comment les données de requête sont hydratées
Contexte | Comportement |
|---|---|
Formation ( | Les colonnes sont extraites du DataFrame étiqueté. Les types sont validés par rapport au schéma déclaré. Les incohérences entraînent une erreur (pas de conversion implicite). |
Déploiement (Endpoint de modèle) | Les colonnes sont extraites de |
Signature du modèle
Lorsqu'un modèle est enregistré à l'aide de log_model avec un ensemble d'entraînement qui inclut RequestSource fonctionnalités, les colonnes RequestSource sont ajoutées à la signature du modèle MLflow comme entrées requises. Cela signifie que le schéma de l'API de l'Endpoint de diffusion reflète les champs que les appelants doivent fournir au moment de l'inférence.
FeatureViewSource
FeatureViewSource utilise les sorties d'autres vues de fonctionnalités comme entrées d'un CustomUDF. Le chaînage de fonctionnalités crée un graphe orienté acyclique (DAG). Par exemple, une fonctionnalité de marge peut combiner les agrégats de revenus et de coûts, et une autre fonctionnalité peut transformer la marge.
Utilisez databricks-feature-engineering version 0.18.0 ou ultérieure pour FeatureViewSource.
Transmettez une liste de Feature objets à features, et non des chaînes de caractères correspondant aux noms de fonctionnalités. Récupérer les fonctionnalités enregistrées avec get_feature. Dans input_bindings, utilisez le paramètre full_name de chaque fonctionnalité enregistrée. Pour une fonctionnalité locale non enregistrée, utilisez plutôt son paramètre name.
L’exemple suivant suppose deux fonctionnalités enregistrées, revenue_sum_7d et cost_sum_7d, qui renvoient des valeurs DOUBLE par customer_id et utilisent event_time pour le calcul ponctuel (point-in-time) :
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import CustomUDF, FeatureViewSource

fe = FeatureEngineeringClient()
revenue = fe.get_feature(full_name="main.ecommerce.revenue_sum_7d")
cost = fe.get_feature(full_name="main.ecommerce.cost_sum_7d")

spark.sql("""
CREATE OR REPLACE FUNCTION main.ecommerce.margin_udf(revenue DOUBLE, cost DOUBLE)
RETURNS DOUBLE
LANGUAGE PYTHON
AS $$
import math

if revenue is None or cost is None:
    return None
if not math.isfinite(revenue) or not math.isfinite(cost) or revenue <= 0:
    return None
return (revenue - cost) / revenue
$$
""")

margin = fe.create_feature(
    source=FeatureViewSource(features=[revenue, cost]),
    function=CustomUDF(
        function_name="main.ecommerce.margin_udf",
        input_bindings={"revenue": revenue.full_name, "cost": cost.full_name},
    ),
    catalog_name="main",
    schema_name="ecommerce",
    name="margin",
)
Les restrictions suivantes s'appliquent :
- Seul
CustomUDFest pris en charge comme fonction. Les caractéristiques en amont peuvent être des agrégations, des sélections de colonnes ou d’autres caractéristiquesCustomUDF. - Omettre
entityettimeseries_columnsur la fonctionnalité dérivée. Chaque entité en amont conserve sa propre entité, son timestamp et sa définition de fenêtre. - Une fonctionnalité a une source de données. Pour combiner une valeur de requête avec une fonctionnalité basée sur une table, définissez une fonctionnalité
RequestSourceet faites référence aux deux viaFeatureViewSource. - Toutes les fonctionnalités en amont déclarées doivent être utilisées dans
input_bindings. Les cycles ne sont pas autorisés. - Enregistrez les fonctionnalités amont avant d’enregistrer la fonctionnalité dérivée. Les graphes locaux non enregistrés peuvent être utilisés avec
create_training_setpour l’expérimentation. - Pour l'entraînement ou le service, vous avez besoin du privilège
READ FEATUREouMANAGEsur la fonctionnalité dérivée et ses fonctionnalités amont transitives. Utilisez des noms de fonctionnalités distincts dans le Graphe pour l'enregistrement et le service, même à travers les catalogues ou les schémas. - Une fonctionnalité peut référencer jusqu'à 20 fonctionnalités directes en amont. Les graphes enregistrés prennent en charge une profondeur maximale de cinq fonctionnalités le long d'un chemin de dépendance, y compris la fonctionnalité de base.
FeatureViewSourceles fonctionnalités ne peuvent pas être matérialisées ou évaluées aveccompute_features. Utilisezcreate_training_setpour les évaluer hors ligne. Pour le service en ligne, matérialisez plutôt les fonctionnalités en amont prises en charge et basées sur des tables.
Pour l’évaluation des dépendances et la sélection des sorties, consultez Entraîner avec des fonctionnalités de FeatureViewSource. Pour le déploiement, consultez Servir des fonctionnalités dérivées.
API de formation et d’inférence
create_training_set et score_batch compute les valeurs de fonctionnalité correctes à un moment précis à la demande à partir des données sources. Pour les fonctionnalités qui prennent en charge la matérialisation hors ligne, telles que les agrégations de fenêtres glissantes sur les sources de tables Delta, la matérialisation des fonctionnalités d'abord vers un magasin hors ligne améliore les performances des deux opérations. Lorsque les fonctionnalités hors ligne matérialisées sont disponibles, les opérations lisent les données hors ligne précalculées au lieu de recalculer les valeurs des fonctionnalités à partir de la source. Consultez Matérialiser les vues de fonctionnalités pour matérialiser les fonctionnalités vers un magasin hors ligne.
create_training_set()
Crée un dataset d'entraînement avec un calcul de fonctionnalités exact à un instant T. Pour plus de détails, consultez Former des modèles avec des vues de fonctionnalités.
FeatureEngineeringClient.create_training_set(
    df: DataFrame,                                # DataFrame with training data
    features: Optional[List[Feature]],            # List of Feature objects
    label: Union[str, List[str], None],           # Label column name(s)
    exclude_columns: Optional[List[str]] = None,  # Optional: columns to exclude
) -> TrainingSet
log_model()
Logs un modèle avec les métadonnées de fonctionnalité pour le suivi de la traçabilité et la recherche automatique de fonctionnalités pendant l’inférence. Pour plus de détails, consultez Former des modèles avec des vues de fonctionnalités.
FeatureEngineeringClient.log_model(
    model,                                    # Trained model object
    artifact_path: str,                       # Path to store model artifact
    flavor: ModuleType,                       # MLflow flavor module (e.g., mlflow.sklearn)
    training_set: TrainingSet,                # TrainingSet used for training
    registered_model_name: Optional[str],     # Optional: register model in Unity Catalog
)
score_batch()
Effectue l’inférence batch hors ligne avec recherche automatique de fonctionnalités. Utilise les métadonnées de fonctionnalité stockées avec le modèle pour calculer des fonctionnalités correctes à un instant donné, garantissant la cohérence avec l’entraînement.
FeatureEngineeringClient.score_batch(
    model_uri: str,                           # URI of logged model (e.g., "models:/catalog.schema.model/1")
    df: DataFrame,                            # DataFrame with entity keys and timestamps
) -> DataFrame
Le DataFrame d'entrée doit contenir les colonnes d'entité et de séries temporelles utilisées pendant l'entraînement. Les fonctionnalités sont automatiquement calculées à partir des données source.
fe = FeatureEngineeringClient()

# Batch scoring with automatic feature lookup
predictions = fe.score_batch(
    model_uri="models:/main.ecommerce.fraud_model/1",
    df=inference_df,
)
predictions.display()
Fenêtres temporelles
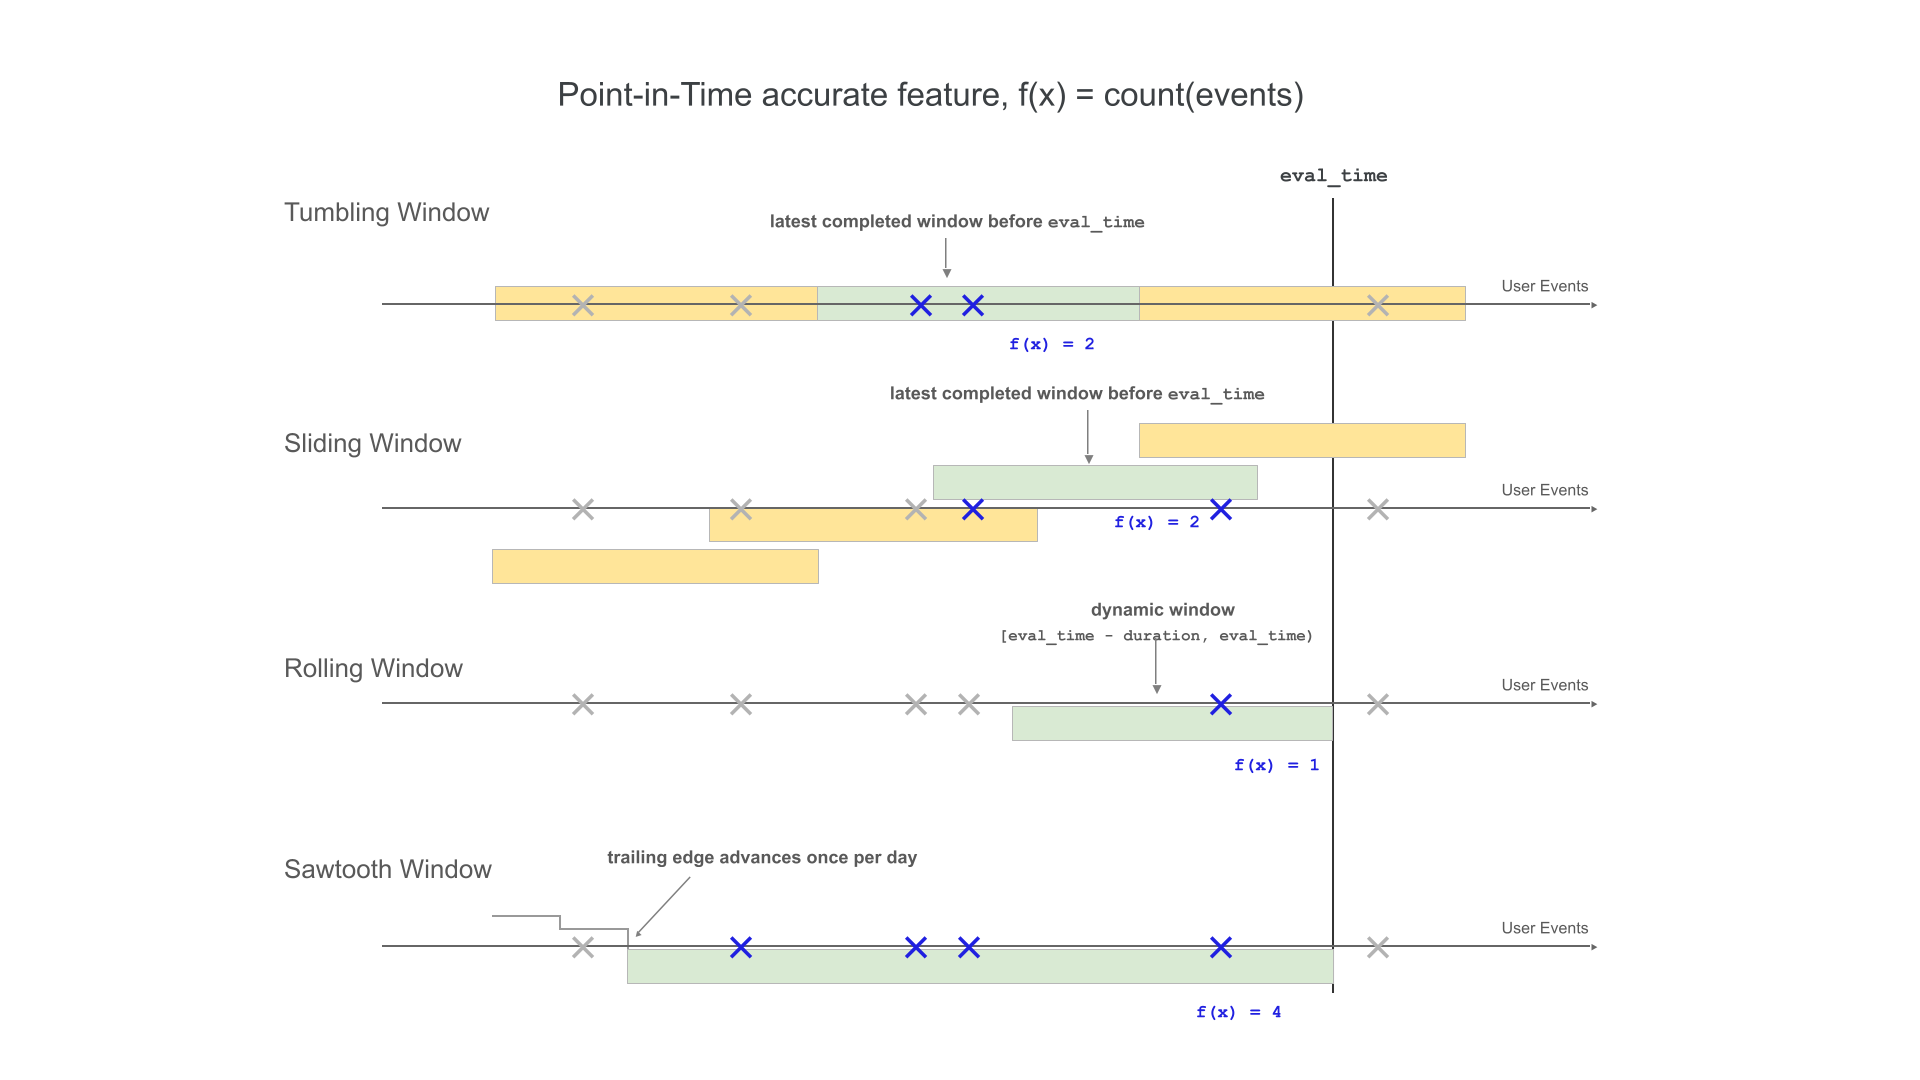
Les vues de caractéristiques prennent en charge quatre types de fenêtres pour contrôler le comportement rétrospectif pour les agrégations basées sur des fenêtres temporelles. Les types de fenêtres disponibles dépendent de la source de la caractéristique : les caractéristiques de source streaming peuvent utiliser des fenêtres glissantes (rolling) et en dents de scie (sawtooth), et les caractéristiques de source batch peuvent utiliser des fenêtres glissantes (rolling), fixes (tumbling) et coulissantes (sliding).
- Les fenêtres glissantes prennent en compte l’historique à partir de l’heure de l’événement. La durée et le délai sont explicitement définis.
- Les fenêtres bascules sont des fenêtres de temps fixes et non chevauchantes. Chaque point de données appartient à exactement une fenêtre.
- Les fenêtres glissantes sont des fenêtres temporelles chevauchantes et continues avec un intervalle de glissement configurable.
- Les fenêtres en dents de scie maintiennent une longue fenêtre rétrospective à jour sur une source de streaming en utilisant un chemin hybride batch et streaming. Voir Fenêtre en dents de scie.
L'illustration suivante présente les types de fenêtres tumbling, sliding, rolling et sawtooth.
Synchronisation de la fenêtre temporelle
Utilisez delay pour évaluer une fenêtre à un moment d'analyse antérieur. Par exemple, une fenêtre de 30 jours avec un délai de 7 jours compute une valeur de 30 jours à partir d'une semaine avant l'heure d'évaluation. delay est indépendant de l'heure d'arrivée des données sources. Pour modéliser le temps que mettent les données sources à arriver, configurez plutôt SourceLateness.settling_delay.
Lorsque les deux paramètres sont présents, ils se composent. Databricks traite la fenêtre comme étant complète après le délai de stabilisation de la source et l'évalue à l'aide du délai analytique.
Utilisez offset pour modifier l’alignement des limites de fenêtre fixe. By default, les fenêtres basculantes et les fenêtres glissantes sont alignées sur minuit UTC. Par exemple, un décalage de 22 heures aligne une limite quotidienne sur 22:00 UTC. Pour estimer les limites dans un fuseau horaire local, configurez un décalage statique par rapport à l’UTC. Le décalage ne prend pas en compte l’heure d’été, ne décale pas l’heure d’évaluation et ne modélise pas les données arrivant en retard.
Le tableau suivant résume la prise en charge de ces champs :
Champ | Fenêtres prises en charge | Contrainte |
|---|---|---|
| En continu, basculement et glissement | Doit être un nombre non négatif |
| Basculement et glissement | Doit être supérieur ou égal à 0 et inférieur à la période* |
| Fonctionnalités rolling, tumbling et sliding | Doit être un nombre non négatif |
| En continu, basculement et glissement | Doit être un(e) |
*Période : pour une fenêtre the tumbling (roulante/par blocs), l’offset (le décalage) doit être inférieur à window_duration. Pour une fenêtre glissante, la valeur doit être inférieure à slide_duration.
Heure de start
Utilisez start_time pour définir la limite d’heure d’événement la plus ancienne en UTC à laquelle une entité peut émettre une sortie. La limite est inclusive. start_time restreint les sorties. Cette option ne restreint pas les lignes de source historiques qu’une fenêtre peut lire, et elle ne modifie pas l’alignement de la fenêtre. Si start_time se situe entre deux limites alignées, la première sortie de fenêtre fixe éligible est la limite suivante.
Avec start_time, les fenêtres à durée fixe peuvent émettre avant qu’une durée de fenêtre complète ne se soit écoulée dans la source. Ces premières sorties utilisent l’historique des sources disponible. Par exemple, considérez une fenêtre glissante avec un window_duration d’un an et un slide_duration d’un jour, sur une source dont les données commencent le 1er janvier 2024 :
- Sans
start_time, la fonctionnalité émet d’abord le 1er janvier 2025, une fois qu’une fenêtre complète d’un an peut être formée. - Avec
start_timedéfini sur le 21 août 2024, la fonctionnalité émet pour la première fois le 21 août 2024. Cette sortie couvre uniquement l’historique des sources disponible jusqu’à présent, à compter du 1er janvier 2024. La fenêtre atteint sa durée complète d’un an le 1er janvier 2025 et produit des résultats complets à compter de cette date.
Étant donné que start_time ne modifie pas l’alignement des fenêtres, une valeur située entre deux limites alignées ne crée pas de nouvelle limite. Pour une fenêtre glissante (tumbling window) avec des limites quotidiennes à minuit UTC, un start_time de 06:00 UTC émet d’abord à la limite de minuit suivante. Un start_time qui atterrit exactement sur une limite émet à cette limite, car la limite est inclusive.
Si start_time n’est pas défini, les fenêtres de bouffée (tumbling windows) et les fenêtres glissantes à durée fixe émettent d’abord à une limite alignée après qu’une fenêtre complète peut être formée. Les fenêtres glissantes à durée de vie (lifetime sliding windows) et les fenêtres mobiles (rolling windows) émettent dès que des données source éligibles existent.
start_time est pris en charge pour les fonctionnalités batch qui utilisent DeltaTableSource avec des fenêtres glissantes, oscillantes ou par saut. Ce n’est pas pris en charge avec StreamSource ou SawtoothWindow.
Par exemple :
from datetime import datetime, timedelta
from databricks.feature_engineering.entities import SlidingWindow

window = SlidingWindow(
    window_duration=timedelta(days=365),
    slide_duration=timedelta(days=1),
    start_time=datetime(2024, 8, 21),
)
Fenêtre glissante
RollingWindow a été précédemment nommé ContinuousWindow. Si vous migrez depuis une version antérieure du SDK, mettez à jour vos importations en conséquence.
Les fenêtres glissantes sont des agrégats à jour et en temps réel, généralement utilisés sur les données en streaming. Dans les pipelines de streaming, la fenêtre glissante émet une nouvelle ligne uniquement lorsque le contenu de la fenêtre de longueur fixe change, par exemple lorsqu'un événement entre ou sort. Lorsqu'une fonctionnalité de fenêtre glissante est utilisée dans les pipelines d'entraînement, un calcul précis des fonctionnalités à un instant T est effectué sur les données sources en utilisant la durée de la fenêtre de longueur fixe immédiatement précédant le Timestamp d'un événement spécifique. Cela permet d'éviter l'asymétrie en ligne-hors ligne ou la fuite de données. Les fonctionnalités à l'heure T agrègent les événements de [T − durée, T).
class RollingWindow(TimeWindow):
    window_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
Le tableau suivant répertorie les parameters d’une fenêtre glissante. Les heures de start et de fin de fenêtre sont basées sur ces parameters comme suit :
- Heure de start :
evaluation_time - window_duration - delay(inclusive) - Heure de fin :
evaluation_time - delay(exclusive)
parameter | Contraintes |
|---|---|
| Doit être ≥ 0. Recule la fenêtre analytique par rapport au timestamp d’évaluation. Utilisez |
| Doit être > 0 |
| Limite d'heure d'événement la plus ancienne à laquelle la fonctionnalité peut émettre une sortie. |
from databricks.feature_engineering.entities import RollingWindow
from datetime import timedelta

# Look back 7 days from evaluation time
window = RollingWindow(window_duration=timedelta(days=7))
Définissez une fenêtre glissante avec un délai à l'aide du code ci-dessous.
# Compute a 7-day value as of one day before the evaluation time
window = RollingWindow(
    window_duration=timedelta(days=7),
    delay=timedelta(days=1)
)
Exemples de fenêtres glissantes
-
window_duration=timedelta(days=7): cela crée une fenêtre rétrospective de 7 jours se terminant à l'heure d'évaluation actuelle. Pour un événement à 14 h 00 le Jour 7, cela inclut tous les événements de 14 h 00 le Jour 0 jusqu'à (mais sans l'inclure) 14 h 00 le Jour 7. -
window_duration=timedelta(hours=1), delay=timedelta(minutes=30): cette opération crée une fenêtre rétrospective de 1 heure se terminant 30 minutes avant l’heure d’évaluation. Pour un événement à 15 h 00, cela inclut tous les événements de 13 h 30 jusqu’à 14 h 30 (exclue).
Utilisez Last pour limiter la fraîcheur d’une valeur récente
Associez Last à RollingWindow lorsqu’une valeur la plus récente n’est valide que pendant une durée limitée. À un moment d’évaluation, la fonctionnalité renvoie la valeur de la ligne dont le timestamp est le plus récent dans cet intervalle :
[evaluation_time - delay - window_duration, evaluation_time - delay)
Si la dernière ligne de l’intervalle contient une valeur nulle, la fonction renvoie une valeur nulle. Si vous souhaitez exclure des valeurs d’entrée nulles, définissez un filter_condition sur la source.
Cette combinaison diffère de ColumnSelection. ColumnSelection renvoie la dernière valeur non nulle observée sans qu'elle n'expire en fonction de son âge.
Pour les fonctionnalités batch, cette combinaison dispose d’un mode de matérialisation en ligne spécial. Il prend uniquement en charge DeltaTableSource, Last, RollingWindow et TableTrigger. Consultez Matérialiser les dernières valeurs limitées dans le temps.
Fenêtre basculante
Pour les fonctionnalités définies à l'aide de fenêtres basculantes, les agrégations sont calculées sur une fenêtre de longueur fixe prédéterminée qui avance par un intervalle de glissement, produisant des fenêtres non chevauchantes qui partitionnent entièrement le temps. En conséquence, chaque événement dans la source contribue à une seule fenêtre. Les fonctionnalités au temps t agrègent les données des fenêtres se terminant à ou avant t (exclue). Windows commencent à l'époque Unix.
class TumblingWindow(TimeWindow):
    window_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    offset: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
Le tableau suivant répertorie les paramètres d'une fenêtre basculante.
parameter | Contraintes |
|---|---|
| Doit être > 0 |
| Doit être supérieure ou égale à 0. Décale la fenêtre analytique vers l'arrière à partir du timestamp d'évaluation. |
| Doit être supérieure ou égale à 0 et inférieure à |
| Limite d'heure d'événement la plus ancienne à laquelle la fonctionnalité peut émettre une sortie. |
from databricks.feature_engineering.entities import TumblingWindow
from datetime import timedelta

window = TumblingWindow(
    window_duration=timedelta(days=1),
    delay=timedelta(hours=2),
    offset=timedelta(hours=22),
)
Exemple de fenêtre glissante
window_duration=timedelta(days=5): Cela crée des fenêtres de longueur fixe prédéterminées de 5 jours chacune. Exemple : la fenêtre n°1 s'étend du jour 0 au jour 4, la fenêtre n°2 du jour 5 au jour 9, la fenêtre n°3 du jour 10 au jour 14, et ainsi de suite. Plus précisément, la fenêtre n° 1 inclut tous les événements avec des Timestamp commençant à00:00:00.00le jour 0 jusqu'à (mais sans inclure) les événements avec le Timestamp00:00:00.00le jour 5. Chaque événement appartient à une seule fenêtre.
Fenêtre glissante
Pour les caractéristiques définies à l’aide de fenêtres glissantes, les agrégations sont calculées sur une fenêtre qui avance selon un intervalle de glissement. Une fenêtre glissante peut avoir une durée fixe ou une durée de vie. Les fenêtres à durée fixe se chevauchent, de sorte que chaque événement source peut contribuer à l’agrégation des caractéristiques pour plusieurs fenêtres. Une fenêtre de durée de vie inclut tous les événements sources avant la fin de la fenêtre. Les caractéristiques à l’instant t agrègent les données provenant de fenêtres se terminant à ou avant t (exclus). Windows sont alignées sur l’époque Unix.
class SlidingWindow(TimeWindow):
    window_duration: Optional[datetime.timedelta]
    slide_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    offset: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
Le tableau suivant répertorie les paramètres d'une fenêtre glissante.
parameter | Contraintes |
|---|---|
| Doit être positif pour une fenêtre à durée fixe. Définissez sur |
| La valeur doit être positive. Pour une fenêtre à durée fixe, elle doit également être inférieure à |
| Doit être supérieure ou égale à 0. Décale la fenêtre analytique vers l'arrière à partir du timestamp d'évaluation. |
| Doit être supérieure ou égale à 0 et inférieure à |
| Limite d'heure d'événement la plus ancienne à laquelle la fonctionnalité peut émettre une sortie. |
from databricks.feature_engineering.entities import SlidingWindow
from datetime import timedelta

window = SlidingWindow(
    window_duration=timedelta(days=7),
    slide_duration=timedelta(days=1),
    delay=timedelta(hours=2),
    offset=timedelta(hours=22),
)
Exemple de fenêtre glissante
window_duration=timedelta(days=5), slide_duration=timedelta(days=1): Cela crée des fenêtres de 5 jours qui se chevauchent et avancent d'1 jour à chaque fois. Exemple : la fenêtre n° 1 s'étend du jour 0 au jour 4, la fenêtre n° 2 s'étend du jour 1 au jour 5, la fenêtre n° 3 s'étend du jour 2 au jour 6, et ainsi de suite. Chaque fenêtre inclut les événements à partir de00:00:00.00le start day, jusqu'à (mais non compris)00:00:00.00le jour de fin. Étant donné que les fenêtres se chevauchent, un événement unique peut appartenir à plusieurs fenêtres (dans cet exemple, chaque événement appartient à jusqu'à 5 fenêtres différentes).
Fenêtre de durée de vie
Définissez window_duration=None pour créer une fenêtre de durée de vie. À chaque limite de glissement, la fonctionnalité agrège tous les événements sources pour l'entité avec des Timestamp antérieurs à cette limite. Par exemple, un glissement d'un jour produit une valeur cumulative une fois par jour.
Les fenêtres de durée de vie ne sont prises en charge que par SlidingWindow. RollingWindow et TumblingWindow nécessitent une window_duration finie.
Les fenêtres de durée de vie nécessitent une version client databricks-feature-engineering prenant en charge window_duration=None et l’activation du Workspace. Les versions client antérieures ne prennent pas en charge cette syntaxe.
from datetime import timedelta
from databricks.feature_engineering.entities import (
    AggregationFunction,
    DeltaTableSource,
    Feature,
    SlidingWindow,
    Sum,
)

lifetime_spend = Feature(
    source=DeltaTableSource(
        catalog_name="main",
        schema_name="store",
        table_name="transactions",
    ),
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(
        Sum(input="amount"),
        SlidingWindow(
            window_duration=None,
            slide_duration=timedelta(days=1),
        ),
    ),
    name="lifetime_spend",
)
Fenêtre en dents de scie
Bêta
SawtoothWindow est en bêta.
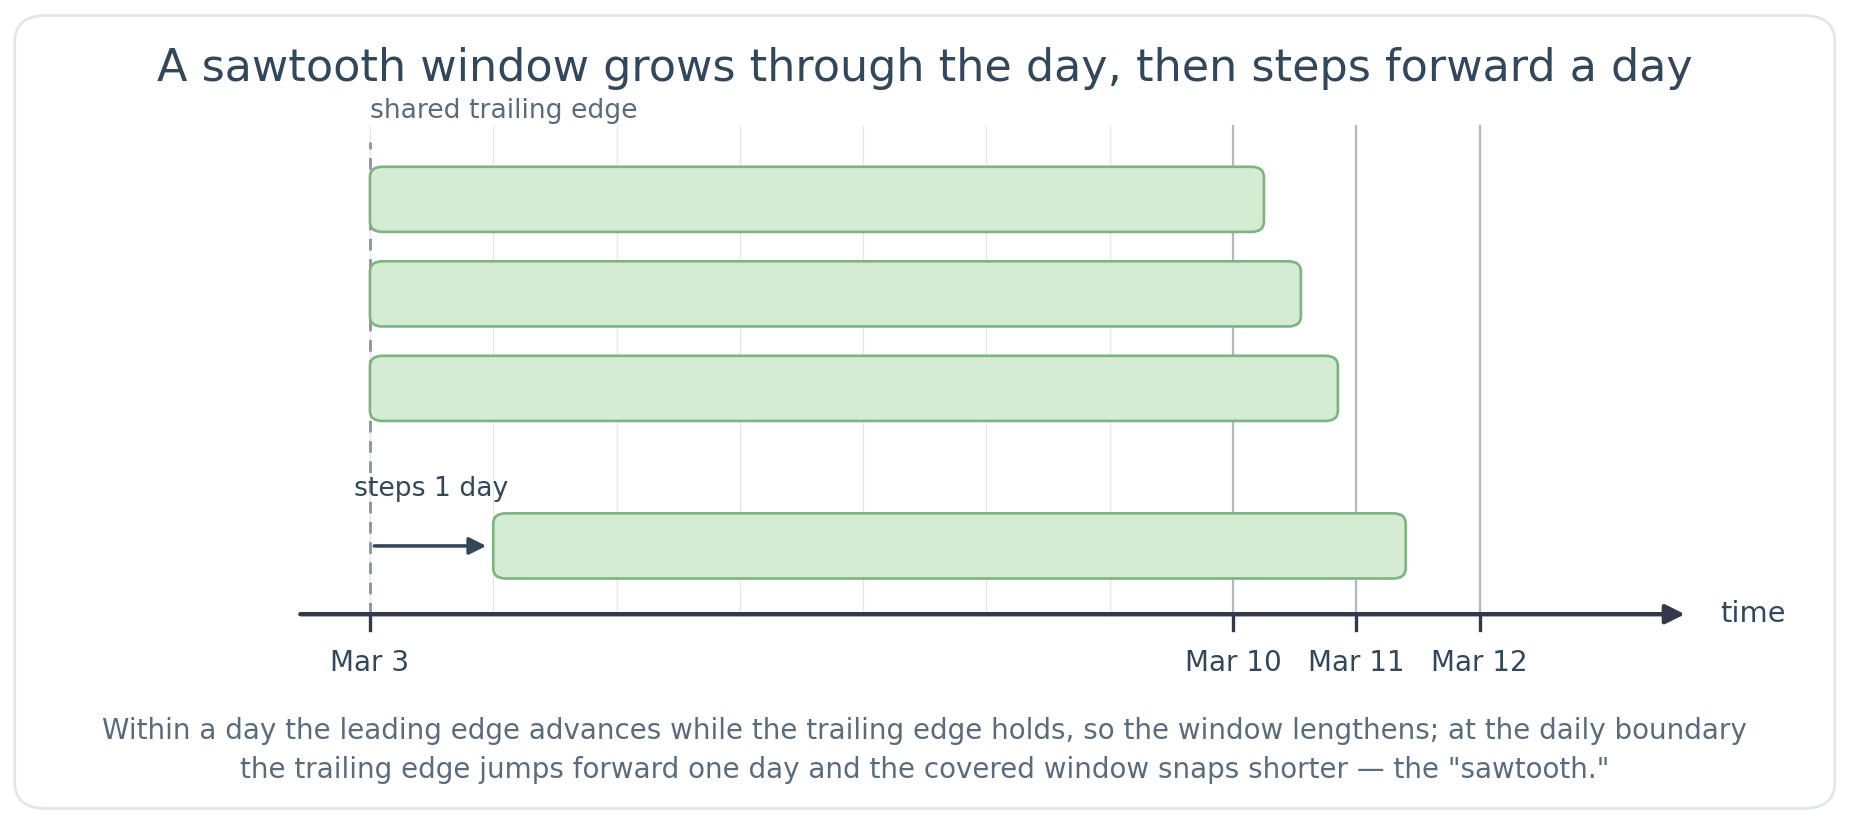
Une fenêtre en dents de scie est une agrégation qui prend en charge des mises à jour très récentes pour les événements récents, ainsi qu’un compactage quotidien des données historiques. Son bord arrière (plus ancien) avance par étapes quotidiennes fixes tandis que son bord avant (récent) reste à jour avec les derniers événements, de sorte que la longueur effective de la fenêtre « scie » au cours de chaque journée. La majeure partie de la fenêtre est servie à partir des données de la table d’ingestion du Stream, et seuls les deux jours les plus récents proviennent du flux en direct. Il s’agit d’un compromis qui permet de compute efficacement des fenêtres de longue durée (s’étendant sur des années) tout en restant réactif aux mises à jour récentes.
Les fenêtres en dents de scie sont matérialisées sur un chemin hybride de type batch et streaming. Un pipeline de type batch maintient la majeure partie de la fenêtre, tandis qu'un pipeline de streaming garde les données les plus récentes à jour en temps réel. Les deux sont Merge lors de la lecture ; ainsi, pour le modèle ou le consommateur de service, il s'agit d'une fonctionnalité unique.
Because the historic portion of the window is computed by the batch pipeline, a sawtooth feature is ready to serve shortly after materialization begins, even when the window spans months or years. Une fenêtre glissante n'est complète qu'après l'écoulement de toute sa durée. The minimum window_duration must be greater than two days (the enforced lower bound). Databricks recommends a sawtooth window for durations longer than 7 days. For windows longer than two days and up to seven days, choose between the fixed-length precision of a rolling window and the faster production readiness of a sawtooth window.
Une fonctionnalité en dents de scie s'appuie sur un historique déjà présent. La table d'ingestion de Stream doit contenir des données couvrant au moins la durée totale de la fenêtre, sinon la fenêtre calculée est incomplète. Avant que 2 jours pleins ne se soient écoulés, la fonctionnalité reflète uniquement les données matérialisées jusqu'à présent. Il n'est pas recommandé de servir la fonctionnalité en production tant que 2 jours pleins ne se sont pas écoulés. Une agrégation sur une fenêtre vide renvoie 0 pour Sum et Count, et null pour Avg, Min, Max, First, Last, VarPop, VarSamp, StddevPop et StddevSamp.
Pour savoir si une fonctionnalité Sawtooth est prête, ouvrez la Feature View dans l’Explorateur de catalogues. Dans la section des fonctionnalités matérialisées, le backfill par batch est terminé une fois que l'heure de la dernière matérialisation de la fonctionnalité avance et que son statut indique un succès. La partie streaming est matérialisée par un pipeline déclaratif Lakeflow. Une fois la Feature View validée, la fonctionnalité matérialisée est liée à ce pipeline, où vous pouvez surveiller son statut d'exécution.
Les fenêtres en dents de scie nécessitent un StreamSource et sont matérialisées avec StreamingMode.
class SawtoothWindow(TimeWindow):
    window_duration: datetime.timedelta
Les bords d'une fenêtre en dents de scie se déplacent différemment de ceux d'une fenêtre glissante : le bord d'attaque suit le dernier événement, tandis que le bord de fuite avance une fois par jour plutôt qu'en continu. Chaque jour, à une heure de coupure fixe de 18 h 00 UTC, le bord de fuite avance jusqu'à la limite de minuit UTC de ce jour. Par conséquent, la fenêtre effective est légèrement plus longue que window_duration et s'agrandit au cours de la journée avant de revenir en arrière d'un jour à la coupure suivante. L'entraînement et le service utilisent la même coupure de 18 h 00 UTC, de sorte que l'entraînement hors ligne et le service en ligne restent cohérents.
parameter | Contraintes |
|---|---|
| Doit être supérieur à deux jours. Une durée qui n'est pas un nombre entier de jours (par exemple, |
Les fenêtres en dents de scie prennent en charge les fonctions d'agrégation Sum, Avg, Count, Min, Max, First, Last, VarPop, VarSamp, StddevPop et StddevSamp.
Exemple de fenêtre en dents de scie (sawtooth)
L’exemple suivant montre un décompte sur 7 jours des transactions d’un utilisateur. La borne supérieure suit l’événement actuel tandis que la borne inférieure avance d’un jour à la fois. Pour les événements du 10 mars, la fenêtre remonte jusqu’au 3 mars environ. À mesure que la journée du 10 mars avance, la borne supérieure continue de progresser tandis que la borne inférieure reste fixe, ce qui augmente la période couverte. Ensuite, au start du 11 mars, la borne inférieure passe au 4 mars environ. La fenêtre effective est toujours un peu plus longue que sept jours. Les deux jours les plus récents sont servis à partir du flux en direct, et les jours précédents sont servis à partir de la table d'ingestion du Stream.
from databricks.feature_engineering.entities import SawtoothWindow
from datetime import timedelta

# 7-day window kept continuously fresh with streaming data
window = SawtoothWindow(window_duration=timedelta(days=7))
Limitations de la fenêtre Sawtooth
- Le parameter
delayn’est pas pris en charge. SourceLateness.settling_delayn'est pas pris en charge.- Les fonctions d'agrégation autres que
Sum,Avg,Count,Min,Max,First,Last,VarPop,VarSamp,StddevPopetStddevSampne sont pas prises en charge (par exemple,ApproxCountDistinct,ApproxPercentile,FirstN,LastN,FirstDistinctetLastDistinct). - Les fenêtres en dents de scie (sawtooth) nécessitent un
StreamSource. UnDeltaTableSourcen'est pas pris en charge.
Materialization triggers
Les déclencheurs déterminent le moment où un pipeline de matérialisation s'exécute. Le type de Trigger dépend du type de fonctionnalité.
CronSchedule
Utilisez CronSchedule pour les fonctionnalités d’agrégation par batch. Par défaut, Databricks déduit une planification de la fenêtre d’agrégation. Un planning dérivé prend en compte la période de la fenêtre, la fenêtre delay et offset, et la source settling_delay afin qu’une exécution ne publie pas de fenêtre avant que les données sources ne soient censées être complètes. Les plannings dérivés prennent en charge les fenêtres par blocs et glissantes.
Pour demander une planification dérivée, omettez l’expression cron. CronSchedule() et la forme explicite CronSchedule(mode=CronScheduleMode.DERIVED) sont équivalents :
from databricks.feature_engineering.entities import (
    CronSchedule,
    CronScheduleMode,
)

trigger = CronSchedule(mode=CronScheduleMode.DERIVED)
Ne définissez pas quartz_cron_expression avec CronScheduleMode.DERIVED. Lorsque vous récupérez la caractéristique matérialisée, la planification renvoyée peut contenir l’expression cron calculée par Databricks.
Pour contrôler directement la planification, fournissez une expression Quartz cron. CronScheduleMode.MANUAL est déduit lorsque vous fournissez une expression :
from databricks.feature_engineering.entities import CronSchedule

trigger = CronSchedule(
    quartz_cron_expression="0 0 * * * ?",  # Hourly
    timezone_id="UTC",
)
TableTrigger
Utilisez TableTrigger pour les fonctionnalités ColumnSelection ou les fonctionnalités d'agrégation (AggregationFunction) prises en charge par un DeltaTableSource. Le pipeline s'exécute chaque fois que la table Delta en amont reçoit un nouveau commit.
Pour les fonctionnalités d'agrégation, le pipeline est limité afin de ne pas s'exécuter à chaque commit. Le pipeline s'exécute au plus une fois par moitié de la longueur de la fenêtre de la fonctionnalité, mais jamais plus souvent que toutes les 5 minutes. Par exemple, une fonctionnalité avec une fenêtre basculante d'une heure s'exécute au plus une fois toutes les 30 minutes, ou une fonctionnalité avec une fenêtre de 8 heures s'exécute au plus une fois toutes les 4 heures. Le seuil minimal de 5 minutes s'applique lorsque la moitié de la fenêtre est inférieure à cette durée ; ainsi, les fenêtres de 10 minutes ou moins s'exécutent au plus une fois toutes les 5 minutes. Les fonctionnalités d'agrégation dont la fenêtre est inférieure à 5 minutes ne peuvent pas utiliser TableTrigger; utilisez plutôt un Trigger de streaming.
from databricks.feature_engineering.entities import TableTrigger

trigger = TableTrigger()
StreamingMode
Utilisez StreamingMode pour les fonctionnalités prises en charge par un StreamSource. Le pipeline s'exécute en tant que pipeline de streaming continu.
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    StreamSource, Feature, AggregationFunction, Sum,
    RollingWindow, OnlineStoreConfig, StreamingMode,
)
from datetime import timedelta

fe = FeatureEngineeringClient()

stream_source = StreamSource(full_name="my_catalog.my_schema.my_stream")

streaming_feature = fe.create_feature(
    source=stream_source,
    entity=["value.user_id"],
    timeseries_column="value.event_time",
    function=AggregationFunction(
        operator=Sum(input="value.amount"),
        time_window=RollingWindow(window_duration=timedelta(hours=1)),
    ),
    catalog_name="my_catalog",
    schema_name="my_schema",
    name="user_purchase_sum",
)

fe.materialize_features(
    features=[streaming_feature],
    online_config=OnlineStoreConfig(
        catalog_name="my_catalog",
        schema_name="my_schema",
        table_name_prefix="streaming_features_serving",
        online_store_name="feature_store_online",
    ),
    trigger=StreamingMode(),
)
Choosing a Trigger
Chaque fonctionnalité utilise un Trigger ; les options par type de fonctionnalité sont :
Type de fonctionnalité | Déclencheur | Lors de l'exécution |
|---|---|---|
Agrégation ( |
| Selon une planification dérivée ou manuelle |
Agrégation ( |
| Lors de chaque commit de table source |
|
| Lors de chaque commit de table source |
Fonctionnalités de |
| Streaming continu |
Vous ne pouvez pas matérialiser de fonctionnalités qui nécessitent différents types de Trigger dans un seul appel materialize_features. Lancez plutôt des appels séparés.