Convertir du SQL avec Genie Migrate
Genie Migrate, anciennement le convertisseur de code agentique, utilise Genie Code pour convertir le SQL existant provenant de dialectes tels que T-SQL, Snowflake, Redshift, Oracle, BigQuery et Teradata en code qui s’exécute sur Databricks. Vous organisez votre travail dans un projet de migration et choisissez un framework cible pour la sortie : SQL pour générer des queries Databricks SQL, ou Notebooks pour générer des notebooks Databricks utilisant l’API DataFrame. Genie Migrate analyse chaque script source, valide la sortie convertie et corrige les erreurs de manière itérative avant d’écrire les résultats dans un dossier de workspace.
Genie Migrate fait partie des outils Databricks permettant de migrer des workloads à partir de data warehouses et d’outils ETL existants vers Databricks. Il convertit votre SQL source pendant que vous organisez et suivez le travail dans un projet de migration.
Comment ça marche
Vous start une conversion en créant un projet de migration dans votre Workspace. Le projet suit l'état de chaque fichier et vous offre un endroit unique pour gérer la migration.

Lorsque vous exécutez une conversion, Genie Code déploie des sous-agents qui convertissent les fichiers simultanément. Chaque sous-agent analyse le dialecte source et génère le code équivalent pour le framework cible du projet (Databricks SQL ou un notebook Databricks). Il vérifie ensuite le code converti :
- Syntaxe : vérifie que le code converti s’exécute sur Databricks sans erreur.
- Intention sémantique : vérifie que le code converti conserve la logique métier de la source, par exemple les mêmes clauses joins et
WHERE.
Lorsqu’une vérification échoue, le sous-agent révise le code et vérifie à nouveau. Genie Code applique également vos compétences personnalisées lorsqu’il convertit des fichiers. Voir Créer une compétence personnalisée (optionnel). Les fichiers convertis sont écrits directement dans le dossier du workspace que vous spécifiez pour le projet.
Vous pouvez également convertir un fichier ou un dossier unique sans projet à l'aide de la commande /migrate dans une conversation Genie Code.
Exigences
- Vos fichiers SQL existants doivent être accessibles dans votre workspace, soit upload en tant que fichiers de workspace, soit ouverts dans l'éditeur.
- Votre Workspace doit répondre aux exigences de Genie Code. See Genie Code.
- Pour utiliser le framework cible Notebooks ou l’analyse et le lignage de projet, qui sont en bêta, un administrateur de workspace doit activer Fonctionnalités expérimentales des projets de migration à partir de la page Aperçus . Consultez Gérer les aperçus Databricks.
Sources prises en charge et limites
Le convertisseur prend en charge les dialectes sources suivants :
- T-SQL
- Snowflake SQL
- Redshift SQL
- Oracle
- BigQuery
- Teradata
Lorsque vous créez un projet de migration, choisissez l'un des frameworks cibles suivants :
- SQL : requêtes Databricks SQL conformes à la norme ANSI.
- Notebooks (Bêta) : Notebooks Databricks utilisant l’API DataFrame, avec
spark.sqlpour la logique plus claire en SQL.
Les limites suivantes s’appliquent à chaque conversion :
- Un batch peut contenir un maximum de 300 fichiers.
- Les scripts Teradata BTEQ ne sont pas encore pris en charge.
Convertir le code SQL existant
Les étapes suivantes décrivent comment convertir du SQL existant dans un projet de migration.
Étape 1 : upload les fichiers source
Upload vos fichiers SQL existants (.sql) à l’aide du navigateur de fichiers du Workspace, ou utilisez la CLI Databricks pour upload en masse un répertoire de scripts.
Étape 2 : créez un projet de migration
Créez un projet de migration depuis votre workspace :
- Cliquez sur
 > Projet de migration .
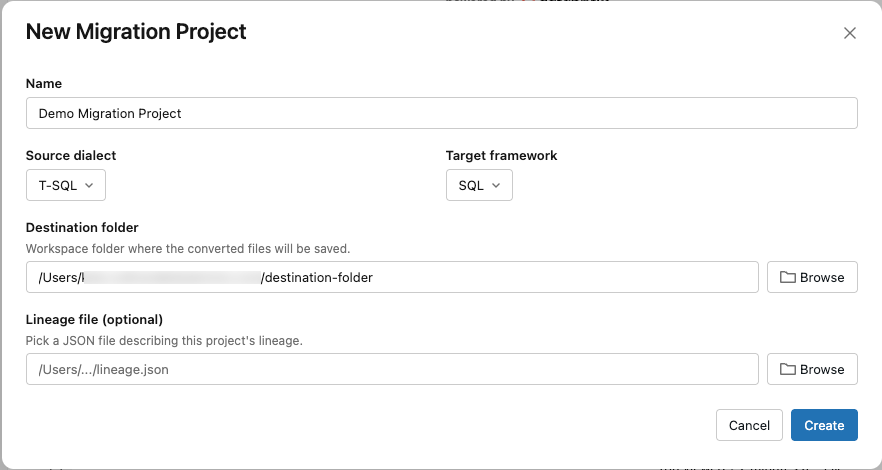
- Saisissez un **Nom** pour le projet.
- Utilisez les sélecteurs déroulants pour choisir un dialecte source et un framework cible . Pour le framework cible , choisissez SQL pour générer des queries Databricks SQL ou Notebooks (bêta) pour générer des notebooks Databricks.
- Saisissez le chemin d’accès au fichier du **Dossier de destination** cible. Cliquez sur Parcourir pour choisir une destination dans la liste des dossiers Workspace disponibles.
- (Facultatif) Saisissez le chemin d'accès à un **fichier de lignage** qui décrit le lignage du projet. Cliquez sur **Parcourir** pour choisir le fichier dans une liste de fichiers de votre Workspace.
- Cliquez sur Créer .
Étape 3 : Ajoutez des fichiers à votre projet
Dans le nouveau projet :
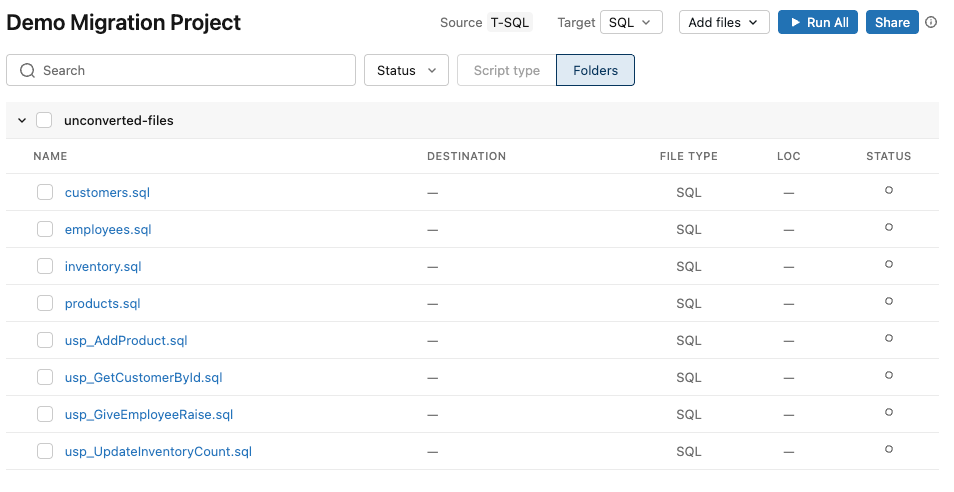
- Cliquez sur **Ajouter des fichiers** > **+ Ajouter des fichiers**.
- Sélectionnez le dossier source ou un fichier depuis votre Workspace.
Le projet répertorie chaque fichier avec son type de fichier, son nombre de lignes et son état de conversion.
Étape 4 : examiner la complexité du code et la traçabilité (facultatif)
Analysez le projet pour examiner la complexité du code et les dépendances entre les fichiers avant de convertir. L'analyse du projet et la traçabilité sont en version bêta. Pour les utiliser, un administrateur de workspace doit activer Fonctionnalités expérimentales des projets de migration sur la page Aperçus . Consultez Gérer les aperçus Databricks.
- Dans le projet, cliquez sur Analyser tout . Si le projet n’a pas de lignage, Analyser tout est l’action default. Sinon, sélectionnez Analyser tout dans le menu déroulant du bouton. L’analyse couvre tous les fichiers du projet, même si vous sélectionnez des fichiers.
- Attendez que l’analyse se termine. Pour annuler une analyse en cours, cliquez sur Arrêter . Une fois l’analyse terminée, le bouton devient Tout convertir .
- Cliquez sur un fichier source pour ouvrir son évaluation de complexité et cliquez sur Lineage pour ouvrir un graphe de dépendances qui montre les fichiers et les tables interdépendants que vous devez migrer ensemble.
Étape 5 : Exécutez la conversion
Pour convertir des fichiers spécifiques, sélectionnez-les et cliquez sur Convertir la sélection . Pour convertir tous les fichiers du projet, effacez la sélection et cliquez sur Convertir tout . Genie Code ouvre une conversation, invoque la compétence de migration et déploie des sous-agents pour convertir les fichiers simultanément. Chaque fichier converti apparaît comme un fichier lié dans le projet. Le convertisseur marque chaque fichier avec un statut :
- Vert : Converti avec succès
- Jaune : Examen requis
- Red : échec de la conversion
- Gris : En cours
Étape 6 : Examiner les résultats de la conversion
Pour les projets SQL , cliquez sur un fichier converti pour ouvrir une comparaison côte à côte dans l’éditeur SQL, avec le code source à côté du SQL Databricks proposé. Acceptez toutes les modifications suggérées, ou examinez et acceptez les modifications individuelles. Pour les projets Notebooks , cliquez sur un fichier converti pour ouvrir le notebook Databricks généré. Pour les scripts qui ne sont pas convertis, modifiez le code dans l’éditeur ou demandez à Genie Code de revalider ou de réessayer des sections spécifiques. Une fois que vous êtes satisfait, exécutez le SQL ou le notebook converti pour confirmer qu’il s’exécute sur Databricks. Si la même erreur apparaît dans plusieurs fichiers, capturez la correction dans une compétence personnalisée et réexécutez ces fichiers. Voir Créer une compétence personnalisée (facultatif).
Créer une compétence personnalisée (facultatif)
Les compétences personnalisées vous permettent d'encoder des règles métier que Genie Code applique automatiquement lors de chaque conversion. Utilisez-les pour gérer les types de données propriétaires, appliquer les modèles cibles préférés ou enregistrer les corrections que vous effectuez de manière répétée. Une compétence de migration est une compétence Genie Code, vous pouvez donc la créer et la gérer de la même manière que toute autre compétence. Pour plus de détails, consultez Étendre Genie Code avec les compétences d'agent.
Il n’est pas nécessaire de définir toutes vos compétences avant votre première conversion. La plupart des règles qu’une compétence devrait capturer ne deviennent claires qu’après avoir examiné les premiers résultats. Un flux de travail classique est :
- Convertissez un ensemble représentatif de fichiers.
- Examinez les fichiers qui doivent être révisés ou qui ont échoué, et recherchez les erreurs qui se répètent dans les fichiers, telles que le même type de données, la même fonction ou le même modèle de nommage non pris en charge.
- Créez une compétence qui capture la correction pour chaque erreur récurrente.
- Sélectionnez uniquement les fichiers concernés et cliquez sur Convertir la sélection . Genie Code applique la nouvelle compétence à ces fichiers.
Répétez ce cycle au fur et à mesure que vous convertissez davantage de code. Genie Code applique chaque compétence aux conversions ultérieures dans le workspace, de sorte qu’un correctif couvre d’autres fichiers avec le même modèle.
Vous pouvez créer une compétence à partir des paramètres de Genie Code ou d'une conversation Genie Code. Utilisez le chemin des paramètres pour les compétences complexes qui incluent des instructions détaillées, des exemples ou des fichiers de support. Utilisez le chemin de discussion pour des compétences rapides et à règle unique.
- Genie Code settings
- Genie Code chat
Créez la compétence en tant que fichier afin que vous puissiez rédiger des instructions détaillées et le versionner dans un dossier Git :
-
Dans le panneau Genie Code, cliquez sur
 Paramètres , puis cliquez sur
 Ouvrir le dossier des compétences .
-
Créez un dossier pour votre compétence sous le chemin des compétences du Workspace,
Workspace/.assistant/skills/. Par exemple,Workspace/.assistant/skills/sql-migration/. -
Dans le dossier de compétences, créez un fichier
SKILL.mdavec le frontmatter requis et vos règles de conversion. Par exemple :---name: sql-migrationdescription: Conversion rules to apply when migrating legacy SQL to ANSI SQL.---Always convert the custom type MYDATE to TIMESTAMP_NTZ.
Genie Code prend en compte la compétence la prochaine fois que vous exécutez une conversion.
Décrivez la règle de conversion que vous souhaitez encoder, puis demandez à Genie Code de l'enregistrer :
Always convert our custom type MYDATE to TIMESTAMP_NTZ. Save this as a custom migration skill.
Genie Code crée et enregistre la compétence et l'applique aux futures conversions dans le Workspace.
Pour afficher les compétences actives :
Show me my migration skills
Pour supprimer une compétence :
Delete the migration skill for [description]
Les compétences Workspace sont stockées au niveau du Workspace et partagées entre tous les utilisateurs du Workspace.
Conseils pour le test
Dans le cadre de sa boucle agentique, le convertisseur analyse chaque script source, valide que la sortie convertie est syntaxiquement valide et sémantiquement équivalente à la source, et corrige itérativement les sections qui échouent avant d'écrire les résultats. Les conseils suivants vous aident à examiner la sortie et à lui faire confiance :
- Conversion par batch : Convertissez un petit batch de deux à cinq fichiers en une session pour vérifier que la conversion de plusieurs fichiers fonctionne de bout en bout.
- Validation syntaxique : Après la conversion, exécutez la sortie dans un éditeur Databricks SQL ou un Notebook pour confirmer qu'elle s'exécute sans erreurs.
- Cas limites : Incluez un script avec des constructions spécifiques au dialecte, telles que des fonctions de fenêtre T-SQL, Snowflake
QUALIFYou Redshift,LISTAGGpour voir comment le convertisseur gère les modèles non triviaux. - Exactitude sémantique : Exécutez les queries originales et converties par rapport à des données de test équivalentes et comparez les résultats. Confirmez que la sortie est sémantiquement correcte, et pas seulement syntaxiquement valide.