Évaluez votre agent
Évaluez votre agent par rapport aux cas de test d'un dataset d'évaluation à l'aide de la fonction mlflow.genai.evaluate(). Au lieu d'exécuter manuellement votre agent et de vérifier les résultats un par un, MLflow Evaluation offre un moyen structuré d'injecter des données de test, d'exécuter votre agent et de noter automatiquement les résultats. Cela facilite la comparaison des versions, le suivi des améliorations et le partage des résultats entre les équipes.
L'évaluation MLflow relie les tests hors ligne au monitoring en production. Cela signifie que la même logique d'évaluation que vous utilisez en développement peut également être exécutée en production, vous offrant une vue cohérente de la qualité sur l'ensemble du cycle de vie de l'IA.
La fonction mlflow.genai.evaluate() teste systématiquement la qualité des agents GenAI en les exécutant par rapport à des données de test (jeux de données d’évaluation) et en appliquant des scorers.
Si l’évaluation est nouvelle pour vous, start par Évaluer et améliorer.
Quand utiliser
- Vérifications quotidiennes ou hebdomadaires de votre application par rapport à des jeux de données d’évaluation organisés.
- Validation des changements de prompt ou de modèle entre les versions d'application
- Avant une publication ou une PR pour éviter les régressions de qualité
Référence rapide
La fonction mlflow.genai.evaluate() exécute votre agent sur un dataset d'évaluation à l'aide d'évaluateurs spécifiés et, éventuellement, d'une fonction de prédiction ou d'un ID de modèle, renvoyant un EvaluationResult.
def mlflow.genai.evaluate(
    data: Union[pd.DataFrame, List[Dict], mlflow.genai.datasets.EvaluationDataset],  # Test data.
    scorers: list[mlflow.genai.scorers.Scorer],  # Quality metrics, built-in or custom.
    predict_fn: Optional[Callable[..., Any]] = None,  # App wrapper. Used for direct evaluation only.
    model_id: Optional[str] = None,  # Optional version tracking.
) -> mlflow.models.evaluation.base.EvaluationResult:
- Pour plus de détails sur l'API, consultez les paramètres de
mlflow.genai.evaluate()ou la documentation MLflow. - Pour plus de détails sur
EvaluationDataset, consultez Création de datasets d'évaluation MLflow.
Exigences
-
Installez MLflow et les packages requis.
Bashpip install --upgrade "mlflow[databricks]>=3.1.0" openai "databricks-connect>=16.1" -
Créez une expérience MLflow en suivant le guide de démarrage rapide de configuration de votre environnement.
(Facultatif) Configurer la parallélisation
MLflow utilise default un pool de threads d'arrière-plan pour accélérer le processus d'évaluation. Pour configurer le nombre de workers, définissez la variable d'environnement MLFLOW_GENAI_EVAL_MAX_WORKERS.
export MLFLOW_GENAI_EVAL_MAX_WORKERS=10
Modes d'évaluation
Il existe deux modes d'évaluation :
-
Évaluation directe (recommandée). MLflow appelle votre application directement pour générer des traces pour l'évaluation :
- Exécute votre application sur des entrées de test, en capturant des traces.
- Applique des évaluateurs ou des juges LLM pour évaluer la qualité, créant ainsi un retour.
- Stocke les résultats sous forme de traces avec les retours de l'évaluateur dans l'expérimentation MLflow active.
-
Évaluation de la feuille de réponses. Vous fournissez des sorties précalculées ou des traces existantes pour évaluation :
- Applique des scorers ou des juges LLM pour évaluer la qualité sur des sorties pré-calculées ou des traces, en créant des feedback.
- Stocke les résultats sous forme de traces avec les retours de l'évaluateur dans l'expérimentation MLflow active.
Évaluation directe (recommandé)
MLflow appelle directement votre agent pour générer et évaluer des traces. Vous pouvez soit transmettre le point d’entrée de votre application encapsulé dans une fonction Python (predict_fn), soit, si votre application est déployée en tant que endpoint Model Serving Databricks, transmettre ce endpoint encapsulé dans to_predict_fn.
En appelant directement votre application, ce mode vous permet de réutiliser les évaluateurs définis pour l'évaluation hors ligne dans le monitoring de production, étant donné que les traces résultantes seront identiques.
Comme le montre le diagramme, les données, votre application et les évaluateurs sélectionnés sont fournis en entrée à mlflow.genai.evaluate(), qui exécute l'application et les évaluateurs en parallèle et enregistre les sorties sous forme de traces et de feedback.

Formats de données pour l'évaluation directe
Pour plus de détails sur le schéma, consultez la référence du dataset d'évaluation.
Champ | Type de données | Obligatoire | Description |
|---|---|---|---|
|
| Oui | Dictionnaire transmis à votre |
|
| Non | Vérité terrain facultative pour les évaluateurs |
Exemple utilisant l'évaluation directe
Le code suivant montre un exemple d'exécution de l'évaluation :
import mlflow
from mlflow.genai.scorers import RelevanceToQuery, Safety

# Your agent with MLflow tracing
@mlflow.trace
def my_chatbot_app(question: str) -> dict:
    # Your app logic here
    if "MLflow" in question:
        response = "MLflow is an open-source platform for managing ML and GenAI workflows."
    else:
        response = "I can help you with MLflow questions."

    return {"response": response}

# Evaluate your app
results = mlflow.genai.evaluate(
    data=[
        {"inputs": {"question": "What is MLflow?"}},
        {"inputs": {"question": "How do I get started?"}}
    ],
    predict_fn=my_chatbot_app,
    scorers=[RelevanceToQuery(), Safety()]
)
Limitation du débit des appels de modèle
Lors de l'évaluation de modèles avec des limites de débit (tels que des APIs tierces ou des endpoints de modèles de fondation), limitez les appels que mlflow.genai.evaluate() effectue vers votre application.
Dans MLflow 3.11.1 et versions ultérieures, un limiteur de type token-bucket intégré régule les appels predict_fn sur tous les threads worker. Définissez MLFLOW_GENAI_EVAL_PREDICT_RATE_LIMIT sur le nombre maximum d'appels par seconde :
# 10 predict_fn calls per minute
export MLFLOW_GENAI_EVAL_PREDICT_RATE_LIMIT=0.167
Les valeurs acceptées sont auto (the default, un débit adaptatif commençant à 10 appels par seconde), un nombre positif pour un débit fixe, ou 0 pour désactiver la limitation. Variables associées :
Variable d'environnement | Par défaut | Description |
|---|---|---|
|
| Maximum |
| dérivé | Nombre maximum d'appels d'évaluateur par seconde. Default to the predict rate times the scorer count. |
|
| Nouvelles tentatives pour les erreurs de limitation de débit (429), appliquées à la fois aux appels |
Pour appliquer une limite sans dépendre de l’environnement, encapsulez plutôt votre fonction predict. Cet exemple utilise la bibliothèque ratelimit, installez-la donc avec MLflow :
pip install ratelimit
Passez le wrapper à predict_fn afin que le limiteur s'applique réellement :
import mlflow
from mlflow.genai.scorers import RelevanceToQuery, Safety
from ratelimit import limits, sleep_and_retry

# You can replace this with your own predict_fn
predict_fn = mlflow.genai.to_predict_fn("endpoints:/databricks-gpt-oss-20b")

@sleep_and_retry
@limits(calls=10, period=60)  # 10 calls per minute
def rate_limited_predict_fn(**kwargs):
  return predict_fn(**kwargs)

results = mlflow.genai.evaluate(
    data=[{"inputs": {"messages": [{"role": "user", "content": "How does MLflow work?"}]}}],
    predict_fn=rate_limited_predict_fn,
    scorers=[RelevanceToQuery(), Safety()]
)
La limite de débit ci-dessus contrôle les appels vers votre fonction predict_fn. Vous pouvez également contrôler le nombre de Workers utilisés pour évaluer votre agent en configurant la parallélisation.
Évaluation de la feuille de réponses
Utilisez ce mode lorsque vous ne pouvez pas – ou ne souhaitez pas – exécuter votre agent directement pendant l’évaluation. Par exemple, vous disposez déjà d’outputs (par exemple, provenant de systèmes externes, de traces historiques ou de batch jobs) et vous souhaitez simplement les noter. Vous fournissez les entrées et la sortie, et evaluate() exécute les évaluateurs et Logs une exécution d’évaluation.
Si vous utilisez une feuille de réponses avec des traces différentes de votre environnement de production, vous devrez peut-être réécrire vos fonctions d'évaluateur pour les utiliser pour le monitoring de production.
Comme indiqué dans le diagramme, vous fournissez les données d'évaluation et les évaluateurs sélectionnés en tant qu'entrées de mlflow.genai.evaluate(). Les données d'évaluation peuvent consister en des traces existantes, ou en des entrées et des sorties précalculées. Si des entrées et des sorties pré-calculées sont fournies, mlflow.genai.evaluate() construit des traces à partir des entrées et des sorties. Pour les deux options d'entrée, mlflow.genai.evaluate() exécute les évaluateurs sur les traces et affiche le feedback des évaluateurs.

Formats de données pour l'évaluation des feuilles de réponses
Pour plus de détails sur le schéma, consultez la référence du dataset d'évaluation.
Si des entrées et des sorties sont fournies
Champ | Type de données | Obligatoire | Description |
|---|---|---|---|
|
| Oui | Entrées d’origine de votre agent |
|
| Oui | Résultats précalculés de votre application |
|
| Non | Vérité terrain facultative pour les évaluateurs |
Si des traces existantes sont fournies
Champ | Type de données | Obligatoire | Description |
|---|---|---|---|
|
| Oui | Objets Trace MLflow avec entrées/sorties |
|
| Non | Vérité terrain facultative pour les évaluateurs |
Exemple utilisant des entrées et des sorties
Le code suivant montre un exemple d'exécution de l'évaluation :
import mlflow
from mlflow.genai.scorers import Safety, RelevanceToQuery

# Pre-computed results from your agent
results_data = [
    {
        "inputs": {"question": "What is MLflow?"},
        "outputs": {"response": "MLflow is an open-source platform for managing machine learning workflows, including tracking experiments, packaging code, and deploying models."},
    },
    {
        "inputs": {"question": "How do I get started?"},
        "outputs": {"response": "To get started with MLflow, install it using 'pip install mlflow' and then run 'mlflow ui' to launch the web interface."},
    }
]

# Evaluate pre-computed outputs
evaluation = mlflow.genai.evaluate(
    data=results_data,
    scorers=[Safety(), RelevanceToQuery()]
)
Exemple d'utilisation de traces existantes
Le code suivant montre comment lancer l'évaluation en utilisant des traces existantes :
import mlflow

# Retrieve traces from production
traces = mlflow.search_traces(
    filter_string="trace.status = 'OK'",
)

# Evaluate problematic traces
evaluation = mlflow.genai.evaluate(
    data=traces,
    scorers=[Safety(), RelevanceToQuery()]
)
Afficher les résultats dans l'UI
Une exécution d'évaluation est comme un rapport de test qui capture tout sur la façon dont votre application a fonctionné sur un dataset spécifique. L'exécution de l'évaluation contient une trace pour chaque ligne de votre dataset d'évaluation, annotée avec les commentaires de chaque juge.
En utilisant l'exécution d'évaluation, vous pouvez afficher les métriques agrégées et étudier les cas de test où votre application a mal fonctionné.
Résumé de l'évaluation
-
Cliquez sur **Expériences** dans la barre latérale pour afficher la page Expériences.
-
Cliquez sur le nom de votre experimentation pour l'ouvrir.
-
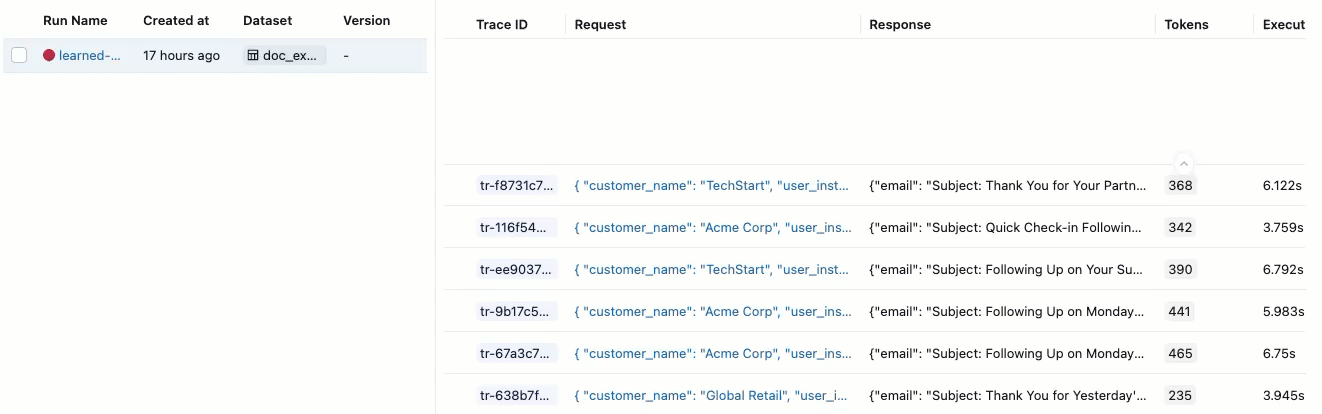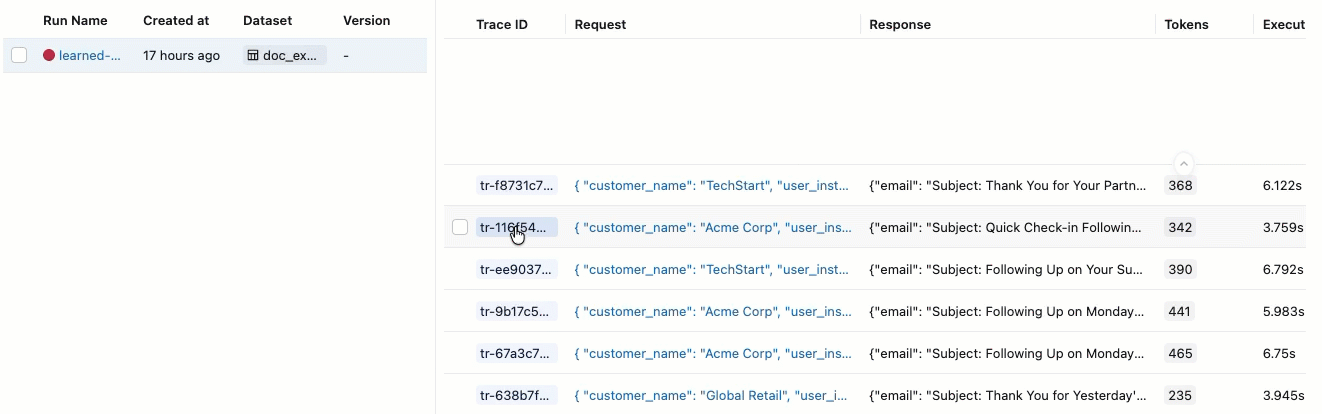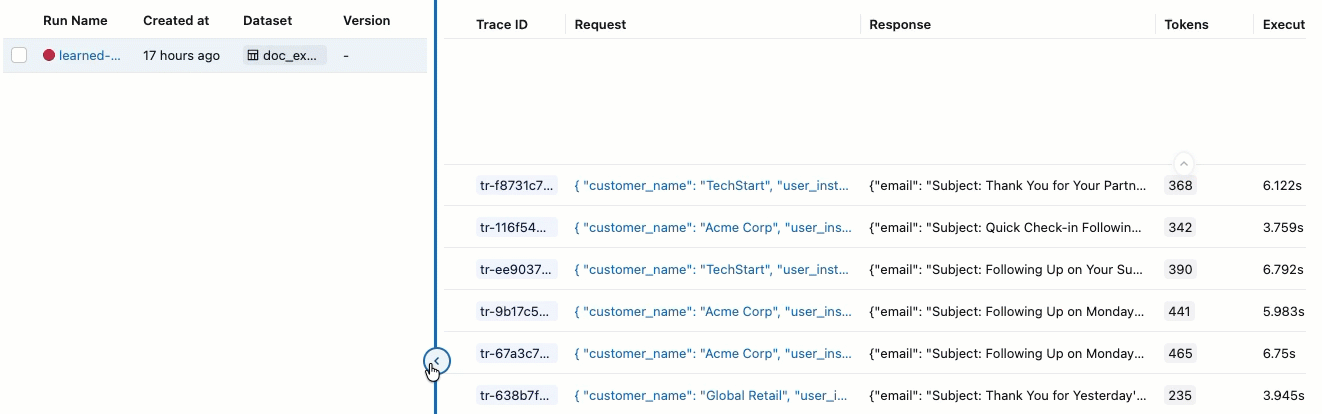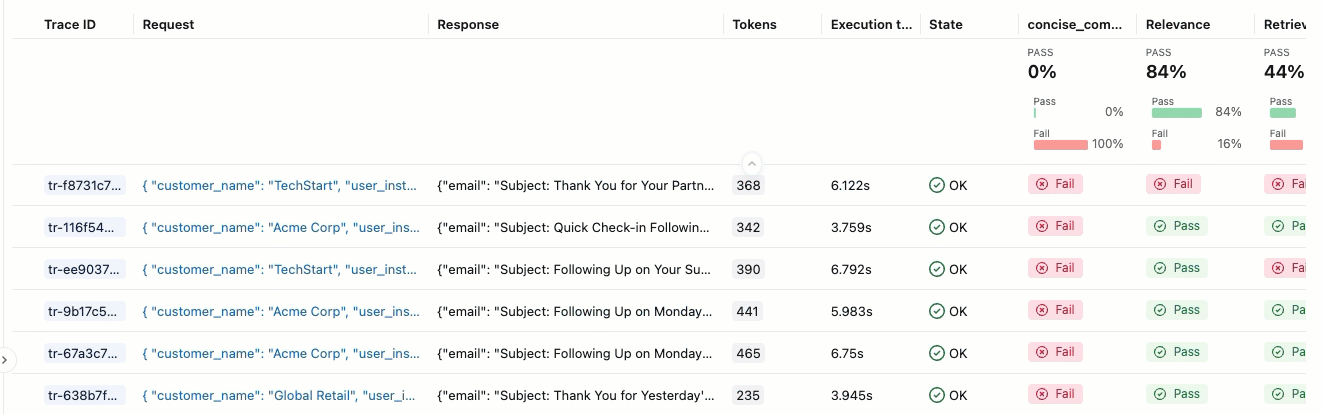
Dans la barre latérale gauche, cliquez sur Exécutions d'évaluation . Le volet de droite affiche un tableau de traces.

Si vous ne voyez pas les Évaluations avec leurs étiquettes Réussite et Échec , faites défiler vers la droite ou survolez le séparateur de volet et cliquez sur la flèche pointant vers la gauche.
-
Pour voir la justification de l'étiquette Réussite ou Échec , passez la souris sur l'étiquette.

Détails et ajout de commentaires.
Pour voir plus de détails pour chaque trace :
-
Cliquez sur l'identifiant de la demande dans la colonne **Demande**. Une fenêtre apparaît, affichant la trace complète, y compris les entrées et les sorties pour chaque étape.

-
À droite, vous pouvez ajouter des commentaires ou des attentes à appliquer à la réponse pour cette demande. Si le volet Évaluations n’apparaît pas, cliquez sur
 . Pour ajouter une nouvelle Évaluation, faites défiler l’écran vers le bas et cliquez sur
 .
-
Vous pouvez utiliser les flèches de chaque côté de cette fenêtre pour parcourir les requêtes.

Paramètres pour mlflow.genai.evaluate()
Cette section décrit chacun des paramètres utilisés par mlflow.genai.evaluate().
def mlflow.genai.evaluate(
    data: Union[pd.DataFrame, List[Dict], mlflow.genai.datasets.EvaluationDataset],  # Test data.
    scorers: list[mlflow.genai.scorers.Scorer],  # Quality metrics, built-in or custom.
    predict_fn: Optional[Callable[..., Any]] = None,  # App wrapper. Used for direct evaluation only.
    model_id: Optional[str] = None,  # Optional version tracking.
) -> mlflow.models.evaluation.base.EvaluationResult:
data
Le dataset d'évaluation doit être dans l'un des formats suivants :
EvaluationDataset(recommandations).- Liste de dictionnaires, DataFrame Pandas ou DataFrame Spark.
Si l’argument de données est fourni en tant que DataFrame ou liste de dictionnaires, il doit suivre le schéma suivant. Ceci est cohérent avec le schéma utilisé par EvaluationDataset. Databricks recommande d'utiliser un EvaluationDataset car il applique la validation du schéma, en plus de suivre la traçabilité de chaque enregistrement.
Champ | Type de données | Description | Utiliser avec l'évaluation directe | À utiliser avec feuille de réponses |
|---|---|---|---|---|
|
| Un | Obligatoire | Soit |
|
| Un | Ne doit pas être fourni, généré par MLflow à partir de la trace. | Soit |
|
| Un | Facultatif | Facultatif |
|
| L'objet de trace de la requête. Si le | Ne doit pas être fourni, généré par MLflow à partir de la trace. | Soit |
scorers
Liste des indicateurs de qualité à appliquer. Vous pouvez fournir :
Consultez Évaluateurs pour plus de détails.
predict_fn
Le point d’entrée de l’agent. Ce parameter est uniquement utilisé avec l’évaluation directe. predict_fn doit satisfaire aux exigences suivantes :
- Acceptez les clés du dictionnaire
inputsdansdatacomme arguments de mot-clé. - Renvoyer un dictionnaire sérialisable en JSON.
- Instrumentez-vous avec MLflow Tracing.
- Émettre exactement une trace par appel.
model_id
Identifiant de modèle facultatif pour Link les résultats à votre version d'application (par exemple, "models:/my-app/1").
Ressources supplémentaires
- Évaluez votre application – Guide étape par étape pour exécuter votre première évaluation.
- Construire des datasets d'évaluation – Créez des données de test structurées à partir des logs de production ou de zéro.
- Définir des évaluateurs personnalisés — Créez des indicateurs adaptés à votre cas d'utilisation spécifique.
Étape suivante : Exemples d’évaluation MLflow pour GenAI