Exécution adaptative de requêtes
La fonctionnalité Spark UI n'est pas disponible sur Databricks sur Google Cloud à partir de cette version.
L'exécution adaptative des requêtes (AQE) est une réoptimisation de requête qui se produit pendant l'exécution de la requête.
Avant qu’une query ne soit exécutée, l’optimiseur choisit un plan de query basé sur des estimations de la taille des données. Ces estimations peuvent être erronées si les statistiques de la table sont manquantes ou obsolètes, si les données sont faussées ou pour les étapes ultérieures d'une query complexe. Un plan basé sur des estimations erronées pourrait utiliser une stratégie de jointure lente, créer trop de petites tâches après un shuffle, ou créer quelques tâches surdimensionnées qui bloquent toute l'étape. AQE résout ces problèmes en réoptimisant le plan pendant l'exécution de la query, en fonction de la taille réelle des données.
À la fin de chaque échange aléatoire ou par diffusion, Databricks dispose de statistiques précises sur les données produites jusqu’à présent. AQE utilise ces statistiques pour choisir une meilleure stratégie physique, sélectionner un nombre et une taille optimaux de partitions après échange, ou appliquer des optimisations qui nécessiteraient autrement des indicateurs de query, comme la gestion des jonctions asymétriques.
AQE est activé par default. Vous n'avez pas besoin de modifier vos requêtes pour en bénéficier. Vérifiez si AQE a modifié un plan de query lorsque vous dépannez une query lente. Ajustez les paramètres AQE uniquement lorsque les paramètres default ne correspondent pas à votre charge de travail. Voir Plans de query et Configuration.
Fonctionnalités
AQE possède quatre fonctionnalités principales :
- Modifie dynamiquement le tri Merge Join en un Broadcast Hash Join.
- Agrège dynamiquement les partitions (combine de petites partitions en partitions de taille raisonnable) après l'échange de brassage. Les très petites tâches ont un throughput d'E/S plus faible et ont tendance à souffrir davantage du surcoût de planification et du surcoût de configuration des tâches. La combinaison de petites tâches permet d'économiser des Ressources et d'améliorer le throughput des clusters.
- Gère dynamiquement l'asymétrie dans la jointure par tri-Merge et la jointure hachée par mélange en divisant (et en répliquant si nécessaire) les tâches asymétriques en tâches de taille à peu près égale.
- Détecte et propage dynamiquement les relations vides, qui sont des parties d’une query qui ne renvoient aucune ligne.
query prises en charge
L'AQE s'applique aux query qui remplissent les deux conditions suivantes :
- Cette query n’est pas une query de streaming.
- La query contient au moins un échange (généralement issu d’une jointure, d’une agrégation ou d’une fenêtre), au moins une sous-requête, ou les deux.
AQE réoptimise chaque query prise en charge, mais le résultat peut être le même plan que celui compilé par l'optimiseur avant l'exécution de la query. Pour vérifier si AQE a modifié le plan d'une query, consultez Plans de query.
Plans de query
Les querys auxquelles AQE est appliqué contiennent un ou plusieurs nœuds AdaptiveSparkPlan, généralement comme nœud racine de chaque query principale ou sous-query. Chaque nœud AdaptiveSparkPlan est doté d’un indicateur isFinalPlan. L’indicateur est false avant et pendant l’exécution de la query, et devient true lorsque la query se termine.
Pour visualiser un plan de query, utilisez la Spark UI, DataFrame.explain() ou SQL EXPLAIN. Chacun montre des informations différentes sur la façon dont AQE modifie le plan.
Spark UI
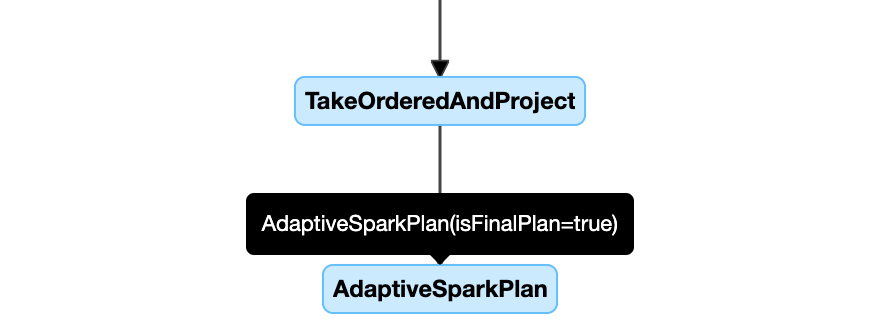
Le diagramme de plan de query dans la Spark UI montre le plan le plus récent et se met à jour à mesure que la query s'exécute. Les nœuds qui ont déjà été exécutés et possèdent des métriques ne changent pas. Les nœuds qui n'ont pas encore été exécutés peuvent changer à mesure que l'AQE réoptimise le plan.
Cet exemple montre un diagramme de plan de query :
DataFrame.explain()
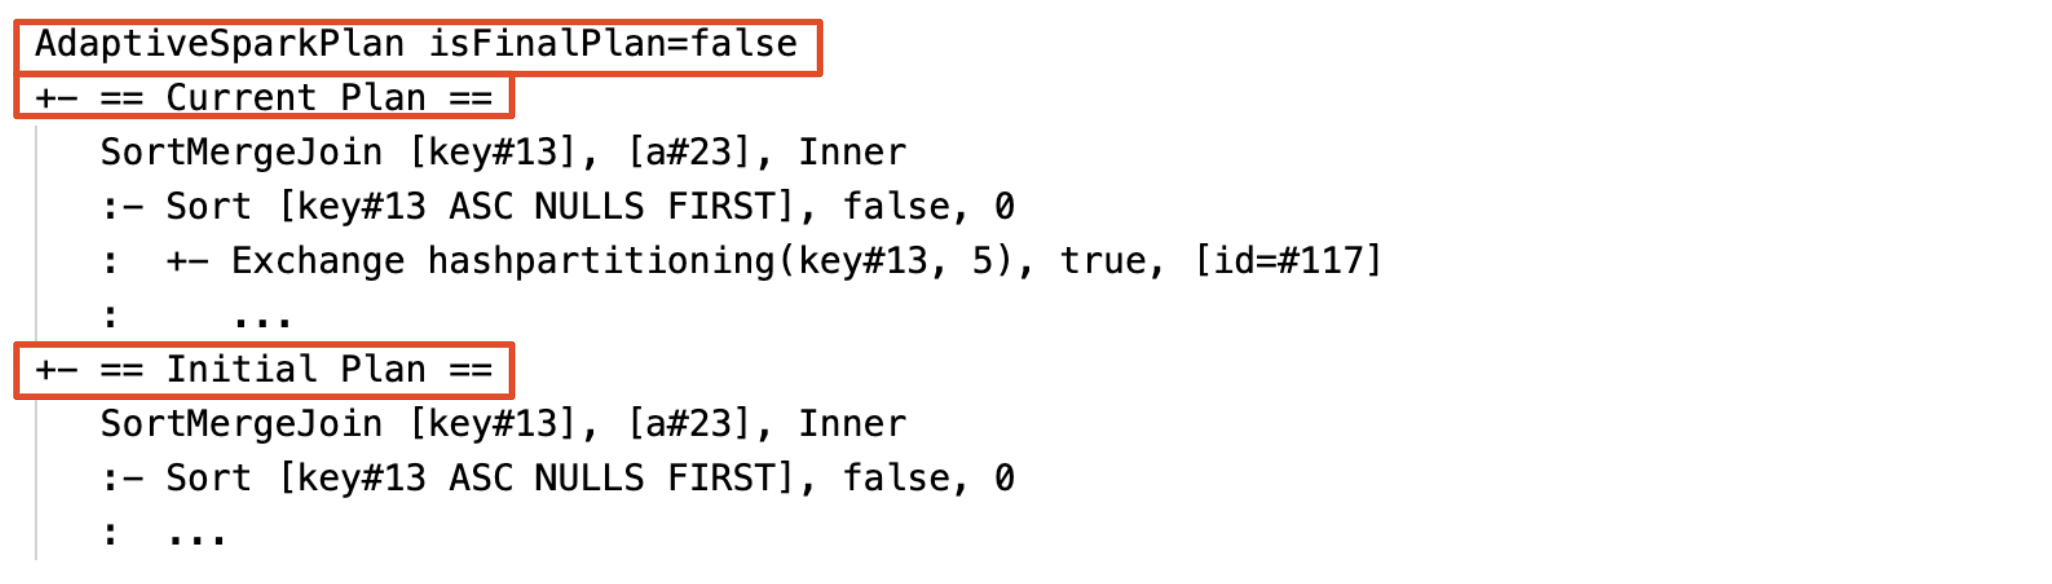
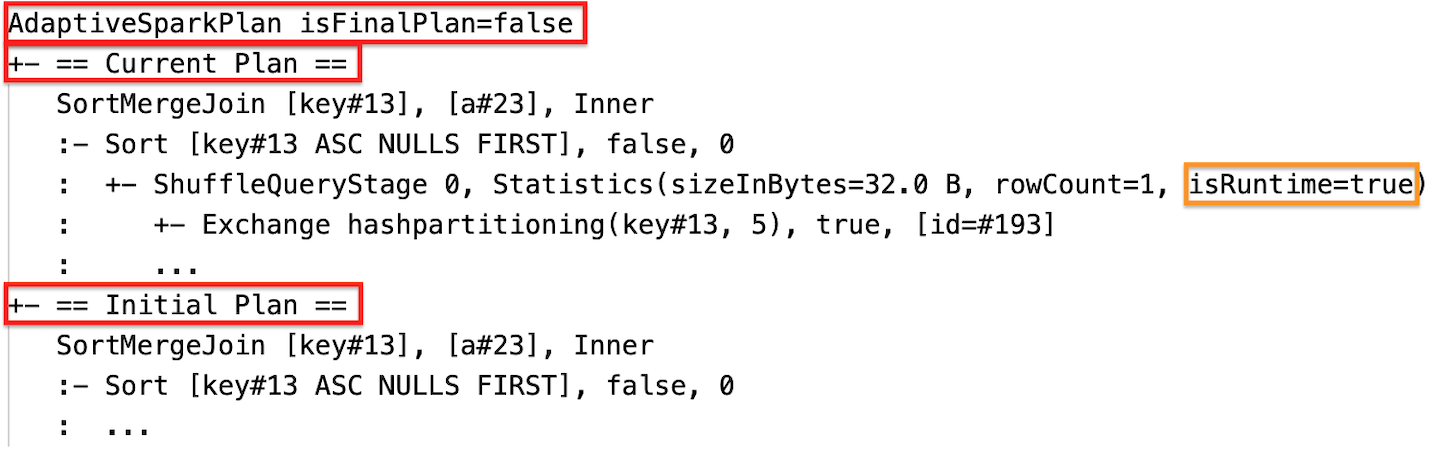
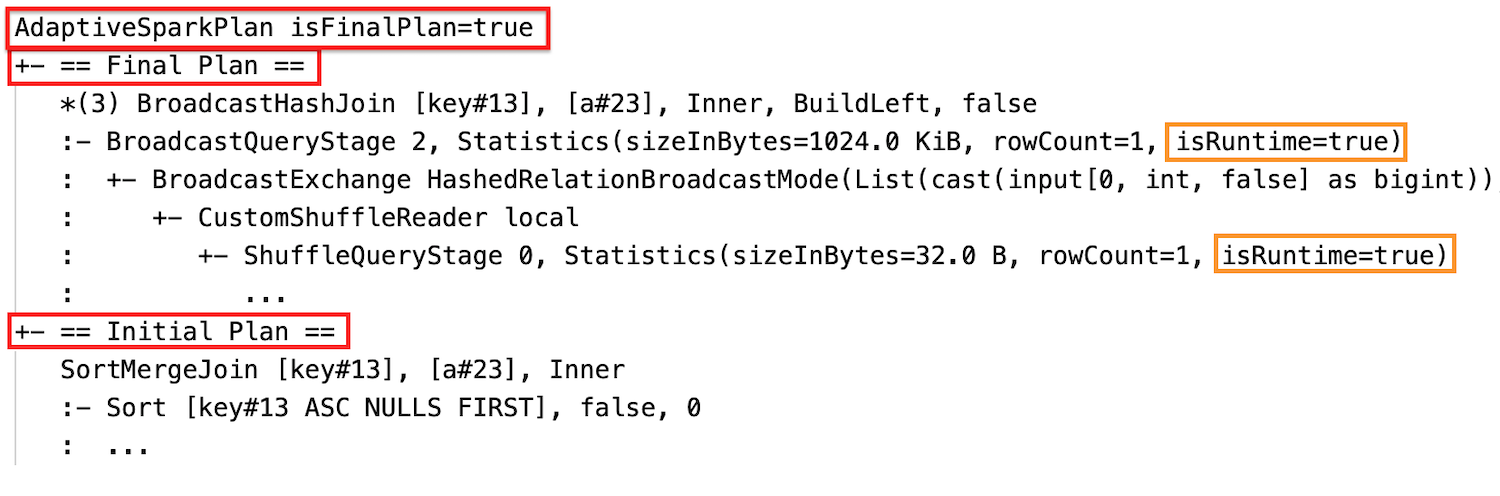
DataFrame.explain() affiche deux plans sous chaque nœud AdaptiveSparkPlan : le plan initial, avant que AQE n'applique des optimisations, et le plan actuel. Le plan actuel change à mesure que la query s’exécute et devient le plan final lorsque la query se termine.
La sortie inclut des statistiques de données pour chaque étape de mélange et de diffusion. Les statistiques dépendent de si l'étape a été exécutée :
- Avant et pendant l’exécution de l’étape,
isRuntimeestfalseet les statistiques sont des estimations au moment de la compilation. Par exemple,Statistics(sizeInBytes=1024.0 KiB, rowCount=4, isRuntime=false). - Une fois l'étape terminée,
isRuntimeesttrueet les statistiques sont des mesures d'exécution. Par exemple,Statistics(sizeInBytes=658.1 KiB, rowCount=2.81E+4, isRuntime=true).
Ces captures d'écran montrent la sortie de DataFrame.explain() avant, pendant et après l'exécution :
-
Avant l'exécution
-
Pendant l'exécution
-
Après exécution
SQL EXPLAIN
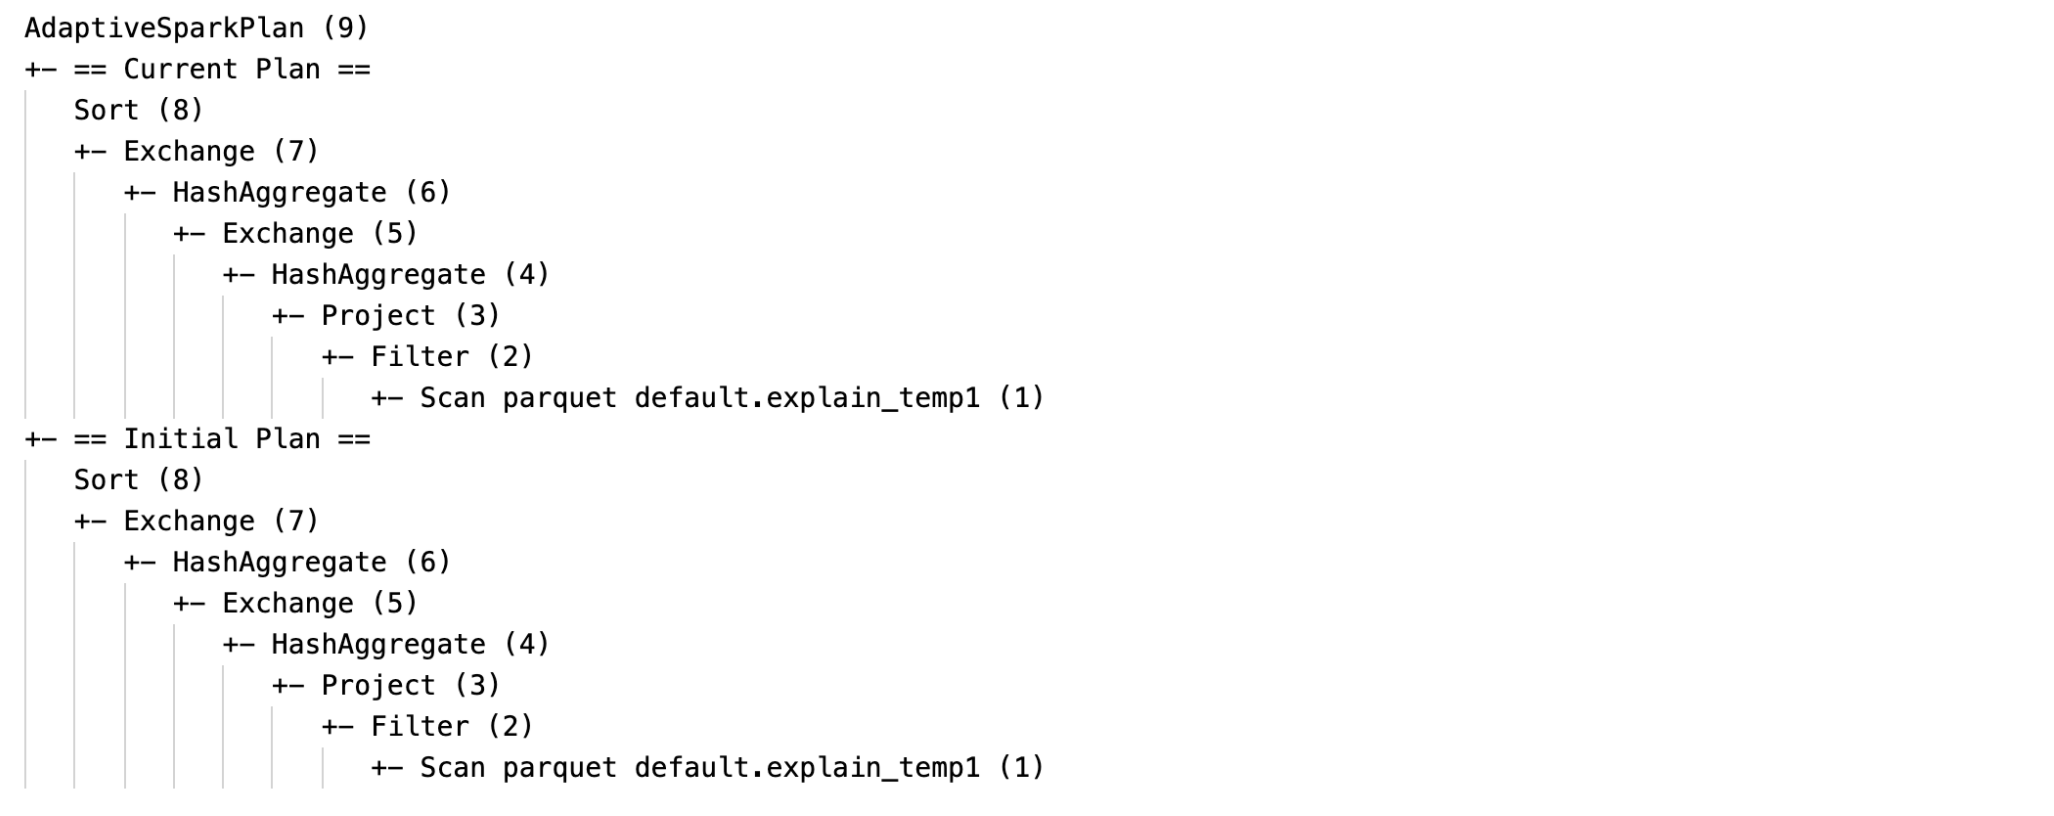
SQL EXPLAIN n'exécute pas la query, donc AQE ne peut pas la réoptimiser. La sortie affiche uniquement le plan initial, qui peut différer du plan exécuté par AQE.
Cet exemple montre la sortie SQL EXPLAIN :
Identifier les optimisations appliquées dans un plan de query
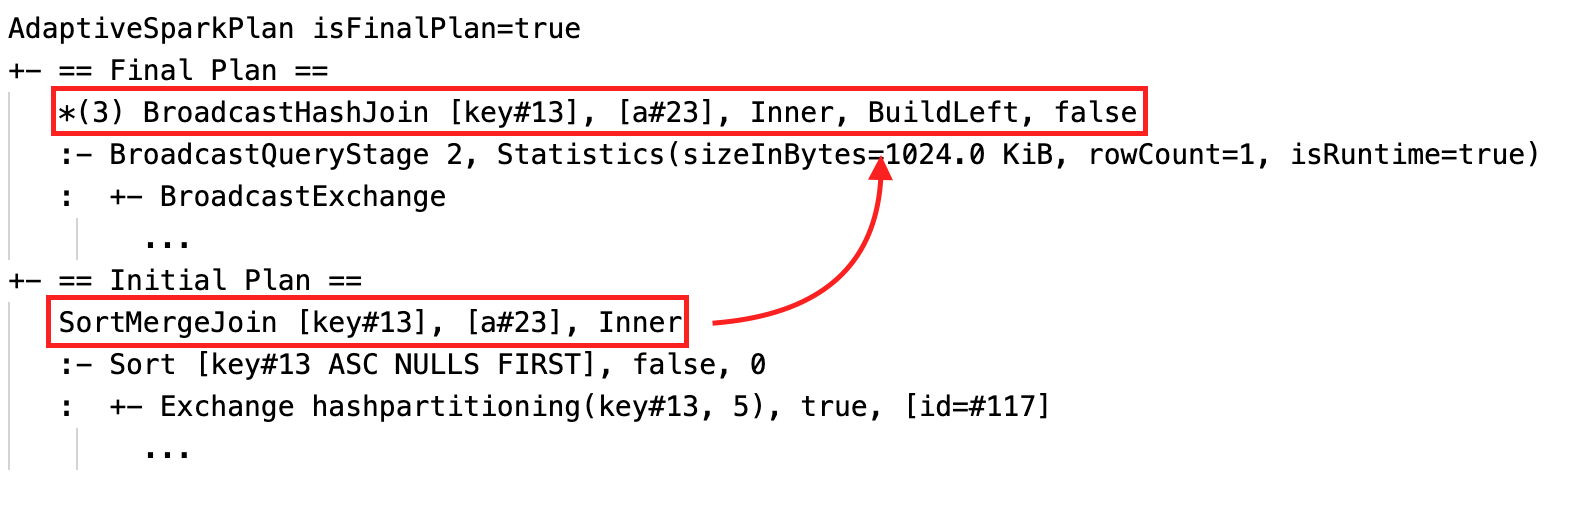
Lorsque l’AQE applique une optimisation, le plan de query change. Pour déterminer quelles optimisations ont pris effet, comparez le plan actuel ou final au plan initial. Chaque optimisation modifie le plan d’une manière spécifique :
-
Changement de stratégie de jointure. Le plan actuel ou final dispose d’un nœud de jointure physique différent du plan initial.
-
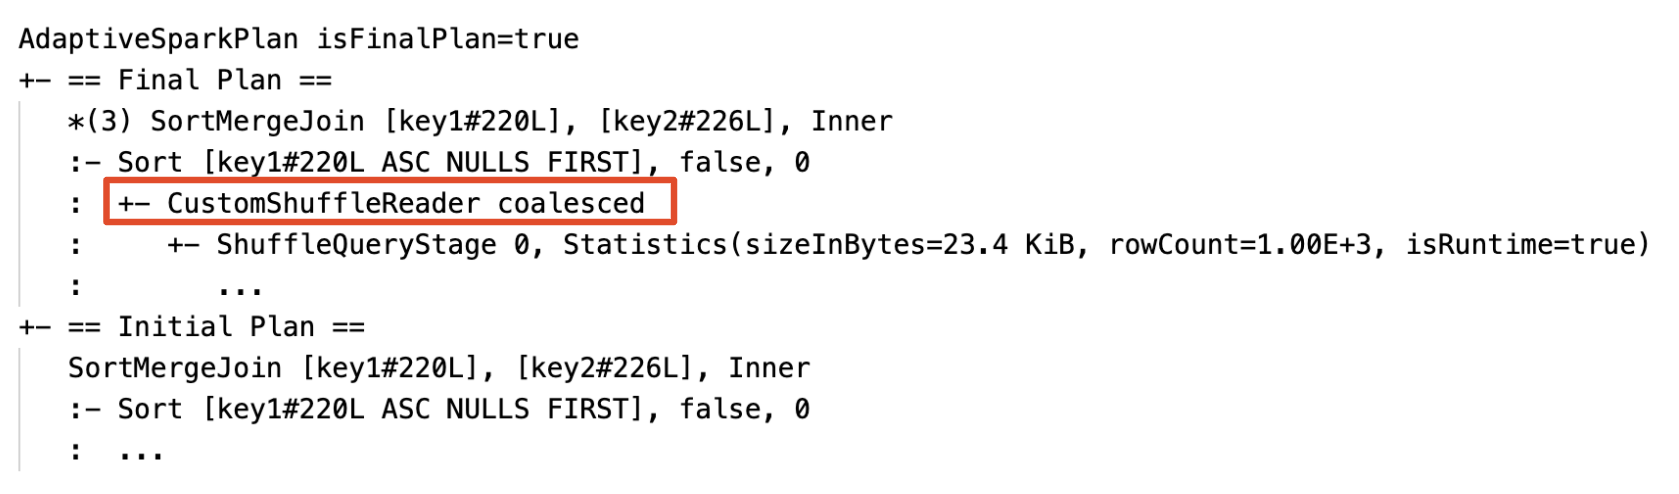
Fusion de partitions. Le plan contient un nœud
CustomShuffleReaderavec la propriétéCoalesced.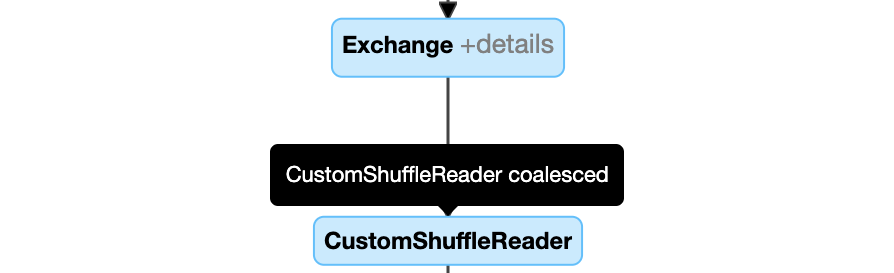
-
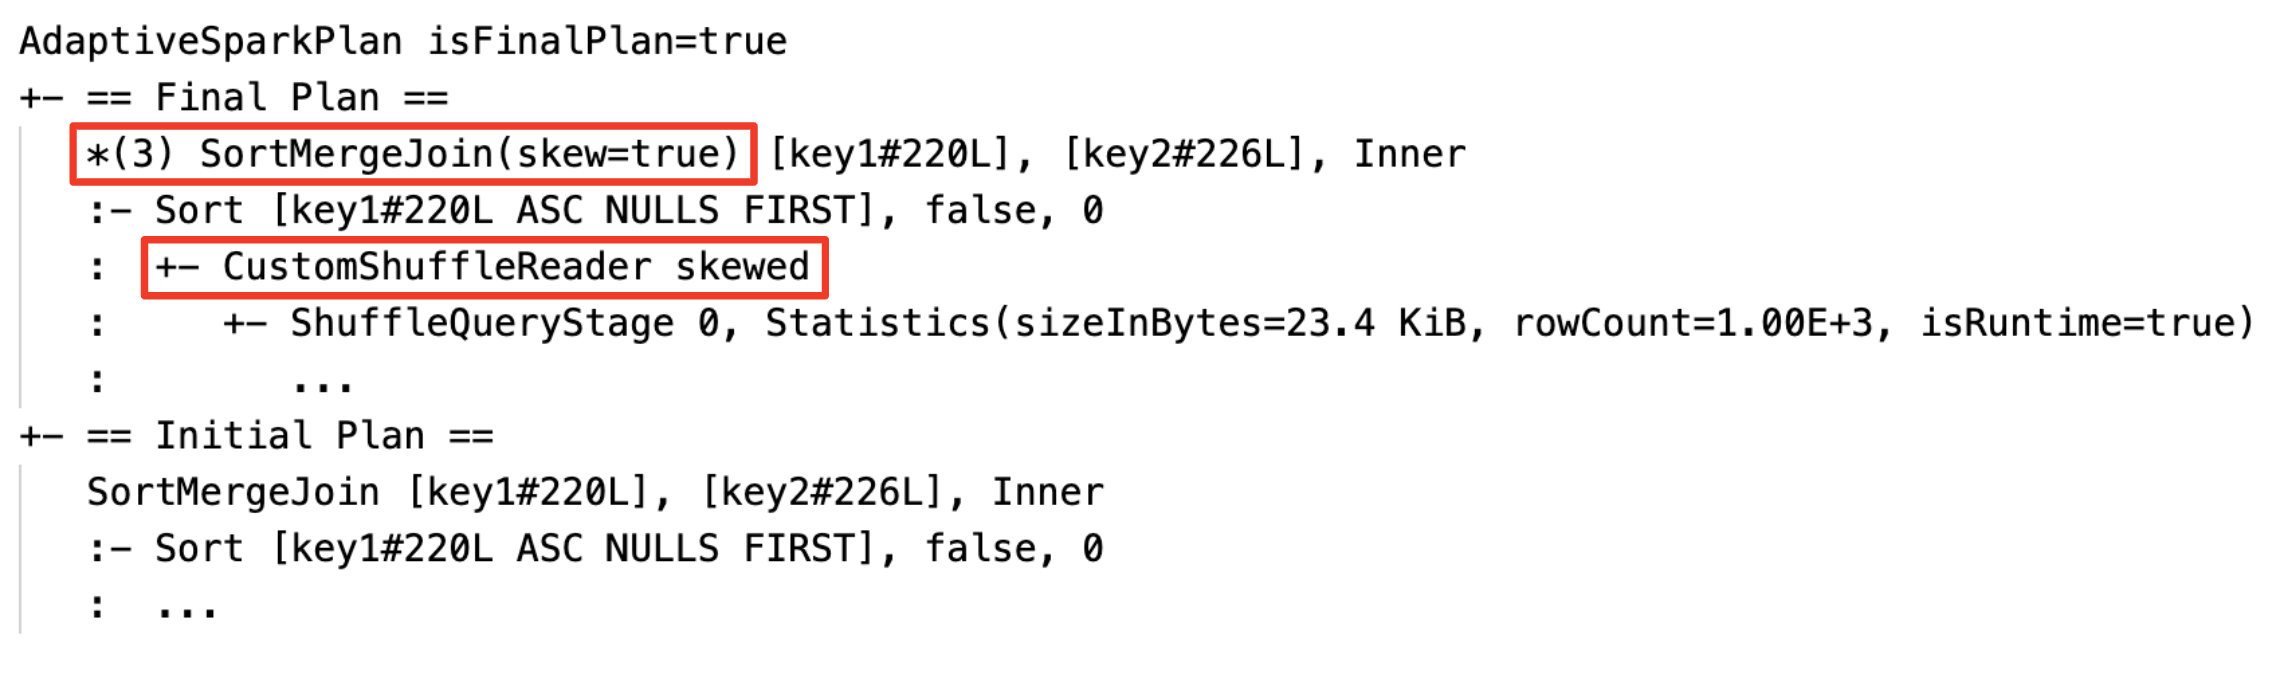
Gestion des jointures asymétriques. Le plan contient un nœud
SortMergeJoinavec le champisSkewdéfini surtrue.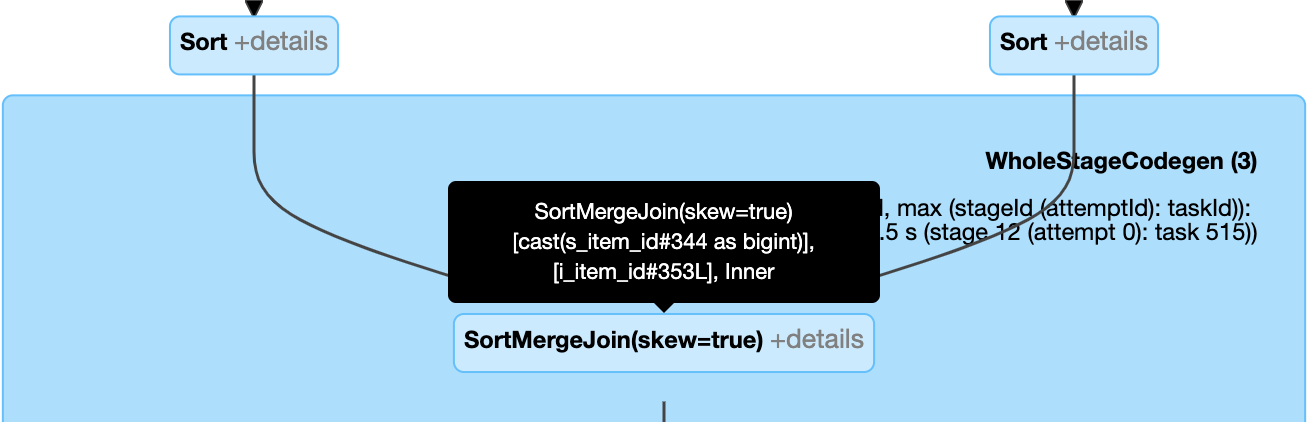
-
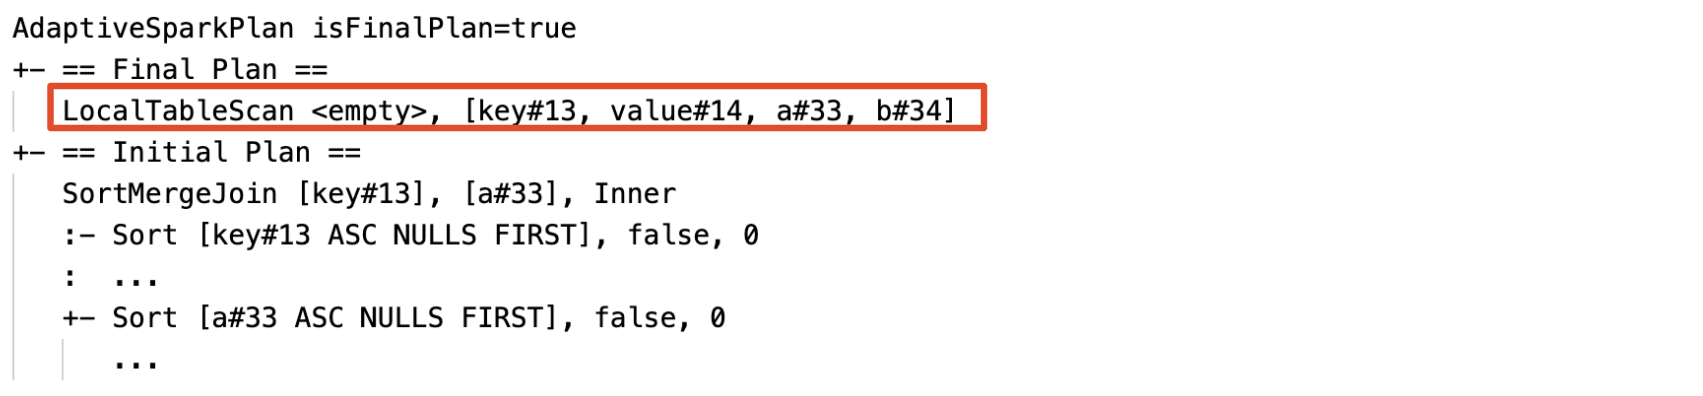
Propagation de relation vide. Un nœud
LocalTableScanavec un champ de relation vide remplace une partie ou la totalité du plan.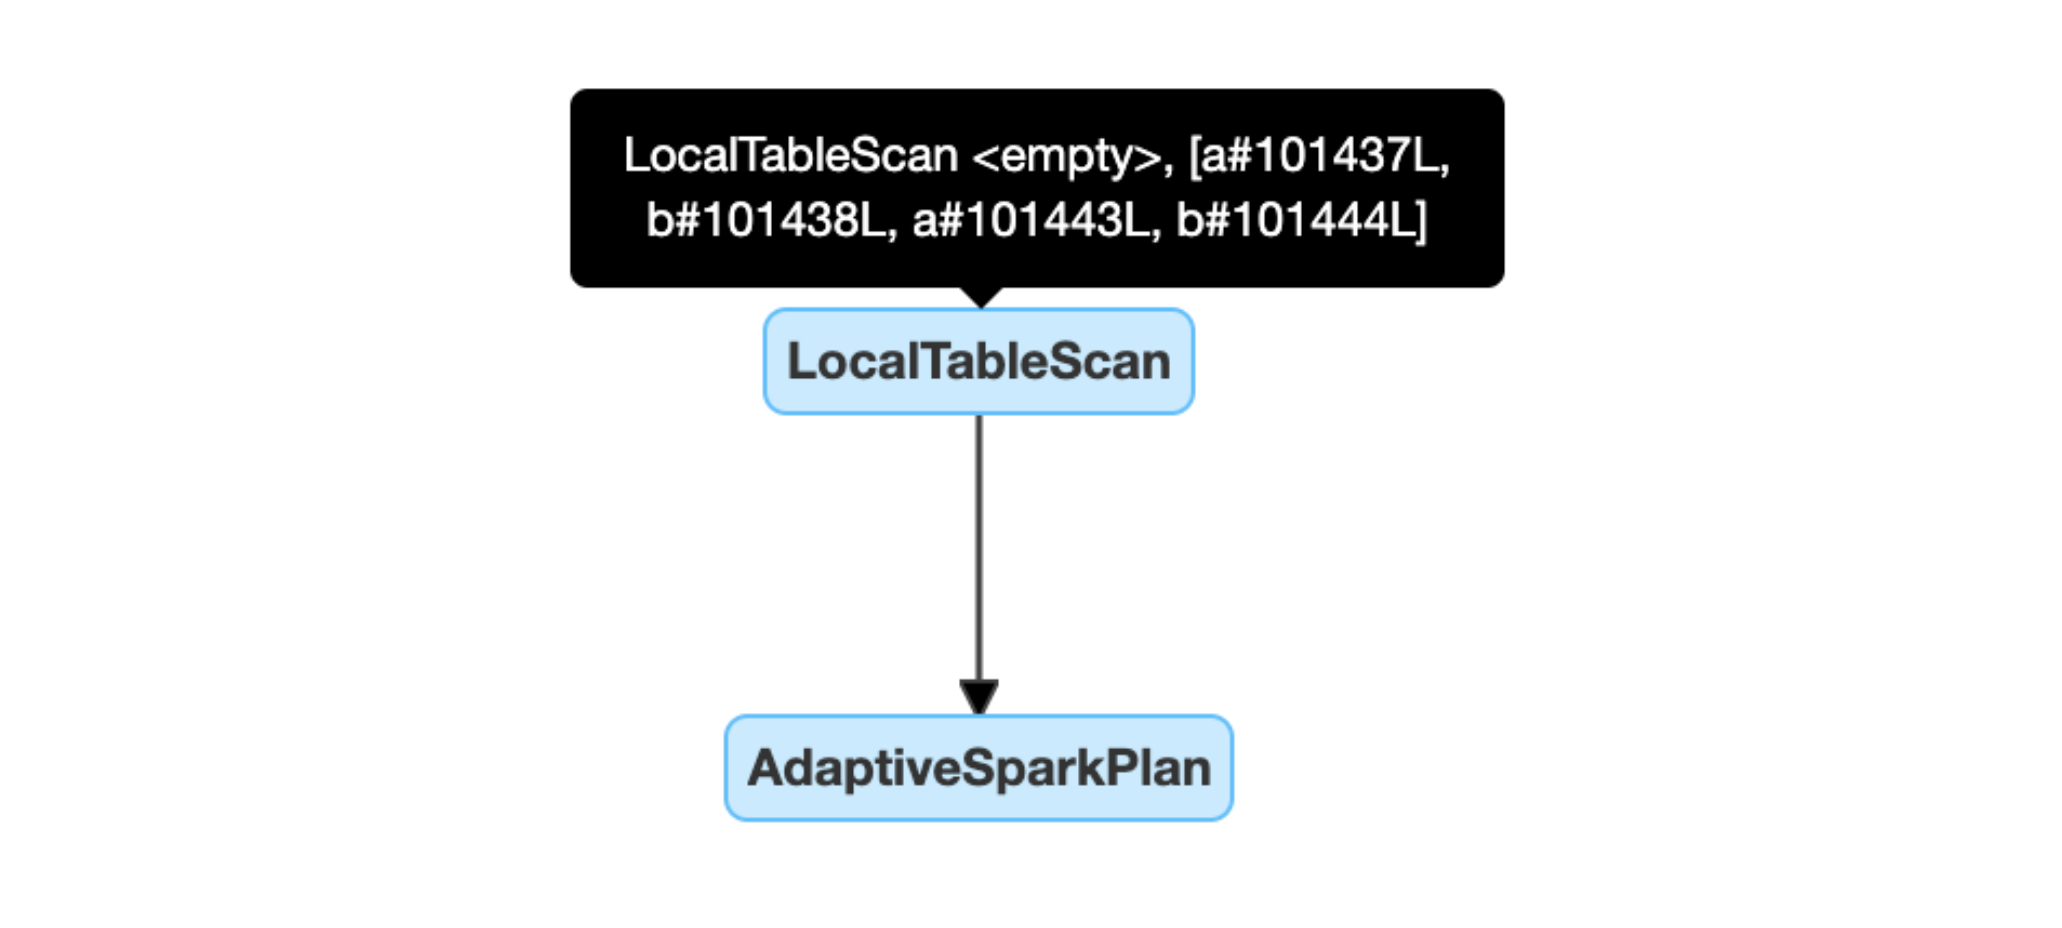
Configuration
Ces propriétés de configuration d'Apache Spark contrôlent l'AQE. La plupart des charges de travail n'ont pas besoin de modifier les default.
Activer AQE et régler les optimisations individuelles
Utilisez ces propriétés pour activer ou désactiver l’AQE et pour ajuster le shuffle auto-optimisé, la commutation de broadcast join et la propagation de relation vide :
Propriété | Type | Par défaut | Description |
|---|---|---|---|
|
|
| Active ou désactive l'exécution adaptative de query. |
|
|
| Nombre de partitions par default à utiliser lors du mélange des données pour les jointures ou les agrégations. Définissez-le sur Pour le Structured Streaming, vous ne pouvez pas modifier cette valeur entre deux redémarrages de la query à partir du même emplacement de point de contrôle. |
|
|
| Le threshold de taille pour passer d'une jointure de Merge à une jointure de hachage de diffusion lors de l'exécution. |
|
|
| Active ou désactive la propagation dynamique des relations vides. |
Coalescer dynamiquement les partitions
Propriété | Type | Par défaut | Description |
|---|---|---|---|
|
|
| Active ou désactive la coalescence de partition. |
|
|
| Taille cible après fusion. Les partitions fusionnées sont proches de cette taille, sans la dépasser. |
|
|
| Taille minimale des partitions après coalescence. Les partitions coalescées ne sont pas plus petites que cette taille. |
|
| Deux fois le nombre de cœurs de cluster | Nombre minimal de partitions après fusion. Ne définissez pas cette propriété, car sa définition remplace |
Gérer dynamiquement la jointure asymétrique
Propriété | Type | Par défaut | Description |
|---|---|---|---|
|
|
| Active ou désactive la gestion des jointures asymétriques. |
|
|
| Multiplicateur de la taille médiane des partitions qu'une partition doit dépasser pour être considérée comme asymétrique. |
|
|
| La taille minimale qu’une partition doit dépasser pour être considérée comme asymétrique. |
AQE considère qu’une partition est asymétrique uniquement lorsque ces deux conditions sont vraies : (partition size > skewedPartitionFactor * median partition size) et (partition size > skewedPartitionThresholdInBytes).
Questions fréquemment posées (FAQ)
Pourquoi l'AQE n'a-t-il pas diffusé une petite table de jointure ?
Si la table est plus petite que spark.databricks.adaptive.autoBroadcastJoinThreshold mais que l’AQE ne la diffuse pas, vérifiez ces causes :
- Le type de jointure ne prend pas en charge la diffusion. Certains types de jointure ne permettent pas de diffuser un côté. Par exemple, AQE ne peut pas diffuser le côté gauche d’une
LEFT OUTER JOIN. - La table comporte de nombreuses partitions vides. La plupart des tâches de la jointure par fusion de tri Merge se terminent rapidement, ou la gestion des jointures asymétriques optimise la jointure. AQE ne transforme pas une jointure par Merge de tri en jointure par hachage de diffusion si le pourcentage de partitions non vides est inférieur à
spark.sql.adaptive.nonEmptyPartitionRatioForBroadcastJoin.
Dois-je toujours utiliser une indication de jointure par diffusion lorsque l’AQE est activée ?
Oui, si vous connaissez bien votre query. Une jointure broadcast que l'optimiseur planifie avant l'exécution de la query fonctionne généralement mieux qu'une jointure que AQE planifie à l'exécution. AQE peut ne pas passer à une jointure broadcast avant d'avoir mélangé les deux côtés de la jointure, c'est-à-dire lorsqu'il connaîtra les tailles réelles des tables.
AQE respecte les indicateurs de query de la même manière que l'optimisation statique, et applique toujours les optimisations dynamiques sur lesquelles les indicateurs n'ont aucun effet.
Dois-je utiliser l’indicateur de jonction asymétrique ou la gestion de jonction asymétrique d’AQE ?
Utilisez la gestion des jointures asymétriques AQE. Il est automatique et fonctionne généralement mieux que l'indice de jointure asymétrique.
Pourquoi AQE n'a-t-il pas réorganisé mes jointures ?
AQE ne réorganise pas les jointures lors de l'exécution. Pour améliorer l’ordre de jointure, collectez les statistiques des tables afin que l’optimiseur basé sur les coûts puisse choisir un meilleur plan. Voir Optimiseur basé sur les coûts.
Pourquoi AQE n'a-t-il pas détecté mon biais de données ?
AQE traite une partition comme asymétrique seulement lorsque ces deux conditions sont remplies :
- La partition est plus grande que
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes(par default256MB). - La partition est plus grande que
spark.sql.adaptive.skewJoin.skewedPartitionFactor(default5) fois la taille médiane de la partition.
AQE gère également l'asymétrie uniquement dans les jointures basées sur le mélange, qui sont des jointures de Merge de tri et des jointures de hachage de mélange. Il n'optimise jamais l'asymétrie dans les jointures de diffusion. Pour les jointures basées sur le mélange, le type de jointure détermine quel côté l'AQE peut optimiser :
Type de jointure | Asymétrie optimisée sur le côté gauche | Asymétrie optimisée sur le côté droit |
|---|---|---|
| Oui | Oui |
| Oui | Oui |
| Oui | Non |
| Non | Oui |
| Oui | Non |
| Oui | Non |
| Non | Non |
Ancien
Spark 1.6 a introduit une fonctionnalité appelée exécution adaptative, mais l'AQE dans Spark 3.0 est une fonctionnalité différente. L'exécution adaptative de Spark 1.6 ne coalesce les partitions que de manière dynamique. AQE est un framework qui planifie et replanifie les queries en fonction des statistiques d'exécution, et il prend en charge toutes les optimisations de cette page.